SV DPI C 参考模型对接:import/export、open array 与联调排错全解
更新时间:2026-09-28。在 SV DPI 与 C/C++ 集成 里已经讲过 DPI 的基本声明和编译链接流程,这一篇聚焦一个更具体的工程场景:把一份现成的 C 参考模型(instruction set simulator、编解码算法、协议栈 golden model)接进 SystemVerilog testbench,让 scoreboard 每一笔事务都能拿到期望值。SV DPI C 参考模型对接的难点不在语法本身,而在数据怎么传、两边内存谁负责、出错时错在哪一侧。
本文要回答的问题
- import 和 export 两个方向分别适合什么角色,纯参考模型为什么大多只 import?
- 变长数据包怎么从 SV 传到 C:open array 的句柄、方向、维度怎么读写?
- context 关键字到底改变了什么,不带 context 的 import 为什么不能回头调 SV?
- C 侧分配的内存返回给 SV,归谁释放,泄漏和悬垂指针怎么防?
- 联调时报 undefined symbol、段错误、数据错位,怎么快速判断错在 SV 侧还是 C 侧?
一、为什么是 C 参考模型,而不是 SV 重写一份
很多 IP 的 golden model 天然就是 C:算法团队给的定点参考代码是 C,指令集模拟器是 C,加解密库是 C。用 SV 重写一份不仅工作量翻倍,还引入「两份参考模型互相不一致」的新风险——比对失败时你得先回答「到底是 RTL 错了还是 SV 模型抄错了」。直接把那份被算法团队签字认可过的 C 代码编译进仿真器,期望值的可信度问题就从根上消失。
DPI(Direct Programming Interface,直接编程接口)是 SystemVerilog 标准(IEEE 1800 第 35 章)规定的 C 互操作层。它的设计取向是「薄」:不做过多的数据封送(marshalling),基本类型按位直接传递,函数调用开销接近一次普通 C 调用。这和 TLM 端口体系 面向组件复用的厚重风格恰好互补——DPI 管「拿到一个正确的数」,TLM 管「这个数怎么在组件间流动」。典型组合是:scoreboard 通过 uvm_tlm_fifo 收到 DUT 事务,再调一次 DPI import 把事务字段喂给 C 模型,拿回期望结果做比对。
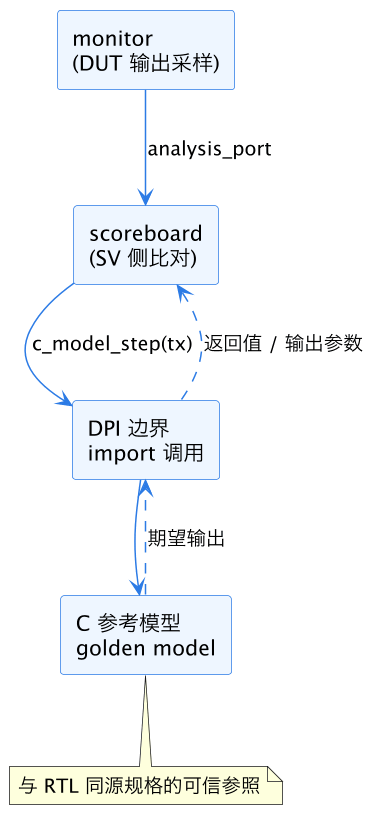
上图画出了 SV DPI C 参考模型在 testbench 里的标准位置:它不自己收发事务,所有「什么时候调用、喂什么数据」的决策都在 SV 侧,C 模型只是一个纯计算引擎。这个职责划分决定了后面所有的对接选择。
二、import 与 export:先定方向,再谈细节
DPI 的两个方向语义很直白:import 是 SV 调 C,export 是 C 调 SV。做参考模型对接时,九成场景只需要 import——C 模型是被动的计算器,SV 侧 scoreboard 掌握了全部时序主动权。
// SV 侧声明:C 模型的三个入口
import "DPI-C" function void c_model_init();
import "DPI-C" function void c_model_reset();
import "DPI-C" function int  c_model_step(
    input  bit [31:0] addr,
    input  bit [63:0] wdata,
    output bit [63:0] rdata,   // 期望值由 C 填回
    output bit        err
);
对应的 C 侧就是三个普通函数,签名由仿真器生成的头文件(svdpi.h 加上工具导出的原型)约束:
#include "svdpi.h"
void c_model_init(void);
void c_model_reset(void);
int  c_model_step(unsigned int addr, unsigned long long wdata,
                  unsigned long long* rdata, unsigned char* err);
export 什么时候登场?当 C 模型内部有「需要反问 testbench」的需求时。典型例子是指令集模拟器跑到一条 load/store,需要访问 SV 侧的内存模型或触发一段 SV 任务。这时把 SV 任务 export 出去,C 侧就能像调普通函数一样调它:
export "DPI-C" function tb_mem_read;
function void tb_mem_read(input bit [31:0] addr, output bit [63:0] data);
  data = mem[addr >> 3];   // C 模型借道访问 SV 内存
endfunction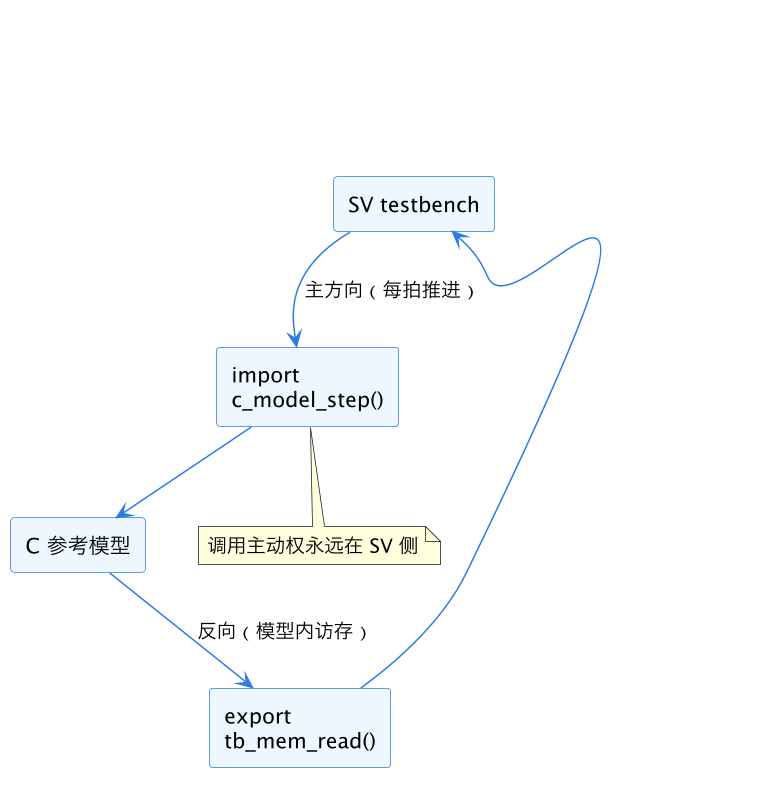
这张图的方向关系要记牢:import 箭头从 SV 指向 C,export 箭头从 C 指回 SV,两条通路在一次仿真里可以交替走,但每次调用的入口一定在 SV 线程上。如果 C 模型自己起线程回头调 export,就踩进了下一节要讲的 context 雷区。
三、context:纯函数与「能回头」的函数
不带 context 的 import 是「纯函数」:仿真器对它几乎不做假设之外的保护,调用开销最低,但函数体内不允许调任何 export、不允许访问 SV 作用域。加上 context 关键字后,仿真器会在进入 C 代码前保存当前 SV 作用域信息,C 侧才能安全地调回 export 函数:
import "DPI-C" context function int c_model_step_ctx(
input bit [31:0] addr, input bit [63:0] wdata);经验法则很简单:只要 C 函数里可能调 export,就声明 context;纯计算的算法模型不要加。白白加 context 的代价是每次调用多一次作用域保存/恢复,在 scoreboard 每拍都调的热路径上,累计开销可观。反过来,该加没加的后果更狠:C 侧调 export 时仿真器报「no context set」之类的运行期错误,或者直接栈错乱段错误,排查时很容易被误判成 ABI 问题。
还有一个细节:C 模型如果需要知道自己「现在是谁在调」(比如多个 agent 实例共享同一份 C 模型),可以用 svGetScope()/svSetScope() 显式切换作用域,把不同实例的状态挂到各自的 SV 层级下。多实例共用 C 模型时这是标准做法,否则 C 侧的全局状态会把两个 agent 的数据搅在一起。
四、open array:变长数据包过边界的正确姿势
标量好办,麻烦的是数据包:一个 1 到 1500 字节不等的以太网帧、一段长度不定的指令流。DPI 的答案是 open array——SV 侧用不指定大小的数组形参,C 侧收到一个 svOpenArrayHandle 句柄,用 API 查询边界、逐元素读写。
import "DPI-C" function void c_model_feed(
    input bit [7:0] payload[],   // open array:长度由调用点决定
    input int       len
);

// 调用点:SV 动态数组直接传,长度不必与形参匹配
bit [7:0] pkt[$] = {8'hAA, 8'h55, 8'h01};
c_model_feed(pkt, pkt.size());
C 侧不能把它当成裸指针用,必须走 svdpi.h 提供的访问函数:
void c_model_feed(const svOpenArrayHandle payload, int len) {
    int n = svSize(payload, 1);          // 第 1 维的元素个数
    int lo = svLow(payload, 1);
    int hi = svHigh(payload, 1);
    for (int i = 0; i < n; i++) {
        // svGetArrElemPtr1 拿到第 i 个元素的地址
        unsigned char* elem = (unsigned char*)svGetArrElemPtr1(payload, lo + i);
        model_consume_byte(*elem);
    }
}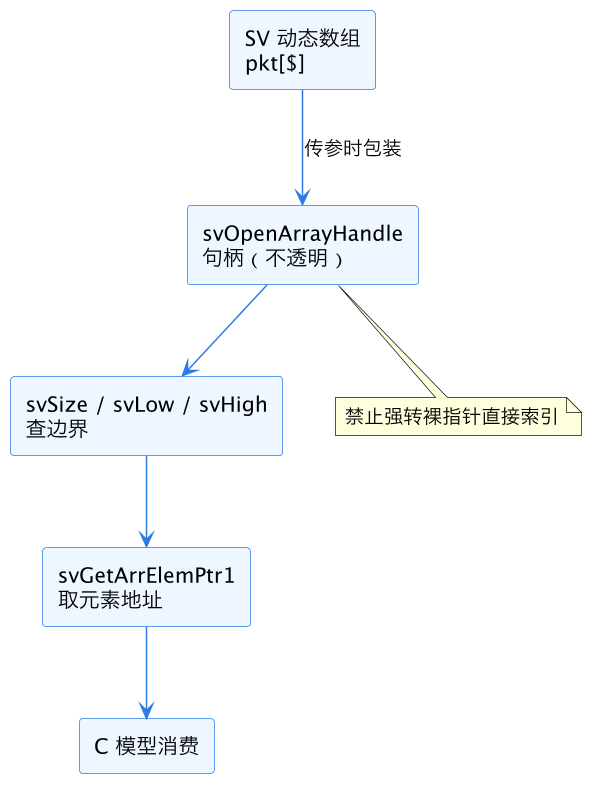
这张数据流图解释了 open array 最容易踩的坑:handle 不是数组首地址。很多第一次写对接的人把它 cast 成 char* 然后 ptr[i] 索引,在某些仿真器上碰巧能跑,换一个仿真器或换一种打包方式立刻数据错位。API 访问慢不了多少,却换来了跨工具的可移植性。另外三个细节:方向是 input 时 C 侧不要写元素(行为未定义,有些工具不拦);SV 数组是倒序声明([hi:lo])时 svLow/svHigh 会反映真实边界,别假设索引从 0 开始;传多维数组时用 svGetArrElemPtr2/3 或先算 svLeft/svRight 逐维展开。
| 数据形态 | SV 形参写法 | C 侧访问方式 | 适用场景 |
|---|---|---|---|
| 32/64 位标量 | input bit [31:0] | 按值传递的普通参数 | 地址、控制字 |
| 固定长宽向量 | input bit [63:0] | unsigned long long | 总线数据 |
| 变长字节流 | input bit [7:0] arr[] | open array API | 数据包、指令流 |
| 结构化记录 | typedef struct packed | 按位拼接的向量(脆弱) | 简单定长记录 |
| 大量字段的事务 | 拆开逐字段传参 | 普通参数列表 | scoreboard 事务比对 |
表格里第五行是血泪经验:把 SV class 事务直接映射成 C struct 看似优雅,但 class 不能过 DPI 边界(只有 packed struct 可以,且字段顺序、填充规则随编译器而变)。可靠做法是在 SV 侧写一个小适配函数,把事务对象的字段展平成一组标量参数。字段多的时候参数列表长一点,换来的是每一比特的语义都白纸黑字。
五、内存与所有权:谁分配,谁释放
对接 C 参考模型最常见的慢性事故是内存:C 侧 malloc 的结果想返回给 SV,或者 C 侧持有的状态在 reset 之间没清。规则只有两条。
第一,跨边界传递的字符串和动态内存,释放权永远在分配方。C 函数返回 char* 给 SV(DPI 里 SV 的 string 对应 C 的 const char*),SV 侧只是借读,绝不 free;下次调用同一函数时 C 侧可能复用缓冲区,SV 侧如果想留存就自己拷贝。反过来 SV 传 string 给 C,C 侧同样不能保存指针跨调用使用,要用就 strdup 后自己管理生命周期。
第二,C 模型的内部状态要有显式的 init/reset 入口。仿真不是跑一遍就退出:UVM 多段激励、多 test 顺序执行、甚至同一个仿真里多次复位,都要求 C 模型能回到干净状态。这就是为什么第一节的接口里固定有 c_model_init 和 c_model_reset——在 SV 的 reset 序列里同步调一次,保证 C 侧队列、统计计数、协议状态机全部归零。漏掉这一步的典型症状是:单跑每个 test 都过,回归连跑从第二个 test 开始挂,期望值里混着上一个用例的残留状态。
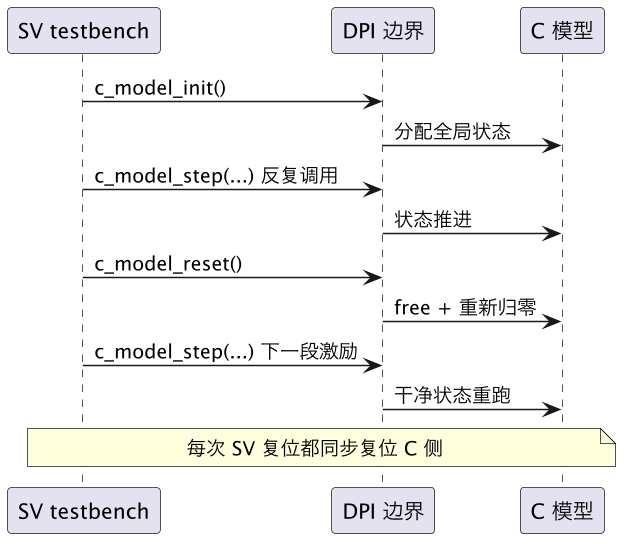
时序图里的 c_model_reset 调用点要和 SV 的复位断言严格对齐:DUT 复位期间 C 模型也必须停在初始态,否则复位释放后的第一拍比对就会报假错。
还有一类介于内存和状态之间的问题值得单独提防:C 模型内部如果用静态变量(static)保存状态,共享库在一次仿真进程里只加载一份,所有 SV 实例看到的是同一份静态数据。单 DUT 环境无所谓,一旦 env 里例化了两个相同的 agent 共用这份模型,两边的中间结果就会互相覆盖。解法要么按第三节说的用 svGetScope() 区分实例、在 C 侧按作用域建状态表,要么把状态封装成句柄——init 返回一个不透明指针,后续每次调用都带上它,模型内部按句柄索引到各自的上下文结构。后一种写法和 POSIX 库的 fd 风格一致,对 C 程序员来说没有理解门槛,也是商用 VIP 参考模型的通行做法。
六、联调排错:报错先定位在哪一侧
对接完成后,排错遵循一个总原则:先用最小用例把 DPI 边界压扁成一次调用,确定错在边界的哪一侧,再回到完整 testbench。常见故障按出现频率排序:
- 链接期 undefined symbol:SV import 的名字和 C 导出符号对不上。C++ 编译会 name mangling,C 参考模型若用
.cpp编译必须包extern "C";函数原型不一致(参数个数、类型宽度)在某些工具上也是链接错误而非警告。 - 段错误发生在 C 函数内:先查 open array 是否被当裸指针用、是否越过了
svHigh边界;再查 C 侧是否保存了上次调用的 SV 指针跨调用使用。 - 数据整体错位/高低字节颠倒:宽度映射问题。SV
bit [31:0]对应 Cunsigned int(不是int,符号扩展会坑你),bit [63:0]对应unsigned long long;logic 四态值过边界时 X/Z 会被压成 0,比对前 SV 侧先做$isunknown检查。 - 第一个 test 过、后续 test 挂:上节的 reset 问题,C 侧状态没归零。
- 偶发性期望错误,波形看 DUT 没错:时序竞争。DPI 调用发生在 SV 进程的求值时刻,如果 scoreboard 在时钟沿同一时刻采样,确认采样在 clocking block 之后、调用在信号稳定区。DPI 本身不引入延迟,但调用点的调度位置是 SV 侧的责任。
排查时最有效的三个手段:C 侧入口加 fprintf(stderr, ...) 打印收到的原始参数(比 SV 侧打印更接近故障点);用 GDB attach 到仿真进程在 C 函数上下断点(主流仿真器都支持,需要把 C 编成 -g 的共享库);以及写一个绕过 testbench 的 C 单元测试 main,把参考模型单独喂数据验证——能独立复现的问题是 C 的,独立跑正确的问题在边界或 SV 侧。
| 症状 | 先怀疑 | 验证手段 |
|---|---|---|
| undefined symbol | 缺 extern "C" / 原型不符 | nm -D libmodel.so 看导出符号 |
| C 内段错误 | open array 越界、悬垂指针 | GDB 断点 + valgrind 单测 |
| 数据错位 | 宽度/符号/字节序 | C 入口打印十六进制原值 |
| 回归连跑挂 | C 状态未 reset | 单 test 复跑确认后查 init 路径 |
| 偶发比对失败 | SV 采样竞争 | 比对日志对齐时钟沿时间戳 |
七、落地清单:把一份 C 模型接进 scoreboard 的完整动作
把前面各节串成一条可执行的路线:
- 确认 C 模型能以纯函数风格被驱动(外部喂输入、取输出),没有就自己包一层;内部有访存需求就规划好 export 的 SV 任务。
- 定义 SV 侧 import 集合:
init/reset/step(或按事务类型拆几个),需要回调的标context。 - 变长数据走 open array,C 侧只用
svdpi.hAPI 访问;事务字段展平传标量,不映射 class。 - C 编成位置无关的共享库(
-fPIC -shared),链接进仿真;C++ 源文件包extern "C"。 - SV 的 reset 序列里同步调
c_model_reset;c_model_init放在 testbench 构建早期。 - 写一个三笔事务的定向用例做边界冒烟:第一笔验证通路、第二笔验证状态推进、第三笔验证 reset 后归零。
- 进 regression 前,在收尾阶段检查 C 模型的统计计数(收了几笔、出了几笔)与 scoreboard 的事务计数一致——数字对不上就是某处静默丢调用。
最后补一条流程层面的建议:C 参考模型和 testbench 分属两个编译域,版本漂移是常态。算法团队更新了 C 模型而没有同步 testbench 里的 import 声明,轻则比对全面报错,重则 ABI 错位直接段错误。把共享库的构建脚本和 DPI 头文件一起纳入仓库管理,并在 c_model_init 里加一行版本号打印(SV 侧同时打印它期望的版本),回归日志里一眼就能确认两边是否同源。这个习惯在有多个项目共用同一份模型时尤其值钱——日志里比对失败的用例,先看版本号那一行,能直接砍掉一半的排查方向。
走完这七步,SV DPI C 参考模型就从一个「能跑通的 demo」变成「敢进回归的比对基线」。
这一篇在知识体系里的位置
- 机制基础:SV DPI 与 C/C++ 集成 讲 DPI 声明、类型映射、编译链接的完整机制,本篇是它在参考模型场景下的工程化落地。
- 比对框架:scoreboard 轨迹比对 描述期望值如何进比对流程,本文解释期望值本身从哪来。
- 通信配套:SystemVerilog TLM 通信 解决事务到 scoreboard 的运输问题,DPI 解决 scoreboard 内部的计算问题。
- 复用视角:分层 testbench 架构与复用 讨论组件跨项目复用,C 参考模型是算法资产跨项目复用的对应物。
总结
SV DPI C 参考模型对接的要点是方向先行与边界克制:import 让 SV 侧 scoreboard 掌握调用主动权,export 只在 C 模型需要反问 testbench 时使用;变长数据一律走 open array 并用 svdpi API 访问,事务字段展平传标量;C 侧状态用 init/reset 显式管理、内存释放权留在分配方;排错先用最小用例定位错在边界哪一侧——做到这些,一份被算法团队认可的 C 代码就能直接成为 RTL 验证的可信比对基线。