Yosys 手工 pass 链:绕开 synth 宏自己排 hierarchy 到 techmap 的顺序
更新时间:2026-11-14。新手第一次跑 Yosys,敲的通常是
yosys -p 'synth -top demo',一条命令拿到门级网表。yosys synth 命令逐段解读 已经证明synth不是单个算法,而是一段打包好的 pass 脚本;Yosys 入门:综合把 RTL 变成了什么 则建立了「RTL 一步步沉降为门单元」的整体直觉。本篇把这件事再推进一步:完全不写synth,在.ys脚本里手工把 hierarchy、proc、opt 系列、fsm、memory、techmap 逐个排出来,用三条链的真跑对照回答一个工程问题——什么时候值得绕开 synth 宏,自己排 Yosys 手工 pass 链。
本文要回答的问题
- 把
synth宏凭直觉展开成hierarchy → proc → opt → fsm → memory → techmap,结果会差多少? - 镜像宏的真实 pass 序列手工重排,能不能复现宏的综合结果?
- 四次
stat打出同样的 16 个单元,为什么 techmap 之后突然跳到 51? - 终态 53、88、51 三个 cell 数字分别说明什么,差 2 个 cell 算不算没收敛?
- 日常工程里到底什么时候才需要自己写 Yosys 手工 pass 链?
先给一张全篇的判断框架卡:
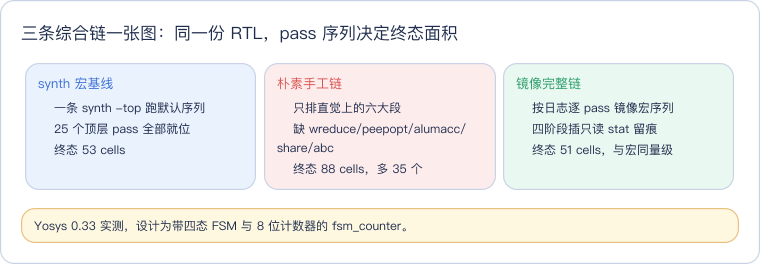
读这张卡先抓住结论:三条链吃的是同一份 RTL,逻辑函数完全相同,终态面积的差异全部来自 pass 序列——少跑几个化简 pass,单元数就膨胀 66%;严格镜像宏的顺序,结果与宏只差 2 个门级单元。下面逐段拆开证据。
一、为什么需要手工 pass 链
synth 宏好用,但它是一个黑盒:给它 RTL,它吐网表,中间发生了什么只能翻日志。多数项目一辈子都不需要打开这个黑盒,可下面三类需求会逼你打开它。
第一类是观察与教学。你想知道 fsm 到底有没有认出你写的状态机、memory_map 把数组摊成了多少个触发器、alumacc 归并了哪些算术单元,就得在对应 pass 后面插一个只读的 stat,让设计在每个阶段停下来报数。宏也能靠 -run 分段跑,但分段标签是固定的 begin/coarse/fine/check,插桩点不能自己定。
第二类是替换或绕开特定 pass。典型场景包括:ABC 在你的工艺库上映射质量差,想换自定义 techmap 规则或直接 -noabc;FSM 要保留原样交给后端工具处理,不能让 fsm pass 提取重编码;验证综合结果怀疑是某个优化 pass 改坏了设计,需要逐段二分定位。宏只暴露有限的开关,精细控制只能靠手工链。
第三类是调试综合结果。网表仿真和 RTL 仿真对不上时,手工链可以在每两步之间 write_verilog 导出中间网表逐段比对,定位「是哪一步改变了设计」。这正是 Yosys techmap 递归映射循环 一类问题的标准排查姿势。
需要先摆正预期:手工链的价值不是比宏更省面积。本篇的实测会显示,认真镜像宏序列的手工链与宏结果同量级,而想当然的朴素链反而显著更差。日常综合仍应优先 synth 宏,手工链是显微镜和手术刀,不是替代品。
二、实验设计:一份带 FSM 的 RTL 与三条链
实验设计刻意选了一个「每个主要 pass 都有活干」的 RTL:fsm_counter 模块含一个四态状态机(IDLE/RUN/WAIT/DONE)、一个 8 位计数器、异步低电平复位和使能逻辑。这样 proc 要拆 always 块、fsm 要提取状态机、alumacc 要处理加法、memory 系列要处理时序赋值、techmap 与 abc 要完成门级沉降,没有 pass 会空跑。
module fsm_counter (
    input  wire       clk,
    input  wire       rst_n,
    input  wire       en,
    output reg  [2:0] state_out,
    output reg  [7:0] count
);

localparam S_IDLE = 3'd0;
localparam S_RUN  = 3'd1;
localparam S_WAIT = 3'd2;
localparam S_DONE = 3'd3;

reg [2:0] state;

always @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        state <= S_IDLE;
        count <= 8'd0;
    end else begin
        case (state)
            S_IDLE: if (en) state <= S_RUN;
            S_RUN:  begin
                count <= count + 8'd1;
                if (count == 8'd9) state <= S_WAIT;
            end
            S_WAIT: state <= S_DONE;
            S_DONE: begin state <= S_IDLE; count <= 8'd0; end
            default: state <= S_IDLE;
        endcase
    end
end

always @(*) state_out = state;

endmodule
同一份 RTL 跑三条 .ys 链。第一条是基线 synth_macro.ys,只有读入、宏、统计三行;第二条是朴素手工链 manual_naive.ys,模拟「知道综合大概分几步、但不知道宏内部细节」的人会怎么排;第三条是镜像完整链 manual_full.ys,从宏的综合日志里逐 pass 提取真实序列手工重排,并在四个阶段后插入只读 stat。
朴素链的完整内容如下,注意每一段后面只跟一个笼统的 opt,这是它后面面积膨胀的伏笔:
read_verilog rtl/fsm_counter.v
hierarchy -top fsm_counter
proc
opt
fsm
opt
memory
opt
techmap
opt
stat
三条链由同一个 run.sh 顺序执行,各自完整日志落在 build/ 下,末尾用 grep 汇总终态 cell 数与镜像链的四次 stat 轨迹。所有数字都来自这次真跑,下一节开始逐一对账。
三、三条链的 pass 序列对照
先看宏到底执行了什么。从综合日志里提取的顶层 pass 序列(编号 2.x 是 synth 宏内部的步骤号,原文如此)如下:
2.1. Executing HIERARCHY pass (managing design hierarchy).
2.2. Executing PROC pass (convert processes to netlists).
2.3. Executing OPT_EXPR pass (perform const folding).
2.4. Executing OPT_CLEAN pass (remove unused cells and wires).
2.5. Executing CHECK pass (checking for obvious problems).
2.6. Executing OPT pass (performing simple optimizations).
2.7. Executing FSM pass (extract and optimize FSM).
2.8. Executing OPT pass (performing simple optimizations).
2.9. Executing WREDUCE pass (reducing word size of cells).
2.10. Executing PEEPOPT pass (run peephole optimizers).
2.11. Executing OPT_CLEAN pass (remove unused cells and wires).
2.12. Executing ALUMACC pass (create $alu and $macc cells).
2.13. Executing SHARE pass (SAT-based resource sharing).
2.14. Executing OPT pass (performing simple optimizations).
2.15. Executing MEMORY pass.
2.16. Executing OPT_CLEAN pass (remove unused cells and wires).
2.17. Executing OPT pass (performing simple optimizations).
2.18. Executing MEMORY_MAP pass (converting memories to logic and flip-flops).
2.19. Executing OPT pass (performing simple optimizations).
2.20. Executing TECHMAP pass (map to technology primitives).
2.21. Executing OPT pass (performing simple optimizations).
2.22. Executing ABC pass (technology mapping using ABC).
2.23. Executing OPT pass (performing simple optimizations).
2.24. Executing HIERARCHY pass (managing design hierarchy).
2.26. Executing CHECK pass (checking for obvious problems).
注意编号里没有 2.25,这是 Yosys 0.33 宏脚本自身的编号跳跃,不是日志缺失。把三条链摆在一起对照,缺口一目了然:
| pass(按执行顺序) | synth 宏 | 朴素手工链 | 镜像完整链 |
|---|---|---|---|
| hierarchy(定顶,首尾各一次) | 有 | 有(仅开头) | 有(首尾各一次) |
| proc / opt_expr / opt_clean / check | 有 | 只有 proc | 全部显式列出 |
| opt(复合优化包) | 6 次 | 4 次 | 按位镜像 |
| fsm | 有 | 有 | 有 |
| wreduce(位宽收敛) | 有 | 缺 | 有 |
| peepopt(窥孔优化) | 有 | 缺 | 有 |
| alumacc / share(算术归并与共享) | 有 | 缺 | 有 |
| memory / memory_map | 有 | 只有 memory | 两个都有 |
| techmap | 有 | 有(过早) | 有 |
| abc(门级映射) | 有 | 缺 | 有 |
| 收尾 check | 有 | 缺 | 有 |
朴素链的问题不是「排错了顺序」,而是把宏想当然地理解成了六段提纲。它缺失的七个 pass 各有不可替代的职责:wreduce 砍掉多余位宽、peepopt 做局部等价替换、alumacc 把散落的加减归并成 $alu/$macc、share 用 SAT 求解共享运算资源、abc 负责把通用函数映射成最优门级结构、memory_map 把存储器摊成触发器阵列、opt_clean 持续清理悬空单元与线网。少了它们,opt 复合包再努力也补不回来——这正是 88 对 53 的来源。
四、pass 链流程图:顺序本身就是约束
下图把镜像完整链压成四个阶段,画清 pass 之间的数据流与顺序依赖。蓝色是入口,橙色四个容器是按序执行的化简阶段,绿色是只读留痕点;容器里标注的是该阶段的关键 pass,与上一节的序列表一一对应。
读这张图要抓住两条约束。第一条是顺序不可随意调换:proc 必须在 fsm 之前,因为状态机识别吃的是过程块拆解后的 mux 网络;memory_map 必须在 techmap 之前,否则存储器抽象没有摊平,门级模板无从匹配;abc 必须在 techmap 之后,它映射的对象已经是内部通用门单元。朴素链把 techmap 放在 memory_map 缺失的位置上提前执行,等于在半成品表示上做沉降,后面又没有 abc 收口,门级结构只能放任膨胀。
第二条是 stat 是旁路观察点,不在主数据流上。它只读设计、打印统计,不修改任何单元,所以插在任意两个 pass 之间都不会改变后续结果。这是手工链相对宏 -run 分段最大的自由度:观察点想放哪就放哪。
五、逐阶段 stat:16、16、16、51 的真实含义
镜像链在 proc 段后、fsm 段后、memory 段后、techmap 与 abc 收尾后各打一次 stat,四次 cell 数轨迹是 16 → 16 → 16 → 51。终端汇总区原样如下:
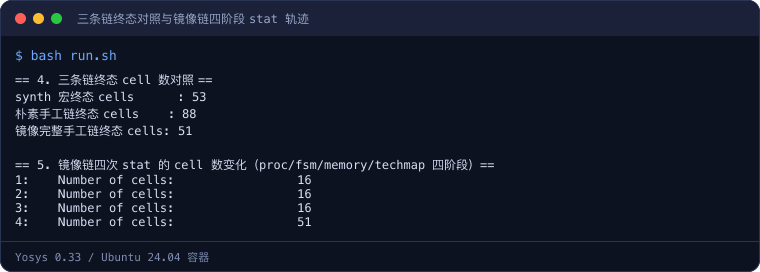
连续三个 16 很容易被误读成「前三个阶段什么都没干」。把四次 stat 的单元构成摊开看,事实正好相反:
| 阶段(stat 时机) | cells | 代表性单元构成 | 表示层级 |
|---|---|---|---|
| proc 段后 | 16 | $add、$adffe×2、$eq×4、$mux×2、$pmux×2 | RTL 高层单元 |
| fsm 段后 | 16 | $alu、$adffe×2、$eq×4、$mux×2、$pmux×2 | RTL 高层单元(算术已归并) |
| memory 段后 | 16 | 与上一阶段同构 | RTL 高层单元 |
| techmap+abc 后 | 51 | $_AND_×15、$_XOR_×6、$_DFFE_PN0P_×10 等 | 门级原语 |
前两次 stat 总数都是 16,内部却发生了实质替换:第一次统计里有 1 个 $add,第二次它消失了,取而代之的是 1 个 $alu——这正是 alumacc 的归并成果,单元总数不变是因为归并是一对一的结构升级。fsm 段后到 memory 段后数字与构成都不变,是因为这个设计没有数组型存储器,memory/memory_map 对它没有实际改动,属于正常空跑。
51 的跳变则是统计口径换了坐标系。前三个 stat 数的是 RTL 级高层单元,一个 $mux 就是一个 cell;techmap 按内置模板把每个高层单元展开成若干门级原语,一个 $mux 会分解成多个 $_AND_/$_NOT_/$_OR_,abc 再在门级表示上重写。所以跨 techmap 边界的 cell 数不可直接比较——16 到 51 不是「优化让设计变大了 35 个单元」,而是同一个设计在两种抽象层级下的不同计数方式。读 stat 报告的完整字段口径可以对照 Yosys stat 报告怎么读。
六、终态面积:53、88、51 三个数字怎么读
三条链的终态门级构成如下,全部数字取自各自最后一次 stat:
| 门级原语 | synth 宏(53) | 朴素链(88) | 镜像链(51) |
|---|---|---|---|
$_AND_ | 2 | 21 | 15 |
$_ANDNOT_ | 15 | 0 | 5 |
$_NAND_ | 6 | 0 | 6 |
$_NOR_ | 1 | 0 | 3 |
$_OR_ | 7 | 25 | 2 |
$_ORNOT_ | 4 | 0 | 2 |
$_NOT_ | 0 | 9 | 1 |
$_XOR_ | 7 | 7 | 6 |
$_XNOR_ | 1 | 0 | 1 |
$_MUX_ | 0 | 15 | 0 |
$_DFFE_PN0P_(时序单元) | 10 | 11 | 10 |
先看朴素链的 88。它的统计里还留着 15 个 $_MUX_——这是 techmap 提前沉降、又没有 abc 收口的直接证据;组合逻辑侧只剩 $_AND_/$_OR_/$_NOT_/$_XOR_ 四类最朴素的门,没有任何复合门(ANDNOT/NAND/NOR/ORNOT/XNOR 全为 0),因为 peepopt 这类负责门级等价折叠的 pass 根本没跑。21 个 AND 加 25 个 OR 堆出了 66% 的面积膨胀,而时序单元只多 1 个(11 对 10),说明浪费集中在组合逻辑,与缺失 pass 的职责完全对得上。
再看镜像链 51 与宏 53 的 2 个 cell 之差。两者时序单元都是 10 个 $_DFFE_PN0P_,触发器层级完全一致;差异全在组合逻辑的分解方式:宏侧有 15 个 $_ANDNOT_ 配 2 个 $_AND_,镜像链反过来是 5 个 $_ANDNOT_ 配 15 个 $_AND_,NOR/ORNOT/OR/NOT/XOR 的配比也各不相同。原因是手工重排后,abc 看到的 AIG(与非图)输入结构与宏内部子 pass 留下的选择状态略有差异,同一个逻辑函数被分解成了等价但不同形状的门级表达式。
工程上的判断口径是:同一逻辑函数的等价门级实现,面积同量级即视为收敛,不追求逐 cell 对等。51 与 53 的差幅不到 4%,且都由同类门级原语构成,没有任何高层单元残留,这就是一次合格的镜像。反过来,88 对 53 是 66% 的差幅且伴随 $_MUX_ 残留,属于结构性未收敛,二者性质完全不同。abc 在门级映射阶段的工作机制,Yosys ABC 工艺映射流程 有完整拆解。
耗时分布也值得记一笔。镜像链日志末尾的 Time spent 行显示,abc 一次调用占了整链 38% 的时间,opt_expr 被调用 21 次、合计占 17%——门级映射与常量折叠是 Yosys 综合的两大时间大户,这也是为什么绕开 abc 的手工链虽然省时间,却必须自己承担映射质量后果。
七、什么时候绕开 synth 宏
把实测结论收成可操作的决策清单。下面四种场景值得写 Yosys 手工 pass 链,除此之外默认用宏:
| 场景 | 手工链做法 | 对应诉求 |
|---|---|---|
| 教学或评审,要看化简轨迹 | 每个关键 pass 后插只读 stat,必要时 write_verilog 导出中间网表 | 可观察性 |
| abc 映射质量不达标或无库环境 | 排到 techmap 收口,用自定义 techmap 规则替代 abc | 替换 pass |
| FSM/存储器要保留原结构交后端 | 跳过 fsm 或 memory_map,让高层单元原样保留 | 绕开 pass |
| 综合后仿真与 RTL 对不上 | 二分插桩,逐段导出网表定位第一个产生分歧的 pass | 调试定位 |
排链时守住三条纪律。其一,顺序照抄宏的依赖关系:proc 在 fsm 前、memory_map 在 techmap 前、abc 在 techmap 后,不要按名词联想重排。其二,每段化简后跟上 opt_clean 与 opt,宏在每个大 pass 后都做清理,手工链漏掉这一步会让悬空单元累积到下游。其三,跨 techmap 比较 stat 没有意义,判断收敛要么在同一表示层级内比 cell 数,要么在门级比面积量级与时序单元数。
最后提醒一句起点:第一次写 .ys 脚本的最小闭环建议先走一遍 Yosys 第一次综合完整流程 的六步标准路径,确认每一步产物长什么样,再回来做手工拆链;对整条 pass 链每个环节的职责还生疏时,yosys synth 命令逐段解读 是本篇最直接的前置阅读。
实验环境
- 机器/系统:linux/amd64 容器,Ubuntu 24.04(geek-eda 镜像)
- 工具版本:Yosys 0.33 (git sha1 2584903a060)
- 日期:2026-11-14
- 完整命令:
bash run.sh(顺序执行 synth_macro.ys、manual_naive.ys、manual_full.ys 三条链,并汇总终态 cell 数与四阶段 stat 轨迹)
代码获取
RTL 设计、三条 .ys 链脚本与一键复现脚本已同步到公开仓库:geek-doc.cn/experiments/yosys-custom-pass-chain,克隆后进入该目录执行 bash run.sh 即可复现本文引用的全部 stat 输出,三份完整链日志保存在 build/ 下。
这一篇在知识体系里的位置
- 想理解
synth宏内部 begin/coarse/fine/check 四段的完整机制:读 yosys synth 命令逐段解读,本篇是它的动手延伸篇; - 还没跑过第一次综合:先读 Yosys 入门:综合把 RTL 变成了什么 与 Yosys 第一次综合完整流程;
- 想学会读 stat 报告每个字段:读 Yosys stat 报告怎么读;
- 关心 techmap 与 abc 的映射机制和报错:读 Yosys ABC 工艺映射流程 与 Yosys techmap 递归映射循环;
- 更多 Yosys 与开源 EDA 实践见 EDA 工具实践目录。
总结
Yosys 手工 pass 链的意义不在替代 synth 宏,而在可控与可观察:朴素链用 88 个 cell 的代价证明了漏掉 wreduce、peepopt、alumacc、share、abc 等化简 pass 的后果,镜像链用 51 对 53 的同量级结果证明严格按序重排可以收敛,而 16→16→16→51 的 stat 轨迹提醒我们跨 techmap 边界的 cell 数不可直接比较;日常综合仍优先用宏,只有需要插桩观察、替换绕开特定 pass 或逐段调试时,才自己排这条 hierarchy 到 techmap 的链。