FPGA 原型验证专题 55:原型容量规划与故障预算——为下一个项目提前算清要多少 FPGA、以及灾难发生那天怎么办
更新时间:2026-09-13。本文是模块 F(规模化、云化与工程运营) 的收官篇,也是整个外围系列(26~55)的收口。46 编译农场与周转时间 OOC/增量/seed 扫掠~54 运营指标看板 利用率/TAT/flake/就绪度 解决的是“当下怎么转得快、测得好”;最后一篇看向未来,处理两件必须提前数月想清楚的事:下一代要多少 FPGA,以及灾难那天怎么办。
一、容量规划:在需求到来之前买对量
硬件采购、license、云合约都有提前期(数周到数月),不能等“板不够了”才买。容量规划的输入与逻辑:
预测需求 D(t) = Σ_项目(预估逻辑规模→所需 FPGA 片数 × 并行构建/副本数
                       × 占用时长 × 同时在跑的团队数)
可用容量 C(t) = 自有板有效机时 + 已签约云额度
缺口 = D − C,缺口为正且超 SLA 等待 → 提前采购/增约- 片数怎么估:用历史“单位逻辑门数/核数 → 占用 FPGA 资源比例”外推下一代(91 篇 AI 切片说明规模会跳变,要留非线性裕量),再乘副本系数(同一镜像常要多份:交互一份、回归池数份、长稳一份);
- 数据基础:直接用 95 看板的真实利用率、排队、TAT 历史,而不是各团队拍脑袋上报(上报必然高估、人人想囤);
- 自有基线 + 云弹性:自有容量按“可预测的基线负载 + 少量裕量”定,不可预测的峰值交给云(90 篇),避免为一年几次的里程碑峰值常年养大量闲置硬件(85 TCO);
- license/存储/机房配套同步:板增了 license 槽、存储 IO、供电制冷不跟上等于没增(87/93 篇三平衡)。
二、把不确定性放进规划:情景与缓冲
预测一定有误差,规划要显式容纳:
- 三情景:乐观(项目延期/规模收敛)、基准、悲观(多项目撞期+规模超估),按“悲观情景下里程碑仍不崩”定底线容量,但用云而非全自建去承接悲观峰值;
- 缓冲池:留一小比例机动板应对临时需求与故障顶替(见第三节备件);
- 季度滚动校准:每季度用实际利用率/排队回看预测偏差并调整采购,而不是一年做一次精确却错误的计划;
- 扩容触发线:预设“利用率连续 N 周 >X% 或 P90 等待 >Y”即触发采购/增云,把决策规则化、提前启动,避开采购提前期。
三、故障预算:为“会坏”这件事做工程
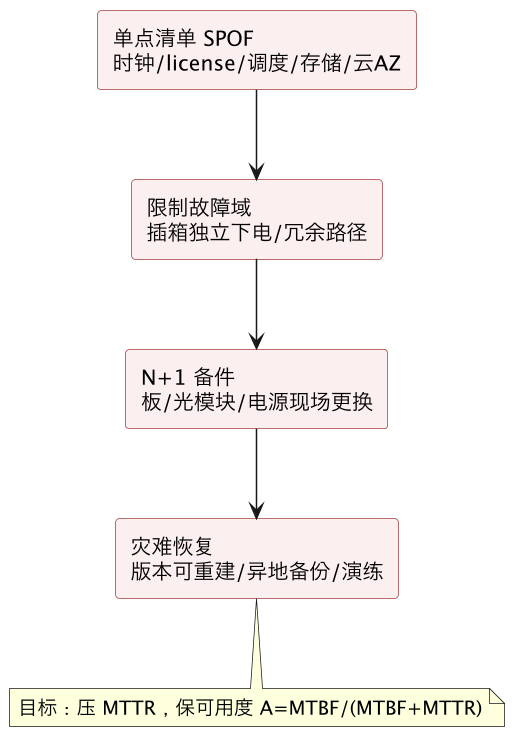
上百片 FPGA + 光模块 + 服务器 + 存储 + 云,故障不是意外而是确定会发生的统计事件。先量化:
可用度 A = MTBF / (MTBF + MTTR)
例:目标 A=99.5% → 全年允许停机 ≈ 1.8 天(分摊到资源池)- MTBF 由器件/模块可靠性决定(板级可靠性见 19 SEU,还要考虑光模块、电源、服务器);
- MTTR 由你的备件、监控、更换流程决定——MTTR 是运营能主动压的变量,比追求更高 MTBF 便宜;
- 故障预算:先定“平台/关键项目需要多高可用度”,反推能接受多少、多长的停机,再决定冗余和备件投入,而不是追求无上限的“永远不宕机”。
四、限制故障域 + 消除单点 + N+1
- 单点(SPOF)清单:逐个列出只有一个的关键件——主时钟源、license 服务器、调度/网关、共享存储、汇聚交换机、云的单可用区,能冗余就冗余(时钟主备 87 篇、服务高可用、存储备份、云多 AZ);
- N+1 备件:板/光模块/电源按规模备一定比例现场备件,坏了立刻换而不是等采购,把 MTTR 从周压到小时;
- 故障域隔离:沿用 93 篇——可独立下电更换的插箱、冗余互联路径、单板下线可降级重组,使一次故障只影响局部;
- 降级而非全停:预定义各级故障下的“还能跑什么较小设计/哪些项目优先”,关键里程碑项目优先保。
五、灾难恢复:RTO / RPO 与演练
区分“故障(局部、自动恢复)”与“灾难(机房级/云区域级/数据丢失)”,后者要书面预案:
RTO(恢复时间目标):多快恢复服务
RPO(数据损失容忍):最多丢多久的数据- 配置与产物可重建:RTL、约束、分区、比特流版本都在版本库(20 比特流烧录与四方版本一致 manifest/门禁),即使机房全失也能在别处重建镜像,这是把 RPO 压到接近零的根本;
- trace/证据备份分级:高价值证据(92 篇结论/证据包)异地备份,海量可重生成原始 trace 不必全备(86 留存纪律);
- 云跨区域 / 跨供应商预案:防单云区域中断(90 篇安全模型也涉及锁定风险——镜像不可移植,要预先验证在另一平台重建的路径);
- 定期演练(chaos/fire drill):故意拔板、关一个服务、切时钟、模拟掉电,验证自动隔离、租约恢复、降级重组真的有效——没演练过的预案等于没有。
六、把容量与可用度放进同一本经济账
韧性不是免费的:备件、冗余、双活、云备份都要花钱。和 44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本 一样按风险定价:
- 关键里程碑前的平台值得更高冗余(停一天的损失远高于备件成本);
- 平时非关键负载可用较低冗余、靠云快速顶替;
- 用“停机损失 × 发生概率”对比“冗余投入”决定冗余级别,避免两种极端:裸奔无冗余、或对所有平台无差别过度冗余。
七、年度容量与韧性评审清单
①下一代规模/并行项目/人数三情景;②所需 FPGA 片数(含副本/非线性裕量)与配套 license/存储/供电;③自有基线+云弹性的配比与扩容触发线;④利用率/排队季度滚动校准机制;⑤可用度目标与 MTBF/MTTR;⑥SPOF 清单与冗余/N+1 备件;⑦故障域与降级优先级;⑧RTO/RPO、异地备份与跨云重建路径;⑨灾难恢复演练日程;⑩冗余投入 vs 停机损失的经济校核。
八、常见坑速查
- 等板不够才买 → 提前期让里程碑全线排队,要按触发线提前规划;
- 全按团队上报/全自建承接峰值 → 用历史数据、自有基线+云弹性;
- 追求零故障/无差别冗余 → 按可用度目标和风险经济账定冗余;
- 只盯 MTBF 不压 MTTR → 备件+更换流程更便宜有效;
- 预案写好不演练 → 火灾演练验证才作数;
- 比特流/证据只存一处 → 版本库+异地备份保证可重建、低 RPO。
与系列及现有篇目的链接
- 容量基础:46 编译农场与周转时间 OOC/增量/seed 扫掠、47 多用户资源调度 预约/作业/租约/防误烧、49 分区云 FPGA Shell/RP/虚拟原型接入、52 多站点机柜与互联拓扑 时钟分发/故障域
- 数据与成本:54 运营指标看板 利用率/TAT/flake/就绪度、44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本
- 可靠性与版本:19 SEU 可靠性、20 比特流烧录与四方版本一致 manifest/门禁、51 跨团队调试闭包 DRI/分诊/证据包/bisect、45 Trace 带宽与深度工程 采样/缓冲/压缩/回传管线
总结
一句话总结:模块 F 收官要把两类决策提前数月做好——其一是容量规划,用看板真实利用率/排队/TAT 历史而非团队高估的上报做需求预测,按“需求 D=Σ(项目逻辑规模外推的 FPGA 片数含 AI 类规模跳变的非线性裕量×交互/回归/长稳副本系数×占用时长×并行团队),缺口=D−可用容量”测算,自有容量只承接可预测基线加小裕量、不可预测峰值交给云弹性以免为一年几次的峰值常年养闲置硬件,并让 license 槽/存储 IO/供电制冷同步配套,同时用乐观/基准/悲观三情景(按悲观不崩定底线但以云承接悲观峰值)、机动缓冲池、季度滚动校准和“利用率连续超阈/P90 等待超限即提前触发采购”的规则化触发线来容纳预测误差、避开采购提前期;其二是故障预算,把故障当确定发生的统计事件,先定可用度目标 A=MTBF/(MTBF+MTTR)(如 99.5% 对应全年约 1.8 天可接受停机)反推冗余投入,重点通过现场 N+1 备件、健康监控和标准化更换去主动压低成本可控的 MTTR 而非只追高 MTBF;具体靠列出主时钟/license 服务器/调度网关/共享存储/汇聚交换机/单云可用区的单点清单并冗余、按规模备板/光模块/电源备件把更换从周压到小时、沿用可独立下电插箱与冗余路径限制故障域、预定义故障下按里程碑优先级降级运行较小设计;灾难级场景定义 RTO/RPO,靠 RTL/约束/分区/比特流全部版本化把 RPO 压到接近零、高价值证据异地备份而海量可重生成 trace 不全备、预设跨区域跨云的重建路径(因云镜像不可移植须事先验证),并定期通过故意拔板切服务的火灾演练验证自动隔离/租约恢复/降级重组,没演练的预案等于没有;最后把容量与韧性放进同一本经济账,用“停机损失×概率”对比“冗余投入”,在里程碑前高配冗余、平时靠云顶替,避免裸奔与无差别过度冗余两个极端。