FPGA 原型验证专题 21:激励注入与软硬件协同——co-model、事务处理器、主机速度协同与向量回放
更新时间:2026-09-12。本文是「ASIC FPGA 原型验证系统」专题 06~25 深体系列分册,对应阶段 5(FPGA 上板运行的激励侧)。混合平台互联见 专家 37 FPGA 与仿真器互联。
这一篇在链路里的位置
阶段 5 的输入是"比特流 + 测试激励/用例"。激励体系决定原型能不能跑出有代表性的真实活动——这直接关系阶段 7 用活动数据做功耗分析是否有意义。原型的独特价值是"以接近真实速度跑真实软件栈"。
本文要回答的问题
- 原型上的负载从哪来:真实固件/OS/应用、定向测试、随机/受约束事务、回放向量、真实外设?
- 主机(慢、灵活)与 FPGA(快、固定)速度差几个数量级,co-model 如何用事务级接口弥合?
- transactor/事务处理器如何把一次函数调用展开成多周期引脚事务?SCE-MI 式输入/输出/采样通道怎么工作?
- 速率匹配:阻塞/非阻塞通道、时钟门控节流、确定性模式与实时模式的区别?
- 多片、多 transactor、多主机通道如何编排与同步?
- 如何保证一次上板运行可复现(种子、录制、回放、时间戳)?
- 软件验证负载 vs 性能评估/活动采集负载在搭建上的差异?
- 覆盖率/检查器如何在原型速度下回收(与仿真、Emulation 的分工)?
一、原型负载光谱
阶段 5 要解决的问题是「让正确的事情在板子上发生」。负载从真实到抽象排成光谱:
| 负载 | 形态 | 速度 | 用途 |
|---|---|---|---|
| 真实软件栈 | DUT 内 CPU 跑 bootloader/OS/驱动/真实应用(29、RISC-V 背景) | 最高、最真实 | 软件验证、长场景、活动/功耗代表性 |
| 真实外设/仪表 | 真实 PHY、流量发生器、协议分析仪接原型接口 | 实时 | 接口互操作、系统级场景 |
| 事务级 co-model | 主机测试程序经通道发事务,FPGA 侧 transactor 转引脚时序 | 事务突发、整体很快 | 定向/随机协议激励、记分板检查 |
| 向量回放 | 仿真录制的引脚/接口周期向量在板上重放 | 快但有限长 | 定向复现 bug、回归黄金向量 |
| 裸激励 | 直接写 DUT 寄存器、置管脚 | 最灵活 | bring-up、单点调试(03 原型平台 bring-up 多片点亮/trace) |
真实软件栈是原型相对仿真/Emulation 的立身之本:操作系统启动这类场景在仿真里可能要跑数周,原型上以分钟计(06 原型验证系统全景与文档地图)。而活动数据是否有功耗代表性(25 真实激励驱动 ASIC 签核 SAIF 反标/边界),首先取决于负载是否真实。
二、速度差:co-model 要解决的根本矛盾
主机(x86 工作站上跑 C/Python 测试程序或外设行为模型)灵活但慢,FPGA 以 MHz 级固定逻辑运行——两者相差约 10⁴~10⁶ 倍。如果主机逐周期地「给值→等一拍→再给值」,FPGA 99.99% 的时间在停等,原型速度优势归零,而且逐周期跨 JTAG/PCIe 的延迟抖动会破坏时序。
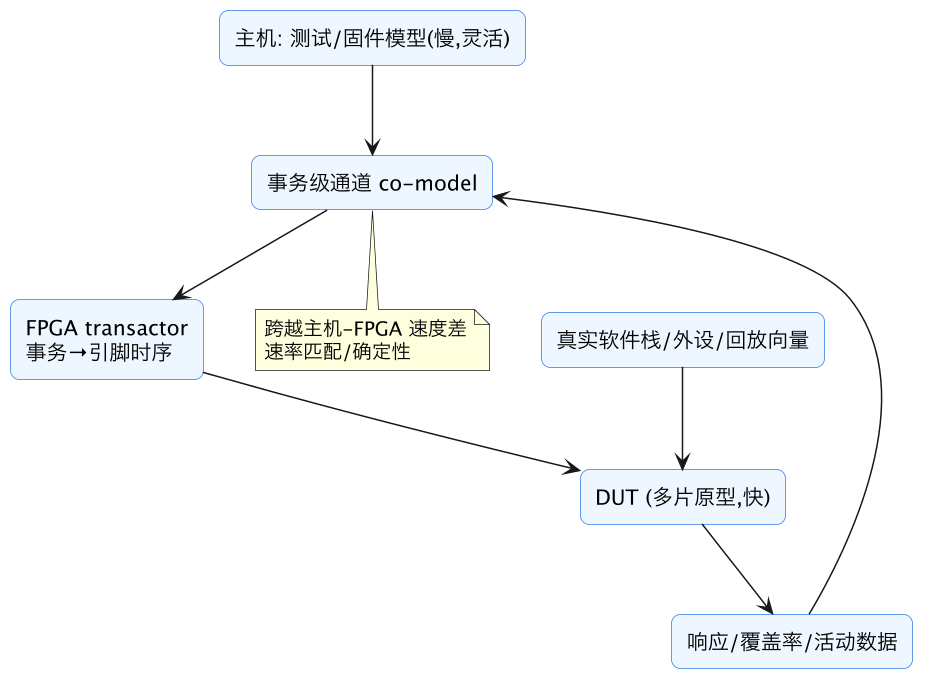
解决方案是事务级抽象:主机一次调用表达一个完整事务(「发一包 64 字节、头字段 X」),事务成批送进通道;FPGA 侧的 transactor(事务处理器)把事务展开成多周期引脚时序自主驱动 DUT,DUT 的响应由 transactor 收集、聚合成事务再回传。主机与 FPGA 之间只在事务边界握手,握手频率比时钟频率低几个数量级。这正是协同建模(co-model / co-simulation)的核心思想,SCE-MI(SCE-MI 是 Accellera 标准化的协同建模接口,商用 Emulator 普遍兼容其通道语义)定义的就是这类通道的标准形态。
三、co-model 架构
三个组成部分:
- 主机侧(HDL 无关的 test program + BFM 抽象层):用 C/C++/SystemC/Python 写的激励模型(如「理想 NVMe 盘」「流量生成器」),通过 DPI/共享库/PCIe 驱动调用通道 API(
send_txn(buf)/recv_txn()); - 通道(channel):主机内存与 FPGA 侧缓冲之间的高速 DMA 管道(PCIe/以太网/JTAG 慢速兜底),带 credit/水位流控;
- FPGA 侧 transactor:综合进比特流的状态机/协议 BFM,一端是通道缓冲(事务内存),另一端是 DUT 引脚时序(AXI/AHB/USB/PCIe 等接口协议),可能还有时钟抑制逻辑(clock gating control)。
一个 co-model 设计里可有多个 transactor(多个接口同时被模型驱动),它们通过 13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频连到不同 FPGA 片上的 DUT 接口。与仿真器/emulator 的混合互联形态见 37。
四、通道的时间语义:input/output/trace
SCE-MI 风格三类通道,时间语义不同,搭错会直接产生假结果:
- input(inbound 事务):主机→FPGA。事务一旦进入 FPGA 缓冲,何时被引脚化由 FPGA 自主决定——主机不指定精确周期,因此多个 input 通道间没有「主机指令序=引脚序」保证,需要严格时序关系的激励必须由 FPGA 侧调度器编排,而不能靠主机调用顺序;
- output(outbound 事务):FPGA→主机。DUT 引脚活动被 transactor 监测并聚合成事务(如「收到一包」),带 FPGA 侧时间戳/序号;
- trace(采样通道):周期级采样流(与 22 Gate 域信号采集 ILA/trace/带宽深度权衡同源),量大、按时间窗口导出,给波形/活动统计用。
阻塞 vs 非阻塞:input 缓冲满时 send 可阻塞(背压),也可用非阻塞+credit;output 用环形缓冲,主机来不及取时策略要明确(覆盖最旧 / 丢包计数 / 反压 DUT),丢数据必须有计数器且默认报错——静默丢包会污染覆盖率与活动统计。
五、速率匹配与确定性模式
通道吞吐再高也有抖动,两种运行模式:
- 确定性模式(cycle-accurate / lock-step):transactor 没有就绪事务时,由它控制抑制 DUT 时钟(clock gating/stall,经 MMCM 使能或停时钟分发),DUT 被冻结等待;事务就绪后恢复。这样激励与响应严格可复现、可与仿真逐周期对拍,代价是平均速度取决于主机响应(burst 之外会慢)。适合功能验证、bug 复现、向量回放;
- 实时模式(live/timed):DUT 时钟自由跑,transactor 按时间戳/实时规则注入,跟不上就报溢出。适合真实软件栈、真实外设互操作(不能冻结真实链路对端)和性能/吞吐测量。
模式选择必须写进场景配置:在实时模式下得到的时序相关 bug 现象和在锁步模式下不同(死锁可能因为时钟被冻结而不复现)。跨片/跨 transactor 的同步靠全局 barrier 事务(所有通道到达同步点再一起放行)和 FPGA 侧公共时基。
六、多通道编排、真实外设与环回
- 多 transactor 场景(如 CPU 子系统在片 0、DDR 模型在片 1、网络模型在主机 B)由场景脚本统一编排启动顺序、barrier、超时;
- 真实外设经板级接口直接接入(此时该接口不用 transactor,而是真实 PHY),混合拓扑里要清楚哪些边实时、哪些边事务化;
- 环回(loopback):DUT 的输出口经简单 transactor 折回输入口,用于存储/网络子系统的自给自足流量;
- 仪表(协议分析仪、逻辑分析仪)旁路接入做独立见证,与 22 Gate 域信号采集 ILA/trace/带宽深度权衡 片内采集互补。
七、可复现性:让一次上板运行能再来一遍
原型常被诟病「跑一遍就没了」,工程对策:
- 种子管理:所有受约束随机(CRV)激励的种子随用例记录;随机发生在主机侧(软件随机)时直接可重放,发生在 FPGA 侧 LFSR 时要能由寄存器写入初始种子;
- 录制/回放:把 output 事务和 trace 录制归档(带 build_id,20 比特流烧录与四方版本一致 manifest/门禁);失败现场可用「回放 input 事务流 + 同种子」重放;引脚级向量回放用于把仿真里抓到的 bug 搬到板上加速复现;
- 日志与时间对齐:主机日志(事务级时间戳)、串口/固件 print、片上 trace 用公共时基(周期计数)对齐,三者在同一时间轴上才能做根因分析;
- 非确定性来源登记:真实外设流量、温度导致的 SerDes 漂移、多核竞争——涉及它们的 bug 必须注明复现概率与次数。
八、两类负载的不同搭法,以及与覆盖率/调试的分工
- 软件验证负载:OS+应用自驱,co-model 主要提供外设世界模型(盘、网、控制台);关注功能正确性、长稳、驱动兼容;多在锁步与实时混合模式下跑(启动阶段实时,特定测试段锁步);
- 活动/性能评估负载:必须实时模式跑真实度高的 benchmark(视频流、网络包、典型业务 mix),时钟不能停(停了活动率就失真),激励 mix、时长、采样窗口预先定义,产出的活动数据经 22 Gate 域信号采集 ILA/trace/带宽深度权衡→23 Gate→RTL 数据回映 查表/聚合/SAIF→25 真实激励驱动 ASIC 签核 SAIF 反标/边界;
- 覆盖率回收与检查:断言/覆盖率收集在 FPGA 速度下代价高,通常只把轻量检查器(协议违例计数、断言命中位)放进 transactor/DUT 探针,详细功能覆盖率与代码覆盖率仍以仿真为主、原型补长场景增量(24 活动覆盖率与性能调试闭环 热点/瓶颈/回放);
- 与 Emulation 的分工(37/06 原型验证系统全景与文档地图):需要海量调试可见性、周期级全信号追溯用 Emulation;要跑真实软件栈、真实外设、最大吞吐用 FPGA 原型;两者共享同一套事务级 test program 是成熟团队的标志。
九、事务级协同建模:在「速度」与「真实」之间连续可调
阶段 5 的激励不只有「RTL testbench 搬上来」和「真实软/硬件接进来」两个极端,工程上更常用的是一条事务级(transaction-level)协同建模的光谱:同一个被测设计,可以让不同部分以不同的抽象级别和速度运行,再通过通道在边界上对齐,从而在验证速度、真实度、可见性三者之间按需取点。
理解这条光谱,先区分两个层次。引脚/周期级模型在每一个时钟沿交换逐位信号,最真实但最慢——这正是把 RTL testbench 直接拖上原型后跑不快的原因:主机为每个周期的逐位翻转付出大量通信开销。事务级模型把「一次突发传输、一个网络包、一条指令、一笔 AXI 传输」封装成单个事务一次性投递,通道上传递的是「从地址 A 读 256 拍」这样的粗粒度描述,由原型侧的一个总线功能模型(BFM/transactor)在片上把事务展开成真实的逐拍握手。通信事件数随事务数而非周期数增长,速度可提升几个数量级,代价是边界内部的逐拍细节由 BFM 决定、可见性变粗。于是同一个测试平台可以分层:软件栈和流量生成器跑事务级追求速度,关键接口上的真实 RTL/物理外设跑周期级追求真实,transactor 就是两层之间的翻译器。
更进一步,混合抽象让「真实」成为一个可替换维度。同一个事务源,后端可以接:行为级的简易存储器模型(最快,用于 bring-up)、时序较真实的存储/器件模型、RTL 实现的真实控制器、乃至最终的真实物理芯片和外设。原型团队常用的策略是先全用快而粗的模型把通路打通,再按风险逐个替换成真实部件——哪一段最可能出问题(如 DDR 控制器与 PHY、高速接口协议、与软件交互的寄存器顺序),就优先把哪一段换「真」。每次只替换一个变量,问题归因才清晰,这和串行链路 bring-up 自底向上的思路一脉相承。
速率匹配在事务级有了更优雅的实现。 周期级协同要靠停钟/流控把两边硬性同步,而事务级可以用深度足够的命令队列/邮箱做解耦:主机成批投递事务、原型以线速消费,平均速率匹配即可,不必逐周期对齐;只有当测试要求确定性(要逐比特复现某次失败)时,才在关键检查点插入屏障并切换到锁步模式。这样日常的吞吐测试跑得飞快,需要时又能退回到可复现的确定模式——两种模式共用同一套事务和同一批用例,只是通道的时间语义不同。
可复现性在事务级反而更容易保证,前提是管好三件事:事务源的确定性(同一随机种子生成同一序列、真实外设的非确定性输入要么录制成 trace 回放,要么隔离在确定性边界之外)、事务时间戳与投递顺序的明确定义(队列重排、多通道并发都要记录)、以及模型版本。成熟的 co-model 环境会把「用了哪个版本的 BFM、哪些部分是行为模型、哪些是真实部件、随机种子、屏障位置、速率模式」全部写进运行清单,使一次事务级运行和一次周期级运行一样可以原样再来一遍。
落到方法论上,事务级协同建模最大的价值是让激励投入可以复用和下沉:架构验证阶段写的事务发生器和记分板,能一路沿用到原型 bring-up、长软件场景和回归;换的只是后端接的模型真实度和通道实现。这也回应了本篇的分工主题——co-model 不是一次性的「接根线」,而是一套分层、可替换、可在速度与真实间连续调节的激励基础设施,原型团队、验证团队和软件团队在同一套事务接口上协作,各自取自己需要的运行点。
十、长软件负载与错误注入:原型激励侧的两类高价值场景
事务级协同建模搭好骨架之后,有两类负载最能体现「真实速度 + 真实软件」相对仿真的独特价值,也是阶段 5 投入产出比最高的用法:真实软件长场景的驱动,以及受控的错误注入与压力测试。
第一类:让真实软件栈当激励发生器。 仿真里跑不完的东西——操作系统启动、完整的驱动初始化序列、真实协议栈建链、固件加载数千个配置寄存器、应用程序跑几分钟到几小时的业务流量——在原型上可以接近实时地运行。这里的关键认知是:软件不是「被验证对象」,而是目前能找到的最真实、覆盖最广的激励源。手写定向 testbench 时,你只会给模块喂「你认为它会收到」的事务;而真实软件会按真实顺序、带真实的状态依赖和时序间隔,访问你从没想到的寄存器组合。原型团队要做的是把软件的总线访问经 transactor/桥接高效接入 DUT(事务级投递、批量命令、必要时用真实硬核 CPU 或软核直接在片上产生流量),并提供软件可见的观测钩子(性能计数器、断言命中、trace 触发),让长运行不只是「跑了很久」,而是「跑了很久且每段都可归因」。配合确定性模式(固定种子、可回放的外设响应、屏障与录制),一次长软件运行发现的问题才能被压缩成可回归的短用例。
长场景尤其擅长暴露三类仿真难覆盖的问题。 一是状态空间长尾:计数器回绕、表项满后再插入、长时间运行后的资源泄漏与描述符耗尽,这些可能要数百万次事务后才出现;二是真实并发:多核/多主同时访问、中断与正常流量交错、死锁和活锁,只有在真实时序和真实操作系统调度下才自然发生;三是软硬件接口的契约偏差:驱动对某寄存器位的理解和 RTL 实现不一致、对完成时间的假设过紧、状态机在特定软件序列下进入未定义态。这些问题在 bring-up 早期用真软件打,远比在流片后或仿真硬凑条件便宜。
第二类:错误注入(error injection)与极端压力测试。 原型相对真实芯片的一个巨大优势是「搞坏了也无所谓、且什么都能注入」。可以在事务通道或片上插入故障点:随机翻转传输中的数据/CRC、强行制造总线超时与不完整突发、让存储返回错误标志、周期性插入反压或长气泡、拔插式地让某个外设/链路消失再恢复、注入时钟漂移乃至(在允许的版本里)可控的亚稳窗口。因为运行在 FPGA 上且速度快,可以把这些故障以真实速率、在真实软件无感知或有感知的情况下重复成千上万次,验证错误处理、重试、降级和恢复逻辑——这类逻辑在正常功能测试里几乎从不被执行,却是系统可靠性的主体。
做错误注入要守住三条工程纪律。 一是可复现:每次注入都有故障类型、位置、时间戳、随机种子的完整记录,并尽量在锁步/确定性模式下可重放,否则「压测时挂过一次」无法变成可修复的缺陷;二是隔离与标记:注入逻辑只存在于专用的故障测试 build,比特流头明确标注 fault-injection enabled,绝不能混进性能/活动采集或签核用 build——故障点本身会改变时序和活动;三是预期结果先行:每类故障要预先定义系统的正确反应(报错计数、重试成功、链路重建、不产生死锁和数据结构破坏),用片上断言和记分板自动判定,而不是靠人肉盯着「好像恢复了」。把长软件负载与错误注入结合,原型就从一个「功能演示平台」升级为能回答「真实地跑很久、并在各种倒霉条件下,系统还对不对、稳不稳」的可靠性验证平台——这正是仿真受限于速度、硅后受限于不可控和不可观测,都难以独立覆盖的地带。
十一、co-model 的性能工程:通道往往才是瓶颈
co-model 环境搭起来之后,团队很快会发现:DUT 在 FPGA 上明明能跑几十兆赫,整体速度却常常只有几十到几百千赫——瓶颈几乎不在被测逻辑,而在主机与原型之间的协同通道。这一节用性能工程的视角拆解瓶颈并给出优化路径。
先建立带宽账。 一次周期级握手的成本不是数据位宽决定的,而是往返延迟决定的:主机发一拍、等 FPGA 应答、再发下一拍,每拍都付一次完整链路延迟(JTAG 可达微秒级),有效频率约等于「一除以往返延迟」。要算清两种极限:纯延迟受限模式(每事务必须等应答,频率≈1/RTT)和流水/批量模式(事务成批发出不必逐拍等待,吞吐≈包大小/间隔时间)。通道选型直接决定账怎么算——JTAG 延迟高带宽低适合偶发控制,PCIe/以太网延迟低带宽高适合持续数据流,SerDes 直连用于 GB 级 trace 导出。
三个最有效的提速杠杆。 第一是抽象层级上移:从逐引脚逐周期改为事务级,通信事件数随事务数而非周期数变化,通常带来一到三个数量级级别的提升,这是性价比最高的一招。第二是时间解耦:把强锁步(每拍同步)改成松弛同步,用片上命令 FIFO 和响应 FIFO 吸收往返延迟,主机批量投递、原型批量消费,只在检查点(需要观测结果或处理中断时)做屏障同步;测试越能「跑一段、看一次」,速度越接近原型裸速。第三是把计算留在数据产生的地方:比较器、期望数据、协议检查和活动聚合都放进片上,主机只接收违例通知和摘要结果,而不是把海量中间波形搬上来再判断。
中断与事件处理是隐蔽杀手。 若每个中断都要停下来等主机软件响应(出队、查寄存器、填数据、恢复运行),高频中断会把性能打回逐周期模式。优化做法包括:把中断处理表放进片上、用向量或队列批量上报、对可预测的设备响应预先装填响应数据(甚至用简单的片上行为模型直接应答),让主机只处理真正异常的事件。存储模型尤其典型——用片上真实存储或高速映射承载绝大多数访问,主机只服务明确标注的监控地址范围,避免每次取指都穿越通道。
速度分层要显式管理,防止「偷偷变慢」。 建议为同一测试定义几个运行点:全速自由运行(吞吐测试,无主机交互)、松弛同步(日常功能回归,批量+检查点)、锁步(缺陷复现和波形比对,逐拍确定)。在测试报告里标注每个用例实际处于哪一档、实测了多少事务/秒,避免「原型很快」的笼统印象掩盖某些用例实际跑得比仿真还慢的事实。通道利用率、FIFO 满/空次数、同步屏障次数、主机端服务延迟都应有计数器——它们就是 co-model 这个「系统」的性能剖视信号,优化前后用数字说话,和 RTL 性能调试是同一套方法论。
最后是容量与成本账。 片上缓冲和片上模型占的是宝贵的原型资源,每给协同逻辑多分一个 BRAM,DUT 可用容量就少一块;高速导出通道占用的 SerDes 也可能和业务接口冲突。因此协同架构要和分区规划一起做:哪些观测和响应必须在片上、哪些可以容忍主机延迟、哪些测试干脆脱机运行只回收摘要,这些取舍本质上是用 DUT 容量换协同速度,应在阶段 4 的资源预算中明确立项,而不是上板后边撞墙边补资源。
知识脉络
与系列及现有篇目的衔接
- 混合/事务级互联:专家 37 FPGA 与仿真器互联
- 采集侧:22 Gate 域信号采集 ILA/trace/带宽深度权衡、45 片上 trace 系统
- 软件/SoC 背景:26 Zynq SoC 入门、29 FPGA 嵌入式软件、芯片侧 RISC-V 入门
- 下游:24 活动覆盖率与性能调试闭环 热点/瓶颈/回放
总结
一句话总结:阶段 5 的核心是让真实而有代表性的事情在板子上发生,负载光谱从真实软件栈(OS/应用自驱,速度和活动代表性最高)、真实外设/仪表、事务级 co-model、向量回放直到裸寄存器激励;主机与 FPGA 速度相差 10⁴~10⁶ 倍,逐周期喂激励会让原型停等死,所以用事务级抽象跨越鸿沟——主机一次调用表达一个完整事务并成批送入高速通道,FPGA 侧综合进比特流的 transactor 自主把事务展开成多周期引脚协议时序、再把响应聚合成事务回传,双方只在事务边界握手;co-model 由主机测试程序/BFM、DMA 通道(带 credit 流控)和 FPGA transactor 三部分构成;SCE-MI 风格通道分 input(注入时机由 FPGA 自主决定,不能靠主机调用顺序保证跨通道时序)、output(响应聚合,溢出策略必须显式且丢包默认报错)和 trace(周期采样流)三类;速率匹配有两种模式——锁步确定性模式用 transactor 抑制 DUT 时钟等激励、严格可复现可对拍,适合功能验证和 bug 重放,实时模式时钟自由跑、适合真实软件/外设和性能活动测量,跑错模式会让死锁类问题不复现或让活动率失真;多 transactor 用全局 barrier 和公共周期时基编排,真实外设走实时边、环回流量自给自足,仪表旁路做独立见证;可复现性靠种子(主机随机直接重放、片上 LFSR 可写初值)、事务流/trace 录制回放(全部带 build_id)、主机日志/串口/片上 trace 三源在公共时基上对齐,并登记真实流量等非确定来源;软件验证负载重功能与长稳、活动评估负载必须实时跑 benchmark 且时钟不能停,轻量检查器可上片、详细覆盖率仍归仿真、长场景增量由原型补,与 Emulation 分工是全信号可追溯选 Emulation、真实栈与最大吞吐选 FPGA 原型,成熟团队让两者复用同一套事务级 test program。