DFT 物理实现:scan 链、测试压缩、OCC、MBIST 与 boundary-scan 的完整落地流程
更新时间:2026-10-03。逻辑综合阶段的 DFT 插入(scan 替换、压缩逻辑生成、MBIST 挂载)交付的是一份「功能上可测」的网表,但这份网表里所有的测试结构都还只是逻辑存在:scan 链的连接顺序是随便排的,OCC(On-Chip Clock Controller,片上时钟控制器)还没有时钟树的概念,MBIST 的存储器可能还没摆位置。DFT scan 与 ATPG(Tessent) 讲过逻辑侧的插入与向量生成,scan 链 reorder 与时序 拆过链序问题的一个侧面。这一篇是枢纽深文:把 scan 链、测试压缩、OCC、MBIST、boundary-scan 五条线在物理实现侧的落地动作串成一套完整流程,回答「逻辑 DFT 插完之后,后端工程师手里到底还有哪些活」。
本文要回答的问题
- 逻辑 DFT 插入后的网表进入物理实现时,哪些测试结构是「假连接」必须重做?
- scan 链在布局之后为什么要 reorder,重连的约束和手段是什么?
- 测试压缩逻辑(EDT/压缩器)在物理侧带来哪些新的拥塞和时序问题?
- OCC 为什么在 CTS 阶段是「二等公民」,它和功能时钟树怎么协同?
- MBIST 控制器、bypass 逻辑与存储器的物理布局有什么讲究?
- boundary-scan 链穿 IO 环的顺序约束怎么落地,测试模式时序怎么收敛?
一、总览:DFT 在物理实现流程里的五个触点
先建立全局图景。逻辑 DFT 插入之后,物理实现流程里 DFT 相关的动作分布在五个触点上:布局前的 DFT 感知(scan chain 的 reorder 能力声明、测试单元的位置约束)、布局中的 scan 链物理化重连、CTS 阶段的 OCC 集成、布线阶段的 MBIST 绕线与测试总线处理、签核阶段的测试模式时序收敛。这五个触点横跨后端主线全程,不是某一个步骤的「附加任务」——这就是很多项目里 DFT 问题拖到签核才爆雷的根源:前面每个触点都默认「后面会处理」,后面发现前面没留余地。
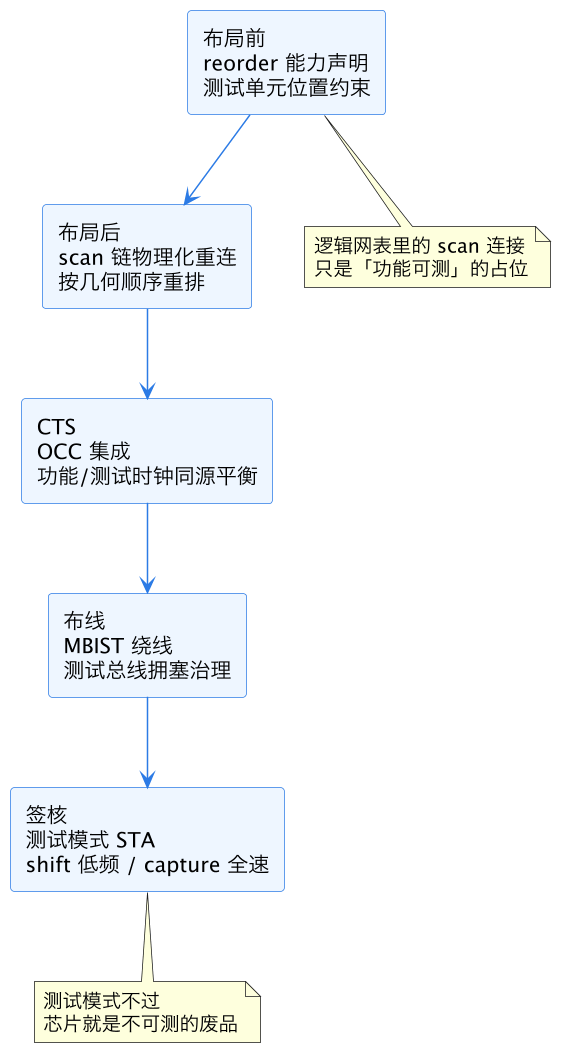
读这张图要抓住一条主线:DFT 物理实现的本质是「把逻辑上正确的测试结构,逐步兑现成物理上可实现、时序上可收敛、制造上可工作的结构」。每个触点解决的问题不同,但它们共享同一份测试架构定义(几条链、几个压缩域、几个 OCC、几个 MBIST 接口),所以这份定义必须在布局前就冻结——后面任何触点改动测试架构,前面的工作都要返工。
一个容易低估的事实是测试逻辑的体量。打开测试压缩的现代设计里,DFT 相关逻辑(压缩器、OCC、MBIST 控制器、bypass 选择器、测试数据通路)占总面积 3% 到 8% 并不少见;scan 链的走线量在布线图里常常是第一或第二大的网络类。把它当「旁路小事」的规划,拥塞报告会教你做人。
二、scan 链的物理化:从随便连到按几何连
逻辑插入时工具连 scan 链的依据是网表顺序或功能模块边界,完全不考虑触发器在版图上的最终位置。一条链如果在版图上呈「折返跑」——链尾在芯片东边、下一个链头在西边——scan 数据通路就会贡献大量长走线,既挤占布线资源又让 shift 时序恶化。所以布局一定之后的第一件事,就是 scan chain reorder:保持每条链的触发器集合和所属压缩域不变,按物理邻近度重新排列链内顺序、必要时在链间做等量交换。scan 链 reorder 与时序 讲过 reorder 的算法与 scan 数据路径的时序特征,这里补物理侧的工程纪律。
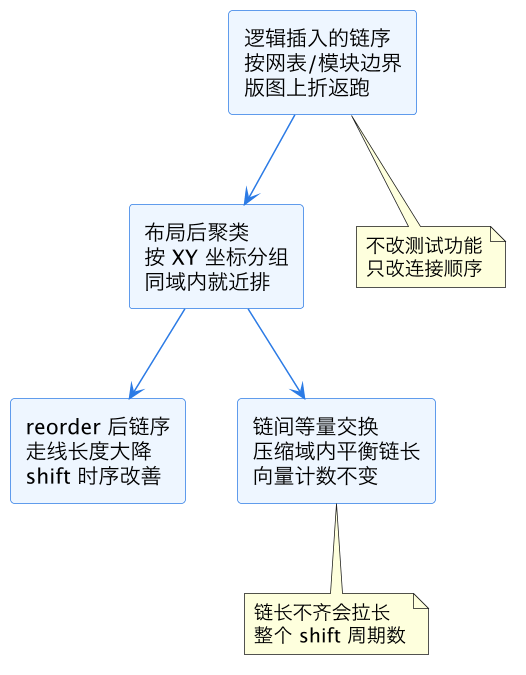
reorder 有三条硬约束不能破。第一,锁存器/触发器的时钟域和极性段必须保持连续——链内从负沿触发段跳到正沿触发段的位置叫 lockup 点,那里原本插了 lockup latch 或 lockup flop,reorder 时这些点位要么不动、要么在新位置补插,漏一个整条链 shift 就错位。第二,压缩域边界不能跨:同一条物理链不能混两个压缩域的单元,否则压缩器输入输出对不上,ATPG 向量直接废。第三,链数与链长平衡:ATE(自动测试设备)按最长链决定 shift 周期数,链长参差不齐等于白烧测试时间,reorder 输出必须做链长均衡报告。
还有一条软约束决定 reorder 的实际收益:功耗。scan shift 是全片触发器同步翻转的场景,shift 功耗可以冲到功能功耗的好几倍,reorder 如果只按几何最优排,可能把同一时刻翻转的触发器在版图上聚成一坨,造成局部 IR drop 尖峰、让 shift 中途数据出错——这种错误在测试机上表现为随机性失效,极其难查。主流 reorder 引擎都带功耗感知开关,会把高翻转概率的单元在版图上打散;开与不开要在向量体积、走线长度、shift 峰值功耗三者之间权衡,先进工艺节点上这条已经从「可选优化」变成「默认开启」。
工程上的操作顺序是:布局(含测试单元的摆放)收敛后导出 scan def 或链段文件,用后端工具的 reorder 引擎或 DFT 工具的物理感知模式重连,再用形式验证(LEC)确认重连前后的扫描功能等价——reorder 改的是物理顺序不是逻辑功能,但「连线接错」这种低级事故在几万触发器的链上永远不缺席,LEC 是兜底纪律。等价性验证的流程框架见 数据流 X1 之交接契约 里 DFT 交接清单的那部分约定。
三、测试压缩逻辑的物理侧:压缩器不是免费的
测试压缩(Synopsys DFTMAX、Mentor EDT 这类结构)用很少的测试引脚驱动大量内部短链:输入侧一个解压缩器(通常是 XOR 网络加少量寄存器)把少量通道展开成几百条内部链,输出侧一个压缩器(XOR 树加可选的 mask 逻辑)把几百条链的响应压回少量通道。逻辑侧的收益是向量体积和测试时间降一到两个数量级;物理侧的代价是两种新的结构性问题。
第一个是扇出与拥塞。解压缩器的每个输出要喂几十上百条链的链头,这些链头散在全芯片——压缩逻辑天然是「一点对全片」的高扇出结构。如果压缩器摆在一个角落,它的输出网络就是一团横穿芯片的测试总线,布线密度热点报告里它经常名列前茅。第二个是时序路径的形态怪:capture 模式下被测路径还是功能路径,但 shift 模式下压缩器输入输出都要工作,mask 逻辑的时序如果按功能约束去优化纯属浪费,不约束又可能报假违例,模式定义必须干净。
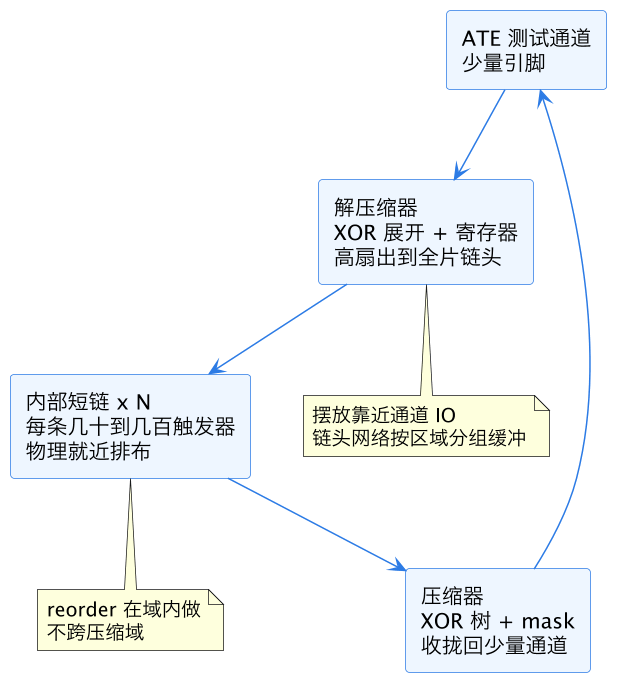
物理侧的对策有三个层次。摆放层次:解压缩器靠近测试通道 IO、压缩器也靠近通道 IO,让「一点对全片」的网络从 IO 附近出发,总线走向单一方向而不是横穿。结构层次:大设计把压缩域按物理区域切分(每个域管一片区域的链),总线只在区域内辐射,跨片总线消失——这也是为什么顶层规划阶段就要决定压缩域数量,它和 数据流 S3 之布局与 floorplan 里的区域规划是同一张图上的事。约束层次:shift 路径用低频时钟约束(典型 10MHz 到 100MHz,够慢所以 shift 时序几乎白送),capture 路径单独一个模式按全速约束,mask 和压缩器内部路径明确归到测试模式,不让功能模式的优化引擎去碰它们。
四、OCC 集成:测试时钟的「二等公民」问题
OCC 是插在功能时钟根部的测试时钟切换结构:功能模式下透传功能时钟,shift 模式下送 ATE 给的慢速测试时钟,capture 模式下从 PLL 功能时钟里精确截取两个沿(launch 沿和 capture 沿)做 at-speed 测试。逻辑上它就是一个时钟选择器加沿截取状态机,物理上它却卡在一个极其敏感的位置:时钟树的最根部。
问题在于 CTS 的视角。功能时钟树的 sink 是功能触发器,OCC 输出的测试时钟的 sink 是 scan 触发器——其实是同一批触发器,只是时钟源在 OCC 前后切换。CTS 必须对「经过 OCC 的所有时钟路径」做统一平衡:功能模式下从 PLL 经 OCC 到 sink 的插入延迟,和 capture 模式下从 PLL 经 OCC 截沿电路到 sink 的插入延迟,要走的是同一棵物理树。如果 OCC 在 CTS 配置里没有被声明为时钟树的「穿透点」(through pin),工具可能在 OCC 内部路径上做出错误的延迟假设,或者在 OCC 前后各建一棵树导致接口处 skew 爆炸。
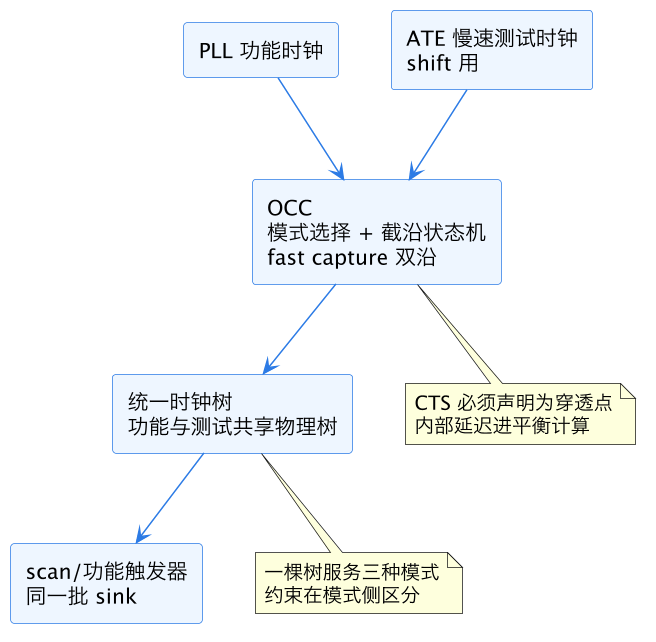
这张图的核心是「一棵树、三种模式」:功能、shift、capture 共用 OCC 之后的物理时钟树,区分全部落在 SDC 的模式定义上。工程纪律有四条。第一,OCC 的时钟引脚特性化必须完整(Liberty 里要有清晰的时钟穿透弧),自建 OCC 软核的要确认库视图,背景见 Liberty 特征化流程。第二,OCC 摆放在时钟根附近、靠近 PLL,别让它离根太远引入额外的根前走线。第三,capture 模式的 at-speed 时序是签核级 STA 的对象,沿的宽度由 OCC 截沿电路保证,STA 只验证数据路径在两个功能沿之间收敛——这部分的模式搭建归 MMMC 与角点模式 框架管。第四,OCC 的测试使能信号本身是异步接口,到 OCC 的时序约束要放足,避免使能毛刺截出不完整的 capture 沿。
CTS 侧的完整方法论(skew 预算、NDR、useful skew)见 CTS 时钟树综合枢纽文,本篇只强调增量:带 OCC 的设计里,CTS 报告的每个时钟域都要分模式看,功能模式 skew 达标的树在 shift 模式下因为时钟源不同(ATE 引脚进来),走线根部多了一段 IO 到 OCC 的路径,这段的延迟和抖动要单独评估。
五、MBIST 的物理落地:控制器、collar 与绕线
MBIST(Memory Built-In Self-Test,存储器内建自测)在逻辑侧交付的是一组控制器加每个存储器周围的测试 collar(地址/数据/控制信号的测试复用逻辑)。物理侧的关键决策全在「距离」两个字上:collar 必须贴着存储器阵列摆,因为 collar 和存储器之间跑的是全速 at-speed 路径——BIST 的意义就是在真实工作频率下测存储器,路径上多绕 500 微米,测出来的就不是真实频率了。
这带来 floorplan 阶段的一连串约束。存储器摆在哪,它的 collar 就得跟到哪,collar 里的触发器和逻辑要占存储器周边的宝贵面积;多个存储器共享一个控制器时,控制器到各 collar 的走线长度决定了共享方案的可行性——控制器太远,共享省下的面积被走线拥塞和时序缓冲器吃回去。大设计的做法是按区域分组:每组存储器一个本地控制器,顶层再有一个调度器串起各组,这样 BIST 总线只在本区域内短距离辐射。
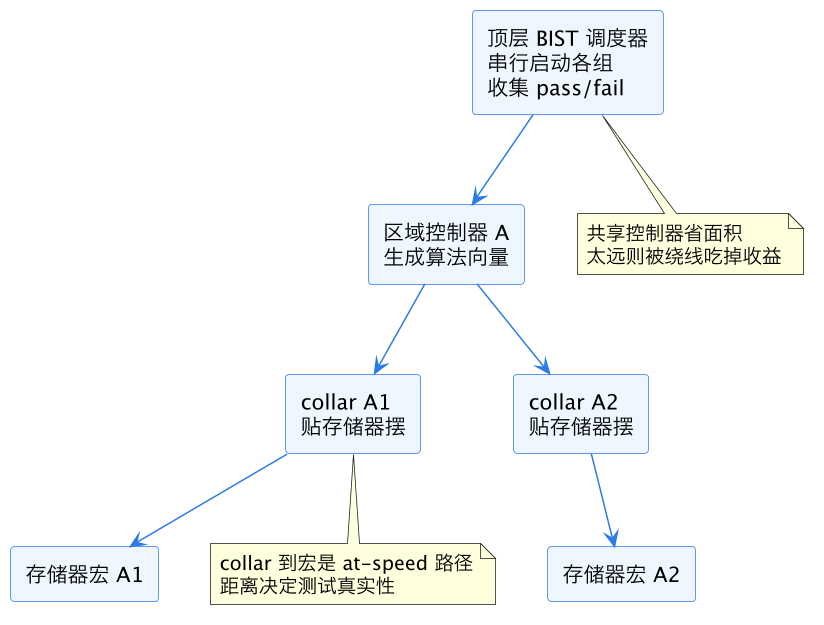
还有三类物理细节常被漏掉。一是 repair 信息通路:带冗余行列的存储器,MBIST 测出的修复地址要写到 eFuse 或寄存器堆,这条通路的走线和时序约束要在布线前规划,它跑得慢但线长,乱放就是拥塞源。二是 MBIST 时钟:BIST 通常跑功能时钟或专用测试时钟,时钟源选择逻辑和 OCC 类似地要进 CTS 视野。三是 BIST 期间的功耗:全片存储器同时跑 march 算法时电流非常可观,调度器往往要分组串行启动控制 di/dt,这个分组方案反过来影响控制器的物理划分——又一处「测试架构冻结要趁早」的证据。
另一个和版图强相关的点是存储器宏的朝向。macro flip 一下,collar 就得跟着换边,BIST 绕线长度和布线通道占用全变。所以存储器的摆放与朝向评审要把 MBIST 负责人拉上,不能等布线拥塞了再回头翻宏——那时候 floorplan 早已冻结,翻一个宏牵连的是整个区域的时序重收敛。测试向量数据格式和交接见 数据流格式之测试向量。
六、boundary-scan 与 IO 环:一条有顺序要求的链
boundary-scan(IEEE 1149.1,JTAG)在每个 IO 引脚旁挂一个边界扫描单元,所有单元串成一条环绕芯片的链,用于板级互连测试和内部测试访问。它的物理约束听起来简单——链必须按 IO 环的物理顺序连——但违反它的代价很隐蔽:链序错了功能上依然能 shift,只是 BSDL 文件里声明的引脚顺序和实物对不上,板级测试时激励打到了错误的引脚,这种问题往往到系统联调才暴露。
IO 环本身的实现(ESD clamp、power pad、corner cell)见 IO 环与 ESD clamp,本篇聚焦扫描链那一段。工程动作是:floorplan 冻结 IO 顺序后,从 IO 库工具导出边界单元的物理顺序表,交给 DFT 工具按这个顺序连 boundary-scan 链;链的走向沿 IO 环单向环绕,转角处经过 corner cell 里的透传段。TAP 控制器(JTAG 状态机)摆在 TCK/TMS/TDI/TDO/TRST 五个测试引脚附近,它到链头链尾的走线要短。
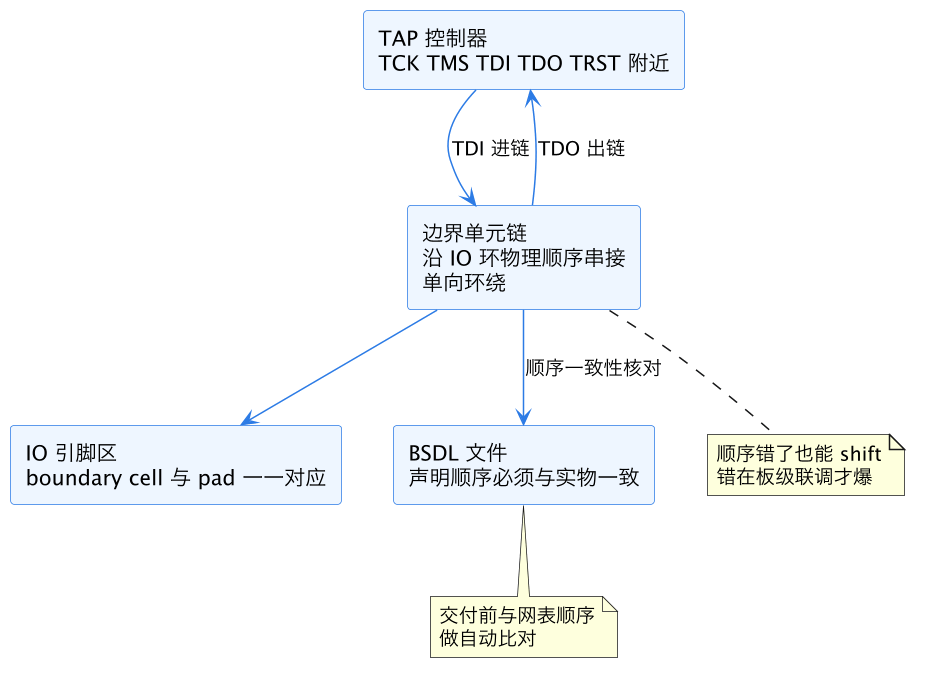
图里特意画了「链到 BSDL」这条边,因为这是 boundary-scan 物理化唯一的验收标准:网表里的链序、版图里的物理顺序、BSDL 声明顺序,三者一致。自动化比对脚本三十行就能写完,但前提是 IO 顺序在 floorplan 阶段真冻结了——IO 环后期调整(比如 SI 原因换两个差分对位置)必须同步触发 boundary-scan 重连和 BSDL 再生成,这个联动要写进 数据流 X3 之 ECO 变更传播 的变更清单里。
七、测试模式时序收敛:签核的最后一道 DFT 关
所有结构就位后,DFT 物理实现在签核阶段收口为一件事:测试模式的时序全部收敛。测试模式的 STA 至少分三个模式跑。shift 模式用慢速测试时钟,约束宽松,主要验 scan 数据通路上的 transition 和最大电容——shift 违例的典型不是 setup 而是 lockup 点缺失导致的保持错位。capture 模式(含 stuck-at capture 和 at-speed transition capture)按功能时钟全速约束,本质上是「换了一组时钟定义的功能时序」,测试模式下功能路径的 false path 定义、OCC 截沿的时钟波形声明都要精确,工具环境同 Signoff STA 与 PrimeTime。MBIST 模式验 collar 到存储器的 at-speed 路径和控制器内部时序。
| 维度 | shift 模式 | capture 模式 | MBIST 模式 |
|---|---|---|---|
| 时钟来源 | ATE 慢速测试时钟 | PLL 经 OCC 截取双沿 | 功能时钟或专用 BIST 时钟 |
| 频率量级 | 10 到 100 MHz | 全速 at-speed | 全速 at-speed |
| 主要检查对象 | scan 数据通路 transition、lockup 点 | 功能路径在测试时钟定义下的收敛 | collar 到存储器宏的路径 |
| 典型违例形态 | lockup 缺失致保持错位 | false path 漏定义报假违例 | collar 离宏太远 setup 不足 |
| 物理侧修复手段 | 补 lockup 单元、修 scan 走线 | 改模式约束、局部重平衡 | collar 挪位、缩短绕线 |
这张表是排障索引:测试模式报违例时先对号入列,判断它属于哪一类结构的病,再翻回前面对应的章节找手段——shift 的病回第二节,capture 的病回第四节,MBIST 的病回第五节。最忌讳的是拿着 capture 违例去改功能时序优化,那是拿测试模式的数据污染功能收敛。
一个特有的坑是模式间的约束污染。测试模式的 SDC 里为了好收敛,工程师有时大手一挥把测试使能相关路径全设成 false path——如果这些约束被无意带进功能模式的分析环境,功能违例就被掩盖了。纪律是模式文件物理隔离、每个模式的签核报告独立存档,合并视图只做展示不做签核依据。
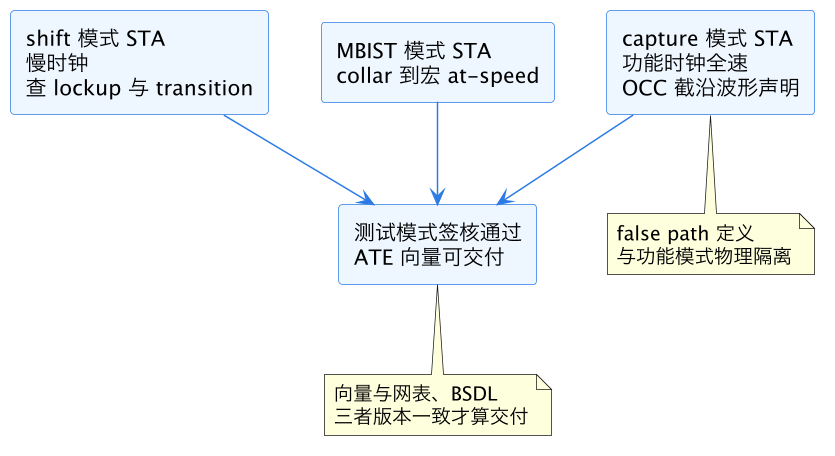
签核通过后的交付物是一致性绑定的一整套:带全部 DFT 结构的最终网表、各测试模式的 SDC 与 STA 报告、ATPG 向量(格式与版本见 数据流格式之测试向量)、BSDL、MBIST 配置与 repair 流程说明。这一整套里任何一件和硅片对不上,测试厂就没有能力把坏片挑出来——DFT 签核的严肃性正在于此:它签的不是性能,是「这颗芯片有没有资格被证明是好的」。
这一篇在知识体系里的位置
本篇是 eda/ 目录 DFT 专题的枢纽深文:逻辑侧基础在 DFT scan 与 ATPG(Tessent),链序问题深化在 scan 链 reorder 与时序,IO 环实现在 IO 环与 ESD clamp,向量数据交接在 数据流格式之测试向量;本篇把这四条长尾收拢,横向挂接主线流程的 数据流 S3 之布局与 floorplan、CTS 时钟树综合枢纽文、Signoff STA 与 PrimeTime、MMMC 与角点模式,变更管理挂 数据流 X3 之 ECO 变更传播,库视图背景挂 Liberty 特征化流程。
总结
DFT 物理实现的本质是把逻辑上可测的网表兑现成物理上可工作的测试结构:布局后按几何重排 scan 链并守住 lockup 点、压缩域、链长平衡三条硬约束,用 LEC 兜底重连正确性;测试压缩逻辑按区域切域、把「一点对全片」的总线压成本地辐射;OCC 声明为时钟树穿透点让功能与测试共享一棵物理树、区分全落在模式侧;MBIST 的 collar 贴宏摆、控制器按区域分组、repair 通路与 BIST 功耗提前规划;boundary-scan 链沿 IO 环物理顺序串接并以「网表、版图、BSDL 三者顺序一致」验收;最后以 shift、capture、MBIST 三个测试模式独立收敛的签核报告收口——DFT 签核签的不是性能,是芯片被证明为好的资格。