总线低功耗编码:从汉明距离到 bus-invert 与格雷编码的取舍
在 低功耗设计直觉:时钟门控、电源门控,为什么需要 UPF 里,降功耗的手段大多沿着「什么时候不让电路工作」展开,比如时钟门控按时间维度切断翻转来源。本篇则换了一个维度:不动工作节奏,而是改变数据在线上的表示方式,让同样的信息用更少的电平翻转传过去。推导基础是 CMOS 动态功耗公式,来历见 芯片功耗从哪来。
格雷码在本站已经出现过一次:数制与编码讲的是它「相邻码字只变一位」如何保证异步 FIFO 跨时钟域采样不采到中间态,落点是正确性;本篇再讲格雷码,落点是功耗,同一个性质的两种用法,读到第四节会明确划界。
本文要回答的问题
- 总线低功耗编码凭什么能省电?总线位线上的一次电平翻转,在 CMOS 电路里为什么对应一份确定的能量开销?
- 汉明距离与位线翻转数之间是什么关系,为什么它能充当总线功耗的估算量?
- bus-invert(总线反转编码)的判定规则、标志线和接收端还原过程具体是什么,最坏翻转数凭什么能压到 n/2?
- 格雷编码为什么只对连续地址总线有效,用在随机数据总线上会发生什么?
- 不编码、bus-invert、格雷编码三条路线,在工程上各自的回本条件是什么?
下面这张概念卡先给出全篇主线:三个分区是一条因果链,从物理开销一路推到编码决策,后面的编号节逐环展开。
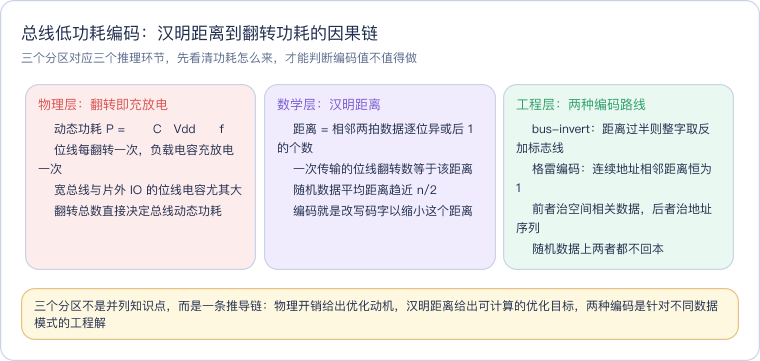
一、翻转即功耗:总线为什么是编码优化的主战场
CMOS 电路的动态功耗经典估计是 P = α·C·Vdd²·f:α 是翻转活动率,C 是节点负载电容,Vdd 是电源电压,f 是工作频率。对单个节点而言,一次 0 到 1 或 1 到 0 的翻转,都意味着负载电容经历一次充电或放电,能量开销近似为 ½·C·Vdd²。理解本篇全部推理,起点就是这个公式:既然每次翻转都有确定代价,那么减少翻转次数就是减少功耗,与降电压、降频率处在同一张能量账单上。
普通单元内部节点的电容大多只有飞法量级,总线位线则完全不同。一条位线往往要横穿大片版图、挂接多个输入引脚,线上还有中继缓冲器;片外总线更要经过封装引脚、ESD 保护电路和板级走线,等效电容可以比片内节点高出一两个数量级。片上数据总线、存储器总线(存储器的位线与字线结构见 片上存储器:SRAM、ROM 与存储阵列)、片外 DDR 与 IO,正是三类「单根线电容大、位线根数又多」的场景。32 根位线每根各翻一次,就是 32 份充放电同时入账。
这给编码优化留出了空间:信息不变,只改变比特的线上表示,让翻转的位线更少。但编解码器自身是组合逻辑,同样耗电、占面积、引入延迟,只有位线省下的能量超过它多花的能量,编码才回本。总线越宽、走线越长、片外占比越高越值得做;触发器之间的短连线谈编码,省的钱不够付编解码器的电费。
二、汉明距离:把位线翻转数变成可计算的量
要优化翻转数,先得能计算它。两个等长比特串 x 与 y 的汉明距离(Hamming distance),定义为它们逐位异或之后结果中 1 的个数,也就是 d(x,y) = popcount(x XOR y)。总线一拍传输一个数据,若上一拍线上是 x、这一拍发 y,那么值不同的位正好翻转、值相同的位保持,逐位异或结果里每一个 1 对应一根真实位线的一次充放电。结论直接而关键:一次总线传输的位线翻转数,等于相邻两个传输数据之间的汉明距离。
一个最小例子:3 位二进制计数从 011 变到 100,逐位异或得 111,汉明距离为 3,三根位线全部翻转;而从 010 变到 011,异或得 001,距离为 1,只有最低位翻转。一段传输序列的总翻转数,就是相邻数据汉明距离的逐拍累加,总线动态功耗随之被这个累加量线性决定。功耗优化问题就此转化为一个纯粹的编码问题:如何设计线上码字,让相邻码字的平均汉明距离尽量小。

读这张图抓住一条主线:蓝色是数据入口,紫色异或门把两根数据的差异算出来,橙色节点给出本文的核心等量关系——异或结果中 1 的个数既是汉明距离,也是物理世界真实翻转的位线数;灰色节点把每次翻转翻译成电容充放电,红色节点就是最终的功耗账单。后续两种编码方案,本质上都是在紫色节点之前插入一个码字变换,让橙色节点的计数变小。
再建立一个基准直觉:数据完全随机且各位独立时,任意一位两拍之间取值不同的概率是 1/2,n 位总线的平均汉明距离就是 n/2。没有任何编码能在对数据模式一无所知时凭空省电,收益必然来自数据中的结构,即相邻拍之间的相关性:bus-invert 利用空间相关性,格雷编码利用取值序列的相邻性。
三、bus-invert:距离过半就整字取反
bus-invert(总线反转编码)的思路近乎直白:既然发原码字要翻 d 根线,那么发它的逐位取反呢?反码字与上一拍线上数据的距离恰好是 n − d,因为原码字里每一位相同的地方,取反后就不同,反之亦然。两个距离 d 与 n − d 之和恒为 n,二者中较小的那个必然不超过 n/2。编码要做的,就是在两者之间挑省事的那个发出去。
完整规则分四步。第一,发送端保存上一拍的实际数据,计算本拍数据与它的汉明距离 d。第二,若 d > n/2,把本拍数据整字取反发送,并把一根额外的 invert(也称 flag)标志线拉高;若 d ≤ n/2,原样发送,标志线拉低。d 恰好等于 n/2 时按原样发送,避免无谓的标志线翻转。第三,接收端按标志线还原:flag 为 1 就对收到的字逐位取反,flag 为 0 直接采用。第四,两端各自更新保存值,进入下一拍。标志线本身也是一根要翻转、要布线的物理线,这是 bus-invert 第一项显式代价。
最坏情况的界可以这样直觉理解:发送端永远在 d 和 n − d 两个候选距离里选小的,而它们的和是 n,所以数据位线上的翻转数每拍都不超过 n/2,即 ⌊n/2⌋;不编码时这个最坏值是 n(相邻两拍恰好互补,全部位线翻转)。标志线每拍至多翻转一次,工程估算时通常把数据位线的 ⌊n/2⌋ 作为编码收益口径,再单独扣除标志线与编解码逻辑的开销。
下面用一个 8 位总线的四拍序列走完整个判定过程。表中所有数字均为演算示例、非实测,用来核对规则而不是测量结论。
| 周期 | 本拍数据 D | 上拍数据 | 汉明距离 d | 决策 | 线上码字 T | flag | 数据位线翻转 | 标志线翻转 | 不编码时翻转 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 11100000 | 00000000 | 3 | 原样发送 | 11100000 | 0 | 3 | 0 | 3 |
| 2 | 00011111 | 11100000 | 8 | 整字取反 | 11100000 | 1 | 0 | 1 | 8 |
| 3 | 11111111 | 00011111 | 4 | 原样发送 | 11111111 | 0 | 5 | 1 | 4 |
| 4 | 00000000 | 11111111 | 8 | 整字取反 | 11111111 | 1 | 0 | 1 | 8 |
逐拍核对,注意位线翻转要按相邻两拍的线上码字 T 来数,而不是按原始数据:第 2 拍若原样发,8 根位线全翻,取反后线上码字 T=11100000 与上一拍完全相同,数据位线零翻转,只付标志线 0 到 1 的一次翻转,8 次变 1 次;第 3 拍原始距离正好卡在 n/2,按规则原样发送、flag 拉低,但本拍线上码字 11111111 与上一拍线上码字 11100000 仍有 5 位不同,数据位线翻 5 次,再加上标志线从 1 退回 0 的 1 次,总翻转 6 次,反而比不编码的 4 次更亏——这拍如实展示了标志线与码字历史反噬收益的情形。四拍累加,编码方案总翻转 11 次(3+1+6+1),不编码为 23 次(3+8+4+8)。演算示例、非实测,真实收益完全取决于数据序列本身的相关性。
机制讲完,代价要单列清楚,它决定了 bus-invert 的适用面。
| 代价项 | 具体内容 | 工程后果 |
|---|---|---|
| 额外标志线 | n 位总线变 n+1 根物理线,flag 同样有负载电容 | 布线资源增加,位线越窄标志线占比越刺眼 |
| 编解码逻辑 | 发送端 n 个异或门加树状加法器算距离、比较器、受控取反;接收端按 flag 还原 | 增加组合逻辑延迟与一块自有功耗,总线时序预算被侵蚀 |
| 相关性前提 | 只比较相邻两拍,仅对空间相关数据有效 | 数据模式剧变时频繁取反,标志线自身翻转密集 |
| 随机数据失效 | 随机序列 d 在 n/2 附近波动,取反与否差不多 | 平均收益趋近零,扣掉标志线与逻辑功耗后倒挂 |
四、格雷编码:把相邻码字的距离钉死为 1
bus-invert 是「先看距离再决定」的自适应方案,格雷编码(Gray code)则是一张静态对照表:重新规定每个数值在线上的码字,使数值相邻的两个码字汉明距离恒为 1。二进制转格雷码只需要一行异或移位:
wire [n-1:0] gray = binary ^ (binary >> 1);反向转换用级联异或恢复,接收端电路略复杂但仍是纯组合逻辑。以 3 位序列为例,二进制 011 变 100 有 3 位同时翻转,对应的格雷码字是 010 变 110,只有 1 位翻转——这正是 数制与编码里讲过的反射构造性质。
把这个性质放到功耗视角,结论非常具体:如果总线传输的是连续递增或递减、或在相邻数值间跳动的序列,那么每拍恰好只有一根位线翻转,n 位地址总线的每拍翻转数从普通二进制的平均约 n/2、最坏 n,直接压成恒为 1。处理器取指、DMA 块传输、DRAM 行扫描都会产生大量连续地址,地址总线因此是格雷编码的天然战场。
但适用边界同样硬。格雷码保证的是「数值相邻则码字距离为 1」,数据总线上的载荷并不满足数值相邻关系:两个随机数据即便数值碰巧接近,其比特模式也无规律,映射成格雷码字后相邻拍的平均汉明距离仍然是 n/2,编码白做。换句话说,格雷编码优化的是取值序列的相邻性,不是比特层面的空间相关性;拿它处理随机数据,等于付了编解码逻辑却什么也没换到。此外格雷码字不适合直接做算术运算,下游若要比较、相加地址,必须先还原成普通二进制。
这里与本站已有内容显式划界:格雷码「相邻码字只变一位」的性质在 异步 FIFO 与 Gray 码指针中承担的是正确性职责——跨时钟域采样时只可能采到旧值或新值,杜绝中间态;本篇用同一性质压低地址总线翻转,承担的是功耗职责。同一个编码、两种立意,读那一篇时关心亚稳态,读这一篇时关心电容充放电,两者互不替代。
五、三种路线对比与工程选型决策
把不编码、bus-invert、格雷编码放在五个工程维度上对照,选型时先定数据模式,再定物理介质,最后才算账。
| 对比维度 | 不编码 | bus-invert | 格雷编码 |
|---|---|---|---|
| 适用总线类型 | 随机数据、短连线、窄位线 | 空间相关性强的宽数据总线、片外 IO | 连续或相邻取值的地址总线 |
| 是否需标志线 | 不需要 | 需要 1 根 invert/flag 线 | 不需要,但收发两端各需码制转换逻辑 |
| 编解码成本 | 零 | 异或树、 popcount、比较器、受控取反,延迟最显眼 | 一组异或移位,成本最低,反向转换略繁 |
| 最坏翻转 | n(相邻数据互补) | 数据位线压到 ⌊n/2⌋,另计标志线 | 连续序列恒为 1,非相邻序列无保证 |
| 随机数据表现 | 平均 n/2 | 平均 n/2,扣除自身开销后倒挂 | 平均仍约 n/2,纯亏编解码成本 |
成本排序决定回本门槛:格雷码最便宜,地址总线优先考虑;bus-invert 要养一整套距离计算逻辑和一根物理标志线,只有宽位线或片外大电容场景才赚得回来。片外 IO 单根线电容远大于片内连线,省下的能量足以覆盖编解码器,bus-invert 最早的工程应用正是存储器总线与板级接口,片内窄总线往往测不到正收益。片上总线的结构背景见 片上总线 AMBA 入门。
读这张决策图按颜色分工:红色是入口问题,两个蓝色菱形是仅有的两个判定点,绿色与橙色是两条被采纳的编码路线,紫色是编码出局后的回流方向。注意第一个判定优先问「是不是地址」,因为格雷方案不需要标志线、成本最低,命中就结束评估;只有数据总线才需要继续回答相关性与物理介质两个问题,任何一个答案为否,编码省下的位线能量都付不起编解码器的自身功耗,应当回到时钟门控等时间维度手段。
六、一个反例与一张知识导图
正误例最能说明选型纪律。设想一条 32 位片上数据总线,载荷是加密模块输出的密文——密文近似随机,各位独立且相邻拍毫无相关性。若仅凭「bus-invert 能把最坏翻转砍半」的印象加上反转编码:汉明距离 d 围绕 16 波动,取反发送的频率接近一半,标志线自身以约 50% 的概率翻转;数据位线的平均翻转与不编码几乎相同,却额外背上异或树加比较器的延迟,可能挤占关键路径时序,整笔账净亏。这正对应第三节代价表最后两行:编码的燃料是数据中的结构,随机数据里没有结构可烧。
把全篇的知识结构收成一张思维导图,复习时沿四条支路自上而下回忆即可。
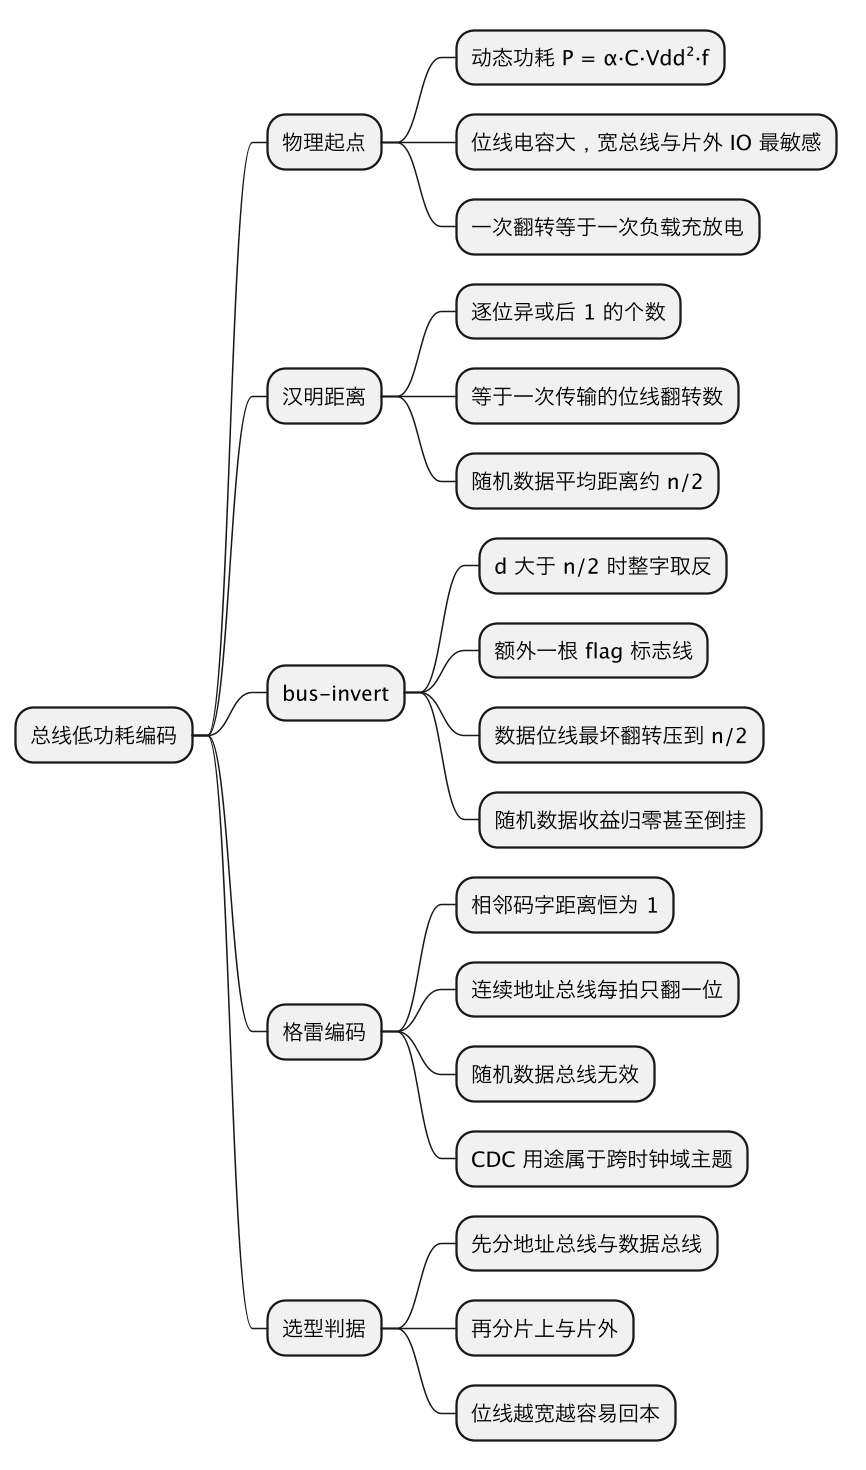
这棵树的第一层切分标准是「推理环节」而不是「方案罗列」:物理起点回答为什么省电要盯翻转,汉明距离回答翻转怎么度量,两种编码回答各自利用数据的什么结构,选型判据回答什么条件下该动手。最后一条支路要和反例一起记——判据里只要有一条不满足,结论就是不编码。
这一篇在知识体系里的位置
本篇属于芯片设计入门层的低功耗主题,向上承接功耗基础与低功耗总览:总线低功耗编码的功耗公式基础给出动态功耗公式与各类功耗来源,总线低功耗编码所属的低功耗方法族给出时钟门控、电源门控等时间维度的降功耗工具箱,同主题的机制深文可对照 门控时钟单元与毛刺:为什么不能直接用与门关时钟,看时钟侧如何处理翻转。横向与编码基础相连:数制与编码讲格雷码的构造与抗误码直觉,异步 FIFO 与 Gray 码指针讲同一性质在跨时钟域的正确性应用;物理介质背景见 片上存储器:SRAM、ROM 与存储阵列与片上总线 AMBA 入门。
总结
总线低功耗编码的全部推理可以收成一条链:CMOS 动态功耗 P = α·C·Vdd²·f 使每次位线翻转都对应一次确定的负载充放电,宽总线与片外 IO 位线电容大,翻转功耗占比高,编码优化才付得起编解码器的成本;一次传输的位线翻转数精确等于相邻两个传输数据逐位异或后的 1 的个数,即汉明距离,于是省电问题转化为缩小相邻码字平均距离的编码问题;bus-invert 利用原码字与反码字的距离之和恒为 n,在 d > n/2 时整字取反并用一根 flag 标志线通知接收端还原,把数据位线最坏翻转从 n 压到 ⌊n/2⌋,代价是标志线、编解码延迟与自身功耗,且只对相邻拍相关的数据有效,随机数据平均收益归零甚至倒挂;格雷编码把数值相邻的码字距离钉死为 1,连续地址总线每拍只翻一位、转换逻辑最便宜,但对取值无相邻关系的随机数据总线无效,它在异步 FIFO 跨时钟域中的抗亚稳态用途属于另一主题;工程选型先问是不是地址总线(命中选格雷),再问数据是否强相关、总线是否够宽或走片外(都满足才选 bus-invert),任一条件不成立就放弃编码,回到时钟门控等不依赖数据结构的降功耗手段。