UVM 命令行 plusargs:uvm_cmdline_processor、内置 +UVM_* 参数与自定义参数规范
更新时间:2026-09-28。在 SystemVerilog plusargs 配置 里,我们讲过
$test$plusargs/$value$plusargs这对语言级原语:任何 testbench 都能靠它们在仿真启动时读参数。UVM 在这个原语之上做了一层封装——uvm_cmdline_processor,并预定义了一整套+UVM_*内置参数控制测试名、verbosity、phase 超时等行为。这一篇把 UVM 命令行 plusargs 的完整链路拆开:参数从命令行进到组件的路径、内置参数各自管什么、项目自定义参数怎么命名才不在回归里撞车。
本文要回答的问题
- 命令行上的
+arg=value在仿真器内部经过哪些环节,最终到达某个组件的代码里? uvm_cmdline_processor单例怎么拿,它提供哪些查询方法,和裸用$value$plusargs有什么区别?+UVM_TESTNAME、+UVM_VERBOSITY、+UVM_MAX_QUIT_COUNT这些内置参数分别控制什么,常见的坑是什么?- 项目自定义 plusarg 该按什么规范命名,才能避免 agent 之间、VIP 之间互相撞名?
- plusarg 和 config_db 谁覆盖谁,回归脚本批量注入参数时推荐哪条链路?
一、解析链路:从命令行字符串到组件手里的值
一条 +ntb_random_seed=12345 写进仿真命令行之后,它的旅程分三段。第一段在仿真器启动时:kernel 把所有以 + 开头的参数收集进一张全局表,这张表仿真期间只读,任何时刻都能查。第二段在 UVM 库初始化时(run_test 之前):UVM 创建 uvm_cmdline_processor 单例,把这张表原样接管,并在自己内部把 +UVM_* 开头的参数挑出来先行消费——比如 +UVM_TESTNAME 决定 factory 按什么类名建顶层测试。第三段在组件代码里:你的 test 或 env 调用 get_arg_value 之类的接口,把项目自定义参数读出来,再决定是本地用还是塞进 config_db 广播给下层。
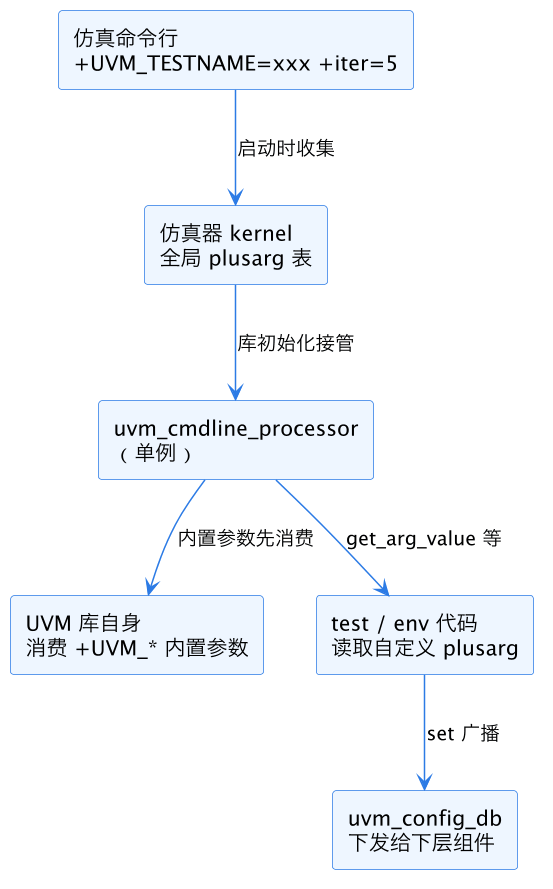
这张链路图有一个关键含义:自定义 plusarg 不会自动到达下层组件。kernel 表是全局可查的,但规范的做法不是让每个组件自己跑去翻全局表(那样参数名就散落在代码各处,改一个名字要全库搜),而是在 test 层统一读取,再通过 config_db 或配置对象显式下发。这样参数的「入口」收敛在一处,日志里打一次就交代清了本次仿真的全部输入。这套「命令行 → test 层 → config_db → 组件」的注入链路,与 UVM config object 与 resource db 讲的配置分发机制是同一条管道,plusarg 只是管道的上游源头之一。
二、uvm_cmdline_processor:单例获取与查询接口
uvm_cmdline_processor 是单例,获取方式固定:
uvm_cmdline_processor clp = uvm_cmdline_processor::get_inst();拿到句柄后,常用接口分四类:
| 接口 | 原型(简化) | 返回 | 用途 |
|---|---|---|---|
get_arg | get_arg(string match, output string value) | int(1=匹配) | 取单个 +arg=value 的值 |
get_arg_value | get_arg_value(string match, output string value) | int(匹配个数) | 同上,最常用;match 里可含 + 与 = |
get_arg_values | get_arg_values(string match, ref string values[$]) | int | 同名参数出现多次时全收 |
get_plusargs | get_plusargs(ref string args[$]) | int | 倒出全部 plusarg,打日志用 |
match 参数的写法值得注意:clp.get_arg_value("+iter=", v) 里的 + 和 = 都是模式的一部分,仿真器做的是前缀匹配。因此 +iter 和 +iterations 如果用同一个模式 "+iter=" 去查不会误伤(因为后者是 +iterations=,前缀到 = 就断了),但 +iter 和 +iter2 这种就危险了——裸 $value$plusargs("iter=%d", x) 匹配 +iter2=5 时行为依工具而异,而显式带上 = 的模式是安全的。养成「模式永远写到等号」的习惯,能消掉一整类隐蔽的参数串读。
和裸用 $value$plusargs 相比,走 uvm_cmdline_processor 多出来三样实际收益。其一,查询结果有明确的匹配计数返回,get_arg_value 返回 0 和返回 2 是两件事——返回 2 说明命令行上同名参数出现了两次,多半是回归脚本拼接时重复塞了,可以当场报警而不是默默用最后一个。其二,工具链一致性:UVM 自带的 trace 开关、report catcher 的参数解析都走同一个单例,你的代码跟着走,行为预期一致,排查问题时不用猜「这个参数到底被谁消费了」。其三,跨仿真器可移植:$value$plusargs 的匹配语义在各家工具上有细微差别(前缀匹配还是整词匹配、大小写敏感性),单例接口把这些差异抹平了一遍,换仿真器时参数解析这层不需要回归。
get_arg_values 与 get_plusargs 容易混淆,分工其实很清楚。前者针对一个已知名字:命令行上同名参数可以出现多次,如 +cov_point=foo +cov_point=bar +cov_point=baz,它按出现顺序把所有值收进 values[$] 队列,返回个数;适合「一组同构条目」的场景,比拼逗号分隔字符串再手工 split 干净,也绕开了命令行总长度对单条参数的限制。后者针对未知全集:把整个 plusarg 表原样倒进 args[$],一个元素就是一条原始参数字符串(含前导 +),主要用途有两个——一是在 build_phase 开头全量打 log,留下本次仿真输入的完整快照;二是做白名单校验,遍历全表对照项目参数登记表,发现不在册的参数立刻 warning,能把「脚本拼错了一个字母、参数根本没生效」这类静默失败提前到仿真第零秒暴露。两者配合的惯用法是:先 get_plusargs 存档与校验,再对每个在册参数用 get_arg_value 或 get_arg_values 精确取值。
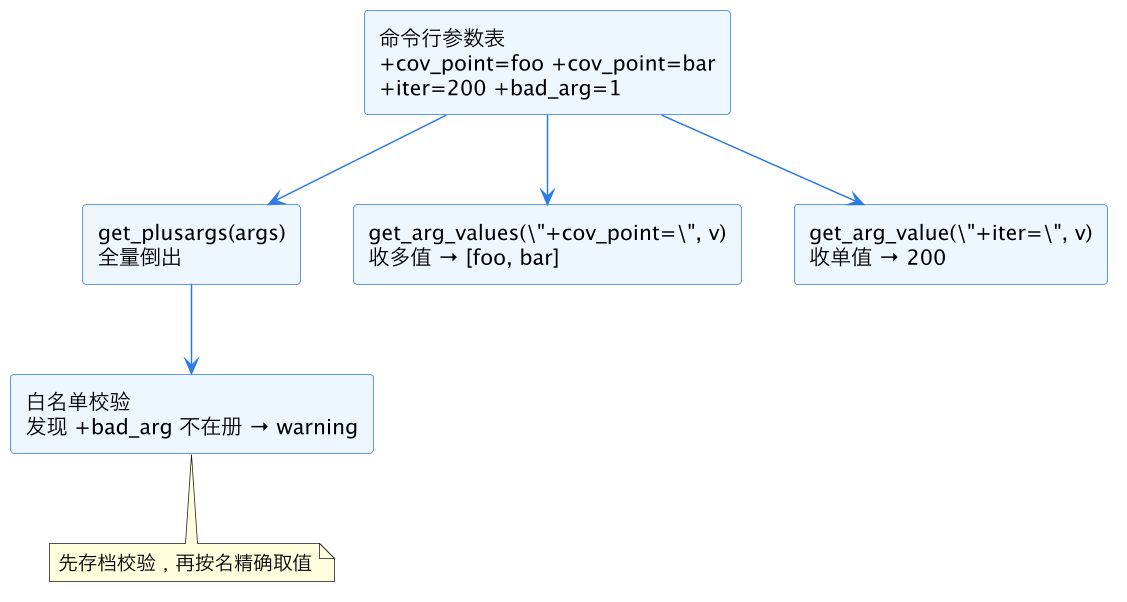
上图把三条查询路径画在同一张参数表上:左侧全量通路负责「看得见、拦得住」,右侧两条按名通路负责「取得准」。注意 get_arg_values 收多值时不做去重也不做类型转换,队列里是字符串原样,数值语义要靠调用方 atoi 并校验,和单值版本的纪律一致。
一个典型的 test 层读取封装:
class smoke_test extends uvm_test;
  int unsigned iterations = 100;   // 默认值
  function void build_phase(uvm_phase phase);
    string v;
    uvm_cmdline_processor clp = uvm_cmdline_processor::get_inst();
    if (clp.get_arg_value("+iter=", v))
      iterations = v.atoi();
    `uvm_info("CFG", $sformatf("iterations=%0d", iterations), UVM_LOW)
    uvm_config_db#(int unsigned)::set(this, "env.agent.*", "iterations", iterations);
  endfunction
endclass三个细节:一是先给默认值再尝试覆盖,命令行没传也能跑,回归脚本只传需要改的项;二是读完立刻用 UVM_LOW 打一条日志,任何一次仿真打开 log 就能确认参数是否生效,排查「传了参数没反应」这类问题只要十秒;三是 atoi 转换失败返回 0,对关键参数要加范围检查,0 次迭代静默通过是最糟糕的假绿。
三、内置 +UVM_* 参数速查
UVM 库自己在 run_test 前后消费一批保留参数,全部以 +UVM_ 开头。这一命名空间是 UVM 的保留地,自定义参数绝不要用这个前缀——今天没冲突,升级库版本可能就多了一个同名内置参数。
| 参数 | 取值 | 控制什么 | 常见坑 |
|---|---|---|---|
+UVM_TESTNAME | 类名字符串 | factory 创建哪个 uvm_test 顶层 | 类必须注册到 factory,拼写错误报 FATAL |
+UVM_VERBOSITY | UVM_LOW/HIGH/DEBUG… | 全局消息冗余度 | 也会被组件级 set_report_verbosity 覆盖 |
+UVM_ACTION | UVM_LOG/UVM_EXIT… | 全局消息动作 | 组合写法 `+UVM_ACTION=UVM_LOG |
+UVM_MAX_QUIT_COUNT | 整数 | 容忍多少个 UVM_ERROR 才 quit | 0 表示不提前退出,跑满整个用例 |
+UVM_TIMEOUT | 时间,如 1000000,YES | 全局 phase 超时看门狗 | 第一个参数是仿真时间单位,别写错单位 |
+UVM_PHASE_TRACE | 无值 | 打印 phase 调度轨迹 | 只在调 objection/phase 问题时开 |
+UVM_OBJECTION_TRACE | 无值 | 打印 objection raise/drop | 配合 phase 与 objection 排查 |
+UVM_RESOURCE_DB_TRACE | 无值 | 打印 resource/config_db 存取 | 查配置没下发到组件时开 |
+UVM_CONFIG_DB_TRACE | 无值 | 同上,config_db 专用 | 输出量大,定向调试用 |
+UVM_SET_INST_OVERRIDE 等 | 见手册 | 命令行直接做 factory override | 复杂环境建议写在代码里而非命令行 |
其中三组最值得展开。
+UVM_TESTNAME 是回归脚本与 testbench 的契约:run_test() 不带参数时,UVM 就从 plusarg 表里找它,找到什么类名就让 factory 建什么。这意味着 Makefile 里一行 make TEST=smoke_test 最终翻译为 +UVM_TESTNAME=smoke_test 传给仿真器。派生关系见 SystemVerilog 测试用例基类派生——所有能作为 TESTNAME 的类都必须经 `uvm_component_utils 注册。
+UVM_VERBOSITY 与代码里的优先级关系常让人困惑:命令行设的是全局初始值,build_phase 里组件再调 set_report_verbosity_level 会把它盖掉;组件特定 ID 的 verbosity 设置优先级又更高。命令行开 DEBUG 看不到消息时,先查是不是代码里某处把它调回去了。verbosity 体系本身见 UVM report 与 verbosity 控制。
+UVM_MAX_QUIT_COUNT 默认 0,也就是不对 error 计数、跑到底。回归里常设成 5 或 10:测试一旦烂掉(比如 X 传播刷屏)就尽早退出省仿真资源。但调试期要设回 0,否则第一个 error 之后仿真就没了,而真正有信息量的可能是第一百个 error 的现场。
四、自定义 plusarg 的分层命名规范
项目大了以后,plusarg 的混乱程度直接决定回归脚本的可维护性。踩过的典型事故是:两个 VIP 各自定义了 +timeout=…,含义和单位都不同,回归脚本给一个就影响了另一个;或者某 agent 定义了 +debug,恰好和仿真器厂商内置参数前缀撞车,行为依工具版本漂移。
一条经过验证的命名规范是层级前缀 + 功能名:
+<域>_<子域>_<功能>[=<值>]域(domain)取项目或 VIP 的名字缩写,子域取 agent 或模块名,功能名用全词。例如:
+ddr_agent_max_burst=64:DDR agent 的最大 burst 长度+pcie_ep_link_width=x8:PCIe EP VIP 的链路宽度+chip_scen_num_txn=200:芯片级 scenario 的事务数+cov_dump_merge:无值开关类,覆盖率 dump 后合并
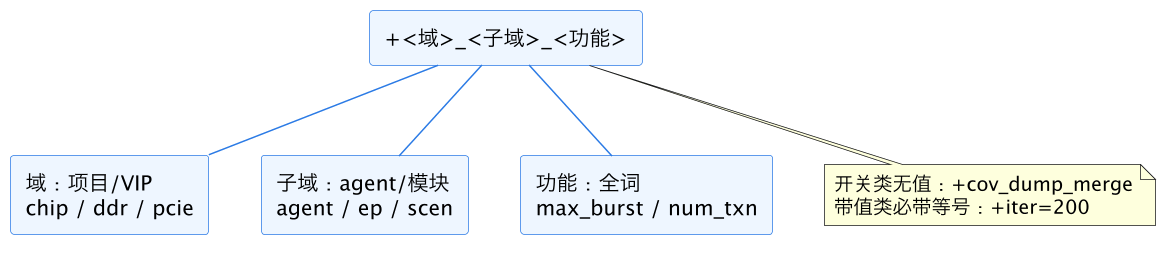
规范之外还有四条执行细节。第一,开关类参数(无值)用 get_arg_count 或前缀匹配判断存在性,带值参数必须带 = 模式,两类不要在同一个名字上混用,否则 +foo 和 +foo=1 语义分歧。第二,参数清单要在项目文档里登记成表——每个参数一行:名字、默认值、作用范围、引入人;新人加参数先查表再命名。第三,VIP 供应商给的参数(如各家 VIP 的 +xxx_vip_…)原样保留、不重命名,在自有一层做映射。第四,顶层 test 读完参数后集中打一张「本次仿真参数表」,回归出错时第一眼看这张表就能复现现场。
与这套命名规范配合,读取代码也建议分层:域级参数(+chip_*)在 base test 读,agent 级参数(+ddr_agent_*)在各 agent 的 base test 或配置对象的 build_from_plusargs 辅助函数里读。不要让 env.agent.monitor 这种深组件自己去翻全局表——读取层级和 UVM 组件与 phase 里的组件层级对齐,参数从哪一层进来、在那一层消化或下发。
五、plusarg 与 config_db 的优先级和注入链路
同一份配置常常有两条入口:命令行 plusarg,以及代码里写死的 config_db set。推荐规则一句话:命令行优先,代码兜底。也就是说 test 层先查 plusarg,查到了以命令行为准,查不到用代码里的默认值;然后把最终生效值 set 进 config_db,下层组件只从 config_db 取、不再关心值是从哪来的。
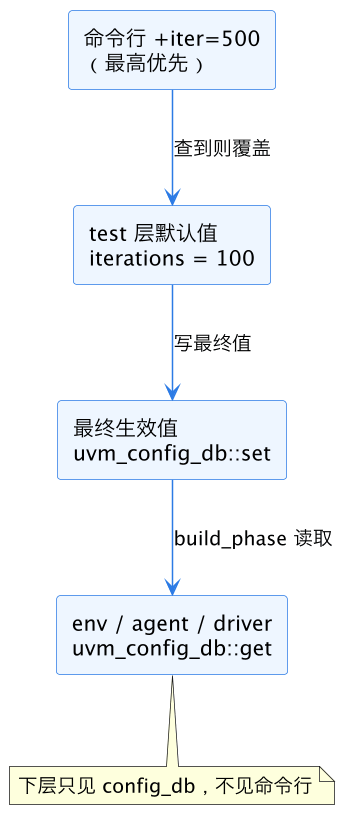
这个单向流的好处体现在回归脚本里:Makefile 或 Python 脚本只负责把参数拼到仿真命令行,testbench 侧零改动;同一份 testbench 不加参数就是默认冒烟配置,加参数就是定向场景。回归管理与 triage 里说的「失败用例一键复现」也依赖这一点——log 里那张参数表加命令行,就是复现所需的全部信息。
还有个顺序细节:config_db 的 set 要在 build_phase 里、且在下层组件 get 之前完成。UVM 的 build_phase 自顶向下执行,test 的 build_phase 先于 env、agent 运行,所以在 test 的 build_phase 里读 plusarg 并 set,天然满足时序。如果图省事在 new() 里 set,会因为 uvm_root 尚未建立层级而匹配不到实例路径,参数静默丢失——这类问题开 +UVM_CONFIG_DB_TRACE 一眼可见。
六、回归脚本侧的参数透传实践
工程上,plusarg 的生产者是回归脚本,消费者是 testbench,中间的契约是一张参数表。一个最小可用的 Makefile 模式:
TEST      ?= smoke_test
SEED      ?= $(shell date +%s)
ITER      ?=
PLUSARGS   = +UVM_TESTNAME=$(TEST) +ntb_random_seed=$(SEED)
ifneq ($(ITER),)
PLUSARGS  += +chip_scen_num_txn=$(ITER)
endif

run:
$(SIMV) $(PLUSARGS) -l sim_$(TEST)_$(SEED).log两个设计决策值得注意。一是可选参数用「空即不传」而非传默认值:不传时 testbench 用自己的默认值并打日志,传了就覆盖;如果脚本总是传一个默认 ITER=100,就把「命令行没传」这个信息抹掉了,testbench 里的默认值逻辑形同虚设。二是日志文件名带上 TEST 和 SEED,参数表加上这条日志路径,任意一次历史仿真都能精确复盘。种子管理本身另有讲究,见 SystemVerilog 随机稳定性与种子——seed 参数命名 +ntb_random_seed 是行业惯例,各家仿真器都认。
仿真器侧还有一个常被忽略的拼接点:很多团队的 run 目标里除了 $(PLUSARGS) 还会追加一段 $(EXTRA_OPTS) 给临时调试用,比如 +UVM_PHASE_TRACE 或 dump 波形开关。建议把这类「调试专用、不进契约」的参数和正式参数分开两个变量存放,log 里参数表只打正式参数——否则两周后回看一条带五个临时开关的命令行,分不清哪些是复现必须的。同理,+define+ 开头的编译期宏和 plusarg 是两条轨:宏在编译时定死,plusarg 在运行时可改;凡是每次回归都要变的量(seed、iter、test 名)必须走 plusarg,只随版本变的结构配置(数据位宽、功能开关)才走宏。把运行期量塞进宏里,等于每改一个数重编译一次,回归吞吐直接腰斩。
大规模回归里还有一个进阶用法:get_arg_values 收多个同名参数。比如 +cov_point=foo +cov_point=bar 传一组要精细化统计的 coverpoint 名,test 层循环取出存进队列,再逐个 set 给 coverage collector。这比拼一个逗号分隔字符串再在 SV 里 split 干净得多,命令行长度限制也不容易触到。
七、常见坑
- 模式串漏写
=:get_arg_value("+iter", v)会意外匹配+iter2=…、+iterations=…;模式永远写到等号。 - 自定义参数用
+UVM_前缀:侵占了库的保留命名空间,升级 UVM 版本后行为不可预测。 - 深层组件直接翻全局 plusarg 表:参数入口散落各处,改名字漏改一处就是静默失效;统一在 test 层读取再下发。
- 读参数不打日志:「传了没生效」无从排查;所有生效参数在 build_phase 用 UVM_LOW 集中打一张表。
- 在
new()里 set config_db:层级未建立,实例路径匹配失败,参数悄悄丢失;一律放 build_phase。 - atoi 不校验:
v.atoi()失败返回 0,0 迭代、0 超时这类值静默通过;关键参数加范围断言。 +UVM_TIMEOUT单位搞错:它吃的是仿真时间单位,不是纳秒也不是拍数,写之前确认 timescale。- 回归脚本传死默认值:脚本总是显式传参会把 testbench 的默认值逻辑废掉,可选参数空即不传。
这一篇在知识体系里的位置
- 语言级基础:SystemVerilog plusargs 配置 讲
$test$plusargs/$value$plusargs原语,本篇是 UVM 在其上的封装与规范。 - 下游管道:UVM config object 与 resource db 承接 plusarg 读出的值,负责把它送到下层组件。
- 相关控制面:UVM report 与 verbosity 控制 展开
+UVM_VERBOSITY背后的消息体系;phase 与 objection 展开+UVM_TIMEOUT与+UVM_OBJECTION_TRACE的语境。 - 工程落地:回归管理与 triage 说明参数表与种子如何支撑失败复现。
总结
UVM 命令行 plusargs 的完整链路是「仿真命令行 → kernel 全局表 → uvm_cmdline_processor 单例 → test 层读取 → config_db 下发」:+UVM_* 是库的保留参数(TESTNAME 定测试、VERBOSITY 定冗余度、MAX_QUIT_COUNT 定容错),项目自定义参数按「域_子域_功能」分层命名、模式串必带等号、读取即打日志、命令行优先代码兜底——守住这几条,回归脚本与 testbench 之间的参数契约就不会烂。