DMA 与 Cache 一致性:clean/invalidate 维护
更新时间:2026-09-24。嵌入式/SoC。DMA 引擎本身的结构见 DMA 控制器微架构,软件侧的顺序保证见 C 侧内存屏障。
本文要回答的问题
- CPU 和 DMA 都在访问同一块内存,为什么会各看各的数据?
- DMA 发送(CPU 写、DMA 读)之前为什么必须 clean,漏掉会怎样?
- DMA 接收(DMA 写、CPU 读)之前为什么必须 invalidate,invalidate 掉脏行为什么会丢数据?
- cache 维护的粒度是 cache line,缓冲区不对齐、长度不凑整会牵连谁?
- coherent DMA 和 non-coherent DMA 差在哪里,驱动代码分别要写什么?
一、根源:系统里有两条访问内存的通路
理解 DMA 与 Cache 一致性,先看一个常被忽略的事实:SoC 里存在两条物理上不同的内存通路。CPU 核心发出的 load/store 不直接到 DDR,而是先进 D-cache(数据高速缓存),命中就不往下走;DMA(Direct Memory Access,直接存储器访问)引擎则挂在总线上,发起的读写事务直接落在 DDR 控制器上,完全不经过 CPU 的 cache。cache 里的「最新数据」和内存里的「真实数据」因此可能是两份。
这张图点出了全部问题的来源:CPU 和 DMA 各自只认自己通路尽头的那份数据。发送方向上,CPU 刚写的数据可能还是 cache 里的脏行,DDR 里是旧值,DMA 从 DDR 取数就取到旧数据;接收方向上,DMA 把外设来的新数据写进了 DDR,但 CPU cache 里那份旧缓存行还在,CPU 一读直接命中旧行,根本不会下到内存。更麻烦的是这类 bug 极其隐蔽:cache 里有没有旧行、脏行何时被硬件自动写回,都取决于之前的访问历史,同一个驱动可能跑十次才错一次。
打个比方:两人合写一份文件,CPU 在自己的草稿纸(cache)上改,DMA 每次只去文件柜(DDR)取正式版。CPU 改完没把草稿誊回文件柜,DMA 发出去的自然是老版本;反过来,DMA 往文件柜换了新内容,CPU 手里却还攥着旧草稿照读。所谓缓存维护,就是在「交接」的当口强制双方同步一次草稿纸和文件柜。
还要破除一个常见的侥幸心理:脏行迟早会被硬件在 cache 容量压力下换出写回,那我等着行不行?不行在于写回时机不可控——它取决于后续访问模式、替换算法和中断嵌套,驱动无法据此安排 DMA 启动时刻。软件维护存在的意义,就是把这个不可控的异步事件变成一个在指定时刻完成的同步动作。
D-cache 的工作原理和 cache line 概念见 Cache 组织与寻址,缓存行大小的工程权衡见 Cache line 大小权衡。
二、维护操作三件套:clean、invalidate、clean+invalidate
软件手里只有三种缓存维护原语,名字在各架构里略有差异(ARM 用 clean/invalidate,x86 惯用 clflush/clwb,很多文档统称 flush),语义可以用「脏行怎么处理」「行还留不留」两个维度分清楚。
| 操作 | 对脏行的处理 | 对有效行的处理 | 操作后 cache 中 | 典型用途 |
|---|---|---|---|---|
| clean(writeback) | 写回 DDR | 保留 | 仍有干净的有效副本 | DMA 发送前 |
| invalidate | 直接丢弃,不写回 | 标记无效 | 该行不存在 | DMA 接收前 |
| clean + invalidate(flush) | 先写回再无效 | 先落内存再丢弃 | 空 | 所有权转移、关 cache 前 |
| zero(清零,如 DC ZVA) | 该行直接置零 | 内存与缓存同时为零 | 一行零 | 接收缓冲预清零,省去读改写 |
关键区别只有一句话:clean 保数据、invalidate 废数据。clean 是「把 cache 里比内存新的内容推下去」,内存变新,cache 行变干净但继续留着;invalidate 是「宣布 cache 里的副本作废」,下次访问重新从内存取——如果被作废的恰好是没写回的脏行,数据就永久丢失了。所以 invalidate 是一个有数据丢失风险的操作,只能作用在「内存才是权威、cache 里的内容已无价值」的地址范围上。表里的 zero 单独说一句:有些架构提供按行清零指令(如 ARM 的 DC ZVA),它把内存和缓存中的对应行同时置零,不需要先把旧行读上来,适合给接收缓冲做初始化;但它同样按整行生效,未按行对齐使用会把邻居一起清零。还要注意前提差异:上述脏行、写回的讨论针对默认的 write-back(写回)策略;如果某块内存被配置成 write-through(写穿透),每次写入同时进缓存和内存,发送方向自然不欠写回,但接收方向的 invalidate 仍旧省不掉——陈旧副本问题在两种策略下都存在。
各架构具体指令见 Cache flush/invalidate 指令。
把「不做维护」与「clean 加 invalidate 配对维护」两个端点放在一起对照,后面第三、四节要展开的时序细节可以先在脑子里挂个总账:
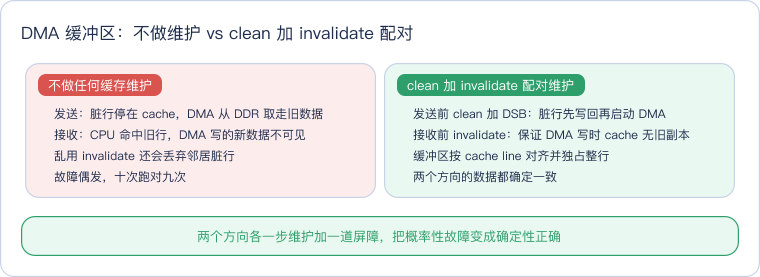
这张卡的左栏正是这类 bug 难缠的原因:不做维护时系统大多数时候「看起来是对的」,错误只在脏行没被换出的窗口里露头。右栏的配对原则只有一句话——clean 保数据给发送方向,invalidate 废副本给接收方向,顺序和方向都不能反。
三、发送方向:CPU 写 → DMA 读,启动前必须 clean
走一遍网卡发包的时序,每一步谁拥有数据的「最新版」要盯紧。

对应到代码,顺序是固定的四步:CPU 用 memcpy 把待发送内容填进 DMA 缓冲区(数据停在 D-cache,该行被标记为脏);对缓冲区地址范围执行 clean,把脏行扫一遍写回 DDR;执行一条 DSB(Data Synchronization Barrier,数据同步屏障),确保 clean 的写回事务在总线上真正完成而不是还在排队;最后才写 DMA 引擎的源地址、长度和启动位。屏障这一步省不得:没有它,「启动 DMA」这个写动作可能先于脏行写回到达总线,顺序仍然是乱的。内存屏障的语义见 内存屏障。
一个真实的事故特征:如果缓冲区反复复用、且每次内容的前几十个字节变化不大,漏 clean 时 bug 表现为「偶发发出上一帧的数据」,因为部分行恰好已被硬件换出写回、部分还是脏的。这种概率性故障在实验室里很难稳定复现。
把数字算实,对齐的直觉会更清楚。假设 cache line 为 64 字节,要发送一个 1500 字节的网络帧:数据覆盖 24 根完整行(1536 字节),clean 必须覆盖全部 24 行,少一行就可能漏一行脏数据;而报文实际只有 1500 字节,最后一行末尾 36 字节是缓冲区内的垫头,DMA 长度寄存器照样填 1500,硬件只发 1500 字节,但 clean 范围必须按 1536 算。「维护范围」和「DMA 长度」是两个不同的量,前者凑整到行、后者按真实字节,不要混为一谈。
在发送环形队列(descriptor ring)里还要理解「所有权」这个概念:驱动准备好一个描述符并 clean 之后,这块缓冲的所有权就交给了硬件,CPU 在硬件回写完成状态之前不应再碰它;想改内容,必须等硬件声明归还。很多「发出去的数据被中途改掉」的诡异现象,本质都是 CPU 在 DMA 还在读的时候又写了同一根 cache line,两个 master 在时间窗口里打架。
四、接收方向:DMA 写 → CPU 读,启动前必须 invalidate
接收方向的操作必须在 DMA 启动之前做,这是和发送方向最容易记反的地方。

为什么 invalidate 必须在前面?DMA 写 DDR 这件事对 cache 是悄无声息的。如果 cache 里已经缓存过该缓冲区的旧行,DMA 写完 DDR 后,CPU 再读仍然命中旧行,新数据永远等不到被看见。提前 invalidate,等于先保证「DMA 写的时候,cache 里没有这个地址的任何副本」,CPU 事后第一次读必然未命中、下到 DDR 取新值。
这里藏着全主题最危险的一个坑:invalidate 会无条件丢弃脏行。假设接收缓冲区只有 32 字节,且和隔壁一个 CPU 正在使用的变量落在同一根 64 字节 cache line 上——invalidate 这一行时,隔壁那个还没写回的变量被一起丢掉,DMA 完成后它在 DDR 里的旧值反而被当成新值读回来,表现为随机内存损坏,且和 DMA 逻辑八竿子打不着,极难定位。所以接收缓冲区在 DMA 进行期间必须独占它覆盖到的每一根 cache line,不能和任何其他有效数据共线。
看一个 SPI 连续接收的典型写法,中断处理函数里的次序同样不能错:初始化阶段先把整块接收缓冲 invalidate 一次并启动 DMA;每次半满/全满中断到来时,先做屏障确认 DMA 写入已落地,再让上层消费数据;如果采用双缓冲(ping-pong)交替接收,CPU 只允许读取「硬件已写完并交出所有权」的那一半,对正在被 DMA 写的另一半绝不能提前读——一旦提前读,对应行被填进 cache,等这一半 DMA 写完,CPU 手里又是一份半新半旧的副本。换句话说,invalidate 保证的是读之前没有旧副本,所有权规则保证的是 DMA 写的时候 CPU 根本不往里读,两者缺一不可。
五、cache line 对齐与长度:维护粒度是整行,不是字节
所有维护指令的最小操作单位都是一整根 cache line(Cortex-M 系列常见 32 字节,应用级 Cortex-A 和 x86 普遍 64 字节)。给一个不对齐的起始地址做 clean,硬件实际维护的是包含该字节的整行。由此推出三条工程规则。
第一,起始地址按 cache line 大小对齐;第二,长度向上凑整到整数根行;第三,也是为了配合第四节那个坑,多凑出来的头尾空间不能放别的活数据——常见做法是分配时按行对齐、并额外多分配一到两行的垫头(padding),只把中间整块区域交给 DMA。
| 参数 | 错误做法 | 后果 | 正确做法 |
|---|---|---|---|
| 起始地址 | 任意字节地址 | 维护范围波及相邻行 | 对齐到 cache line |
| 长度 | 按报文实际字节数 | 尾部半行无法单独维护 | 向上取整到整数行 |
| 内存布局 | DMA 缓冲与普通变量共线 | invalidate 误杀邻居脏数据 | 独立对齐分配 + 垫头 |
把一个不对齐的例子算一遍。cache line 仍为 64 字节,缓冲区起始地址是 0x1004、长度 100 字节:它实际跨越 0x1000~0x107F 三根行,维护范围必须按「起始向下对齐到 0x1000、长度向上凑到 192 字节」来算。比缓冲区低 4 字节的头部和比它高 60 字节的尾部都在维护范围内——这两段若放着活数据,clean 时它们只是被无害地写回,invalidate 时却会被直接抹掉。这就是为什么驱动里常见这样的分配套路:从一个专用内存池里取地址已对齐的块,块与块之间留出至少一行的隔离带,从布局上物理杜绝共线。
对齐与填充的通用规则见 内存对齐。
六、coherent DMA 与 non-coherent DMA:谁来做维护
并不是所有系统都要驱动手工 clean/invalidate。高端应用处理器上的 DMA 通常是 coherent(一致的):DMA master 挂在带一致性扩展的互连(ARM 的 ACE/CCI/CMN,或带 snooping 的 PCIe/IOMMU 路径)上,它访问内存时硬件自动广播 snoop(侦听)事务,检查各 CPU cache 里有没有脏行或有效副本——有脏行就先抓写回、有有效副本就使其失效,整个过程对软件透明。背后的目录/侦听机制见 目录一致性与互连。
| 维度 | coherent DMA(硬件一致) | non-coherent DMA(软件维护) |
|---|---|---|
| 硬件支撑 | ACE/CCI 互连、总线 snooping、IOMMU | DMA 直连内存端口,无侦听 |
| 典型平台 | Cortex-A 应用处理器、PC、服务器 | Cortex-M MCU、中低端嵌入式 SoC |
| 发送前软件动作 | 同步 + 屏障即可 | 必须 clean + 屏障 |
| 接收前软件动作 | 屏障后直接读 | 必须先 invalidate,再启动 DMA |
| 驱动接口 | dma_map_single 等一致性映射 API | 手工 cache 维护或 non-cacheable 区 |
| 硬件成本/功耗 | 高(侦听带宽、一致性目录) | 低 |
| 易错点 | 误以为裸平台也有,漏写维护 | 顺序错、不对齐、误杀脏行 |
Linux 驱动里那层 dma_map_single(... DMA_TO_DEVICE) / DMA_FROM_DEVICE 接口,本质就是把这两套差异藏起来:在 coherent 平台上它基本只做地址翻译(配合 IOMMU/SMMU 建立 IO 虚拟地址),在 non-coherent 平台上它内部就替你执行了对应的 clean 或 invalidate。映射方向必须和真实数据流向一致:DMA_TO_DEVICE 对应发送、映射时做 clean,DMA_FROM_DEVICE 对应接收、映射时做 invalidate,搞反方向等于维护做反。用完配对的 dma_unmap_single 解除映射,所有权才回到 CPU 手里;中途想在设备持有期间访问缓冲,必须走显式的 dma_sync 接口而不是直接读写指针。
裸机环境没有这层抽象,驱动必须自己判断硬件能力并写全维护动作——而判断只能靠查 SoC 手册,不能靠「这颗 Cortex-A 应该带一致性」之类的想当然:同一颗 CPU 核挂在不同互连、DMA 接口接在不同总线上,结论可能相反。顺带澄清一个概念混淆:IOMMU/SMMU 解决的是地址翻译与访问保护(让设备用 IO 虚拟地址、限制它能碰的内存范围),它本身不自动带来缓存一致性;一条路径有 IOMMU 但不带 snooping,数据照样会陈旧,两件事要分开确认。
不做任何维护还有一条朴素的退路:通过 MPU/MMU 页属性把 DMA 缓冲区映射成 non-cacheable(不可缓存)。这样 CPU 每次访问都直达 DDR,天然一致,零维护指令;代价是 CPU 侧丢掉了缓存加速,对大缓冲区做校验、解析等处理时明显变慢,因此通常只用于小缓冲或控制结构。Linux 里的 dma_alloc_coherent 就是「一致性内存」的标准做法——在 non-coherent 硬件上,它通常返回一块被映射成不可缓存的内存;在 coherent 硬件上则返回普通可缓存内存,两种情况下驱动都不用再做维护。描述符等小而频繁访问的控制结构用它,大块报文数据用流式映射,是驱动里的常见分工。
常见坑速查
- 方向做反:发送要 clean,接收要 invalidate;接收的 invalidate 在 DMA 启动前做,不是读完后。
- invalidate 掉脏行:接收缓冲与有用数据共享 cache line,DMA 期间邻居数据被丢。
- 不对齐、不凑整:维护按整行生效,首尾半行牵连相邻数据。
- 只做维护不加屏障:没有 DSB,维护完成与 DMA 启动之间的顺序不被保证。
- 想当然有硬件一致性:coherent 与否取决于互连和 DMA 端口,不取决于 CPU 核名字。
- 自修改代码只维护 D-cache:往内存写新指令后还要 invalidate I-cache,详见 I-cache。
这一篇在知识体系里的位置
本篇属于芯片设计进阶层的 DMA/内存子系统主题,回答「两个 master 看到的内存为什么不一样、软件怎么补」。向前读,DMA 引擎如何搬运、链表描述符如何工作见 DMA 控制器微架构,cache 为什么会让数据停在半路见 Cache 组织与访问;横向配套,维护指令的架构差异见 Cache flush/invalidate 指令,多 master 硬件一致性见 目录一致性与互连,软件排序靠内存屏障;向后读,可延伸到 IOMMU/SMMU 地址翻译与保护、Linux DMA API 的映射模型,以及多核缓存一致性协议(MESI)专题。
总结
DMA 绕过 cache 直连 DDR,和 CPU 看到的可能是两份数据:发送方向 CPU 写完先 clean 把脏行写回内存、加屏障再启动 DMA;接收方向先 invalidate 丢弃旧行、再启动 DMA,完成后 CPU 首次读取被迫从内存取新值;缓冲区必须按 cache line 对齐、长度凑整并独占整行,否则 invalidate 会误杀共享行里的脏数据;coherent DMA 靠总线 snooping/IOMMU 让硬件代劳,non-coherent 平台(多数 MCU)只能由驱动手工维护,或把缓冲设成 non-cacheable——顺序反、不对齐、想当然有硬件一致性,是这类偶发且极难定位的 bug 的三大根源。