扩散模型推理加速:step 蒸馏(LCM/Turbo)与 DiT 注意力 kernel 的时延结构
更新时间:2026-10-03。文生图模型(Stable Diffusion、SDXL、Flux)和 LLM 一样都是「按 token/按步迭代」的推理负载,但时延的构成完全不同:LLM 的瓶颈在 KV cache 带宽(见 KV cache 推理显存),扩散模型的瓶颈在迭代步数 × 每步算力。社区里的 SDXL-Turbo、LCM-LoRA 这些「1 步出图」方案本质是 step 蒸馏;而每一步内部,DiT(Diffusion Transformer)的注意力又贡献了绝大部分 FLOPs,注意力 kernel 优化的手法与 LLM 侧完全同源(背景见 FlashAttention 显存分块 tiling 与 FlashAttention-3:Hopper 三件套)。本篇把「步数怎么降、每步怎么快」这两条线合在一起,讲清文生图推理的完整时延账本。
本文要回答的问题
- 一张 SDXL 图片从提示词到像素,时延到底花在哪几个组件上?
- 为什么扩散步数从 50 降到 4 不是简单的「少循环几次」,蒸馏损失了什么?
- LCM 与 SDXL-Turbo(ADD)这两条 step 蒸馏路线的差异在哪,LoRA 化为什么能即插即用?
- 每步内部,DiT 注意力的序列长度、GEMM 形状与 LLM 有何不同,kernel 侧能榨多少?
- 蒸馏和 kernel 优化叠加后,端到端时延的数字长什么样,画质边界在哪?
一、文生图推理的时延结构:去噪循环是主战场
先看一张 SDXL 出图的完整流水线。文本编码器(CLIP 双塔)把提示词编码成 embedding,只跑一次,时延占比通常不到 5%。主角是 UNet 或 DiT 组成的去噪网络:从纯噪声 latent 出发,按调度器(scheduler)给的步数 T 迭代 T 次,每次完整跑一遍网络。最后 VAE decoder 把 latent 解码成像素,也只跑一次,但在高分辨率下能占 10%~15%。
上面这张结构图给出了扩散模型推理加速的第一性公式:端到端时延 ≈ T × 单步时延 + 固定开销。两个乘数互相独立,于是优化天然分成两条正交的路线——砍 T(算法侧的 step 蒸馏)和压单步时延(kernel 侧的注意力/GEMM 优化)。这和 LLM 推理「prefill 算力瓶颈、decode 带宽瓶颈」的二分很像,先分清瓶颈在哪个乘数上,再决定投入方向。
去噪循环内部每步的耗时构成也值得一提。对 SDXL 的 UNet,耗时大头是中间分辨率层级的注意力块和残差卷积;对 Flux、SD3 这类 DiT 架构,则几乎全是 transformer block——自注意力加 MLP,和 LLM 的层结构同源。这就是为什么 DiT 时代的 kernel 优化可以直接搬 LLM 侧的武器库。
再补一个容易被直觉带偏的事实:批大小(batch size)在这里的作用和 LLM 推理不同。扩散 serving 里单卡一次通常只处理一张图——不是因为显存放不下,而是因为步数维度本身就是一个串行循环,多图拼 batch 只是把每步的 GEMM 变大、把单图时延换成吞吐。对延迟敏感的交互场景(聊天配图、实时画板),batch=1 是常态,这意味着单步 kernel 跑在小 batch 形状下,tensor core 利用率天然打折,kernel 侧的优化空间比训练场景更大。这一点在第四节算账时会再出现。
| 组件 | 执行次数 | 典型占比(SDXL 50 步) | 优化抓手 |
|---|---|---|---|
| CLIP 文本编码 | 1 | <5% | 可忽略,或蒸馏到小模型 |
| 去噪网络(UNet/DiT) | T 次 | 80%~88% | step 蒸馏 × 注意力 kernel |
| 调度器更新 | T 次 | <1% | 纯标量运算,忽略 |
| VAE decoder | 1 | 10%~15% | 量化、tiling、轻量 decoder |
二、步数为什么贵:常微分方程求解器的精度预算
扩散模型采样的数学本质,是在解一个概率流 ODE(常微分方程):从 t=1 的纯噪声积分到 t=0 的干净数据。调度器(DDIM、DPM-Solver、Euler)就是这个 ODE 的数值解法,步数 T 是数值积分的步长预算。欧拉法步长砍一半,离散误差翻倍——直接体现在画质上:纹理糊掉、结构崩坏、色彩发灰。
直觉上说,预训练好的扩散模型每一步只做「小幅修正」,它假设前后步之间的噪声水平差很小。强行大步跳,模型的预测误差被调度器公式放大,误差沿积分路径累积。这就是「直接减步数」失败的原因:不是网络不够快,是网络没被训练成能跨大步。实测里这个现象的观感很直接——同一个提示词,50 步出图细节饱满,砍到 10 步时大体构图还在,但发丝、织物纹理、文字边缘先糊;砍到 4 步以下,结构本身开始漂移,人脸手指最先崩。误差不是均匀摊在整张图上,而是优先攻击高频细节。
step 蒸馏的思路因此很直接:既然原模型只能小步走,就训练一个新模型(或适配器),让它一步预测出原模型好几步之后才到的状态。蒸馏的师生结构如下图所示。
上图的师生结构与知识蒸馏的通式一致,但扩散蒸馏的难点在「目标本身要在线算」:教师的 k 步结果没法预存,每次训练迭代都要现跑教师 k 步。LCM 的聪明之处在于把这个开销绕开了,见下节。
三、LCM 与 SDXL-Turbo:两条蒸馏路线的差别
Latent Consistency Model(LCM,潜空间一致性模型)把 consistency model 的自洽性质搬到了 latent 空间:一致性模型要求「同一个 ODE 轨迹上,任意起点映射到终点的输出一致」,于是训练时只需要教师走一步(甚至一步都不用走完),靠轨迹自洽性自举,不需要教师在线多步展开。训练成本大降,而且可以做成 LoRA(低秩适配器,只训练少量注入矩阵)插在原模型上——LCM-LoRA 因此成为即插即用的社区标配:任何同底座的微调模型加载这个 LoRA,就能从 25~50 步降到 4~8 步。
SDXL-Turbo 走的是另一条路:Adversarial Diffusion Distillation(ADD,对抗扩散蒸馏)。学生不仅拟合教师的轨迹终点,还要骗过一个判别器——让 1 步生成的图片在分布上贴近真实图像。对抗损失补上了「大步长下细节发糊」的短板,1~4 步的画质明显优于同步数的 LCM,代价是训练管线重(判别器加教师加学生三方),且输出风格被判别器的偏好塑形。
| 维度 | LCM / LCM-LoRA | SDXL-Turbo(ADD) |
|---|---|---|
| 蒸馏信号 | ODE 轨迹自洽性 | 教师轨迹 + 对抗判别器 |
| 可用步数 | 4~8 步 | 1~4 步 |
| 画质(同 4 步) | 细节偏软 | 明显更锐 |
| 形态 | 可做成 LoRA 即插即用 | 整模型替换 |
| 训练成本 | 低(不需教师多步在线) | 高(判别器联合训练) |
| 引导系数 CFG | 小(1~2),可省 CFG 双倍前向 | 通常免 CFG |
表里最后一行藏着一个容易被忽略的 2 倍收益:传统采样用 classifier-free guidance(CFG,无分类器引导),每步要跑「有条件」和「无条件」两次前向再插值;蒸馏模型在低引导系数下工作,很多实现直接把两次前向合成一次或干脆免 CFG——步数从 50 到 4 是 12.5 倍,叠加免 CFG 的 2 倍,网络前向次数实际压缩了 25 倍。这才是「秒级出图」的完整算术。
工程选型上还有一层现实考量:LCM-LoRA 只有几十 MB,可以和风格 LoRA 叠加加载,社区生态里它更像一个「加速器配件」而非新模型;SDXL-Turbo 是完整权重,换上它就放弃了原底座的所有微调积累。因此生产管线里常见的组合是「保留原底座 + LCM-LoRA 做实时预览,全步采样做最终交付」——同一张底图两档质量,时延差一个数量级,用户先在 1 秒级预览里挑构图,选定后再花 10 秒出终稿。蒸馏在这里改变的不只是速度,还有产品的交互形态。
四、每步之内:DiT 注意力 kernel 的时延账本
步数砍完后,单步时延成为新的主战场。DiT 与 LLM 的注意力有一个关键差异:序列是稠密的、定长的、无 KV cache 的。1024×1024 图像在 latent 空间是 128×128,patchify 成 2×2 的 patch 后得到 4096 个 token,拼接文本 token 后序列长约 4K~5K,且每一步都是全量重新计算——没有增量 decode 这回事。这意味着:
- 注意力是标准的稠密自注意力,FlashAttention 直接适用,不需要分页、变长打包这些 serving 侧机制(对照 PagedAttention 分页 KV 在 LLM 侧的必要性)。
- 序列长度 4K 上下,QK^T 的矩阵规模让注意力 FLOPs 占比约 30%~40%,其余在 MLP 的 GEMM 上。kernel 收益要两头都算。
- 每次前向形状完全固定,非常适合 CUDA Graph 整图捕获(背景见 CUDA Graphs 捕获与重放),把 kernel 发射开销清零。
下面这张图给出 DiT 单步的耗时分布与对应的 kernel 抓手。

两个要点值得展开。先补一组形状数字帮助建立直觉:序列 4096、head dim 128、32 个 head 的典型 DiT block 里,QK^T 与 PV 两个 GEMM 的 FLOPs 合计约等于 MLP 两个投影 GEMM 的一半到三分之二,注意力随序列长度平方增长而 MLP 线性增长——所以 1024 像素出图时注意力还不是绝对大头,但一旦升到 2K 分辨率(序列破万)或视频扩散(序列再乘帧数),注意力立刻反超成为唯一的主矛盾,FlashAttention 系 kernel 从「锦上添花」变成「没有就跑不动」。其一,蒸馏把步数从 50 压到 4 之后,固定开销的相对占比从可以忽略变成了必须处理:每步几十个 kernel 的发射延迟、文本编码器和 VAE 的一次性耗时、host 侧调度逻辑,在总时延 0.5 秒的目标下全都浮上水面。CUDA Graph 在这里的收益比 LLM 场景更干脆——形状恒定、无动态控制流,一次捕获全步重放。其二,低精度化路径成熟:DiT 的 GEMM 对 INT8/FP8 量化的容忍度不错(方法见 FP8 E4M3 与 E5M2 推理 与 量化校准 PTQ 与 QAT),社区 FP8 版 SDXL 实测单步再省 30%~40%,画质损失在肉眼阈值之下。FlashAttention-3 的 FP8 注意力在 DiT 这种定长稠密场景甚至比 LLM serving 更好落地——不需要处理变长边界。
把这些手段按时间轴叠起来,单步内部的加速路径如下。
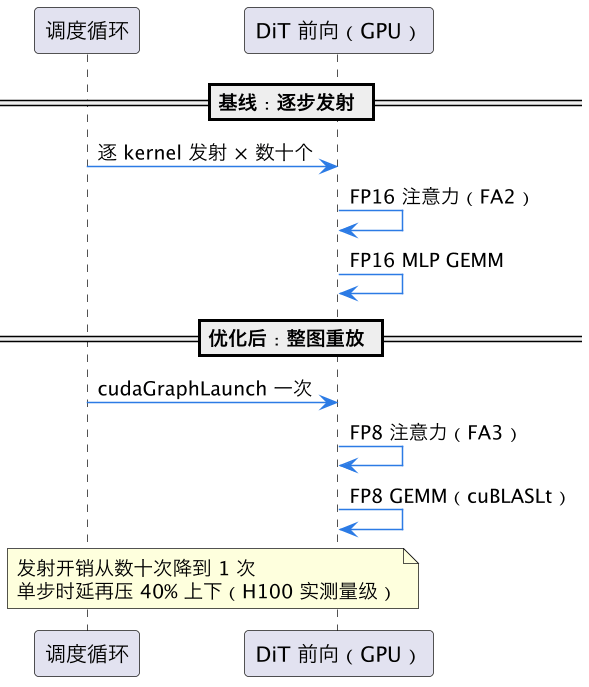
图中两条时间带的对比说明一个工程事实:step 蒸馏解决「跑几步」,kernel 与图捕获解决「每步多快」,两条线的收益是相乘关系,谁也不替代谁。
五、端到端数字:从 12 秒到 0.5 秒的账怎么算
把两条线合起来算一笔 A100/H100 量级的粗账(1024×1024 出图,不含排队):
| 配置 | 步数 | 每步前向 | 单步时延 | 去噪总耗时 | 端到端 |
|---|---|---|---|---|---|
| SDXL 基线(DDIM,CFG 7.5) | 50 | 2 次 | ~220 ms | ~11 s | ~12 s |
| + LCM-LoRA | 4 | 1 次 | ~220 ms | ~0.9 s | ~1.3 s |
| + FP8 + FA3 + CUDA Graph(H100) | 4 | 1 次 | ~120 ms | ~0.5 s | ~0.7 s |
第一行到第二行是 10 倍量级,全部来自蒸馏(步数 50→4 叠加免 CFG);第二行到第三行是 2 倍上下,全部来自 kernel 与图优化。这个乘法结构也是容量规划的基础——和 LLM serving 一样,单请求时延压下去之后,吞吐与 SLO 的换算方法可以直接套用 LLM serving 的 TTFT/TPOT 与 SLO 里的框架,只是扩散请求的「时延」没有流式中间量,只有一个整体完成时间。
边界也要说清:1~4 步蒸馏模型在复杂构图(多人物、精细文字渲染、强风格迁移)上仍然输给 30 步以上的全步采样,高分修复(img2img 放大)链路里通常保留一段全步精修;LCM-LoRA 在 8 步以上继续加步数收益迅速饱和,这是蒸馏目标本身的性质,不是工程没调好。另外 VAE decoder 在步数压到个位数后占比升到 20% 以上,成为下一个值得动的固定开销(轻量 distilled decoder 或 FP8 VAE 是常见解法)。
最后给一张落地检查的速查清单,按投入从小到大排序:先换调度器(DPM-Solver++ 2M 这类高阶求解器在 20 步内就能接近 50 步 DDIM 的画质,零训练成本);再挂 LCM-LoRA 降到 4 步(几十 MB,可叠加风格 LoRA);然后开 torch.compile 或 CUDA Graph 把固定开销清零;最后上 FP8(需要逐模型验证画质,但 DiT 类架构普遍耐量化)。每一步的期望收益在上文表格里都能对号入座,先做便宜的,够用就停。
这一篇在知识体系里的位置
本篇是 AI 推理加速线索里「扩散模型」支线的主干:算法侧的 step 蒸馏与 kernel 侧的注意力优化在此汇合。上游基础是 FlashAttention 显存分块 tiling(稠密注意力的分块框架)与 FlashAttention-3:Hopper 三件套(FP8 与异步流水);同层对照 注意力 kernel 优化版图(全场景 kernel 选型)、ViT 编码器推理流水线(同为定长稠密序列的视觉 transformer)、FP8 E4M3 与 E5M2 推理(低精度格式本身)与 CUDA Graphs 捕获与重放(固定开销清零手段);下游延伸是多步蒸馏与视频扩散(DiT 序列再乘时间维)的时延结构。
总结
扩散模型推理加速的账本只有一行乘法:端到端时延 = 步数 × 单步时延 + 固定开销——step 蒸馏(LCM 靠轨迹自洽、SDXL-Turbo 靠对抗判别)把步数从 50 压到 1~4 并顺手免掉 CFG 双倍前向,贡献约一个数量级;DiT 注意力 kernel(FlashAttention 系、FP8 GEMM、CUDA Graph 整图捕获)再把单步压掉近一半,两条线收益相乘,把 1024 像素出图从 12 秒级带进 1 秒以内——而画质边界提醒我们:蒸馏省的是「数值积分的步长预算」,复杂构图下全步采样仍然不可替代。