FPGA 进阶 39:DMA 数据搬运架构——AXI DMA/DataMover 与带宽匹配
本文是
fpga/进阶层第 43 篇。搬运基础是 AXI4 完整协议(突发/outstanding)、流接口是 AXI4-Stream、Zynq 侧使用见 Zynq 数据交互、视频场景用 VDMA 见视频流水线。
本文要回答的问题
- DMA 引擎在数据通路里扮演什么角色?S2MM/MM2S 是什么?
- AXI DMA / DataMover / VDMA 怎么选?
- 实际带宽怎么估、损耗在哪、怎么优化?
- 内存 buffer、缓存一致性、流与突发的速率匹配怎么处理?
一、DMA 数据通路
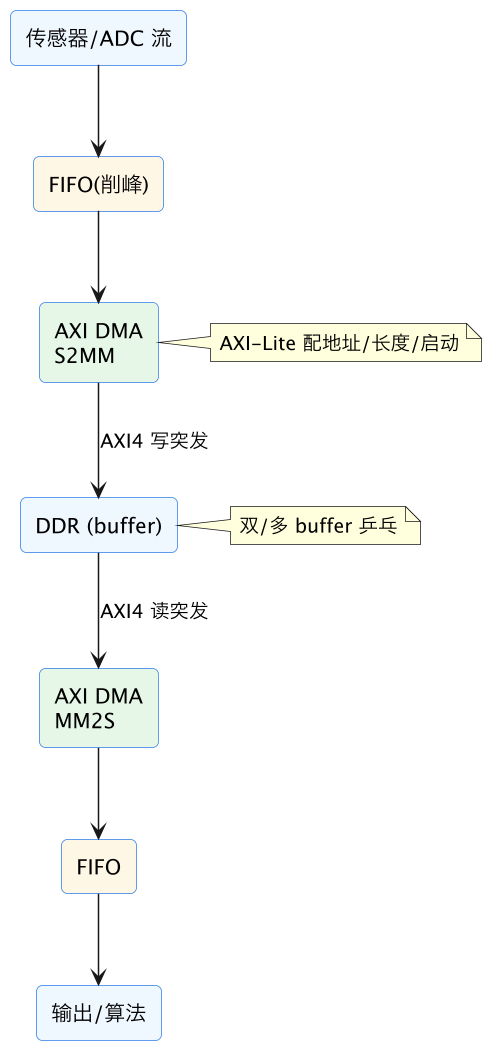
- S2MM(Stream to Memory-Mapped):流数据写进 DDR(采集/落盘方向);
- MM2S(Memory-Mapped to Stream):DDR 数据读成流(回放/发送方向);
- 控制面:AXI-Lite 寄存器设目的/源地址、长度、启动;中断报完成;
- 用户逻辑只见 AXI-Stream(valid/ready/tlast),不碰内存地址。
二、引擎选择
| 引擎 | 特点 | 适用 |
|---|---|---|
| AXI DMA | Lite 配置+流口,简单/SG 两模式 | 通用块数据采集回放 |
| DataMover | 命令流驱动(地址+长度),无寄存器框架 | 自定义调度、HLS m_axi、多通道仲裁 |
| VDMA | 二维帧缓冲、乒乓、同步信号 | 视频(见视频篇) |
| QDMA/XDMA | PCIe 主机侧 | PCIe 场景 |
三、带宽估算与优化
理论带宽 = 数据位宽 × 频率(64bit×150MHz≈1.2GB/s,128bit 翻倍)。实测打折因素:
- 突发长度:短突发效率低(寻址/仲裁/行打开开销占比大)→ 用长突发、连续 buffer;
- DDR 争用/刷新/行切换:多主设备时更明显;
- 流反压打断突发:流口停,突发悬置 → FIFO 削峰;
- 描述符/中断开销(SG 模式)。
工程取值:按理论的 60%~80% 估可用带宽,峰值需求再留 20%~30% 裕量。优化手段:长突发、加宽总线、多 HP 口并行、FIFO 隔离流与内存、多 buffer 乒乓。
四、buffer 与一致性
- 物理连续:DMA 绕过 MMU 用物理地址——裸机直接给地址;Linux 用 CMA 预留连续内存或 SG 链接不连续页;
- 缓存一致性(Zynq):HP 口不保证 cache 一致 → buffer 映射非缓存,或 DMA 前 clean、后 invalidate;要硬件一致走 ACP 口(带宽略低);
- buffer 管理:双缓冲至少(一块在搬、一块在用),高要求用环形多 buffer + 描述符;
- tlast/帧边界:流上用 tlast 标记一次传输结束,和描述符长度对应。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 给 DMA 传虚拟地址 | 乱写内存/崩溃 | 物理连续/CMA/SG |
| 不处理 cache 一致性 | CPU 看到旧数据 | 非缓冲映射或刷 cache |
| 流直连 DMA 无 FIFO | DDR 抖动时丢数 | FIFO 削峰+深度按最坏停摆 |
| 短突发零散传输 | 带宽只有理论两三成 | 长突发、连续 buffer |
| 单缓冲 | 搬运和处理互相等 | 双/多 buffer 乒乓 |
| 带宽按理论值规划 | 峰值丢数据 | ×60~80% 估再留裕量 |
| 描述符环不检查完成 | 覆盖未处理 buffer | 用完成中断/状态轮询 |
相关与延伸
协议基础:AXI4 完整与互联、AXI-Stream/Lite;存储:DDR MIG。 平台使用:Zynq DMA/VDMA、嵌入式软件;多时钟:多时钟系统。
一句话总结
DMA 让 FPGA 自己发起 AXI4 突发搬大块数据、CPU 只管配地址长度和收完成中断:S2MM 把流写进 DDR、MM2S 把 DDR 读成流,用户逻辑只看 AXI-Stream。引擎按场景选:通用块用 AXI DMA(简单 buffer 或 SG 散聚)、视频用 VDMA(帧缓冲乒乓)、自定义搬运用 DataMover(命令流给地址长度)。带宽按位宽×频率×60~80% 估(短突发、DDR 争用、流反压都打折),靠长突发、连续 buffer、FIFO 削峰、多 buffer 乒乓逼近理论值并留裕量。软件侧两大坑:DMA 用物理地址(Linux 走 CMA/SG)、缓存一致性(非缓存映射或 DMA 前后 clean/invalidate,或用 ACP);流与 DDR 之间必须加 FIFO,深度按"DDR 最坏停摆时间×数据率"的 2~4 倍设计。