AOCV 降额:按逻辑深度查表的片上偏差建模方法
Derate 与 POCV 建模讲过降额为什么存在、POCV 怎么用统计矩替代固定系数;MMMC 多角分析讲过角与角之间怎么组合。但在这两者之间还隔着一个工程上绕不开的问题:全局 OCV 一刀切太悲观,POCV 又依赖 Liberty 里的 LVF 矩数据——如果库里没有 LVF,或者项目节点还撑不起 POCV 的完整建模链,怎么办?答案就是本篇的主角 AOCV 降额(Advanced On-Chip Variation,高级片上偏差):用一张「逻辑深度 x 物理距离」的二维查值表,给路径上的每一级单元单独定降额系数,既不一刀切,又不需要逐单元统计矩。
本文要回答的问题
- 全局 OCV 为什么悲观?「一刀切降额」在数学上错在哪?
- AOCV 凭什么用「逻辑深度」做索引就能削掉大部分假悲观?背后的物理依据是什么?
- stage count(级数统计)到底怎么数?时钟路径和数据路径的口径一样吗?
- AOCV 库表(derate table)是怎么生成的?代工厂给的还是自己表征的?
- 在 PrimeTime/Tempus 签核里怎么加载 AOCV 表、怎么验证它生效了?
一、全局 OCV 的悲观从哪来:把相关偏差当成了独立偏差
OCV(On-Chip Variation,片上偏差)的物理事实很简单:同一片晶圆上,哪怕相邻的两个反相器,沟道长度、阈值电压也会因为工艺涨落而不完全一样,延迟自然有差异。签核时不能像测单管那样给每个晶体管实测值,于是经典做法是给整条路径乘一个降额系数——比如建立时间检查时数据路径延迟乘 1.05、时钟捕获路径乘 0.95,人为拉开 10% 的余量带。
问题在于这个「每条路径统一乘」的假设。一条路径有 5 级逻辑还是 50 级逻辑,都用同一个 1.05,这在统计上等于说:路径上所有单元的偏差是同一个方向的、完全相关的。而真实情况恰恰相反——片上随机涨落(random variation)在级与级之间大部分相互独立,第 3 级偏慢和第 17 级偏快会互相抵消。统计学常识:N 个独立同分布随机变量相加,总和的标准差只按根号 N 增长,不按 N 增长。50 级路径的真实偏差幅度远低于 50 个「每级都偏 5%」的叠加,可能只有它的 1/7 左右。
这就是全局 OCV 的结构性悲观来源:路径越长,假悲观越大。一条 60 级的数据路径在 5nm 节点上,全局 OCV 可能比实际硅偏差多吃掉 200ps 以上的余量——这些余量不会出现在硅上,却实实在在压在时序收敛身上,表现为永远修不完的 setup 违例、被迫加大的 buffer 面积和功耗。
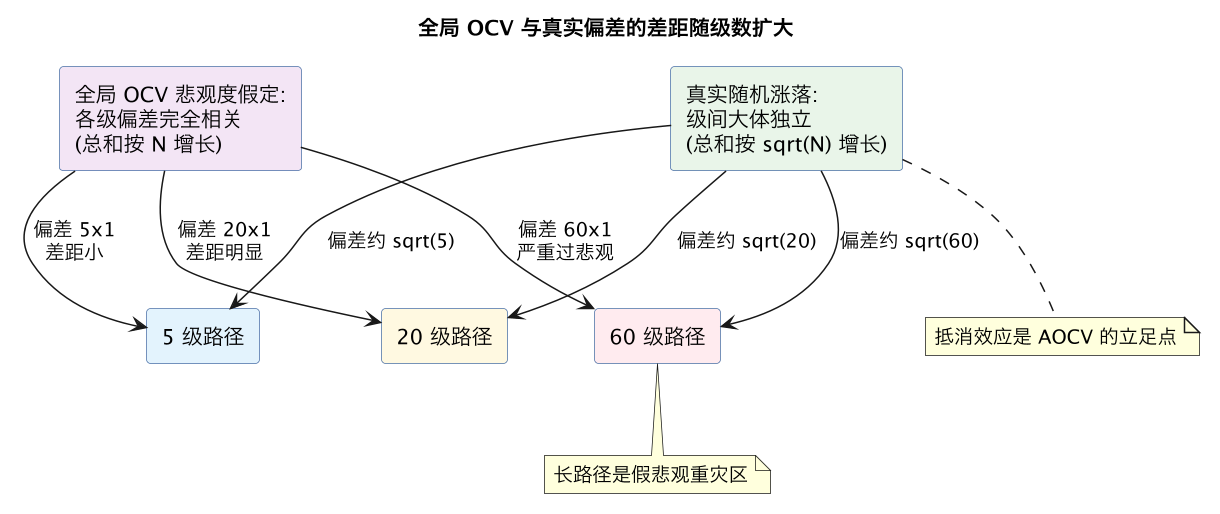
这张图把整篇的核心论点画出来了:横着看,路径越长,「完全相关」假设离真相越远;竖着看,AOCV 要做的事就是把降额曲线从「按 N 线性增长」拉回「按根号 N 亚线性增长」的轨道上来,而拉回的手段就是按级数查表。
二、AOCV 的核心思想:路径越长,单级降额越小
AOCV 把「一刀切」改成「按深度分档」。它给 STA 工具一张二维表:横轴是逻辑深度(depth,即路径上经过的单元级数 stage count),纵轴可以是单元间的物理距离(distance),表项是这一级单元该用的降额系数。深度 1 的孤立单元用最大的降额(比如 1.08),深度越深每级降额越小,深度 20 以上可能只剩 1.02,渐近收敛到一个地板值。
为什么这个做法在物理上站得住?因为片上偏差可以拆成两个成分:系统成分(systematic,比如版图梯度、密度效应)在空间上连续、方向上相关,不随级数抵消;随机成分(random)级间独立,随级数按根号 N 被平均掉。AOCV 表的深度维度刻画的正是随机成分的平均化曲线——级数越多随机成分摊得越薄,剩下的地板值就是消不掉的系统成分。这也是为什么 AOCV 表的降额不会降到 1.0:系统偏差永远在那。
| 对比维度 | 全局 OCV | AOCV | POCV |
|---|---|---|---|
| 降额粒度 | 整个设计一套系数 | 按深度/距离查表,逐级不同 | 逐单元逐弧的统计矩(sigma) |
| 需要的库数据 | 无额外数据 | AOCV 表(文本或 .aocv) | Liberty LVF(ocv_sigma_*) |
| 悲观度 | 最高,长路径假悲观严重 | 中等,深路径明显松绑 | 最低,且支持 PBA 精确传播 |
| 随机偏差建模 | 不区分 | 深度维度近似根号 N 平均 | 一阶矩/二阶矩显式建模 |
| 与距离相关性 | 无 | 可选 distance 轴 | 配合 SOCV 有空间相关模型 |
| 签核成熟度 | 老节点主流 | 28nm-7nm 广泛使用 | 7nm 以下主流,见 Derate 与 POCV |
从这张表能看出 AOCV 的历史位置:它是 OCV 到 POCV 之间的过渡形态,用极低的库数据成本拿到 POCV 七八成的悲观度收益。直到今天,不少成熟节点(28nm 及以上)和模拟/数模混合设计的数字部分,签核仍然用 AOCV 而不是 POCV——因为那些节点的 Liberty 库里根本没有像样的 LVF 数据,POCV 无从谈起。
三、stage count 怎么数:口径决定悲观度
AOCV 表查值的第一步是算每条路径的深度,而「怎么数」直接决定查出来的系数。STA 工具的标准口径是:数据路径从发起触发器的 clk 引脚开始,经过的每一个时序弧(cell arc)算一级,直到捕获触发器的 D 引脚。线网本身不算级,只有单元算。组合逻辑 30 级就是 depth=30。
时钟路径的数法对称但独立:发起侧时钟路径(launch clock path)和捕获侧时钟路径(capture clock path)各自从时钟根(clock source)数到触发器的 clk 引脚。setup 检查时 launch 时钟用 late 系数、capture 时钟用 early 系数,各自按自己的深度查表——两边的级数通常差很多,因为公共时钟段(common clock path)在 CRPR(时钟收敛悲观度削减)里已经被剔掉了,剩下的发散段往往只有 CTS 末级 buffer 那几级。所以时钟路径查到的 AOCV 降额通常比数据路径大(深度浅、系数靠表的左端),这是正常现象,不是工具数错了。
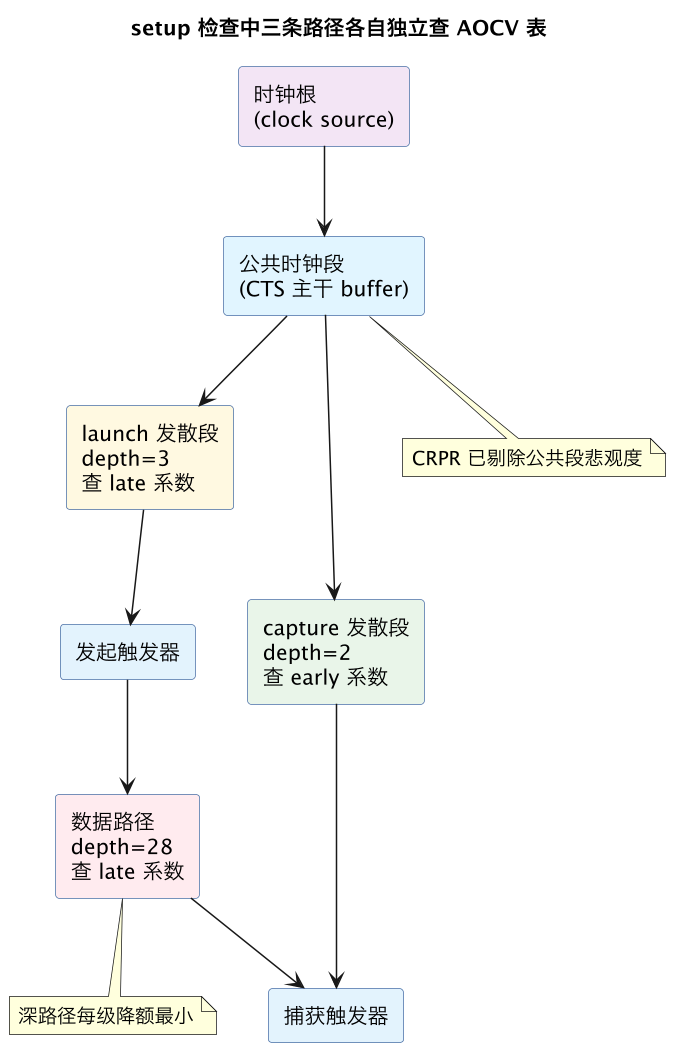
图里有个容易踩的坑值得点明:级数是按分析时刻的网表结构数的,不是按功能块数。一条数据路径中途被 hold 修复插了 6 个 buffer,depth 就从 22 变 28,AOCV 降额会进一步放松——这正是我们想要的(buffer 多了随机平均更充分),但也意味着 AOCV 的降额结果对网表版本敏感,ECO 之后必须重算,不能拿旧的降额缓存继续签。
几个具体场景下的计数口径值得单列一表,因为实际项目里一半的 AOCV 争议都出在这里:
| 场景 | depth 怎么数 | 备注 |
|---|---|---|
| 普通组合逻辑链 | 每经过一个单元算一级 | 线网、扇出分叉不另算 |
| buffer 树 / 时钟树末级 | 树上每个 buffer 算一级 | 树分叉后各分支按各自路径数 |
| 多层低功耗单元(isolation、level shifter) | 算一级,且通常有专属降额档 | 跨电压域单元 sigma 特性不同 |
| 层次边界(hierarchical port) | 不单独算级,穿透计入 | 扁平化分析才有正确深度 |
| 时序例外路径(multicycle) | 计数口径不变 | 例外只改周期预算,不改深度 |
还有一类争议是「depth 上限截断」。AOCV 表的深度轴不会无限延伸,典型表给到 20 或 40 就截断,超出部分用最后一档的地板值。这是故意的设计:深度 40 以上随机成分早已摊平,继续细分没有意义,反而会把表征误差引进来。如果你的关键路径普遍在 60 级以上(比如超长移位链),不要试图让 foundry 把表延到 60——正确做法是回头检查这条路径是不是该打断了。
四、AOCV 库表从哪来:表征流程与文件格式
AOCV 表不是拍脑袋填的,它的生成路径有两条:代工厂随 PDK 提供,或设计方用表征工具自己生成。先进节点代工厂的 signoff 包里通常附带推荐 AOCV 表(按 VT 类别、驱动强度分文件);如果不用原厂表,常见做法是用表征工具(或 foundry 认证的流程)对标准单元做蒙特卡洛 SPICE 仿真:同一单元在随机涨落下仿真数千次,统计延迟分布的 sigma,再按「N 级串联后总延迟 sigma 如何随 N 衰减」拟合出降额-深度曲线。
一张典型 AOCV 表的逻辑结构如下(实际文件是工具私有文本格式,这里给出语义骨架):
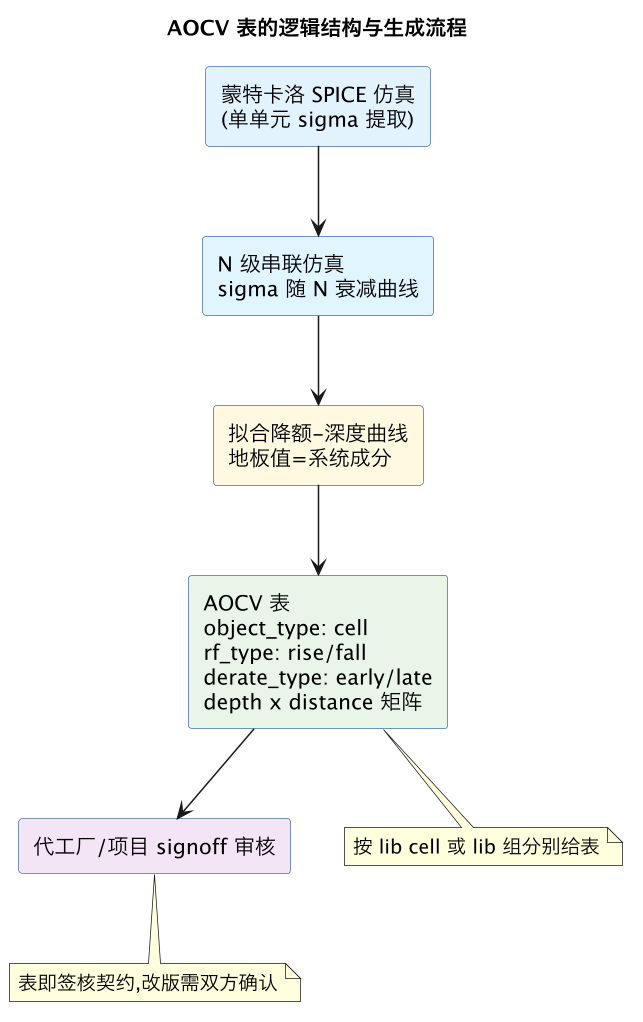
表里有几个字段决定它怎么被用:object_type 指定降额施加对象是单元还是线网(delay 用 cell 表、slew 有单独的 slew 表);derate_type 分 early/late,setup 和 hold 检查查的是同一表的不同列;distance 轴是可选的,建模的是空间相关成分——两个相距 500 微米的单元比一个 die 两端的单元更可能同向偏差,所以距离越远降额略大。很多项目为稳妥起见只用 depth 一维表,放弃 distance 维度换来更简单的审查。
还有一条工程纪律:AOCV 表和 MMMC 角定义是绑定的。同一份网表在 ss_0p99v_125c 角和 ff_1p1v_m40c 角用的 AOCV 表通常不同(低压角随机 sigma 更大,降额曲线整体抬高),角增减时表也要配套增减。表征轮次上也有讲究:库修订(library rev)哪怕只动了几个单元的时序弧拟合,sigma 特性就可能漂移,AOCV 表必须跟着重出;拿上季度的表签本季度的库,是 review 时一定会被揪出来的硬伤。
五、签核设置:加载、验证与常见翻车点
以 PrimeTime 为例,AOCV 的接入就三条命令的事:设 timing_aocvm_enable_analysis 为 true,用 read_aocvm 读入表格文件,然后正常 update_timing。Tempus 对应 set_analysis_mode -aocv true 加 read_aocvm。但「能跑」和「签对」之间隔着一串验证动作:
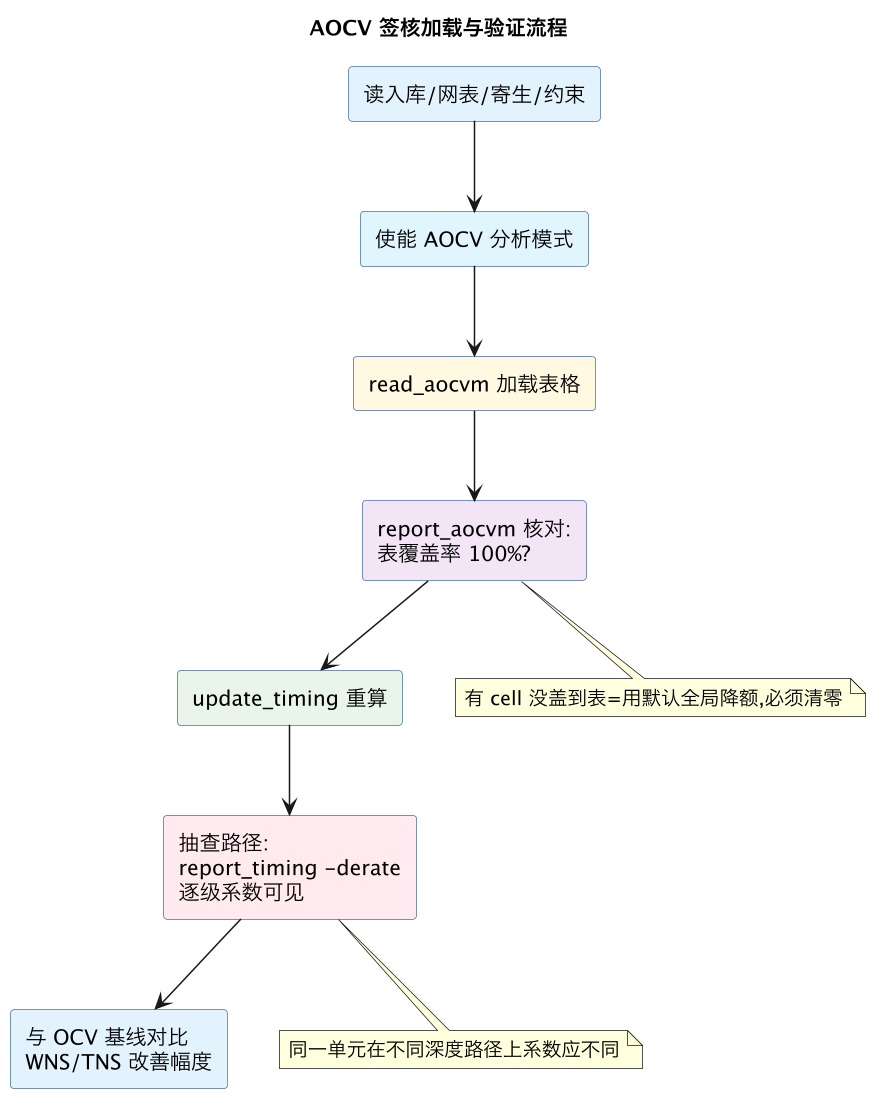
最常见的翻车点是覆盖率:库里新加的单元(比如 ECO 阶段引入的新驱动档位)不在 AOCV 表里,工具会悄悄退回全局默认降额,结果一部分路径奇悲观、一部分正常,报告里根本看不出来。所以 report_aocvm 的覆盖率检查必须进回归脚本,100% 才算过。第二个坑是混用:AOCV 和 POCV 不能在同一个分析里同时开(部分工具允许按时钟域混用,但审查风险极大),项目启动时就要在 PrimeTime/Tempus 签核方法学文件里写死选哪条路。第三个坑是拿实现阶段(Innovus/ICC2 里)的 AOCV 结果直接当签核结论——实现工具的 stage count 口径和 signoff 工具有细微差异(比如对 buffer 树的数法),最终数字一律以 signoff STA 为准,这与 GBA 与 PBA 分析模式里「实现用 GBA、签核补 PBA」的分工是同一个逻辑。
最后说收益量级:在 28nm 一个 40 万实例的模块上,从全局 OCV 切到 AOCV 后,setup TNS 通常能改善 40%-60%,修不完的违例路径减少一半以上,同时 hold 违例会小幅增加(early 侧降额也放松了)——这是正常的,提前留好 hold 修复余量即可。从 AOCV 再迁到 POCV 还有一档收益,但需要库端 LVF 数据支撑,那就是 SOCV 与 LVF 统计矩要讲的故事了。
把本篇的决策点收拢成一张速查表,方便项目启动会直接用:
| 决策问题 | 推荐做法 | 反模式 |
|---|---|---|
| 节点有 LVF 库吗 | 有则直接上 POCV,跳过 AOCV | 拿着完整 LVF 库还签 AOCV,白留悲观度 |
| AOCV 表来源 | 优先 foundry 认证表 | 自己拟合却没过 signoff 审核 |
| depth 维还是 depth+distance | 成熟项目上一维即可,先进节点再考虑二维 | 为「精确」上二维,审查周期翻倍 |
| 覆盖率不达标怎么办 | 补表或退回全局 OCV 整体签 | 放任部分单元用默认值混签 |
| ECO 后怎么处理 | 重跑 stage count 加全量 STA | 复用 ECO 前的降额结果增量签 |
这一篇在知识体系里的位置
本篇是「时序悲观度建模」主线的中间一环:MMMC 多角分析解决「角与角之间」的偏差覆盖,本篇的 AOCV 解决「同一个角内部、路径与路径之间」的悲观度分级,Derate 与 POCV 建模再往下走到逐单元统计矩,SOCV 与 LVF 矩补上空间相关建模。分析模式层面配合 GBA 与 PBA 理解悲观度削减的另一条轴;落地执行时回到 PrimeTime/Tempus 签核 的完整流程。
总结
AOCV 降额的全部要义是一句话:片上随机偏差随逻辑级数按根号 N 平均抵消,所以降额系数不该一刀切,而该按 stage count 查一张「深度 x 距离」表——深度越浅降额越大、越深越小并收敛到系统成分地板值;用好它的三个纪律是:表覆盖率必须 100%、ECO 后级数必须重算、与 POCV 二选一不混用。