valid-ready 握手与反压实测:200 项传输零错误、44 拍反压波形实证
更新时间:2026-10-25。本文是「集成电路大类 · 芯片设计」入门层(beginner)的一篇实验文。理论篇 三个最常见基础模块:FIFO、仲裁器、握手 已经把 valid-ready 握手的三条规则讲清楚了——那一篇解决「规则是什么」;本篇解决另一个问题:**下游随时会「吃不下」的反压场景里,一级流水缓冲怎么做到不丢数据、不重数据?**我们实现一个一级弹性缓冲(elastic buffer)流水级,用随机反压激励真跑 200 项传输,让计数器和波形一起作证。
本文要回答的问题
- valid-ready 握手的「成交」到底发生在哪一拍?
- 下游 ready 拉低(反压)时,上游 valid 和数据必须遵守什么纪律?
- 一级弹性缓冲的
in_ready = !out_valid || out_ready是什么意思? - 随机反压下实测吞吐率掉到多少?数据完整性怎么自动验证?
先给结论卡,四个数字全部来自后文真实仿真日志:
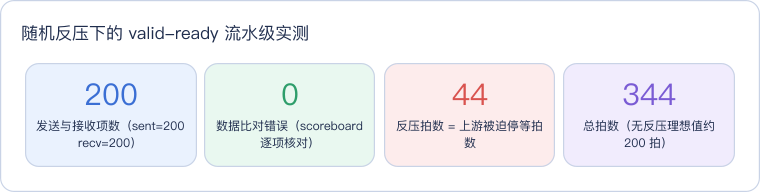
读这张卡抓一组关系:200 项数据在理想满吞吐下约 200 拍传完,实测用了 344 拍——多出来的部分正是下游 40% 概率拉低 ready 造成的停顿;其中 44 拍里缓冲已满、上游被明确顶住(in_valid 高但 in_ready 低),但 200 项数据一项不丢、一项不重。
一、握手规则与「成交」时刻
valid-ready 握手的全部规则就三条:发送方数据有效就拉高 valid,接收方能收就拉高 ready,同拍两个信号都为高,数据在这一拍末尾完成转移——这一拍叫「成交」或「传输拍」。三条纪律跟着规则来:valid 拉高后在成交前不许撤、数据在成交前不许变、ready 允许随时起落。
把一次典型的反压场景画成时序图最直观。下游第 3 拍拉低 ready,上游已经把 valid 和数据摆上了总线,只能举着不动,直到第 5 拍 ready 回来才成交:
读这张波形抓住两段平台期:第 3-4 拍 in_ready 和 out_ready 同时走低(反压开始),in_valid 和 in_data 保持不动——这就是纪律一和纪律二的具象化,上游「举着数据等」;第 5 拍 ready 回高,当拍成交,out_valid 在下一拍随之放行。新手最常犯的错是在等待期间把 in_data 换成下一个数据,接收方就会在成交拍采到错误的值——波形里 in_data 的平台段就是防这件事的。
这套规则之所以成为事实标准,是因为它把流量控制与数据有效性彻底解耦:发送方不需要知道下游的缓冲深度、处理速度,只盯一个 ready;接收方不需要预告自己何时能吃,只在自己方便的拍拉高 ready。AXI-Stream、TileLink、以及大量芯片内部自定义接口都沿用这套语义,区别只在数据通道旁边挂多少侧带信号。学会读本文这张六信号的波形,读任何 AXI 类接口的波形都只是「信号多一点」的问题。
二、一级弹性缓冲:反压怎么向上游传导
单看握手信号还不够,真实流水级内部要有一个寄存器存「已被接收但还没被下游取走」的数据。本文的 DUT 是教科书上最经典的一级弹性缓冲,全部逻辑只有一行 assign 加一个 always 块:
assign in_ready = !out_valid || out_ready;

always @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        out_valid <= 1'b0;
        out_data  <= 0;
    end else if (in_ready) begin
        out_valid <= in_valid;
        if (in_valid) out_data <= in_data;
    end
end
in_ready = !out_valid || out_ready 这一行是整个设计的灵魂,用一张数据流图把上下游关系摆清楚:
读这张图抓两条路径的颜色分工:绿色顺流路径是数据从上游经寄存器到下游的正向流动;红色反压路径是下游的 out_ready 反向传回上游——缓冲空着(!out_valid)或者下游正等着收(out_ready)时,in_ready 为高,上游随时可以放新数据进来;缓冲占着且下游又不收,两者同时成立时 in_ready 才拉低,把压力原样顶回上游。这就是「弹性」的含义:一项的存储深度刚好吸收一拍的决策延迟,让反压传导不需要打断已经在路上的数据。
值得注意的是 in_ready 是纯组合逻辑、直接依赖 out_ready——好处是反压当拍生效、零延迟;代价是 out_ready 到 in_ready 之间有一条跨模块的组合路径,在多级级联、物理距离远的场景会成为时序瓶颈。工程上的解法是把 ready 也寄存器化(skid buffer / pipeline register 变体),那是进阶话题,本篇先把行为语义吃透。
还有一个容易想反的细节:缓冲只有一级,out_valid 和 out_ready 同拍为高时,寄存器里的旧数据被下游取走、上游的新数据同拍补进来——in_ready 表达式里的 || out_ready 支路就是放行这种「边取边补」的满速流水工况。如果把这个支路去掉(in_ready 只看 !out_valid),缓冲每空一次要停一拍才能补,满速场景吞吐直接腰斩到 0.5 项每拍。这一行表达式的两个子句分别对应两种工况:!out_valid 管「空着尽管进」,out_ready 管「满了但下游正在取,照样进」,二者缺一不可。
三、测试平台:随机反压 + scoreboard 双保险
激励设计刻意制造压力:下游 out_ready 每拍以约 40% 概率拉低($random % 100 < 60 为高),上游则持续举着 in_valid 不放、一个数据被接收立刻换下一个——这是「源快汇慢」的典型工况。验证靠两个互相独立的机制:
| 机制 | 检查内容 | 对应风险 |
|---|---|---|
| scoreboard 逐项比对 | 第 k 个被下游收走的数据 == 第 k 个被上游发送的数据 | 丢数据、重数据、乱序 |
| 计数器对账 | sent == recv == 200,且 backpressure_cycles > 0 | 反压没真正发生(激励无效) |
| 停顿计数 | stall_cycles(in_valid && !in_ready 拍数) | 反压是否正确传导到上游 |
第二条的 bp_cycles > 0 是个容易忽略但很重要的判定:如果激励写错了导致 ready 全程为高,200 项数据照样零错误通过,但这个实验就白做了——它验证的是「无反压时不出错」,而不是「反压下不出错」。把「反压确实发生过」列进 PASS 条件,是这类负面场景测试的标准手法。
四、iverilog 实测:344 拍传完 200 项
整个流程就两条命令:iverilog -g2012 编译、vvp 运行。真实执行实录如下:
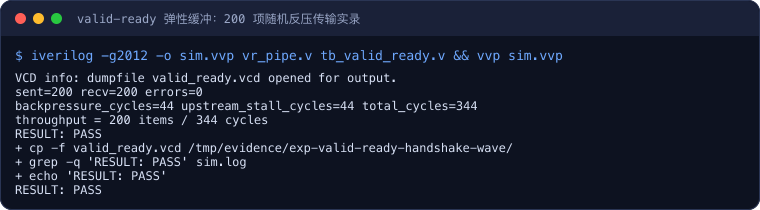
读这份实录抓四行数字。第 12 行 sent=200 recv=200 errors=0 是完整性总账——上游发出的 200 项和下游收到的 200 项逐项相等,零丢失零重复。第 13 行三个计数器讲反压故事:backpressure_cycles=44 拍里缓冲被占住且下游拒收;upstream_stall_cycles=44 与前者精确相等,证明反压每一次都正确传导回了上游、没有一拍该停没停;total_cycles=344 是全部开销。第 14 行给出吞吐率:200 项 / 344 拍 ≈ 0.58 项每拍,和下游 60% 就绪率的理论上限(约 0.6)几乎贴合——一级缓冲的吸收能力有限,吞吐率基本被下游速率钉死,这本身就是符合理论预期的结果。
从编译到判定的完整过程原样摘录一段,可以看到从 VCD 波形文件生成到 scoreboard 总账再到脚本判定的完整链条:
+ iverilog -g2012 -o sim.vvp /tmp/evidence-src/exp-valid-ready-handshake-wave/vr_pipe.v /tmp/evidence-src/exp-valid-ready-handshake-wave/tb_valid_ready.v
+ vvp sim.vvp
+ tee sim.log
VCD info: dumpfile valid_ready.vcd opened for output.
sent=200 recv=200 errors=0
backpressure_cycles=44 upstream_stall_cycles=44 total_cycles=344
throughput = 200 items / 344 cycles
RESULT: PASS
+ cp -f valid_ready.vcd /tmp/evidence/exp-valid-ready-handshake-wave/
+ grep -q 'RESULT: PASS' sim.log
+ echo 'RESULT: PASS'
RESULT: PASS
这段摘录里 backpressure_cycles=44 和 upstream_stall_cycles=44 两个数字并排出现,是全文最值得停下来看的一行:它定量证明了这个一级缓冲的反压传导是无损的——下游每一次拒收,上游都恰好停了一拍,不多也不少。开头的 VCD info 说明波形文件同步落盘,想逐拍复核时可以用 GTKWave 打开 valid_ready.vcd,按本文第一节的波形图对照任意一个反压窗口,检查 in_data 是否在等待期间保持不动。
五、从这份实验能带走的三条经验
第一,「成交才计数」是写握手测试平台的第一原则。上游 sent 计数器只在 in_valid && in_ready 同高的拍加一,下游 recv 同理只在成交拍加一——谁如果把「valid 拉高」当「数据已发出」,反压场景里立刻账目不平。本文 scoreboard 的模型数组下标就是成交序号,比对自然有序。
第二,反压测试必须验证「反压真的发生了」。把 bp_cycles > 0 写进 PASS 条件,防止激励失效造成假通过。同理想法也适用于其他负面场景:测溢出保护就要确认溢出真被触发过,测超时重传就要确认超时真发生过。
再往深一层,本文还专门对比了 backpressure_cycles(下游视角:缓冲被占且下游拒收的拍数)与 upstream_stall_cycles(上游视角:举着 valid 但被拒的拍数)两个计数器。在一级缓冲这个特定结构里,二者应当精确相等——实测都是 44。如果设计换成两级缓冲或 FIFO,这两个数字会拉开差距(缓冲吸收了部分反压、上游停顿少于下游拒收),那时「差值 = 被缓冲吸收的反压量」本身就是衡量缓冲深度的定量指标。养成同时从两侧各摆一个计数器的习惯,接口行为就从「感觉没丢」变成「账目能对上」。
第三,一级缓冲的吸收能力就是一拍。实测吞吐 0.58 贴近下游就绪率 0.6,说明深缓冲并不能凭空创造带宽——缓冲深度解决的是「吸收突发、平滑速率抖动」,长期平均吞吐永远被最慢一级钉死。想要更高的抗突发能力就把一级缓冲换成同步 FIFO(见同系列 同步 FIFO 实测),valid-ready 接口原样保留,变的只是内部深度。
动手复现时建议做两个修改实验:一是把下游就绪率从 60% 改成 90%,观察 total_cycles 向 220 左右收敛、吞吐率上升,建立「就绪率 ↔ 吞吐」的定量直觉;二是故意把 DUT 里的 in_ready 恒接 1(去掉反压传导),重跑会看到 scoreboard 立刻报 MISMATCH——下游拒收的拍里寄存器被新数据覆盖,旧数据丢了。亲眼看一次「握手纪律破坏 → 数据损坏」的因果链,比读十遍规范更能记住那三条纪律。
这一篇在知识体系里的位置
- 理论承接:三个最常见基础模块:FIFO、仲裁器、握手(握手三条规则的定义);
- 缓冲深化:同步 FIFO Verilog 实现与回归实测(把一级弹性缓冲扩成深 FIFO);
- 波形阅读方法:数字波形怎么读(用 GTKWave 逐拍复核本文 VCD)。
一句话总结
valid-ready 握手在反压下的全部纪律就是「成交前 valid 不撤、数据不变」,一级弹性缓冲用 in_ready = !out_valid || out_ready 一行组合逻辑把压力无损顶回上游——实测 200 项传输、44 拍反压、零丢失零重复,吞吐率被下游就绪率钉死,深缓冲只能吸收突发不能创造带宽。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:iverilog -g2012(eda-golden-v1 镜像自带 Icarus Verilog)
- 日期:2026-10-25
- 完整命令:
bash run.sh(内部执行iverilog -g2012 -o sim.vvp vr_pipe.v tb_valid_ready.v,随后vvp sim.vvp,拷贝valid_ready.vcd,最后grep 'RESULT: PASS' sim.log)
代码获取
完整 RTL 与测试平台已同步到公开仓库:geek-doc.cn/experiments/exp-valid-ready-handshake-wave,克隆后进入该目录执行 bash run.sh 即可复现本文全部结果;生成的 valid_ready.vcd 可用 GTKWave 打开逐拍对照。