SystemVerilog TLM 通信:port/export/imp 连接方向与事务传输全解
更新时间:2026-09-25。在 UVM 组件与 phase 里,monitor、scoreboard、driver 都是独立组件,它们之间不直接持有对方句柄,而是靠 TLM(Transaction-Level Modeling,事务级建模)端口收发事务。这一篇专门拆开 SystemVerilog TLM 通信的端口体系:谁发起、谁实现、连接怎么逐层穿透,以及 monitor 抓到的事务如何一路送到 scoreboard。
本文要回答的问题
- port、export、imp 三种端口到底有什么区别,为什么不能随便连?
- initiator 和 target 两个组件怎样在互不知晓对方类型的情况下通信?
- put、get、peek 有什么语义差异,blocking 和 nonblocking 版本在调度上如何表现?
- 一个 monitor 的事务想同时送给 scoreboard 和 coverage collector,怎么接?
- 生产和消费节奏不一致时,tlm_fifo 应该插在哪两个端口之间?
一、从事务级抽象说起:为什么需要 TLM
信号级 testbench 用 @(posedge clk) 逐拍改管脚,组件之间共享的是 wire。问题在于:driver 把一个 16 拍的 burst 写完之后,scoreboard 怎么知道这是一笔完整事务?如果 monitor 直接调用 scoreboard 的任务,两个类就硬绑在一起,换一个 scoreboard 实现就得回头改 monitor 的代码,agent 想原封不动搬到下一个项目更是无从谈起。
TLM 把通信单位从「信号跳变」提升为「事务对象」:一笔 read、一个 packet、一条总线 burst,封装成一个 transaction 对象,通过端口上的方法调用传递。方法名本身就是通信语义——put 表示我塞给你,get 表示我主动来取。发起方只面对一个端口句柄,不关心实现方是谁、处在哪一层,这正是 分层 testbench 架构与复用 能跨项目复用的基础。
这里说的 TLM 属于 TLM-1 范畴,也就是 UVM 随附的 uvm_tlm 包:它关心的是组件之间「把一个事务从这里送到那里」,不描述总线周期、不规定时序阶段,所以端口类型只与数据流向和阻塞行为有关,与具体协议无关。无论是 AXI、APB 还是自定义小包协议,monitor 出口长的都是同一副 analysis_port 面孔。协议差异被关在 transaction 字段和 monitor 的采样逻辑里。
TLM 给通信参与方起了三个角色名:initiator 是主动发起调用的一侧,target 是被动响应、握有数据或处理逻辑的一侧,interconnect 处在中间做路由和分发。一个组件可以同时扮演多个角色——scoreboard 对 monitor 是 target,对参考模型又可能是 initiator。角色描述的是「在这一次方法调用里谁主动」,不是组件的固定身份。
附带的好处是仿真效率与可读性。逐拍握手要在 testbench 和 DUT 之间唤醒大量调度事件;事务级通路一次方法调用就传递整笔 burst,组件内部再把它拍碎成信号时序。调试波形时,在 put/write 上设断点,看到的是有意义的事务流,而不是对着 valid/ready 波形人工拼包。
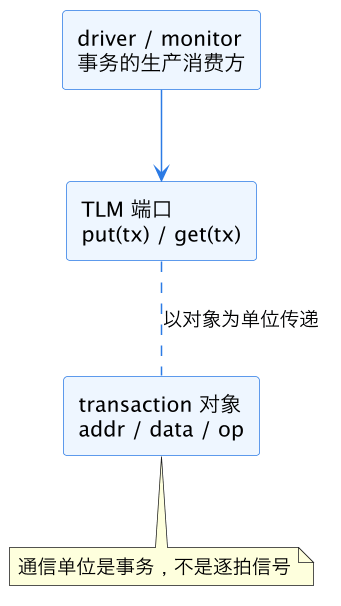
上图表达的核心是:组件只看见端口上的方法,方法携带的参数是 transaction 对象。时钟拍数被收进 driver 和 monitor 内部,组件之间的对话里不再出现 clk、valid、ready 这些信号词。
二、port、export、imp:发起、穿透、实现
SystemVerilog TLM 通信把端口分成三种角色,初学者最常犯的错就是把它们当成同义词。
- port:发起连接、发起调用的一端。initiator 组件持有 port,它声明「我要 put 事务出去」,但自己不实现这个方法。
- export:中间层的「透传插座」。它让连接继续向下穿透,自身也不实现方法,用于把外层端口接到层级深处的内层组件。
- imp(implementation 的缩写):方法真正落地的一端。target 组件持有 imp,
put/get任务的实体代码就写在这个宿主组件里。
连接规则只有一句话:connect 必须从 port 这一侧发起,一路连到 imp,中间可以穿过任意多个 export。 方向反了、两个 imp 互连、或者两边参数化的事务类型不一致,仿真在 connect_phase 就会报 fatal,不会带病跑到 run 阶段才出怪事。
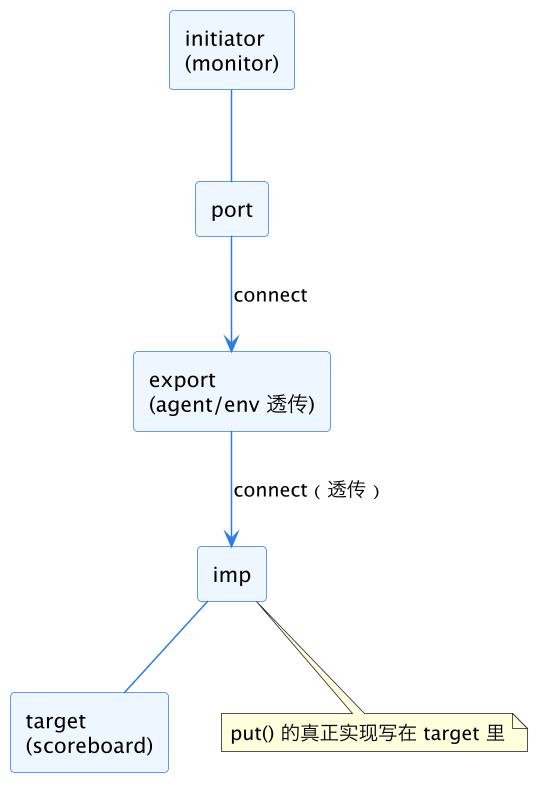
这张连接层次图值得对着代码记:monitor 里声明的是 uvm_blocking_put_port,scoreboard 里声明的是 uvm_blocking_put_imp,env 在更高一层把两者缝起来。monitor 从头到尾不知道 scoreboard 的存在,它只知道「我的 port 连上了某个实现」。
中间层到底声明 port 还是 export,判断标准是一句话:这个组件自己要不要主动发起调用?要发起,用 port,因为只有 port 能作为 connect 的起点;只负责把内层组件的接口暴露出去,用 export。常见的误写是 agent 图省事也声明一个 port,再写一个转发任务把数据倒一手——功能能跑,但凭空多了一层无意义的方法调用,也让连接关系在代码里变得难追踪。export 的价值就是让「透传」这件事在类型上显式可见。
三、逐层连接:connect 发生在什么地方
UVM 的惯例是子组件各自声明端口,在父组件的 connect_phase 里完成接线。agent 作为中间层时,要把内部 monitor 的 port 通过自己的 export 暴露给 env。
class tx_monitor extends uvm_monitor;
  uvm_blocking_put_port #(txn_t) put_port;
  task run_phase(uvm_phase phase);
    txn_t tx;
    forever begin
      collect_txn(tx);          // 在总线上采一笔事务
      put_port.put(tx);         // 只管发,不管谁收
    end
  endtask
endclass

class tx_agent extends uvm_agent;
  uvm_blocking_put_export #(txn_t) put_export;
  function void connect_phase(uvm_phase phase);
    mon.put_port.connect(put_export);   // 内层 port 接到本层 export
  endfunction
endclass

class tx_scoreboard extends uvm_scoreboard;
  uvm_blocking_put_imp #(txn_t, tx_scoreboard) put_imp;
  task put(txn_t t);                    // imp 要求宿主实现 put
    compare(t);
  endtask
endclass

class tx_env extends uvm_env;
  function void connect_phase(uvm_phase phase);
    agt.put_export.connect(sb.put_imp); // export 最终落到 imp
  endfunction
endclass有个语法细节:uvm_blocking_put_imp #(TX, IMP) 的第二个参数是宿主组件类型,因为 imp 要回头调用宿主的 put,所以 scoreboard 必须真的提供一个签名完全匹配的 task put(txn_t t),漏了就是编译错误。imp 类名随方法组合各不相同(如 put_imp、get_imp),同一组件需要多个同型 imp 时,UVM 提供 `uvm_blocking_put_imp_decl(_suffix) 宏生成带后缀的新类,避免两个 imp 抢同一个 put 任务名。
层级更深时,export 可以层层嵌套。一个 SoC 级 env 下面有子 env,子 env 下面有 agent,agent 里面才是 monitor。这条链上每一层都声明自己的 export,在各自的 connect_phase 里把内层 port 接到外层 export:agent 接 monitor,子 env 接 agent,顶层 env 再接子 env。穿透多少层由结构决定,端口写法不因此变化。读代码时顺着 export 往里找,总能找到最深处的 imp;找不到,说明这条连接在某一层断了,仿真也会在启动时直接指出来。
调用方向与连接方向一致:run 阶段 mon.put_port.put(tx) 沿建好的连接链,最终执行的是 scoreboard.put。中间的 export 没有任何方法体,纯粹是结构上的转接器。直接收益是替换实现零成本——把 scoreboard 换成 predictor,monitor 一行不改,env 里改一个 connect 目标即可。
| 端口类型 | 谁持有 | 是否实现方法 | 典型出现位置 |
|---|---|---|---|
| port | initiator | 否,只发起调用 | driver、monitor |
| export | 中间层容器 | 否,透传连接 | agent、env、subenv |
| imp | target | 是,方法体在宿主组件内 | scoreboard、coverage、fifo |
四、put / get / peek 与 blocking / nonblocking
同一件「传递事务」的事,TLM 按数据流向和等待行为给了两套正交的语义。
流向方面:put 是 initiator 把事务推给 target;get 是 initiator 主动从 target 拉走一个事务,取走后 target 不再保留;peek 也取,但不拿走,下一次 get/peek 看到的还是同一个事务,适合「先看一眼决定怎么处理,再正式取走」的场景。阻塞行为方面:blocking_put 是 task,可以挂起调用方直到对方就绪;nonblocking 版本是 function,立即返回状态位,绝不消耗仿真时间,接口名形如 try_put、try_get,配合 can_put/can_get 探活。
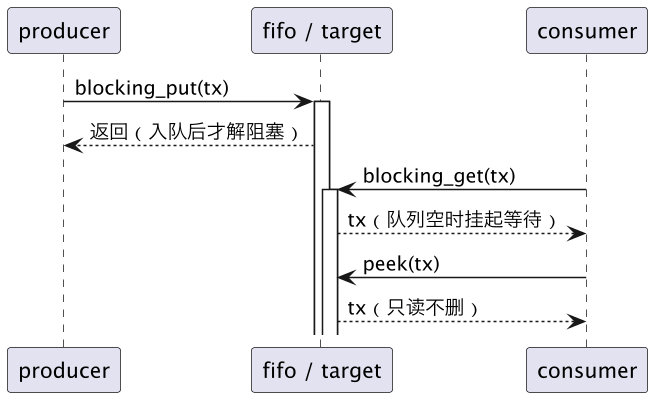
时序图的关键在两个「挂起点」:fifo 满时 put 不返回,fifo 空时 get 不返回。这种反压是自动的,生产者消费者因此不会丢事务。nonblocking 版本适合「有就处理、没有就干别的」的轮询:返回 0 时组件可以转去检查超时或服务其他通路,避免把整条线程堵死。需要同时具备两套接口时,用 uvm_put_port/uvm_get_port 这种合体端口,一个端口上既有阻塞 task 又有非阻塞 function。除了单向的 put/get,TLM-1 还提供 transport:调用方一次发出 request、阻塞等待 response,语义上接近函数调用,适合 driver 把命令交给参考模型并取回期望值的场景,它与「put 之后再各自 get」的区别是一次调用完成配对,不存在请求和响应错配的窗口。
| 方法 | 流向 | 调用后数据归属 | 典型用途 |
|---|---|---|---|
| put | initiator → target | target 持有 | monitor 推送、driver 下发 |
| get | target → initiator | initiator 取走 | scoreboard 取待比对事务 |
| peek | target → initiator | target 保留 | 预取检查、路由前窥探 |
| transport | 双向往返 | 请求/响应一次配对 | 命令换结果的模型调用 |
五、analysis_port:一份事务广播给多个订阅者
普通 put 端口是点对点的,一个 port 最终只连到一个 imp。验证里更常见的需求是扇出:monitor 采到的同一笔事务,scoreboard 要、coverage collector 要、打印模块也要。为每个接收方各开一个 port,monitor 就得跟着接收者数量改代码。
uvm_analysis_port 解决的正是这个问题。它内部维护一个订阅者列表,一次 write(tx) 广播给所有已连接的 uvm_analysis_imp。订阅是松耦合的:零个订阅者也合法,广播直接空转;在 passive agent(只监听不驱动的 agent)里接一个新 subscriber,env 中多加一行 connect 就够,monitor 无感知。
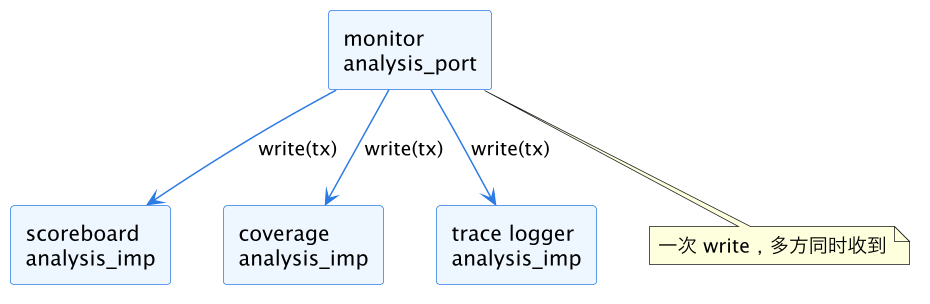
图中三条边共用同一个事务句柄,因此有个工程细节:接收方不应修改收到的对象,多个 imp 并发写同一对象会互相污染,需要留存就先 clone 一份。analysis 通路本身是非阻塞的 function 调用,广播按 connect 的顺序逐家执行,某个 subscriber 的 write 写得慢会拖慢整次广播,所以 write 实现要轻量,重活丢给后台线程或先进 fifo。不想直接实现 imp 时,可以继承 uvm_subscriber #(T),它已经把 analysis_imp 和 write 壳子备好了。与点对点端口相比,analysis 通路没有反压、不保证消费方处理完才返回,因此它的定位是「观测与分发」,而不是流量控制;需要反压的通路仍应走 put/get 加 fifo。
六、tlm_fifo:在节奏不一致的组件之间加缓冲
端口直连要求两边在同一时刻握手:scoreboard 正在 get 上等,monitor 恰好 put。真实环境里两边节奏独立——monitor 背靠背采到三笔,scoreboard 比对一笔要查参考模型,耗时若干拍。uvm_tlm_fifo #(T) 就是标准缓冲组件:对上提供 put 侧 export、对下提供 get 侧 export,内部是一个定长队列,满了反压 put,空了挂起 get。
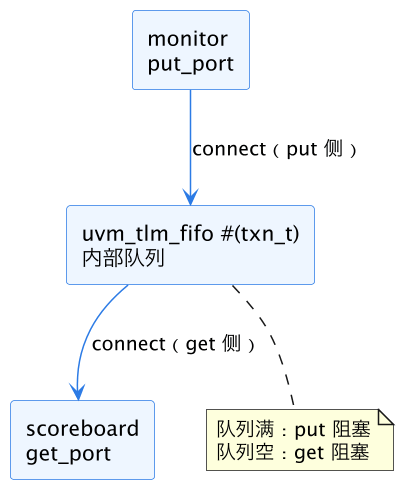
接法上 fifo 自己就是 imp 的拥有者,所以 monitor 的 port 连 fifo.put_export,scoreboard 的 get_port 连 fifo.get_export,双方都不用实现对方的方法。是否需要 fifo 按通路判断:analysis 广播用 analysis_imp 直接收即可;点对点且消费方处理耗时(如带参考模型的 predictor),加 fifo 能隔离两边节拍。深度要结合用例长度选择,UVM 还提供无界版本,代价是写错了会默默吃光内存。收尾阶段有两个有用检查:used() 不为零说明有事务进了队却没被取走比对,是漏比对的直接信号;flush() 则用于 reset 之间清空残留,防止上一段激励污染下一段。fifo 还自带 put_ap 和 get_ap 两个 analysis_port,事务每次入队、出队都会向外通知。不想用阻塞 get 挂起线程时,可以订阅这两个端口被动感知队列变化,coverage 统计生产消费速率时也直接取这个信号,不必另埋钩子。
七、完整实例:monitor 到 scoreboard 的真实接线
把前面几块拼起来,agent 内常见结构是:monitor 用 analysis_port 广播,env 里挂 scoreboard 和 coverage,scoreboard 前放一个 fifo 做缓冲。
class tx_monitor extends uvm_monitor;
  uvm_analysis_port #(txn_t) ap;
  task run_phase(uvm_phase phase);
    txn_t tx;
    forever begin
      collect(tx);
      ap.write(tx);                 // 广播,不关心订阅者数量
    end
  endtask
endclass

class tx_scoreboard extends uvm_scoreboard;
  uvm_blocking_get_port #(txn_t) get_port;
  task run_phase(uvm_phase phase);
    txn_t tx;
    forever begin
      get_port.get(tx);             // 按自己的节奏取
      check(tx);
    end
  endtask
endclass

class tx_env extends uvm_env;
  tx_agent              agt;
  tx_scoreboard         sb;
  tx_coverage           cov;
  uvm_tlm_fifo #(txn_t) sb_fifo;
  function void connect_phase(uvm_phase phase);
    agt.mon.ap.connect(sb_fifo.put_export);   // 广播的一个分支入队
    agt.mon.ap.connect(cov.analysis_export);  // 另一个分支直收
    sb.get_port.connect(sb_fifo.get_export);
  endfunction
endclass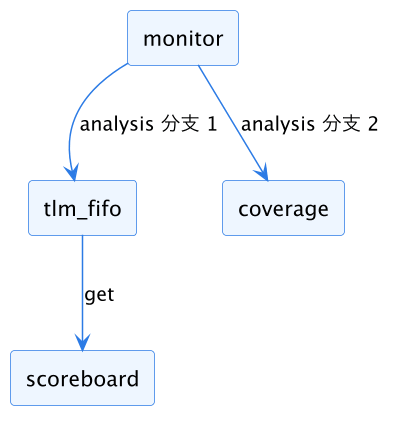
对照最后一张结构图读代码:monitor 只有一个 analysis_port,两条边在 env 的 connect 里决定,一条进 fifo 再由 scoreboard 按自己节奏 get,一条直送 coverage。这就是 SystemVerilog TLM 通信的典型落地形态——发起方、接线方、实现方职责分离,任一环替换都不波及其他组件。接线完成后建议在仿真起步阶段做一次最小验证:只跑几笔定向事务,确认 fifo 的 used() 随 monitor 广播而增长、随 scoreboard 比对而回落。计数器只涨不落,说明 get 侧没接上或 scoreboard 线程已死;始终为零,说明 monitor 的广播在 env 那一层接错了对象。这个检查在第一个用例上花十分钟,能省掉后面整条回归的错误数据。
多端口、多 scoreboard 的复杂总线环境只是在这张图上重复同样的元件与规则,可参考 AXI UVM 环境搭建 与 scoreboard 轨迹比对。
八、常见坑
- connect 方向写反或在 build_phase 就 connect:接线统一放在
connect_phase,此时所有子组件才保证已创建完毕。 - imp 宿主漏写方法或参数类型对不上:编译能过、 elaboration 报方法缺失,对照 imp 要求的签名补齐。
- 在 analysis 订阅者里修改事务对象:广播共享句柄,后收到的订阅者会看到被改过的数据,需要私有副本就 clone。
- fifo 深度拍脑袋:深度太小退化成直连、反压频繁;用无界 fifo 又可能掩盖消费方卡死,先按最长 burst 估,再用
used()峰值回归校准。 - 复位后不清 fifo:多段激励场景里 reset 之间要
flush(),否则旧事务会在新阶段被比对出来。 - 用 analysis_port 充当可靠传输:它不阻塞、无应答,订阅者漏掉事务不会报错;关键比对通路要么用 imp 直收,要么在收尾检查 fifo 余量。
- 结束测试时不核对在途事务:objection 落下前应确认 scoreboard 已排空输入,最后一笔事务还躺在 fifo 里就结束,用例假性通过是最隐蔽的那类漏测。
- 一个组件上堆太多 imp:事务类型不同、语义不同的接口全塞进一个类,connect 时极易接错位置;按通路拆成小的 subscriber 或 predictor,接线关系一目了然,出问题也更容易定位。
这一篇在知识体系里的位置
- 向上承接:UVM 组件与 phase 给出组件骨架,本篇解释组件之间如何传事务。
- 横向相关:sequence 与 driver/scoreboard 协作 讲激励侧 seq_item_port 通信,与 monitor 侧 analysis 通路对称。
- 机制对照:event、semaphore 与 mailbox 是语言级同步原语,TLM 端口则是面向组件复用的结构化封装。
- 落地延伸:分层 testbench 架构与复用 展示这些连接如何在 agent/env 分层中组织。
总结
SystemVerilog TLM 通信以事务对象为单位,用 port 发起、export 透传、imp 实现的连接链把 initiator 与 target 彻底解耦:put/get/peek 定流向、blocking/nonblocking 定等待行为,analysis_port 负责一对多广播,tlm_fifo 在节奏不一致时提供缓冲——monitor 到 scoreboard 的接线就是这四种元件的标准组合。