数据通路算子实现:综合器对加法、乘法、比较器的选型机制与手动干预
更新时间:2026-10-04。写 RTL 时一个
a + b只是三十来个字符,但综合之后它可能是 32 个全加器串成的一条慢链,也可能是一棵五级的并行前缀树——同样的代码,门级实现差出三倍延迟、两倍面积。这背后就是数据通路算子实现(datapath operator implementation selection):综合器为每个算术算子从实现库(Synopsys 叫 DesignWare,Genus 叫 ChipWare,开源 yosys 则是内建的 techmap 规则)里挑一个具体结构的过程。本篇是 eda/ 目录综合线的深入篇,承接 逻辑综合与 Design Compiler 的整体框架和 综合约束 SDC 的约束写法,聚焦一个问题:加法、乘法、比较这些算子,工具到底怎么选、什么时候选错、错了怎么干预。读之前建议先过一眼 线载模型 WLM,因为算子选型用的延迟估算就建立在它上面。
本文要回答的问题
- 一个 32 位加法在实现库里通常有哪几种候选结构,它们的延迟-面积 trade-off 长什么样?
- 综合器按什么机制在候选里挑一个——约束松紧如何直接改变选型结果?
- 乘法器的 Booth 编码和 Wallace/Dadda 压缩树分别解决什么问题,为什么先进工艺下选型结论和老教科书不一样?
- 比较器、加减混合、乘加(MAC)这类算子有没有特殊的合并优化机会?
- 什么时候必须手动干预(指定实现、例化 DesignWare、set_implementation),干预的代价是什么?
一、一个加号背后的候选池
以 32 位加法为例,主流实现库里至少躺着四类候选。
第一类,行波进位加法器(ripple-carry adder,RCA):32 个全加器首尾串联,进位像波浪一样从最低位传到最高位。结构最省面积(32 个全加器加几条线),但关键路径是 32 级进位链,延迟随位宽线性增长。16 位以下、约束宽松时它是常客。
第二类,超前进位加法器(carry-lookahead adder,CLA):不逐位等进位,而是用 generate/propagate 信号把进位逻辑展开成多输入的并行逻辑,通常按 4 位一组、两级先行。延迟降到对数级,代价是面积增大 1.5-2 倍,且中间节点扇出大。
第三类,并行前缀加法器(parallel prefix adder):把进位计算抽象成前缀运算,用树状结构在 log2(N) 级内算出所有进位。家族里有三个常见变体——Kogge-Stone(速度最快、面积和布线最费)、Brent-Kung(面积最省、多一级逻辑)、Sklansky(级数最少但扇出爆炸)。先进工艺下这是高性能加法器的主力。
第四类,进位选择/进位跳过加法器(carry-select / carry-skip):把位宽切段,每段同时算「进位为 0」和「进位为 1」两份结果,上一段进位到了用 MUX 选一份。用复制硬件换时间,介于 RCA 和前缀树之间。
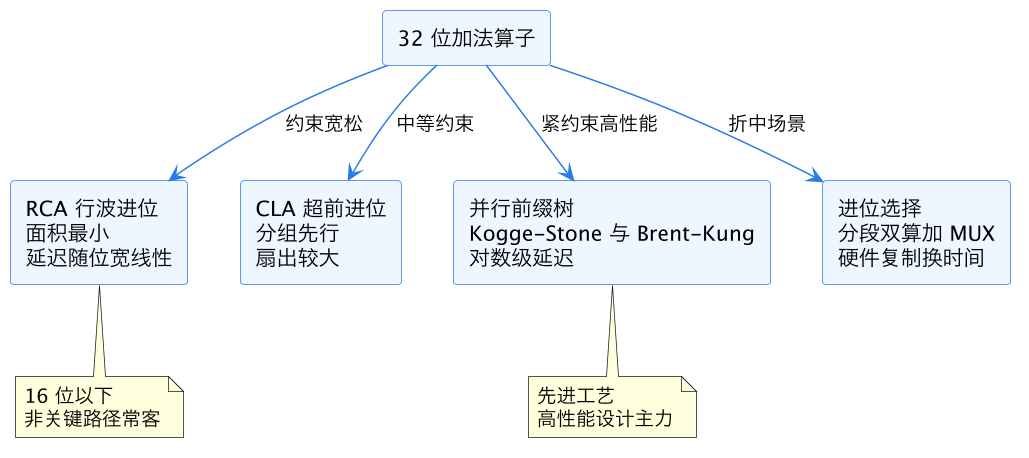
这张图是选型问题的全貌:同一个算子,候选池里的结构在「延迟-面积-布线压力」三个维度上各据一角,不存在全面最优。综合器的工作就是按约束从这四个角里挑一个「刚好够用、不多花」的点。注意图中选型箭头上的标签——约束松紧是唯一的裁判,这就是下一节的主题。
| 结构 | 关键路径量级(32 位) | 相对面积 | 布线压力 | 典型归宿 |
|---|---|---|---|---|
| RCA 行波 | 约 32 级进位 | 1.0x | 低 | 宽但慢的非关键路径 |
| CLA 超前 | 约 8-10 级 | 1.5-2.0x | 中(大扇出) | 中等时钟频率 |
| Kogge-Stone | 约 5 级前缀 + 末级 | 2.5-3.0x | 高(长线多) | 高频关键路径 |
| Brent-Kung | 约 9 级前缀 | 1.8-2.2x | 低 | 面积敏感的高频 |
| 进位选择 | 约 段数 + 段内 | 2.0-2.5x | 中 | 迟到达输入场景 |
二、选型机制:约束是唯一裁判
综合器选型的本质是一次受约束优化。流程大致是:算子在综合早期以「合成组件」(synthetic operator,比如 ADD_TC_OP 这样的抽象节点)形式存在于网表中,到了 datapath 优化阶段,工具为每个算子评估候选实现——用 线载模型 WLM 估延迟,用库单元面积估成本,然后看该算子所在路径的时序裕量(slack)。裕量充足(比如路径 slack 还有 2ns,周期总共 5ns),工具选最省面积的 RCA 类实现;裕量紧张甚至为负,一级一级往更快的实现换,直到 slack 转正或者换到最快的实现为止。
这带来几个直接推论。推论一:同一个 RTL 模块,跑 200MHz 和跑 2GHz,综合出的加法器结构完全不同——代码不能告诉你答案,约束才能。推论二:选型的延迟估算基于 WLM,布局布线后真实线延迟往往更差,所以综合期「刚好够用」的选型到后端可能不够——这是为什么 综合交接数据流 S2 强调要给后端留时序裕量,也是物理感知综合(DCG / Genus physical)兴起的原因:有了粗略布局信息后,算子选型才能把线延迟算准。推论三:虚假的紧约束有害。有些人习惯把时钟约束写紧 20%「留余量」,结果是全芯片的算子被过度选型——前缀树遍地开花,面积和动态功耗白白多花 15% 以上,布线拥塞反而让真实时序更差。余量该留,但要留在明确的地方(比如 OCV 与 AOCV 那套降额体系里),不要藏在虚假频率里。
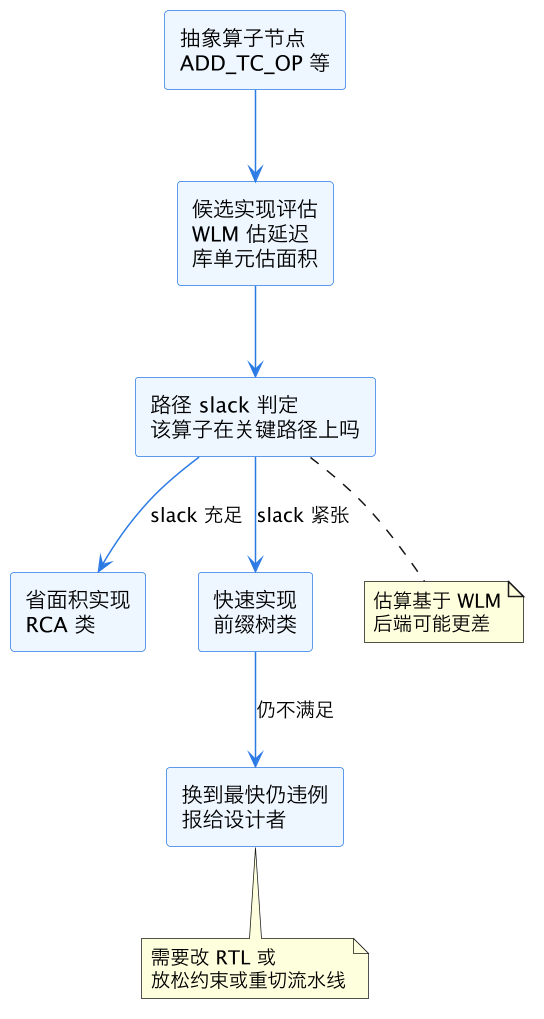
这张图是综合器内部的选型决策链。读图的关键在中间那个 slack 判定:选型不是全局最优搜索,而是逐算子、按路径局部决策的贪心过程——先让所有算子用最省实现,再从最差路径开始逐个升级。这意味着关键路径上的算子会拿到最好的结构,而它的邻居可能仍是行波链,两者只差一级寄存器的距离。
三、乘法器:Booth 与压缩树的二人转
乘法比加法复杂一个数量级:N×N 位乘法先产生 N 个部分积(被乘数与乘数每一位相与),再把 N 个部分积压成一个和。实现选型围绕这两步展开。
部分积生成侧,Booth 编码(基 4 Booth)是标配:把乘数每三位一组重编码,部分积数量从 N 个直接减半到 N/2+1 个,每个部分积是 0、±1 倍、±2 倍被乘数(±2 倍只是移位,不要钱)。32 位乘法的部分积从 32 个降到 17 个,压缩树的规模和深度近乎减半。Booth 编码本身的逻辑(选择器和取反加一)会引入一点额外延迟,但远小于它省下的压缩级数——所以商用实现库里乘法器几乎清一色带 Booth。
部分积压缩侧,两大流派:Wallace 树用全加器当 3:2 压缩器,每级把部分积数量压到 2/3,级数约 log_{1.5}(N);Dadda 树同样用 3:2 压缩,但每级只压到「下一级所需的最少行数」,用的压缩器更少、面积略省,级数一样。现代实现库普遍采用 Dadda 式调度的 (4:2) 压缩器树——两个全加器打包成一个 4:2 单元,进位在树内横向传播不串级,规则性更好、布线更友好。压缩到两行后,末级再用一个快速加法器(通常就是并行前缀树)完成最终相加。
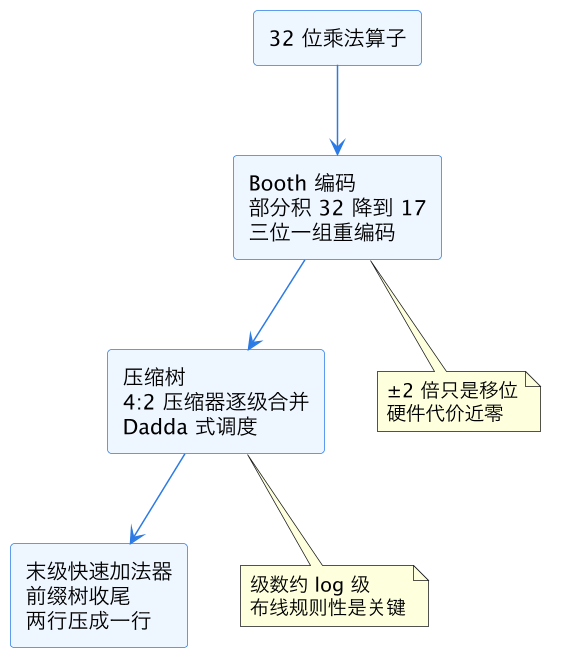
这张图是高性能乘法器的标准三段式。要补充一个和教科书不同的观察:老书强调 Wallace 比 Dadda 快,但在标准单元实现里,决定速度的往往不是压缩器级数而是布线的规则性和拥塞——4:2 Dadda 树连线更规则,先进工艺下互连延迟占比高,实际版图后结果常常反超。这就是「综合选型结论随工艺漂移」的典型例子:选型不是背结论,要信工具在你这个 PDK 上的评估。
面积/速度档位的选择同样由约束驱动:约束松时,工具会选阵列乘法器(array multiplier,部分积逐行 ripple 相加,面积最小、延迟 O(N));约束越紧,越往 Booth + 压缩树 + 更宽的末级前缀加法器走。还有一种常被忽略的折中:流水线化乘法器(pipelined multiplier),算子内部插 1-2 级寄存器,用 latency 换频率——工具只在 RTL 允许重定时(见 综合重定时)或显式例化流水线 DesignWare 时才会用。
四、比较器与算子合并
比较器(>、== 等)本质是减法的进位输出:a > b 等价于 a - b 不产生借位。所以比较器的候选池和加法器共享——快加法器的进位网络直接给出比较结果,选型逻辑也一致。一个小优化:等值比较(==)不需要进位链,N 个 XNOR 加一棵 AND 归约树就够,延迟天然是 log 级,任何实现库都会走这条捷径,不用操心。
真正的重头戏在算子合并(operator merging / resource sharing 的 datapath 版)。三个高频机会:
乘加融合:a * b + c 如果拆成乘法器和加法器两个算子,c 要等压缩树和末级加法器全走完才参与;融合成 MAC(multiply-accumulate)后,c 作为第 18 个部分积直接塞进压缩树,几乎零代价省掉整个末级加法器的延迟。主流综合器自动做这个融合,前提是你的写法是单个表达式而非中间信号打断。
加减合并:a + b - c 可以共用一套加法硬件(把减 c 变成加 c 的补码,融进同一棵树),省一个加法器。
多路复用下共享:if-else 两个分支各有一个加法器且不会同时活跃时,资源复用(resource sharing)阶段可以把它们合并成一个加法器加输入 MUX——但注意这是面积换延迟(MUX 进了关键路径),综合器只在面积优先或分支互斥关系明确时才做。不想让工具共享时(比如两条都是关键路径),要关掉对应约束选项,don't_use 与 don't_touch 流程 讲的控制手段在这里同样适用。
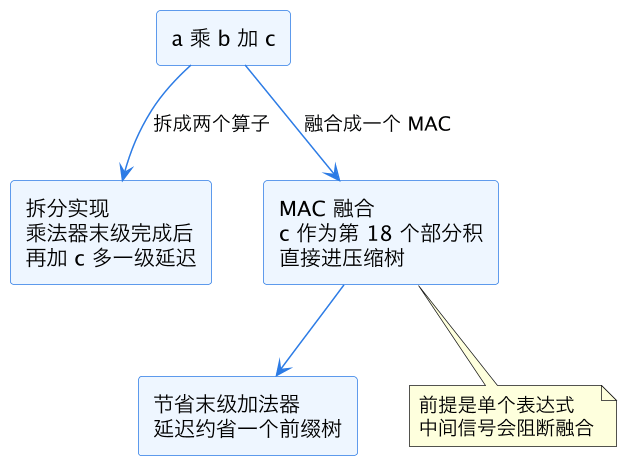
这张图对比了乘加的两种实现路径。实战建议:乘加一定写成一个表达式 assign y = a * b + c;,不要拆成 wire p = a * b; assign y = p + c;——后者中综合器虽常能救回来,但跨模块边界、带中间 don't_touch 层次时就彻底没戏。
五、手动干预:什么时候、用什么手段
自动选型覆盖了 95% 的场景,剩下 5% 必须人来。典型触发场景有四个。
场景一:工具被 WLM 骗了。综合期估算说某路径 slack 充足选了 RCA,布局后真实线延迟翻倍,该路径成了最差路径。手段:对该算子 set_implementation(DC)或等价命令强制指定快速实现,或者更治本——换物理感知综合流程重跑。
场景二:已知结构的最优解工具库里没有。比如你的设计需要一个特殊位宽的饱和加法器,或者要复用硬宏(DSP slice 式的乘加硬核)。手段:RTL 里直接结构例化,并用 don't_touch 保护(参考 don't_use 与 don't_touch),综合只过路不动它。
场景三:跨层级的算子被层次边界切碎。a*b 在模块 X,+c 在模块 Y,MAC 融合没戏。手段:flatten 相关层次,或者改 RTL 把算子挪进同一模块,或者用 DC 的 boundary optimization。
场景四:等效验证翻车后的回滚。强制实现改变了网表结构,形式验证 LEC 的映射点变少、比对变慢甚至不收敛。手段:干预要逐算子进行、每步跑 LEC(翻车了按 LEC 不等价调试 的方法定位),不要一口气给全设计下几十个 set_implementation。
手动干预的通用代价要清楚:指定实现是「冻结决策」,工艺换了、约束变了,这条命令不会自动跟着调整——它从「工具帮你选」变成「你替工具负责」。所以干预命令必须和设计一起进版本管理、写清注释(为什么干预、当时的目标频率),在 综合 QoR 报告 里复核它仍然合理。
| 干预手段 | 作用粒度 | 副作用 | 适用场景 |
|---|---|---|---|
| set_implementation | 单算子 | 冻结选型,换工艺需复查 | WLM 估算失误 |
| 结构例化 + don't_touch | 模块级 | 失去综合优化空间 | 硬宏、特殊算子 |
| flatten / 边界优化 | 层级级 | 破坏层次、运行时间上升 | 跨层级算子融合 |
| 改 RTL 写法 | 代码级 | 无(最推荐) | MAC 融合、资源共享 |
这一篇在知识体系里的位置
本篇是 eda/ 综合线的中段深入文:上承 逻辑综合与 Design Compiler 的整体流程与 综合约束 SDC 的约束体系,与 线载模型 WLM(选型延迟估算的地基)、综合重定时(流水线化乘法器的前置手段)、don't_use 与 don't_touch(干预的控制原语)同层互补;下游接 综合交接数据流 S2(选型结果随网表交给后端)与 形式验证 LEC(干预后的等价性兜底)。看完这篇,你在 QoR 报告里看到 DW02_mult 后面挂的实现后缀时,能说出它为什么是这个、该不该换、怎么换。
总结
数据通路算子实现是综合器把 RTL 算术表达式落到具体硬件结构的受约束优化过程:加法器在 RCA、CLA、并行前缀树(Kogge-Stone/Brent-Kung)之间按路径 slack 贪心升级,乘法器走 Booth 编码减半部分积、4:2 Dadda 压缩树合并、末级前缀加法器收尾的标准三段式,比较器复用加法进位网络而等值比较走 XNOR 归约捷径,乘加融合和加减合并能再省一整级延迟——选型的唯一裁判是约束松紧(估算地基是 WLM,后端可能翻盘),虚假紧约束会导致全芯片过度选型多花 15% 面积功耗;95% 交给工具,剩下 5%(WLM 误判、硬宏复用、层次切碎、LEC 兜底)用 set_implementation、结构例化、flatten 逐级手动干预,且每条干预命令都要进版本管理写清来由,因为它冻结的是本该随工艺和约束自动漂移的决策。