FPGA 入门 12:module 与端口——Verilog 的"方框"
更新时间:2026-09-12。本文是
fpga/入门层第 14 篇。组合/时序范式见 组合与时序逻辑,数据类型见 数据类型与运算,IP 复用思想见进阶 RTL 复用与参数化。
本文要回答的问题
- Verilog 的
module在硬件上到底对应什么?为什么说例化不是「函数调用」? input/output/inout三种端口在模块内外分别能做什么、不能做什么?- ANSI 风格和老式端口声明差在哪,为什么推荐前者?
- 怎样在一个模块里例化另一个模块?按位置连接和按名字连接哪种更安全?
parameter/localparam怎么让一份代码变成多种电路?参数在综合时意味着什么?- 多文件工程怎么组织、顶层模块只做什么、综合工具怎么找到子模块?
- 悬空输入、多驱动、位宽不匹配会综合成什么、为什么是隐患?
读完本文,你应该能把一个稍大的设计(例如计数器 + 分频 + LED/数码管驱动)拆成几个各司其职的 module,用按名连接把它们在顶层「画」成一张框图,并通过 parameter 让同一个模块复用于不同位宽/分频比。
一、module = 原理图方框
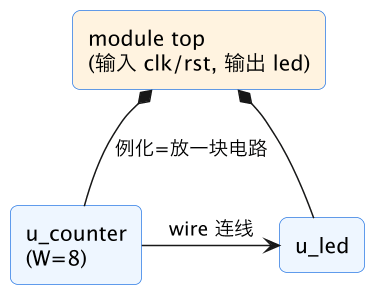
二、端口与例化规则
| 端口 | 内部 | 外部 |
|---|---|---|
| input | 只读 | 必须驱动 |
| output | 被 assign/always 驱动 | 只读,可悬空 |
| inout | assign sda=oe?v:1'bz | 三态总线 |
例化(按名连接):
counter #(.W(8)) u_counter (
    .clk(clk), .rst(rst), .q(cnt)   // .子端口(本地连线)
);- 例化一次 = 一块真实电路,多次 = 多块并行;
- 位宽匹配;输入不可悬空;
- 参数化:
#(parameter W=4)+ 例化时#(.W(16)),一份代码多种规格。
三、多文件工程
- 顶层 top:只做例化和连线(像画总图);
- 子模块各自一个 .v 文件;
- 综合时把全部 .v 加进工程,工具自动找模块定义;
- 工程 top 设为顶层实体。
四、端口方向背后的硬件语义
input/output/inout 不是给编译器看的形式标注,而是在描述「这根线由谁驱动」。数字电路里一条导线同一时刻只能有一个确定的驱动源(高阻态除外),端口规则正是为了保证这一点。
- input:驱动源在模块外部,模块内部只能读。它通常连到父模块的某根 wire(或顶层的管脚)。在内部对 input 赋值 = 试图从线的另一头反向驱动,会报多驱动错误。
- output:由模块内部驱动:纯组合输出用
assign y = ...;(output 为 wire 型)或在always里赋值(output 声明为 reg)。外部只能读、不能再驱动。output 可以悬空不接(比如某个状态位本设计没用),但不能有两个源同时接它。 - inout(双向):用于真正的三态总线,如 I2C 的 SDA、外部并口总线。内部必须有一个输出使能 oe:
assign sda = oe ? out_val : 1'bz;——oe 有效时驱动 out_val,无效时把自己置成高阻 z,把线让给别人。FPGA 内部逻辑几乎不用 inout(内部总线用 mux 选源更稳),它主要出现在管脚级的开漏/总线协议上。
还有几个和端口相关、容易忽略的硬件事实:①未连接的 input 不是 0,综合后可能由保持器(keeper)或上拉决定,电平随机,仿真里是高阻 z,所以「输入必须有驱动」;②输出无负载(no load)只告警不报错,但常意味着你接错了线或信号被优化掉;③端口位宽是模块边界契约,8 位 output 接到 4 位 wire 会发生截断(见 数据类型与位宽),要显式对齐。
wire 型端口与 reg 型端口怎么定
判断方法只看「在模块内部怎么给它赋值」:
- 输出由
assign连续赋值或直接把某根内部 wire 引出来 → 端口声明成output wire(ANSI 里可省略 wire,默认就是 wire); - 输出在
always过程块里被赋值 → 必须声明成output reg(或 SystemVerilog 的output logic)。
这与「reg 不一定是寄存器」是同一回事:在组合 always 里赋值的 output reg,综合出来仍是 LUT(见 数据类型 与 always 与 case)。input 端口永远是 wire(你只能读外部驱动进来的线)。
五、例化:把方框摆到图纸上
例化(instantiate)的硬件含义是放置一块电路并连线:例化一次放一块,例化 N 次就真的有 N 块相互独立、并行工作的电路,不是软件里「调用一次函数、执行一段代码、返回后复用同一块逻辑」。同一段 RTL,例化 4 次乘法器,资源报表里就是 4 份乘法器资源。
按名连接(推荐)与按位置连接
// 推荐:.子模块端口(父模块信号),与书写顺序无关,增删端口不易错位
counter #(.W(8)) u_counter (
    .clk   (clk),
    .rst_n (rst_n),
    .q     (cnt)
);

// 不推荐:按位置连接,顺序必须与子模块端口列表严格一致,改端口顺序就悄悄错位
counter u_counter2 (clk, rst_n, cnt);
按名连接的额外好处是:子模块某个端口本设计不用,可以显式悬空 .unused_port(),意图清晰;阅读时也不必来回翻子模块定义去数第几个参数对应谁。
层次、命名与可见性
- 例化时的
u_counter叫实例名(instance name),综合/仿真/调试路径里用top|u_counter|q这样的层次路径引用它;同一个子模块例化多份时,实例名必须各不相同。 - 父模块只能通过端口与子模块交互,看不到也不能直接改子模块内部 reg/wire(信息隐藏)。需要观察内部信号,调试时用层次路径(仿真)或 ILA/SignalTap(上板,见 ILA 初用)。
- 子模块的输出端口不要被父模块里别的逻辑再驱动;需要「多个来源选一个」时,在父模块用组合 mux 合成一根 wire 后再接入,而不是多个驱动并接。
- 端口位宽可以用参数表达,如子模块
output [W-1:0] q、例化传.W(8),父模块用 8 位 wire 接它,两边天然一致。
生成(generate):批量例化
当要例化「参数化的多份」时用 generate-for(本质仍是复制出多块硬件),例如把 4 个 1 位同步器拼成 4 位:
genvar i;
generate for (i=0;i<4;i=i+1) begin: g_sync
    sync1bit u_sync (.clk(clk), .d(async_in[i]), .q(sync_out[i]));
end endgenerate
它不是「循环执行」,而是展开成 4 个并列实例 g_sync[0].u_sync … g_sync[3].u_sync。跨时钟域同步见进阶 CDC 与亚稳态。
六、parameter:一份代码,多种电路
参数让模块成为「可配置的电路模板」。综合时参数必须是常量,工具按例化传入的值真的生成对应规模的电路:传 .W(16) 就有 16 个触发器,传 .W(4) 就只有 4 个。这与软件变量截然不同——它更像 C++ 模板/宏在「编译期定死」。
module counter #(
    parameter W = 4          // 默认 4 位
)(
    input  wire          clk, rst_n,
    output reg  [W-1:0]  q
);
    always @(posedge clk or negedge rst_n)
        if (!rst_n) q <= {W{1'b0}};   // 用参数拼出 W 位复位值
        else        q <= q + 1'b1;
endmodule- 例化覆盖默认值:
counter #(.W(16)) u16 (...);不写#(...)则用默认 4。 localparam是模块内部常量,外部不能改,适合状态编码、由 parameter 推导出的内部值,如localparam AW = $clog2(DEPTH);。两者配合是写可复用 IP 的基本功(系统方法见进阶 RTL 复用与参数化)。- 参数还能做条件生成:
generate if (USE_PIPELINE) begin ... end else begin ... end endgenerate,同一份 IP 按参数长出不同结构。 - 参数化的边界:位宽、深度、分频比、是否包含某可选功能可以参数化;不要把「只有在某些时刻才决定」的运行时值当参数——那是输入信号,不是配置常量。
参数化分频计数器的完整两文件例子
把 计数器与分频 的思想与模块拆分结合,能同时练到例化、parameter、按名连接、时钟使能:
// tick_gen.v:每 DIV 个 clk 产生 1 拍 tick(时钟使能,不是造时钟)
module tick_gen #(parameter DIV = 50000)(
    input  wire clk, rst_n,
    output reg  tick
);
    localparam CW = 16;                 // DIV<=65536 时 16 位足够
    reg [CW-1:0] c;
    always @(posedge clk or negedge rst_n)
        if (!rst_n) begin c <= 0; tick <= 1'b0; end
        else begin
            tick <= (c == DIV-1);
            c    <= (c == DIV-1) ? 0 : c + 1'b1;
        end
endmodule

// top.v:只做例化与连线;LED 在 tick 有效拍翻转
module top(input wire clk, rst_n, output reg led);
    wire tick;
    tick_gen #(.DIV(50000)) u_tick (.clk(clk), .rst_n(rst_n), .tick(tick));
    always @(posedge clk or negedge rst_n)
        if (!rst_n) led <= 1'b0;
        else if (tick) led <= ~led;
endmodule
注意顶层 top 几乎没有「算法」,只负责把 u_tick 的 tick 接到 LED 逻辑——这就是分层设计中顶层的角色:画总图。要换频率,只改例化的 DIV,不用动 tick_gen 内部;要在别的工程复用,直接拷走 tick_gen.v。
七、多文件工程怎么组织
当设计不止一个模块时,按「一个模块一个文件、文件名与模块名一致」来组织最省心:
- 顶层(如
top.v)只放例化和连线,尽量不放复杂算法;子模块tick_gen.v、debounce.v、seg_disp.v、uart_tx.v各自独立。 - 综合时把所有源文件都加进工程(Vivado Add Sources / Quartus Add Files),工具自动按模块名查找定义;少加一个文件会报
module not found,重复定义同名模块会报 conflicting。 - 在工程设置里指定顶层实体(Vivado 自动识别 top、Quartus 在 Settings 里设 Top-level entity)。
- testbench 单独放 sim 集,只用于仿真,不参与综合(写法见 Testbench 与仿真)。
- 复用别人的模块/IP 时,把它当作「带文档的方框」:先看它的端口表和 parameter 列表,不必读内部实现即可例化;这与你调用一个 IP 核是同一回事(见 IP 核怎么调)。
分层的直接收益:子模块可以先在 testbench 里单独验证(输入可控、波形简单),再进顶层集成;顶层出问题时按层次路径快速定位到具体子模块。这是 FPGA 工程从「一个文件写到底」走向可维护设计的第一步。
ANSI 风格 vs Verilog-1995 旧式声明
// ANSI(Verilog-2001,推荐):端口列表里一次写清方向、类型、位宽
module m #(parameter W=8)(
    input  wire          clk,
    input  wire [W-1:0]  d,
    output reg  [W-1:0]  q
);

// 旧式(1995,仅在老代码里见到):先列端口名,再重复声明方向/类型
module m(clk, d, q);
    input clk; input [7:0] d; output [7:0] q; reg [7:0] q;
旧式要把端口名写两遍、位宽改一处忘另一处就错;新代码一律用 ANSI。读老工程时能认出旧式即可,不要新写。
八、自测要点与学习地图
自测:① 说明为什么「例化一次 = 一块电路、例化两次 = 两块并行电路」,这和软件函数调用差在哪;② 给一个三端口子模块,分别写出按名连接和按位置连接,并指出后者增删端口的风险;③ 说出 input/output/inout 在模块内外各自能不能赋值、inout 为什么要写高阻;④ 判断一个输出该声明成 wire 还是 reg;⑤ 用 parameter 写一个可配置位宽的计数器并例化成 12 位;⑥ 解释参数和普通输入信号在综合时间点上的区别;⑦ 列出多文件工程必须满足的条件(文件齐全、top 正确、无重复/悬空输入)。
学习地图:紧接着掌握数据怎么在端口间流动——数据类型与位宽、always 与 case、阻塞与非阻塞;动手综合看 LUT 与 FF;复用能力进阶看 RTL 复用与参数化 与 工程版本与 IP 管理;跨时钟边界的模块接口处理看进阶 CDC 与亚稳态。
九、把三态端口写对:I2C SDA 的例子
inout 是新手最容易写错的端口,因为它要求你同时管理「我要不要驱动这根线」。下面是一个可综合的三态端口骨架,体现「读」和「写」必须分开:
module i2c_port(
    input  wire sda_oe,      // 输出使能:1=本模块驱动, 0=释放给别人
    input  wire sda_drv,     // 使能时要输出的值
    output wire sda_in,      // 把线当前电平读回来
    inout  wire sda          // 真正接到管脚的双向线
);
    assign sda    = sda_oe ? sda_drv : 1'bz;  // 不使能 -> 高阻
    assign sda_in = sda;                       // 任何时候都能读回线电平
endmodule关键点:①使能无效时必须输出 z(高阻),而不是输出 0——I2C 是开漏线与,任何一方强行拉低都会和别人冲突;②读回的值要通过单独的 sda_in 端口或内部 wire 取,不能直接把 inout 当 reg 用;③在 FPGA 内部不要这样做三态(内部总线靠 mux),只有管脚级总线、外部 SRAM 数据总线、开漏协议才用 inout;④约束时 inout 同样要给 PACKAGE_PIN 与 IOSTANDARD。理解了「一个驱动 + 高退让线」,你就理解了所有共享总线协议的电气基础。
十、一个更真实的分层例子:UART 回环
UART 回环实验非常适合用来体会「模块即方框」。一个典型 UART 顶层会被拆成:
top (只画总图)
 ├─ u_reset_sync  : 异步复位同步释放
 ├─ u_tick        : 由时钟分频产生波特率采样 tick(时钟使能)
 ├─ u_rx          : 串行 in -> 并行 data + valid(状态机+采样)
 ├─ u_loop_fifo   : data/valid 写入、读出(可选 FIFO 缓冲)
└─ u_tx : 并行 data/ready -> 串行 out(状态机+并转串)- 每个子模块只通过几根线与外界相连(clk/rst_n 几乎人人都有,业务端口很少),可以分别写 testbench 验证;
- 顶层做的事就是声明一堆 wire,然后五次按名例化、把
rx 的 data/valid接到 FIFO、再把 FIFO 输出接到 tx; - 想换波特率,只改
u_tick的参数;想把回环改成「收到后加 1 再发」,只在 rx 与 FIFO 之间插一个小模块,其他方框不动。
这就是层次化设计对抗复杂度的方式:每一层只关心有限的几个端口,复杂系统 = 许多简单方框的连接图。状态机方框怎么写见 状态机入门,跨模块的异步数据交接见进阶 FIFO 设计。
elaboration 阶段最常见的连接错误
综合开始前的「elaboration(展开例化层次)」会专门检查端口契约,常见报错与原因:
| 报错关键词 | 含义 | 修法 |
|---|---|---|
module ... not found / unknown module | 子模块文件没加进工程或名字拼错 | 加文件、核对模块名/文件名 |
port ... not connected | input 端口悬空(多为警告,但危险) | 接上驱动或显式接常量 |
cannot find port / not a port | 按名连接写了子模块不存在的端口 | 核对 .name 与子模块端口表 |
port width mismatch | 端口与连线位宽不一致 | 统一位宽,或显式截位/补位 |
multiple drivers / multi-driven | 同一信号被两个源驱动 | 合并成一个 mux 或删重复驱动 |
duplicate instance name | 同层实例名重名 | 起不同实例名 |
养成习惯:elaboration 的警告也要逐条看,尤其是未连接输入和位宽不匹配——它们常常能编译过、能下板,但行为就是不对。
十一、从资源与仿真两个视角理解层次
资源视角:综合器展开整棵例化树,把每个模块映射成具体硬件。例化一个参数化计数器,报表里就多出 W 个 FF 和一小段进位 LUT;例化一个厂商乘法 IP,就占用一块 DSP;例化一个双口 RAM,就推断/例化一块 BRAM。因此「这个模块例化几份、参数多大」直接决定芯片占用——同一个 FIFO,深度 16 和深度 4096 是天壤之别。看资源报表时按层次(hierarchical)展开,能定位是哪个子模块吃资源最多,这是 资源利用率怎么读 的基础。也正因如此,写 RTL 时要对「这行会变成多少电路」有数:一个 for 循环若变量范围是常量,会展开成 N 份并行电路;若范围是运行时变量则往往不可综合。
仿真视角:testbench 里通常只例化「待测模块(DUT)」一个实例,给它的 input 加激励、观察 output:
counter #(.W(8)) dut (.clk(clk), .rst_n(rst_n), .q(q));层次路径 dut.q、dut.u_sub.sig 让你在波形里直接看到子模块内部。多输出对照期望时,好的端口划分让你能在 testbench 里只驱动少量信号、只断言少量输出;如果发现一个模块要在 testbench 里强行改它的内部 reg 才能测,基本说明端口/层次没划好。子模块独立可测,是判断模块边界是否合理的实用标准。
十二、设计模块边界的几条原则
模块划分没有唯一答案,但下面这些经验法则能让大部分入门设计更清晰:
- 一个模块一个明确职责:消抖、边沿检测、波特率生成、接收、发送各是各的模块;一个 always 块也尽量只描述一类行为(组合或时序)。
- 时钟与复位优先统一:同一层次的模块尽量共用
clk、rst_n,需要不同频率用时钟使能或 PLL 派生(见 计数器与分频、时钟与复位)。接口跨时钟域要显式做同步,别让一个模块内部偷偷混时钟。 - 端口尽量少而稳:如果一个模块有几十个 input,往往是把本该内部解决的细节暴露了;用结构体(SystemVerilog interface/struct)或打包成 valid/ready、data 这样的标准握手更清晰。
- 方向与极性一致:复位全设计统一高/低有效(建议低有效
rst_n),valid/ready、片选等信号命名体现极性,避免有的模块叫rst有的叫rst_n接反。 - 参数放在模块头、常量放 localparam:外部可能改的(位宽、深度、分频)用 parameter,内部编码用 localparam,不要把状态码暴露到端口。
- 组合输出与时序输出想清楚:纯组合模块(译码、mux)输出随输入变;带状态的模块输出最好寄存一拍再出端口,无毛刺、利于时序(见 状态机入门)。
- 面向复用写:把与具体板子有关的东西(分频常数、管脚)放在顶层或参数里,让子模块与板级无关,换板子时只动顶层和约束。
初学者关于 module 的几个典型误解
- 误解一:「例化多次会像递归/重入那样复用同一段逻辑」——不会,硬件是按实例复制的,资源也成倍增加。
- 误解二:「在多个 always 里给同一个 reg 赋值能实现『多个条件都能改它』」——这是多驱动,非法;想要多源选择,用一个 always + if/case 或组合 mux 汇聚后单驱动。
- 误解三:「output 不接没关系,随便留空也行」——输出可以不接,但输入不能悬空;顶层未用的 input 管脚要在 RTL/约束里妥善处理。
- 误解四:「parameter 能像函数参数那样传运行时变化的值」——parameter 在综合时定死,运行时可变的是数据输入端口。
- 误解五:「文件加进去就行,顶层无所谓」——工具需要知道哪个是顶层实体来确定管脚与最终层次;top 设错会综合出完全不同的结果或报一堆管脚未约束。
- 误解六:「子模块内部寄存器没复位也没关系,父模块复位了它就会清零」——复位只对明确写了复位的 FF 生效,子模块寄存器要么自己接 rst_n 复位,要么保证复位期间不被使用。
把这几点和前面的端口规则、参数化、分层验证结合起来,你写出的就不再是「能跑的一段代码」,而是可复用、可独立验证、资源可预期的电路模块——这正是从「会写 Verilog 语法」走向「会做 FPGA 设计」的关键一步。
一个对照练习:用三种方式描述同一组功能
为了固化「模块是电路」的直觉,可以拿同一需求做对照:用一个大 always 块写、用两个 always 块写、用两个独立 module 在顶层例化写。综合后你会看到:三种写法只要行为等价,资源基本一致,但第三种最容易单独仿真、复用和替换。再进一步,把其中一个模块参数化(位宽、采样 tick 分频比做成 parameter),同一份代码在不同工程里长出不同规模的电路——这时你就真正掌握了 module/port/parameter 这套抽象的价值。配合 always 与 case 的两种 always、阻塞与非阻塞 的赋值纪律,Verilog 入门最难的「软件思维转硬件思维」这一关就算过了。
最后再把本文的硬件主线收一遍:你在屏幕上看到的是 module、端口、例化这些文本,但综合器看到的是一张由方框(模块实例)和连线(wire)组成的电路图。input 是别人驱动、你只能读的线,output 是你驱动、别人读的线,inout 是靠高阻分时共享的总线;例化是往图上摆方框,parameter 是摆方框时选定的规格,顶层 module 是把所有方框连起来的总图。写每一行时都问自己一句「这对应图上的哪个方框、哪根线、由谁驱动」,悬空输入、多驱动、位宽截断、拿参数当变量这些典型错误就会大幅减少。等这套「看着代码脑子里自动出电路图」的习惯形成,再去看 UART、FIFO、状态机、甚至 AXI 总线这些更复杂的设计,本质都只是更多方框和连线的有序组合而已。学习时建议边读边动手:找一个现成工程,打开综合后的 schematic/层次视图,把屏幕上的每个方框与 RTL 里的每个 module、每个实例名一一对应起来;再试着把其中一个模块改成不同参数重新综合,观察资源报表里 FF/LUT 数字的变化。这种「代码—方框—资源」三位一体的对应练上两三次,比单纯背语法规则牢固得多,也为后面学状态机、FIFO、流水线打下最关键的直觉基础。
十三、端口连接的三种写法与隐式端口风险
例化一个子模块时,Verilog/SystemVerilog 提供了三种把外部信号接到模块端口上的写法,新手应尽早理解它们的差别,因为同一个例化语句,换种写法在端口增删时的行为会完全不同。第一种是按位置连接:严格按照模块定义里端口声明的先后顺序,一个不落地列出外部信号。它最短,也最脆弱——只要子模块作者调整了端口顺序、或在中间插入了一个新端口,所有按位置例化的地方都会静默错位,编译器可能因为位宽或方向侥幸不报错,仿真却得到莫名其妙的结果。任何稍微正式的工程都不建议依赖这种写法。
第二种是按命名连接,用 .端口名(外部信号) 的形式逐条显式对应。端口顺序可以任意排列,少接一个端口就让它悬空(input 悬空会给警告、output 悬空等于不接),可读性和可维护性都好得多,是 RTL 工程的主流写法。它的价值在代码评审时尤其明显:不用跳到子模块去数顺序,一眼就能看出谁连了谁。第三种是 SystemVerilog 的隐式连接,包括 .端口名(让端口自动连接同名的外部线网)和 .*(一次性把所有同名、同位宽、同方向的端口全部自动连上)。它们能显著减少样板代码,在端口和连线命名严格统一的大工程里很方便,但也把"显式"这个安全阀让渡了出去:一条 .* 会让你很难在例化处看清到底连了哪些信号,同名但含义不同的线还可能误接。入门阶段的稳妥建议是:读代码时要能看懂这三种写法,但自己写新代码一律用按命名连接,等对命名规范和层次结构有把握后,再在团队约定的范围内谨慎使用 .*。
十四、把模块边界画进框图:评审时怎么看端口
模块划分得好不好,最直观的检验方式不是看代码行数,而是看它的端口表。一个边界清晰的模块,端口数量适中、方向一目了然、时钟和复位这样的全局信号单独成组,数据通路信号用 valid/ready 或 valid/stb 这样的约定成对出现,参数通过 parameter 在例化时配置,内部状态完全不暴露给外面。评审一个模块时,有经验的工程师往往先不看实现,只盯着端口列表问几个问题:这个模块需要几个时钟域?如果一个模块同时吃 clk100m 和 clk50m 却没有任何跨域说明,大概率埋了 CDC 隐患;这个 output 有没有可能不被任何上游使用,即是不是设计阶段就已经多余?输入信号是否在某些工作模式下根本不被关心,若是就该拆成两个职责更单一的模块。
还有几类"端口坏味道"值得警惕。其一是端口爆炸:一个模块动辄三四十个端口,通常意味着它承担了太多职责,应当沿数据通路和控制通路拆成若干级。其二是用一根输入信号在模块内部控制十种模式,这种"万能配置口"会让状态空间组合爆炸、验证永远覆盖不全,更好的做法是用明确的模式枚举或多个独立使能。其三是把本该内部缓存的数据用端口倒腾到外面再传回来,说明存储边界没划清。其四是双向 inout 口滥用——除了真正的三态总线,模块内部一律不要用 inout 传递普通数据。养成"先审端口、再审实现"的习惯后,你会发现很多后期难以收敛时序、难以复用、难以验证的问题,在模块边界这一步就已经注定了;反过来,一个端口表干净的模块,内部实现通常也不会差到哪里去。这也是为什么前面反复强调要在脑子里维护那张"方框加连线"的图——它不仅帮助理解电路,更是评审设计质量最快的工具。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 把例化当函数调用 | 软件思维误解硬件 | 例化=复制一块电路 |
| input 悬空 | 综合出振荡/随机 | 所有输入有驱动 |
| output 外部再驱动 | 多驱动冲突 | 一个信号一个驱动源 |
| 按位置连接端口 | 错位难查 | 用 .name(wire) 按名连接 |
| 位宽不匹配 | 截断/警告 | 例化处位宽对齐 |
| 复制模块改位宽 | 维护多份 | parameter 参数化 |
相关与延伸
语法:组合与时序逻辑、数据类型与位宽。 复用:进阶 RTL 复用与参数化、工程版本与 IP 管理。
一句话总结
Verilog 的 module 就是原理图上的方框:有名字、有 input/output/inout 端口、框内是 wire 和逻辑;例化一个 module 不是"函数调用"而是真的在芯片里放一块电路,例化两次就有两块独立并行的电路。端口规矩:input 内部只读、output 内部被驱动、inout 三态要写 assign sda = oe ? v : 1'bz;例化推荐按名连接 .port(wire) 防错位、位宽必须匹配、输入不能悬空。多文件工程里顶层 top 只负责例化和连线、子模块各一文件全部加入综合。可复用的基本功是 parameter 参数化(#(parameter W=4),例化时 #(.W(16)) 配置,综合时按常量生成对应大小电路),配合 localparam 定义内部常量——一份参数化代码胜过一堆复制粘贴。