covergroup 采样时机:构造绑定时钟事件与手动 sample() 的调度区域解析
更新时间:2026-10-01。前面 covergroup 与 coverpoint bins 讲了 bins 怎么定义,cross 覆盖率与 illegal bins 讲了交叉仓怎么配。这一篇回答一个更底层、也更常被踩的问题:covergroup 到底在什么时候把信号值读进来?采样早半拍采到的是旧值,晚半拍又可能整个漏掉,很多「覆盖率死活不涨」的根因其实不在激励,而在采样时机。
本文要回答的问题
- 构造 covergroup 时写
@(posedge clk)和手动调cg.sample()这两种方式,本质差别是什么? - SystemVerilog 的调度区域(Active/NBA/Reactive/Observed)里,采样到底发生在哪一格?
- 「采到旧值」「一拍被采两次」「事件被整个漏掉」这三种典型坑各自怎么产生、怎么修?
- UVM monitor 里手动采样时,
sample()应该放在write()的哪个位置、配合 clocking block 怎么写?
一、两种采样方式:事件驱动 vs 手动触发
SystemVerilog 给 covergroup 准备了两种采样入口,写法不同,语义完全不同:
covergroup cg_bus @(posedge clk);      // 方式一:构造时绑定时钟事件
  cp_addr : coverpoint addr;
  cp_rw   : coverpoint rw;
endgroup

covergroup cg_trans;                    // 方式二:不带事件,手动触发
  cp_kind : coverpoint tr.kind;
  cp_len  : coverpoint tr.len;
endgroup
// 某处代码里:cg_trans_inst.sample();
方式一是「事件驱动采样」:covergroup 自己挂一根敏感线,每个 posedge clk 自动采一次,不需要任何后续调用。方式二是「手动采样」:covergroup 是个哑容器,谁在什么时候调 sample(),它就采谁当前看到的值。
上图是两种路径的对照:殊途同归,最终都是「在某个调度时刻对表达式求值」。选型经验是:采样对象是同步接口上的 wire/reg 信号,用方式一绑时钟;采样对象是 transaction 对象的字段,用方式二在 monitor 里手动触发。把方式一用在 transaction 上会出现「同一个事务被连续采样 N 拍」的重复计数;把方式二用在总线信号上,则容易错过短暂的脉冲。
两者也可以叠加:构造时绑定事件,同时又允许手动 sample()。这种混用合法,但会让覆盖率的语义变得含混——同一个 bin 既被时钟驱动涨、又被手动调用涨,审阅报告时说不清每个 hit 来自哪条路径,工程上不建议。
还有一个常被忽略的点:方式一的事件表达式不只限于时钟沿。LRM 允许写任意事件表达式,比如 @(posedge valid) 这种以信号变化为触发,甚至 @(ev) 触发一个 named event。这给了漏采场景一条出路——与其绑慢时钟漏掉快信号,不如让信号变化本身当采样事件。代价是事件密度不可控:valid 毛刺一下也会触发一次采样,bin 里混进瞬态值。所以用信号边沿做触发时,coverpoint 表达式最好配合 iff 或稳定化逻辑,把毛刺挡在门外。
手动采样还有一个进阶形态:sample() 支持带实参。covergroup 里可以把 coverpoint 写成 coverpoint int'(v) with function sample(int v) 这种带参数形式(或干脆在 covergroup 声明里列出形式参数),调用 cg.sample(len) 时把值显式传进去。这样做的好处后文第五节还会展开:采样值来自调用点的快照,之后对象被怎么折腾都不影响已采的数据。
二、调度区域:采样发生在哪一格
要理解采到的是什么值,必须回到 SystemVerilog 的时分调度模型。一个时间槽里,区域大致按 Active → Inactive → NBA → Observed → Reactive 的顺序推进。RTL 的 always 块在 Active 区执行,非阻塞赋值(NBA)的右值在 Active 区求值、左值更新拖到 NBA 区,断言在 Observed 区判定,而 testbench 的 program 代码和手动 sample() 落在 Reactive 区。

这张图是全篇的枢纽。两个关键结论:
- 构造绑定时钟事件的 covergroup 在 Observed 区采样。此时本拍 NBA 更新已经完成,所以它读到的是「时钟沿之后的新值」,语义干净——这正是方式一最稳妥的原因。
- 手动
sample()在调用者所在的区域采样。UVM monitor 跑在 Reactive 区,此时信号同样已稳定,但如果 monitor 采样 transaction 字段、而该对象是在 Active 区被另一段 TB 代码用阻塞方式改写的,时序就取决于两边代码的先后,存在竞争。
顺带一提:断言(assert property)也在 Observed 区采样,所以「断言看到的值」和「事件驱动 covergroup 看到的值」天然一致——拿断言波形去对 covergroup 的 hit 时刻,两者应该严丝合缝。如果对不上,多半是你的 covergroup 用了手动采样、而调用点放错了位置。关于断言采样的更多细节见 SVA 断言实战。
再补一个理解调度区域的实用视角:很多资料会用「program block 里的代码在 Reactive 区执行」来解释时序竞争,这没错,但 UVM 时代 testbench 主体是 module 而非 program——UVM 组件跑在 module 域里,它们的方法实际仍在 Reactive 语义下被调用(phase 机制底层由 program 风格的调度驱动)。所以「monitor 里手动采样处于 Reactive 区」这个结论对 UVM 成立,不需要因为代码写在 module 里就重新推导。真正要警惕的是混用时钟:DUT 时钟沿触发的 always 块(Active 区)和 monitor 的 @(posedge clk) 唤醒(随后落到 Reactive 区执行)之间存在一整条 NBA→Observed 的走廊,手动采样站在走廊尽头,天然比 Active 区晚看到新值。
还有 option.per_instance 与采样的交互值得一提:当 per_instance = 1 时,每个 covergroup 实例独立统计,采样次数按实例分开累计。如果环境里有多个 agent、各自 new 了一份 covergroup,又只有部分 agent 的 monitor 调了 sample(),合并报告里就会出现「某些实例空、某些实例满」的假象。这不算采样时机 bug,但在排查「覆盖率不涨」时很容易和漏采混淆——先看实例维度是否齐全,再怀疑时序。
三、坑一:采到旧值——时钟沿前的最后一格
「采到旧值」最常见的剧本:验证工程师嫌 @(posedge clk) 绑定不够灵活,改成在时钟周期任务里手动采样:
task collect();
  @(posedge clk);
  cg.sample();          // 想采本拍握手,实际可能采到上一拍尾巴
endtask
问题出在 @(posedge clk) 唤醒的是 Active 区的进程,此时本拍 NBA 还没更新,DUT 用非阻塞赋值产生的新值要到 NBA 区才落地。如果 cg.sample() 直接读 DUT 信号,读到的就是沿到来之前的值——一拍错位,握手的 valid 和 data 对不上,cross bin 永远少一类组合。
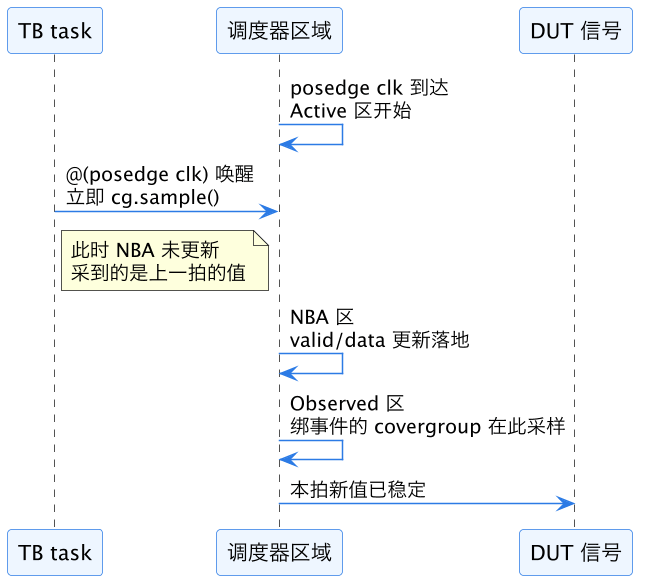
上图标出了错位的根源:手动采样的唤醒点比 NBA 更新早了一格。修复有三种等价写法,按场景选:
- 改用构造绑定
@(posedge clk),把采样交给 Observed 区(首选); - 唤醒后加
##0风格的让步——在时钟块场景就是@(cb),让采样等到 clocking block 的输入偏斜生效; - 干脆把信号包进 interface 的 clocking block,采样
cb.valid、cb.data,由 clocking block 的#1step输入偏斜保证读值时序与断言一致。
第三种写法顺带解决了驱动侧的竞争,是大中型环境的标准做法,细节见 clocking block 与 testbench 同步 和 sv-interface 与 clocking block。
四、坑二:漏采与重采——事件密度和触发条件没对齐
第二类坑来自「采样事件和信号变化不同步」,方向有两个。
漏采:信号在一个时钟里可能变化多次,或者有效窗口短于一拍。典型场景是异步脉冲、门控时钟域、@(sig) 边沿本身。如果 covergroup 绑在慢时钟上、信号却在快时钟域翻转,一拍里连续两次握手只被采到一次,覆盖率直接腰斩。修复思路是把 covergroup 绑到信号所属的那个时钟,或者改用 covergroup cg @(sig_change_event) 让信号变化自己触发采样;跨时钟域的场景,每个域各建一个 covergroup 实例,比强行共用一个绑定要清晰得多。
重采:一个事务的有效窗口持续多拍(valid 拉高等待 ready),绑时钟的 covergroup 每拍都采一次,同一个事务被计 N 次。weight 和 at_least 会因此虚高,报告好看但不可信。修复是在 coverpoint 上加 iff 限定有效条件:
covergroup cg_bus @(posedge clk);
  cp_addr : coverpoint addr iff (valid && ready);  // 只在握手拍采样
endgroup
iff 的语义是「条件不满足时本次采样整组作废」,不只是该 coverpoint 不采——cross 里引用它时也一并跳过。这点和 covergroup 选项 goal 与 at_least 里讲的统计口径直接相关:重采会让 at_least 形同虚设。
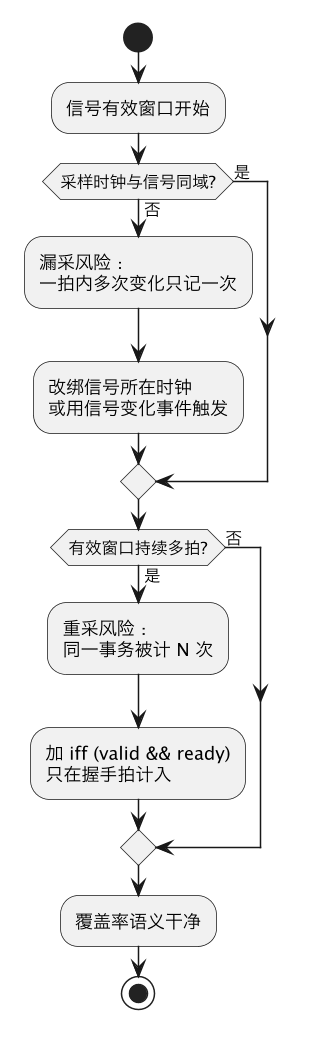
上面这张决策图把两类坑的诊断和修复收成一条路径:先看时钟域对不对齐,再看有效窗口是不是多拍。实际回归里「某个 bin 的 hit 数是预期的整数倍」几乎就是重采的指纹,「hit 数连一半都不到」则先怀疑漏采。
再给一个真实感更强的漏采案例:某 DMA 控制器的 done 脉冲只拉高一拍,验证环境却把 covergroup 绑在门控后的慢时钟上——门控关闭的拍里 done 来了又走,采样事件根本没触发,覆盖率面板上一片空白。排查者盯着激励看了两天,最后把采样时钟换回原始时钟,done 的 bins 立刻填满。教训是:绑事件前先问一句「这个信号最短活多久」,答案如果短于采样事件的最小间隔,就必须换触发源,这是激励再丰富也救不回来的结构性问题。
与漏采相对,重采还有一个隐蔽变体:复位释放瞬间的连采。复位期间信号保持默认值,复位释放后若干拍内 covergroup 照样按时钟采样,把一堆 idle 默认值灌进 bins,真实流量还没开始,「默认组合」的 bin 就已经命中,给人「这组场景已覆盖」的错觉。处理手法依然是 iff——加一个 iff (rst_n && started) 的门控,或者用 $rose(rst_n) 之后的使能信号做限定,把热身期挡在统计之外。
五、UVM 场景:monitor 里的手动采样放哪里
UVM 环境里 covergroup 几乎都用手动采样:monitor 在 analysis_port.write(tr) 前后调 cg.sample(),或者由 subscriber 在 write() 里采样。问题只剩一个——事务对象的字段在 sample() 那一刻是不是最终值。
两个写错率最高的位置:一是 monitor 在接口上 @(posedge clk) 刚看到握手就立刻采样,但 transaction 的某些字段(如响应、结束时间戳)要等事务收尾才填——采样太早,后半字段全是默认值;二是把 sample() 放在 write() 之后由 subscriber 间接调用,结果 subscriber 的 write() 实现里先做了字段归一化(比如把 x 态抹成 0),采到的不是线上真实值。
task monitor::sample_on_complete(bus_txn tr);
  cg.sample();                       // 时机:tr 字段已全部填好
  ap.write(tr);                      // 再广播给 scoreboard / subscriber
endtask经验法则一句话:sample() 放在 transaction「封箱」之后、任何归一化处理之前。另一个稳妥做法是把 covergroup 的采样表达式直接写成函数参数——cg.sample(tr.kind, tr.len) 配合带参数的 coverpoint,采样值来自调用栈上的快照,彻底摆脱「对象后来又被改了」的隐患。
如果是 subscriber 模式,还要注意 write() 本身跑在 Reactive 区,多个 subscriber 挂在同一个 analysis port 上时执行顺序不定——覆盖率 subscriber 务必不修改 tr,只做只读采样,否则它会污染排在自己后面的兄弟组件。环境级的覆盖率收集策略(monitor 内置 vs 独立 subscriber)可以和 代码覆盖率与功能覆盖率 的合并流程一起规划。
六、自检清单:覆盖率数字异常时的排查顺序
把前三节的坑收敛成一张排查表,覆盖率不符合预期时按行过一遍,十有八九能定位:
| 症状 | 最可能根因 | 验证方法 | 修复 |
|---|---|---|---|
| cross bin 组合对不上 | Active 区手动采样采到旧值 | 波形对齐 hit 时刻与信号跳变 | 改绑事件或走 clocking block |
| hit 数是整数倍偏高 | 有效窗口多拍导致重采 | 单事务跑一遍看 hit 增量 | 加 iff (valid && ready) |
| hit 数系统性偏少 | 采样时钟慢于信号域 | 数信号边沿与采样次数 | 绑快时钟或变化事件 |
| 某些字段永远是默认值 | sample() 早于事务封箱 | 打印 sample 点的对象内容 | 挪到封箱之后 |
| 字段被抹成归一值 | subscriber 先做归一化 | 比较线上值与采样值 | 采样提前或用参数快照 |
| 断言波形与 hit 对不齐 | 手动采样区域错位 | 对照 Observed 区断言结果 | 与断言共用同一采样语义 |
最后一行值得单独强调:断言是天然的「标准答案」。断言在 Observed 区采样、时序语义由 LRM 钉死,拿它和 covergroup 对拍是成本最低的校准手段——同一拍断言 pass 的握手,covergroup 就该在同一拍 hit,对不齐就是采样时机错了,不是激励不够。团队里把这张表贴在覆盖率评审 checklist 上之后,新人文档里「采样时机」类问题从平均三天定位缩短到半天,清单的价值就在于把隐性的调度区域知识变成了显性的排查步骤。
这一篇在知识体系里的位置
本篇是 covergroup 系列的「时序底座」篇。前置阅读:covergroup 与 coverpoint bins(bins 定义)、covergroup 选项 goal 与 at_least(统计口径)、clocking block 与 testbench 同步(输入偏斜与区域竞争)。后续可接:cross 覆盖率与 illegal bins(在正确采样前提下做交叉分析)、覆盖率合并与排除流程(把干净的覆盖率数据送进签核流程)、代码覆盖率与功能覆盖率(两类覆盖率的互补关系)。
总结
covergroup 采样时机的本质是「在哪个调度区域读值」:构造绑定 @(posedge clk) 的采样落在 Observed 区、读到 NBA 更新后的新值,是最稳妥的默认选择;手动 sample() 的时机完全由调用点决定,采旧值、重采、漏采三类坑分别对应「唤醒早于 NBA」「有效窗口多拍未加 iff」「采样时钟慢于信号域」,UVM 场景下把 sample() 放在事务封箱之后、归一化之前,并拿 Observed 区的断言波形做校准,覆盖率数字才可信。