ERROR GRT-0119 Routing congestion too high 排查:OpenLANE 布线拥塞失败修复实录
更新时间:2026-10-26。报错排查篇,属于 EDA 报错排查系列。
ERROR GRT-0119 Routing congestion too high是 OpenLANE flow 在全局布线(global route)阶段最常见的硬失败之一:GRT 是 OpenROAD 全局布线器(FastRoute)的日志前缀,0119 表示布线资源的需求量超过了拥塞阈值,布线器判定「这张图布不通」主动放弃。拥塞的理论背景见 全局布线拥塞分析,宏通道挤压场景见 宏通道拥塞。
首屏答案:看到 GRT-0119 不要先去翻布线器参数,九成问题是前面布局阶段埋的——核心利用率 FP_CORE_UTIL 和布局目标密度 PL_TARGET_DENSITY 开得太激进,标准单元挤成一团,留给走线的通道不够。本文实测的 4 路 16x16 乘法器阵列在 sky130A PDK 下,95/0.99 配置在 STEP 17 被 GRT-0119 打死;只把这两个旋钮降到 50/0.6,同一份 RTL 全程跑通。有宏(SRAM、PLL)的设计再加两个旋钮:宏周围 placement halo 和宏摆位形成的通道宽度。
本文要回答的问题
ERROR GRT-0119和Routing congestion too high这两行日志每个字段在说什么?- 为什么拥塞问题在布线阶段才爆,根子却常常在布局?
- 四个降拥塞旋钮(FP_CORE_UTIL / PL_TARGET_DENSITY / placement halo / 宏摆位)各管什么、先拧哪个?
- 修完怎么确认不是「这次侥幸布通」?
一、报错原文与现象
复现设计是一个 4 路 16x16 乘法器加累加器的阵列(mult_array),纯标准单元、无宏模块,故意用极端激进的密度配置把拥塞逼出来。flow 跑到 STEP 17(全局布线阶段的时序优化)时中止:
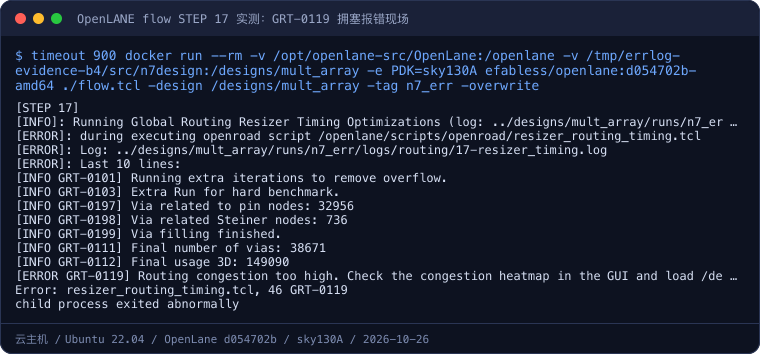
读这段输出抓四个字段:第一,[ERROR GRT-0119] Routing congestion too high 是核心判定——FastRoute 跑完全局布线后又做了额外迭代(前一行的 GRT-0101 Running extra iterations to remove overflow),仍然清不掉溢出的布线格,于是判定拥塞不可收敛;第二,报错行末尾给出的 resizer-routing-timing-congestion.rpt 路径是下一步排查的入口,里面按层列出每个 gcell 的容量与占用;第三,Error: resizer_routing_timing.tcl, 46 GRT-0119 说明错误是从时序驱动的布线优化脚本里抛出的,不是详细布线器 TritonRoute;第四,OpenLANE 随后自动打包 issue_reproducible 目录并打印 Flow failed——STEP 17 失败意味着连全局布线都没过,后面的详细布线、寄生提取、signoff 全部不会发生。
注意一个容易误读的点:log 尾部 [ERROR]: Flow failed. 之后列出的 4 warnings found by linter 只是 OpenLANE 的事后归因提示,那 4 条 linter warning 与本次拥塞没有因果关系——真正的失败点就是 STEP 17 的 GRT-0119。不要被「failure may have been because of the following warnings」带偏去修 lint。
二、根因总览:不是布线器不行,是前面塞太满
全局布线的任务是把每条 net 分配到布线格(gcell)里,每格每层有固定的走线轨容量。当某个区域的 net 需求持续超过容量,布线器先绕行、再迭代,仍清不掉就报 GRT-0119。需求超容量的来源按命中率排序:
| 根因 | 机理 | 典型场景 |
|---|---|---|
| 核心利用率过高 | FP_CORE_UTIL 接近上限,单元间几乎不留走线空隙 | 为了缩 die 面积把利用率开到 90%+ |
| 布局密度过高 | PL_TARGET_DENSITY 让布局器把单元往死里挤 | 默认 0.7 左右被调到 0.95+ |
| 宏挤压通道 | 宏摆位形成的通道太窄,穿行 net 全部挤进走廊 | SRAM 围成一圈、中间留细缝 |
| 局部引脚密度爆点 | 少数区域单元引脚过密(高扇入逻辑锥) | 大型 MUX 阵列、交叉开关 |
本例的 mult_array 同时踩中前两条:FP_CORE_UTIL=95 表示 95% 的核心面积要摆满标准单元,PL_TARGET_DENSITY=0.99 又要求布局器把单元压到 99% 的局部密度。sky130 的 hd 单元库横向走线主要靠 met1/met2,纵向靠 met3/met4,单元贴单元之后这些层在阵列中央基本被占满,乘法器之间的大量中间结果 net 无处可去——拥塞是必然结果,不是布线器的锅。
三、四个降拥塞旋钮
OpenLANE 应对拥塞的可调项很多,但真正见效快、语义清晰的是这四个。按「先试哪个」的顺序排:
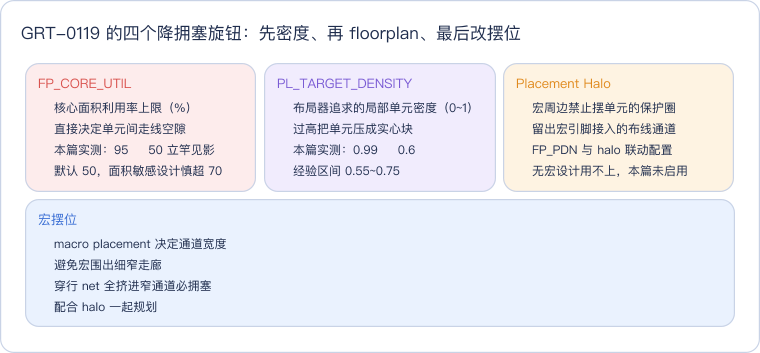
这张卡的要点是「便宜的先试」。FP_CORE_UTIL 和 PL_TARGET_DENSITY 是 config.json 里改两行数字的事,一次重跑十来分钟出结果;而 halo 与宏摆位涉及 floorplan 重设计,迭代成本高得多。实践中 80% 的 GRT-0119 靠前两个旋钮就能压下去——前提是你知道当前值是多少。查法很简单:翻 run 目录下 config.tcl(OpenLANE 会把最终生效的全部配置落盘),搜这两个变量名,和默认值对比就知道自己开得多激进。利用率的理论背景与「利用率-可布性」的权衡见 布局密度筛选与利用率,halo 细节见 宏 halo 隔离带规则。
四、排错流程:从报错行到修复配置
把整条排查路径画成一张决策图,按角色上色:红是命中的拥塞根因,蓝是排查动作,橙是修复旋钮,绿是通过态。
读这张图抓住一条主线:先查数值、再看图、最后动 floorplan。FP_CORE_UTIL=95 / PL_TARGET_DENSITY=0.99 这种组合在 config.tcl 里一眼就能认出来,属于「数值明显离谱直接改」的路径,不需要打开 GUI 看热力图。只有当前两个旋钮都在正常区间(利用率 ≤70、密度 ≤0.75)还报 GRT-0119 时,才需要按报错行给出的 resizer-routing-timing-congestion.rpt 去定位溢出集中的 gcell——若溢出带沿着宏与宏之间的走廊分布,那就是通道宽度问题,动 halo 和摆位;若溢出集中在某个逻辑锥(比如巨型 MUX),则是引脚密度爆点,要考虑给该模块加 cell padding 或重构 RTL。
另外一个常被忽略的辅助手段是综合阶段的拥塞感知重构:乘法器阵列这类数据通路规整的设计,让综合器换用面积更小或引脚更分散的映射,能从源头降低布线需求,思路见 拥塞感知综合重构。但这是「前面都试过还不行」时的后手,不要一上来就改 RTL。
五、对照实测:95/0.99 打死,50/0.6 跑通
修复只改了 config.json 里两行:FP_CORE_UTIL 95→50、PL_TARGET_DENSITY 0.99→0.6,RTL 与其余配置完全不动,用 -tag n7_fix 另起一个 run 对照。结果:同一个 STEP 17 顺利通过,全局布线、详细布线、GDS 流出一气呵成:
# command: docker run --rm -v ...:/openlane efabless/openlane:d054702b ./flow.tcl -design /designs/mult_array -tag n7_fix -overwrite
# date: 2026-10-26T01:48:00+08:00
# host-toolchain: OpenLane d054702b2cce04761cc2bc598f6b95c9d8ca7c6c / sky130A PDK (sky130_fd_sc_hd)
---
[STEP 17]
[INFO]: Running Global Routing Resizer Timing Optimizations (log: .../routing/17-resizer_timing.log)...
[STEP 19]
[INFO]: Running Global Routing (log: .../routing/19-global.log)...
[STEP 23]
[INFO]: Running Detailed Routing (log: .../routing/23-detailed.log)...
[INFO]: No DRC violations after detailed routing.
[INFO]: No DRC violations after GDS streaming out.
两个标志确认这次不是侥幸:其一,STEP 23 详细布线之后 No DRC violations——全局布线即使过了,若拥塞仍处在临界,详细布线阶段往往会爆出大片 DRC;其二,GDS 流出后的整版检查也是零违例。两头都干净,说明密度回调给的布线余量是充足的,而不是贴着阈值勉强挤过去。
代价要说清楚:利用率从 95 降到 50,die 核心面积大约涨了一倍(floorplan 从 255.76 x 255.68 um 起重新生成)。这正是利用率与面积的根本权衡——FP_CORE_UTIL 开得越高,面积越省、布线越难;开得越低,布线越松、面积越费。工程上的合理区间通常在 40~70:低于 40 说明 floorplan 太浪费,高于 70 就要开始为拥塞和时序优化付出迭代成本。另外 fix 版 log 尾部仍有 setup violation 的提示,那是时序收敛问题,与拥塞无关,属于下一轮 PL_RESIZER 时序优化要处理的事,不影响本篇对 GRT-0119 的结论。
六、预防与纪律
- 新项目从默认值出发:
FP_CORE_UTIL=50、PL_TARGET_DENSITY用 PDK 推荐值起步,first tape-in 之前不要为了省面积动这两个旋钮。 - 改密度必留对照 run:每次调整用不同
-tag起新 run,保留上一轮的reports/metrics.csv,拥塞、时序、面积三个维度一起比,防止「按下葫芦浮起瓢」。 - 把 STEP 17 写进 CI 监控:OpenLANE 的
metrics.csv里有全局布线溢出计数,溢出非零就该告警,不等 GRT-0119 直接打死 flow 才发现。 - 宏设计先画通道预算:摆宏之前在纸上算每条走廊的宽度与穿行 net 数,halo 值一次给够;事后扩通道等于 floorplan 推倒重来。
- 不要用
quit_on_routing_congestion=0掩盖:OpenLANE 有开关可以把拥塞错误降级让 flow 继续,但下游详细布线会用数小时和海量 DRC 违例把账讨回来——拥塞必须在全局布线阶段解决。
实验环境
- 机器/系统:云主机竞价实例 / Ubuntu 22.04(docker 运行 OpenLANE 容器)
- 工具版本:OpenLane d054702b2cce04761cc2bc598f6b95c9d8ca7c6c(镜像 tag
efabless/openlane:d054702b...-amd64,照抄 log 头);PDK sky130A / 标准单元库 sky130_fd_sc_hd(volare 管理) - 日期:2026-10-26
- 完整命令:
./flow.tcl -design /designs/mult_array -tag n7_err -overwrite(复现报错,FP_CORE_UTIL=95 / PL_TARGET_DENSITY=0.99);./flow.tcl -design /designs/mult_array -tag n7_fix -overwrite(验证修复,50 / 0.6),均经docker run --rm -v ...:/openlane -e PDK_ROOT=... -e PDK=sky130A启动
代码获取
复现用 RTL(mult_array 4 路乘法器阵列)与两份 config.json(err / fix 配置)在公开仓 https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/openlane-fastroute-congestion。按目录内 README 把设计目录挂进 OpenLANE 容器,分别用两份配置跑 flow.tcl 即可重现「STEP 17 GRT-0119 失败 → 密度回调后全程跑通」的对照。
这一篇在知识体系里的位置
本篇是 EDA 报错排查系列 中 OpenLANE flow 错误簇的一员:上游承接 全局布线拥塞分析(拥塞度量的理论框架)与 宏通道拥塞(floorplan 层面的通道规划);同簇还有 OpenLANE OOM exit 137(资源类失败)与 OpenLANE docker tag 不匹配(环境类失败)。本篇管的是「密度类失败」——flow 能跑、机器没崩,是设计塞得太满让布线器布不通。
一句话总结
ERROR GRT-0119 Routing congestion too high = 全局布线器判定布线需求超出容量、主动放弃,根因九成在布局而非布线:先翻 run 目录 config.tcl 核对 FP_CORE_UTIL 与 PL_TARGET_DENSITY,激进的数值(如本篇实测的 95/0.99)直接回调到 50/0.6 量级即可让 flow 跑通;数值正常还报才去开拥塞热力图查宏走廊,用 placement halo 和宏摆位打开通道——绝不用降级开关把拥塞错误压过去,详细布线会连本带利讨回来。