FPGA 专家 06:以太网深水区——10G、UDP 卸载与线速处理
本文是
fpga/专家层第 09 篇。千兆基础见进阶 千兆以太网 RGMII;物理层见收发器深水区;时间敏感网络见专家层 TSN 专题。
一、速率与 IP 结构
| 速率 | 介质/编码 | 接口 |
|---|---|---|
| 1G | GMII/RGMII 接外部 PHY | 8bit/4bit |
| 10G | 10GBASE-R 走 GTH,64b/66b | AXI-Stream 64bit@156.25MHz |
| 25G | NRZ 走 GTY | 类似升级 |
| 40G/100G | 多 lane / PAM4 | 多通道 |
二、协议栈做到哪层
| 方案 | 内容 | 适用 |
|---|---|---|
| 纯 L2 私有帧 | 自组以太帧 | FPGA 间/私有链路,最快 |
| UDP/IP 卸载 | IP/UDP 头+ARP+ICMP | 采集/行情,线速低延迟主流 |
| TCP | 有状态重传/窗口 | 用 IP 核或交 CPU |
| Linux socket | GEM/软核+OS | 标准省心、抖动大 |
三、线速工程
- 小包流水线:10G 64B = 1.488Mpps,边收边解析、边决定,禁止整包缓存再处理;
- 突发吸收:网络帧突发,FIFO 借 IFG 空闲平滑、突发落 DDR;
- 反压:AXI-Stream tready 全链路贯通;
- 卸载点:CRC、过滤、PTP 硬件时间戳(ns 级)、打标签在数据通路就地完成;
- 大包看带宽、小包看 pps,瓶颈不同。
四、调试
- PCS block_lock/链路状态(同收发器 LTSSM 思路);
- 帧级:前导、MAC、CRC 错误计数;
- 近端/远端回环;
- Wireshark 抓包对照;
- ping(ICMP)验证 IP 栈基本通路。
五、10G/25G 物理与 MAC/PCS:信号在芯片里怎么走
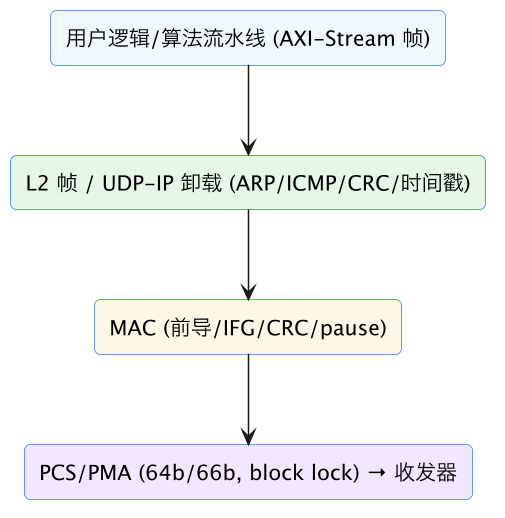
高速以太网和千兆方案在物理形态上是两种东西,理解硬件路径是配置正确的前提。千兆方案是 FPGA 内 MAC 经 GMII/RGMII 接外部 PHY 芯片,PHY 完成模拟收发(MDIO 配置、RGMII 延迟模式是千兆特有的坑);10GBASE-R 则把 PCS/PMA 直接做进收发器硬核,FPGA 例化的是 10G Ethernet Subsystem(MAC+PCS/PMA)或把 MAC 与裸 10GBASE-R PCS 分开例化,数据出芯片已经是 10.3125Gbps 串行差分对,经 AC 耦合到光模块(SFP+)或磁性模块/背板。PCS 内部完成 64b/66b 加扰编码、块锁定(搜索 01/10 同步头并验证周期)、Gearbox(内部 64bit 数据到串行码流的宽度/速率适配)、可选的 BASE-R 链路故障编码和自协商的有限子集(10GBASE-R 严格说没有千兆那样完整的自协商,速率/双工固定;多速率口靠主机配置或更上层协商)。参考钟 156.25MHz(或 156.25M 的倍数/参考钟方案)必须低抖动,时钟规划遵循 专家 04 第八节的全部要求——很多“10G 口随机掉线”根因是参考钟电源或 Quad 归属错误,与网络逻辑无关。
用户接口侧,MAC 与逻辑之间是 AXI4-Stream(或厂商简化的帧接口):10G 典型 64bit@156.25MHz,25G 用 128bit@390.625MHz 等;接口上同时跑收发两个方向的帧流,tlast/tkeep 标帧尾与有效字节,tuser 常用来传递“该帧 CRC 错误/接收 FIFO 溢出”等状态。要区分流时钟与系统时钟:MAC/PCS 用核时钟(coreclk),用户逻辑用自己的时钟时必须经 FIFO;统计计数器、MDIO/管理接口通常在独立的管理时钟域。光模块侧还有一组低速管理信号(I2C 读模块 EEPROM/DOM、TX_DISABLE、RX_LOS、MOD_ABS/PRSNT),它们决定“物理口在不在、模块是否支持该速率”,bring-up 第一步其实是读模块 EEPROM 确认模块类型和链路状态,再看 PCS block_lock,最后才看帧——这与收发器“从内向外点亮”的方法学(专家 04 第九节)完全一致。40G/100G 则是多 lane(4×10G、4×25G、10×10G)加 PCS 内的 lane 对齐/标记重排(alignment marker),或 PAM4(50G/lane 及以上),对应 IP 复杂度高一个量级,选型时要确认 FPGA 收发器代际和许可成本。
六、UDP/IP 硬件卸载的完整实现:从帧解析到 ARP 表
UDP/IP 卸载是 FPGA 数据采集、行情、馈送系统里最常见的网络形态,它的边界要清楚:硬件实现的是无连接、无重传的数据报通路,复杂控制仍交主机。接收方向流水线:帧从 MAC 流出后逐拍解析(不能等整帧),依次检查目的 MAC(是否本机/广播/组播)、以太类型 0x0800、IP 版本与头长(IHL 字段允许 IP 选项,简单栈可拒绝非 20 字节头)、TTL、协议号(17=UDP)、源/目的 IP、IP 头校验和(用加法反码,逐拍累加即可),然后 UDP 源/目的端口、长度,再把净荷交给后端;校验失败的帧要么丢弃计数、要么用 tuser 标记继续传递。发送方向:后端请求(目的 IP、源/目的端口、净荷长度)进入组帧器,依次写以太头、IP 头(含标识、分片标志——不分片时置 DF)、UDP 头,IP 头校验和与 UDP 校验和(UDP checksum 可选,IPv4 允许置 0,但建议计算)边发边累加,最后由 MAC 追加 CRC。
ARP 是硬件栈必须实现的最小“控制面”:发送 IP 包前需要目的 MAC;启动时或缓存未命中时,本机广播 ARP request(谁是 x.x.x.x),目标主机单播回 ARP reply,硬件维护一张小表(通常只存几个固定对端,用 IP 索引 MAC,带老化计时);同时要能应答别人发来的 ARP request(否则对端学不到本机 MAC,链路看似 block_lock 正常却完全不通)。再加上 ICMP echo(ping)响应,设备就能被标准网络工具发现和验证,调试收益极高。可选的 DHCP 客户端让设备自动获取地址,但工业系统更常用静态 IP 以保证确定性。几个必须处理的边角:MTU 限制(标准 1500 字节净荷,超长发片或置 DF 后报 ICMP 不可达;支持巨型帧要与交换机/网卡 MTU 一致)、IP 标识不能每包恒定(某些中间设备和抓包工具会异常)、字节序(网络序大端,组帧时逐字段转换)、广播/组播地址(发现协议、PTP 多播)。VLAN(0x8100 + TCI)、时间戳选项(第八节)是否支持要在架构期定。把“硬件做 L2/UDP 快路径 + 软件做 TCP/ARP 管理/异常”作为默认分工,是兼顾性能和可维护性的成熟模式。
七、线速小包:预算、流水线与不丢包设计
“线速”在大包和小包下是两个完全不同的工程目标。10G 链路最小 64 字节帧加上 8 字节前导、12 字节帧间隔,线包率为 14.88Mpps 除以十即 1.488Mpps,平均每包 67.2ns;25G 是 2.5 倍。这意味着任何“收到整包再开始处理”的架构(哪怕只是写入 DDR 再读出)都会在小包下丢包——DRAM 访问延迟本身就是几十到上百纳秒。正确架构是单遍流式流水线:解析、分类、过滤、转发决策、时间戳、计数全部在帧经过的若干级寄存器上完成,每个时钟周期固定推进 8 字节(64bit 接口)或更多;需要全帧数据的操作(CRC 已由 MAC 处理、深度检测、落盘)放到决策之后的旁路,且必须保证旁路带宽≥线速或明确允许丢哪些包。流水线设计要点:头字段在到达对应级时已经有效,决策结果随帧携带(元数据 sideband,与 tdata 并行传递,避免回头修改);输出仲裁在多个发送源竞争时必须按线速调度且无锁(简单轮询加严格的“本轮必发出”预算)。
突发与缓冲:以太网帧是突发到达的,IFG 和帧内间隔提供了天然空闲,少量 FIFO(几KB~几十KB)能吸收微突发;但多端口汇聚、后端落 DDR/PCIe 的系统要按“端口数×线速突发长度”设计共享缓冲,并实现显式丢包策略(尾丢弃、按优先级 RED),绝不能让 FIFO 静默溢出——每次丢包要有计数器,关键流要有水位告警。资源—速率折中:解析器用宽度换频率(25G 用 128bit/390MHz 与 64bit 双倍频率的逻辑成本差异很大);CAM/哈希表(五元组分类)的查表延迟要藏在流水线里。校验和更新:转发/NAT 改 IP 头时只需增量更新校验和而不必全头重算。验证线速要用商用测试仪或自建 64B 最小帧发生器做“零丢包”测试(RFC 2544 思路),并在温压角和混合帧长分布下复测;同时测量延迟(store-and-forward 至少一个帧时间,cut-through 可压到几十字节时间)和抖动。把“pps 指标、平均/最坏延迟、丢包计数”写进验收标准,而不是只测 iperf 大包带宽。
八、时间同步与时间戳:PTP 硬件实现的要点
网络测量、遥测、金融和 TSN 场景里,时间戳往往比数据本身更重要。普通软件时间戳的误差来自协议栈排队、中断、调度,抖动在几十微秒量级;FPGA 的价值是在 MAC/PHY 边界打硬件时间戳。关键概念是检测点选择:发送方向在帧起始定界符(或 66b 块中帧起始字符)真正离开 MAC/PCS 的时刻打戳,接收方向在该字符到达的时刻打戳——越靠近物理边界,越能消除队列和调度抖动,10G 节点间精度可达数十纳秒。IEEE 1588 PTP 的工作方式:主时钟周期性发 Sync(并可跟 Follow_Up 携带精确发送时间 t1),从时钟记录收包时刻 t2;从时钟发 Delay_Req 记录 t3,主时钟回 Delay_Resp 携带其收到时刻 t4;在对称路径假设下,偏移为 ((t2−t1)−(t4−t3))/2,链路延迟为 ((t2−t1)+(t4−t3))/2。硬件负责识别 PTP 事件报文(UDP 319/320 或二层 EtherType)并打戳/回填时间,软件(本地或软核)跑伺服环路调整本地时钟频率。
本地时钟实现通常是一个硬件计数器加数字频率调节(用累加器小数步进或可调 DDS 控制频率,避免直接改计数器造成跳变),时间分辨率建议纳秒或更细;和 GPS/北斗、1PPS、PLL(如时钟发生芯片)组成时间基时,FPGA 可做频率 disciplining。工程坑很多:不对称路径(交换/路由设备正反延迟不同)直接破坏 PTP 假设,点对点直连或用 boundary clock/transparent clock 交换机解决;普通交换机的存储转发抖动会淹没精度,必须用支持 PTP 的网络设备或改用白兔子式同步以太+PTP 组合;多端口设备要为每个端口独立打戳;时间戳回填 Sync 有时需要两步法(Follow_Up),MAC 要支持发送完成后读出实际离开时刻。时钟故障要有 holdover(本地振荡器维持)和层级(clockClass)降级逻辑。把时间同步当作独立子系统(晶振选型、伺服参数、故障行为)设计,而不是“抓包时顺便记个数”,这部分内容与 专家 36 的 TSN 体系互为表里。
九、从 UDP 卸载到 SmartNIC:卸载边界的演进
把 FPGA 网络设计放在产业脉络里看,能帮助决定“做多少”。第一代是简单 UDP 卸载:帧收发、ARP/ICMP、时间戳,逻辑几万行、风险可控,至今是采集/行情系统的主力。第二代加入传输层:可靠 UDP(自研序号/ACK/重传)、商用或开源硬件 TCP(要处理连接状态机、拥塞窗口、乱序重组、保活,状态量随连接数增长,适合固定少量连接而非通用服务器替代)、RDMA 类传输(RoCE 依赖无损以太网和 PFC,配置不当会引发 PFC 风暴,数据中心级工程)。第三代是SmartNIC/DPU 形态:FPGA 上做多队列虚拟网卡(virtio/SR-IOV)、Open vSwitch 流表卸载(match-action 流水线、隧道封装 VXLAN/Geneve)、存储协议(NVMe-oF)、加解密与压缩,控制面在板上 ARM 核或主机 agent,数据面在 FPGA;其设计方法学从“协议实现”转向“可编程流水线 + 流表 + 异常上送 CPU”。
边界判断的准则:快路径下沉、慢路径上送。凡是每个包都要做、规则固定、延迟敏感的(分类、过滤、转发、时间戳、聚合统计、包头改写),进 FPGA;凡是罕见、复杂、需要与操作系统/管理系统交互的(ARP 表项建立后的老化管理可选、DHCP、TCP 建链、路由协议、TLS 握手、故障诊断页面),交主机,硬件通过控制寄存器和上送队列与软件协作。典型架构是 FPGA 与主机之间除数据 DMA 外还有一条“慢通道”(控制面 AXI-Lite + 异常帧/未知流上送队列),这与 PCIe DMA 的控制/数据分面(专家 08 第十节)是同构的。不要低估“看起来简单”的管理面:生产网络里 VLAN、巨型帧、链路聚合、交换机的 pause/PFC、双口冗余、ARP 风暴防护、广播抑制都会影响设备行为,规格阶段就要写明部署环境假设。成熟团队的选择通常是:能用 UDP 私有协议就不碰 TCP,能固定拓扑就不引入通用网络栈,把复杂度预算花在真正产生价值的数据处理上。
十、调试、验证与网络互操作清单
网络接口的问题分布在物理层、帧层、协议层和对端设备四个地方,调试要分层且每层都有独立判据。物理层:模块在位与 EEPROM 信息、TX_FAULT/RX_LOS、参考钟与电源、PCS block_lock 和 hi_ber(高误码率指示)、收发器眼图/BER(回环 PRBS);近端 PCS/PMA 回环验证本机,远端回环验证光纤/模块。帧层:MAC 统计计数器(CRC 错、长度错、接收溢出、帧间隔违例、发送 pause 帧计数)是第一证据源;用协议分析仪或在 FPGA 内置帧捕获器(匹配过滤 + 快照到 DDR)抓前 128 字节;与主机 Wireshark 双向对照。协议层:ARP 是否双向解析(先查交换机/主机 ARP 表)、ping(ICMP)验证 IP 连通、抓包核对校验和与字节序、TTL/VLAN/Mtu 问题(DF 置位超 MTU 时的 ICMP Frag Needed)。对端与网络:网卡 offload 设置(GRO/LSO/校验和卸载可能让 Wireshark 看到的帧与线上不同)、交换机端口速率/双工/流控配置、防火墙与 ARP 限速、多网卡主机上的路由表和 ARP flux(同一 IP 多口漂移)。
验证体系建议三支柱。其一,仿真:MAC/卸载逻辑用自造帧向量做单元测试(各种异常头、截断帧、错误 CRC、ARP 风暴、乱序 IP 分片),协议检查器断言总线行为。其二,自环与对等测试:FPGA 口经电缆回环、两块 FPGA 对打(一边发 PRBS 载荷帧一边校验序号和 CRC)、与真实网卡(Linux)用标准工具互测,跑 RFC 2544 风格的吞吐/丢包/延迟矩阵(64B 到 9KB,100%/90%/50% 负载)。其三,长时间与异常注入:72 小时满包率、随机拔插光模块、断交换机恢复、ARP 表老化、对端故意发畸形帧、时钟重训注入,验证不挂死、计数器不溢出、可自恢复。交付文档至少包含:速率/编码/模块兼容表、默认 IP/端口配置、统计计数器定义、抓包样本(建链一次完整通信)、已知 MTU/VLAN 限制。把网络子系统当“与不可控外部世界对接的接口”来做防御式设计(任何字段都可能非法、任何对端都可能异常),是 FPGA 网络设备区别于实验室 demo 的分水岭。
十一、千兆 RGMII 专题:延迟、时钟与 PHY 协同
在 10G 方案之外,千兆口仍大量存在于管理面和工业设备中,它的坑集中在 RGMII 这个源同步接口。RGMII 用 4 位 DDR 数据在 125MHz 下传 1Gbps,接收侧数据与 RX_CLK 的建立保持窗口非常紧,规范定义了两种模式:PHY 可在内部加约 2ns 延迟(使数据相对时钟居中),或 FPGA 侧用 IDELAY/相位调整完成;发送侧同理需要 TX 时钟相对 TX 数据的 2ns 延迟。最常见故障是“双方都加了延迟”或“双方都没加”,表现为百兆通、千兆不通或误码率高。正确做法是在原理图和驱动配置中统一延迟归属(通常让 PHY 加延迟,FPGA 直采),并在 FPGA 内仍保留可调延迟用于板级补偿。MDIO/MDC 管理接口用于配置 PHY 寄存器(速率、自协商、环回、延迟模式),复位释放与时钟就绪的时序要按 PHY 数据手册设计;自协商结果(速率、双工)要读回并相应调整 FPGA MAC 配置,10/100M 时时钟是 2.5/25MHz,不能假设固定 125MHz。PCB 上 RGMII 信号等长、阻抗和参考平面仍是基本功,时钟走专用线。把 RGMII 当作一个低速但严格的源同步接口(方法见 专家 03),它就不再是“千兆玄学”。
十二、可靠性与现场运维:网络设备的防御式设计
部署到现场的 FPGA 网口面对的是不可控网络,防御式设计决定了可用性。第一,畸形输入免疫:接收流水线对所有长度字段做一致性检查(以太长度/IP 总长/UDP 长度互相对照),对过短帧、超长帧(巨型帧配置之外)、截断帧、非法版本/IHL、TTL=0、校验和错的帧一律丢弃计数而不是让状态机进入异常;ARP、ICMP 速率限制防风暴攻击。第二,链路事件处理:block_lock 丢失、模块不在位、TX_FAULT、对端端口 flap 时,清空接收 FIFO、复位解析状态机(防止半帧进入业务)、通知上层连接中断;恢复后重新学习 ARP。第三,统计与遥测:RFC 标准 MIB 风格计数器(ifInOctets、各类错误、丢包、pause、CRC)是现场诊断的第一语言;计数器读清零语义和 64 位回绕要处理;关键告警(高 BER、FIFO 溢出、ARP 长期失败)可中断上报。第四,配置安全:静态 IP/端口等参数存放在受保护存储,留有恢复出厂方式;暴露的任何管理协议(调试用的原始帧、重配置服务)在量产镜像中关闭或加认证,FPGA 网口直连内部网络时,未认证的重配置通道等于后门(专家 24)。第五,时间相关失效:计数器、老化定时器、PTP 伺服在长时间运行下的位宽和回绕要验证(72 小时 soak test 的价值就在这里)。把“网络是恶意且混乱的环境”作为设计前提,网络功能才具备产品属性。
十三、选型与演进:FPGA 网络栈做到什么程度的决策框架
最后给一个按场景选型的决策框架,避免过度设计。场景 A,板间/机箱内私有数据搬运:10G 裸 L2 或 Aurora(见 专家 05)即够,不必上 IP;自研帧类型、序号、信用流控,延迟最低、可控性最高。场景 B,采集/测量数据进 Linux 主机:10G/25G + UDP/IP 硬件卸载(ARP/ICMP/PTP),主机标准 socket 或内核旁路接收;这是性价比最高的主流形态,硬件逻辑量和风险可控。场景 C,需要可靠传输/标准生态:少量固定连接可上商用 TCP 卸载 IP;通用多连接、需要路由和防火墙穿越的,把 TCP 交 PS/ARM 或主机,FPGA 只做 L2/L3 快路径与隧道。场景 D,数据中心基础设施:多队列、虚拟化、隧道、遥测一体化的 SmartNIC/DPU,通常基于成熟平台和 IP 组合开发,而不是从零写栈。贯穿四个场景的评估维度是:连接数与状态量、延迟确定性要求、需要互通的设备生态、团队协议验证能力、维护生命周期。一个朴素但有效的判断:凡是“不做就不工作”的协议最小集(ARP/ICMP/校验和/PTP)硬件做扎实;凡是“做了更兼容”的复杂度(拥塞控制、路由、分片重组、TLS)尽量推给主机。把 FPGA 的宝贵预算花在线速、确定性和就地数据处理上,是这一篇希望建立的最终判断力。
十四、与 Aurora、PCIe 的接口选择对照
网络工程师常问:板间数据到底用以太网、Aurora 还是 PCIe?三者物理层同源(收发器),差异全在协议栈和生态。用以太网当需要 IP 路由、交换机多对多组网、与通用主机/第三方设备即用即通、或需要标准监控生态(SNMP、抓包工具)时;代价是 MAC+PCS+协议栈的资源开销、帧间隙和包头开销、配置管理(IP/ARP/VLAN)复杂度。用 Aurora(见 专家 05)当两端都是 FPGA、点对点、追求最低延迟和最小资源时;它没有交换和网络语义,拓扑要自己组织。用 PCIe(见 专家 07)当 FPGA 是主机外设、需要枚举/DMA/内存语义和操作系统驱动时。一个实用判据:问三个问题——对端是谁(FPGA/主机/第三方设备)、拓扑(点对点/交换网络)、谁负责运维(自己/客户 IT)。答案分别是“多厂商设备、任意拓扑、客户网管”就用以太网;“全是自己的 FPGA、固定点对点、自己运维”就选 Aurora;“插在主机上被驱动”就选 PCIe。机箱内背板常见混合:Aurora 做板间低延迟数据面、以太网做设备对客户的标准出口、PCIe 做卡与服务器的连接,三者各守其位。
十五、25G/100G 时代的资源与收敛挑战
速率提升对 FPGA 工程的影响不只在收发器。25G 单口用户接口 128bit@390.625MHz,100G 四通道汇聚后内部流可达 512bit 以上、时钟仍在 300~400MHz 量级,帧解析、FIFO、跨时钟域和 DMA 接口都变成超大位宽逻辑:多路选择器面积、BRAM 端口宽度限制(需要拆 bank 并行)、tkeep 编码、以及大位宽下一个时钟周期内的报文边界可能横跨两个以上端口,解析器必须处理“一拍多帧、一帧跨多拍”的所有组合,简单的状态机写法会直接时序爆炸。工程上采用宽总线+窄处理的分层:宽总线做搬运,在入口把帧切分为固定宽度的向量+长度/偏移元数据,处理流水线按元数据工作;统计、哈希、校验和等运算用进位链/树型归约在一拍或固定几拍内完成。资源预算在 100G 双口设计里可能吃掉相当比例的 BRAM/URAM 和收发器 Quad,架构早期就要让网络口参与资源盘点(资源趋势见 专题 07)。此外 100G 对主机侧也是考验:DMA 必须能持续消费近 100Gbps 的 C2H 流(见 专家 08 的带宽公式),很多“网络口跑不满”实际是 PCIe Gen3 x8 或软件栈成了瓶颈——系统设计要从端到端带宽倒推每一段,而不是各口各自达标就算完成。收尾建议:高速网络子系统的评审应同时邀请逻辑、SI、驱动和运维四方,物理参数、协议栈边界、主机接收能力、现场监控各自有人签字,网络口才能从“能 ping 通”升级为“可承诺线速和可用性的系统部件”。最后补一个常见认知偏差:UDP 卸载实现完成不等于网络子系统完成,交换机端口的 MTU、流控、组播抑制、VLAN trunk 配置和对端网卡的 offload 行为都是系统联调的一部分;设备出厂文档里应给出一份经过验证的交换机/网卡配置示例,把现场网络环境这一不可控变量尽量变成已知项,这是工业网络设备减少售后问题的实用经验,值得在每个项目的交付评审中作为固定检查项保留下来,并随版本发布一并更新;唯有把网络环境、协议边界和监控手段都文档化,高速以太网口才真正具备可交付、可维护的工程属性,这也是 FPGA 网络专家与普通使用者的分水岭:前者交付的是经过验证的线速保证和完整的故障语义,后者交付的只是实验室里能跑通的功能演示,两者在可靠性承诺上的差距一目了然。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 整包存完再处理 | 小包线速爆 | 流水线边收边判 |
| 10G 按千兆思路配 | 编码/时钟全错 | 64b/66b+156.25M+GTH |
| 无 FIFO 吸收突发 | 突发丢帧 | 反压+缓冲借 IFG |
| 硬件硬做 TCP | 状态机灾难 | UDP 卸载/TCP 交 CPU |
| 忽略 ARP/ICMP | 不通又难调 | 至少做 ARP+ping |
| 时间戳软件打 | µs 抖动 | PTP 硬件时间戳 |
相关与延伸
一句话总结
10G+ 以太网直接跑在 GTH/GTY 收发器上:PCS/PMA 用 64b/66b+块同步(10GBASE-R),MAC 做前导/IFG/CRC/pause,用户接口是 156.25MHz 下 64bit 宽的 AXI4-Stream 帧流;千兆则是 GMII/RGMII 接外部 PHY。协议栈分档选:私有 L2 帧最快、UDP/IP 卸载(IP/UDP 头+ARP+ICMP)是 FPGA 采集/行情的主流甜点(无连接、硬件状态机可控、亚 µs 延迟),TCP 复杂交给 IP 核或 CPU,兼容省心走 Linux socket。线速核心是小包流水线——10G 最小包 1.488Mpps、每包仅 ~67ns 预算,必须边收边解析边决定、禁止整包缓存,FIFO 借 IFG 吸收突发、CRC/过滤/PTP 时间戳就地卸载。相比网卡+CPU(即便 DPDK),FPGA 胜在延迟确定、线速小包、数据就地处理和 ns 级硬件时间戳,复杂管理面仍交主机。