FPGA 原型验证专题 11:ASIC→FPGA 等价单元替换库——SRAM/时钟/IO/PHY/模拟宏的替换与等价性
更新时间:2026-09-12。本文是「ASIC FPGA 原型验证系统」专题 06~25 深体系列分册,对应阶段 2(原型适配/设计转换)。总览见 06 原型验证系统全景与文档地图;替换的策略框架与能力边界见 08 不可综合构造识别与存根替换 模拟IP/时钟门控,本篇讲可复用的规则库工程。
这一篇在链路里的位置
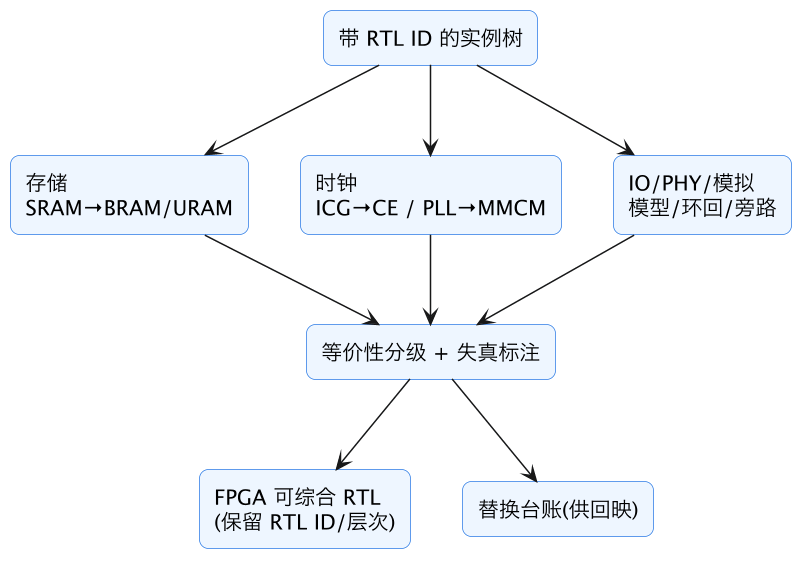
阶段 2 把"带 RTL ID 的展开实例树"变成"FPGA 可综合 RTL"。替换发生在保留 RTL ID 与层次关联的前提下——每个被替换的 ASIC 单元都要能追溯回原始实例,否则阶段 6 采到的活动无法归到正确模块。此时仍没有 GateID。
本文要回答的问题
- ASIC SRAM/单口/双口/ROM 到 BRAM/URAM/LUTRAM 的映射有哪些宽度/深度/冲突语义差异?
- ICG 时钟门控为何要转成时钟使能(CE)而不是真去门控时钟?PLL/DLL/晶振怎么替?
- IO 宏、SerDes/PHY、模拟/混合信号单元在原型上用什么替身(功能模型、环回、外部仪表)?
- 替换如何做到"功能等价但承认失真":哪些行为(X 传播、时序、初始态、保持时间)在 FPGA 上不可复现?
- 替换规则库如何工程化(规则文件、参数化、版本管理、多项目复用)?
- 替换如何记录到映射台账,支撑后续 Gate→RTL 回映与数据解释?
一、替换在流水线中的位置
替换发生在 Elaboration(09 编译器前端展开 Elaboration AST/实例树)分配完 RTL ID(10 RTL ID 体系 分配规则/层次绑定/稳定性)之后、多 FPGA 分割(12 多 FPGA 分区算法 割集/容量/图划分)与 Compiler 逻辑综合(15 编译器逻辑综合 工艺无关网表/两级综合)之前。这个次序有两个硬理由:①替换要按模块名/参数自动匹配实例树上的黑盒节点,必须先有确定实例树;②被替换单元仍挂着原实例的 RTL ID,替换后映射台账才能把替身活动归回原模块。替换库工程化的目标,是让 08 不可综合构造识别与存根替换 模拟IP/时钟门控讲的一次性人工决策沉淀为跨项目复用、带版本、带自检的规则。
二、存储替换:规则库里最大的一类
ASIC 项目里 SRAM 实例成百上千,手工改不可行,全靠 memory wrapper + 自动规则:
- 匹配:按 compiler 输出的模块名前缀/参数(深度、宽度、端口类型、字节使能)匹配规则,如
*_sram_dp_*+ (W=64,D=512) → 对应 BRAM 配置; - 资源选型:小深度寄存器堆/LUTRAM,中深 BRAM,超大深 URAM;宽深组合按器件块大小拼条(cascade),规则里要算可用块数与级联资源;
- 必须显式处理的行为差异:
| 差异点 | ASIC SRAM | FPGA BRAM | 原型处理 |
|---|---|---|---|
| 同口同时读写 | 可配 write-through/read-first/保持 | BRAM 模式可选但默认不同 | wrapper 按 SRAM 配置固定模式,必要时外围加旁路逻辑 |
| 字节使能 | 按 bit mask | 按 byte enable,位宽非 8 倍数时语义有缝 | wrapper 内展开/聚合使能 |
| 初始值/X 态 | 未复位读出 X | 可初始化为固定值 | 统一初值策略并登记:X 传播类验证在原型无效 |
| 延迟周期 | 0/1 可配 | 固定 1 拍(可配输出寄存器 2 拍) | wrapper 打拍对齐,保证周期精确 |
| 读写冲突 | 工艺库定义 | 冲突行为器件相关 | 加前向旁路或显式冲突模型 |
| 位选写、mask | 常见 | 受限 | 拆字+合并 |
- ROM 用
$readmemh初始化文件注入;memory BIST/DFT 端口(见芯片侧 DFT)在原型 wrapper 上悬空并固定使能正常模式。
三、时钟/复位替换
- ICG→CE 是规则库里数量第二多的规则:识别标准 ICG 单元的
(clk, en, test_en)端口模式,替换为带 CE 脚的触发器使能语义(转换代码见 08 不可综合构造识别与存根替换 模拟IP/时钟门控),test_en 接非扫描常量; - PLL/DLL→MMCM/PLL:按输出频率表参数化生成厂商时钟向导配置;多组相关时钟要求同源,避免原型凭空产生 ASIC 里不存在的异步关系;锁定信号
locked用可配置延时模型给出,复位释放逻辑(芯片侧复位设计)照常等待; - 内部时钟归一:识别「寄存器输出当时钟」的模式(ASIC 可能是真门控网表的一部分),规则报错交回人工确认,能转 CE 的转 CE,确需独立时钟的在时钟表登记、由 MMCM 生成;
- 复位同步替换:ASIC 复位释放单元替换为原型库的同步释放模块,多片广播场景输出对齐使能(见 13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频)。
四、IO / PHY / 模拟替换
按可信度从高到低三档落地为规则:
- 硬核直连:FPGA 有对等硬核时(DDR controller+PHY、PCIe block、MGT SerDes),wrapper 把数字侧接口原样保留、模拟参数用约束配置,可做到协议周期精确;LVDS 源同步接口直接映射 SelectIO/ISERDES(背景见 20 LVDS 源同步);
- 环回 + 数字模型:无对等物或板子不引腿时,TX→RX 板内/片内环回跑协议栈,驱动软件能完整演练;DDR 训练、链路均衡等模拟相关流程用行为模型给出「训练成功」结果;
- 外部仪表/co-model:少量关键 PHY 引到板子连接器,用外部信号源/协议分析仪注入真实激励,或与仿真器协同(37 FPGA 与仿真器互联)。模拟宏(ADC/DAC/电源监控)整体旁路,数字侧由寄存器替身 + 脚本激励模拟采样值。
五、其他专属单元
- FIFO 宏/队列编译器单元:按深度选寄存器/BRAM 实现,almost-empty/full 水位线标志逐一对齐,注意 FWFT 模式语义(参见 FPGA 侧 FIFO 设计 与芯片侧 FIFO 深度计算);
- CRC/DSP/安全硬宏:优先映射 DSP48 等硬块(11 DSP48 与算术),无对应时用可综合 RTL 替身;
- DFT/test 逻辑:scan_en、test_mode 等端口在原型常量化为功能模式,扫描链本身不实现(扫描是制造测试结构,见 DFT 可测性);JTAG TAP 若软件要用则保留 TAP 控制器替身;
- 电源单元:按 08 不可综合构造识别与存根替换 模拟IP/时钟门控 的折叠规则处理(虚拟开关/可配隔离/影子 retention),归入规则库的 power 类。
六、等价性分级:规则自带可信度标签
每条替换规则在库里带三个等级之一,随台账流转:周期精确(BRAM 打拍对齐、CE、同源 MMCM——性能与功能结论可用)、功能等价(环回 PHY、行为 PLL——协议/软件结论可用,性能/margin 无效)、仅接口替身(模拟激励、stub——只能让系统跑起来)。规则还声明失真清单(哪些信号/时序不复现),自动拼进原型版本的能力边界声明。
七、规则库的工程形态
replace_rules/
├── memory/    sram_dp_w*.yaml   匹配模式+参数约束→替身模块+资源算法
├── clock/     icg_to_ce.yaml, pll_to_mmcm.yaml
├── io_phy/    ddr_loopback.yaml, serdes_hard.yaml
├── power/     upf_collapse.yaml
└── models/ 替身 RTL/网表(带自己的版本号)每条规则:匹配谓词(模块名正则+参数条件)、替身目标、参数映射、等价等级、失真声明、适用器件、owner。工程要点:①自动匹配 + 白名单——规则覆盖不了的黑盒必须报错停下,禁止默认塞空壳;②回归校验——替身单元与 ASIC 模型在仿真里跑同一组定向向量做周期比对,规则升级时全量回归;③版本管理——规则库与模型一起打 tag,替换产物记录所用规则版本;④多项目复用——不同 SoC 的 SRAM/PLL 往往来自同一批 IP,规则命中率随项目数快速上升,这正是 Compiler 团队的核心资产。
八、替换台账:回映的前提
每次替换落一条:原 RTL ID/层次路径 → 替身模块名+资源类型(BRAM 位点/CE/DSP…)→ 规则版本 → 等价等级 → 失真清单。它在阶段 3 汇入 info_table(17 info_table 映射表 GateID↔RTLID/回溯/版本)。没有这条链,阶段 6 采到 BRAM 使能翻转就无法解释为「SRAM 访问活动」、CE 翻转无法还原 ICG 行为(23 Gate→RTL 数据回映 查表/聚合/SAIF、25 真实激励驱动 ASIC 签核 SAIF 反标/边界),真实激励反哺签核的价值就断了。
九、存储替换的深水区:多端口、写掩码与行为偏差
存储类替换数量最大、也最容易在「看起来一样」的模型上出行为偏差,值得展开讲透。ASIC 存储器编译器生成的 RAM 有丰富的配置维度:单口/简单双口/真双口、读写位宽比、写掩码(byte/bit enable)、写穿透行为(write-first/read-first/no-change)、输出锁存、初始化方式、冲突端口同时读写同一地址时的行为(有的库定义为 X,有的给出旧值)。FPGA BRAM/URAM 只支持其中一组组合,替换规则库必须把每个维度的映射和偏差显式记录。写穿透模式是头号坑:ASIC 模型配置成 write-first 时,同拍写同址读返回新值;若替换 IP 配置成 read-first,功能仿真与上板在该边界上分叉,且这种分叉只在特定地址模式下出现,常规随机用例可能漏掉,必须靠规则库强制配置并做定向断言。多端口 RAM(三读两写之类)在 FPGA 上没有原生对应,规则会把它拆成多块 BRAM 加前贴复制/仲裁逻辑;拆分引入的仲裁延迟改变了同址冲突的语义,可信度应降级并在台账标注——回映时对该实例的活动数据要意识到端口活动被复制放大。写掩码粒度不匹配(ASIC 支持 bit enable 而目标配置为 byte enable)时,替换逻辑要读改写,增加读端口流量,活动率同样失真。初始化方面,ASIC RAM 上电内容常定义为 X,FPGA BRAM 可加载初值;替换时统一初始化为零会让依赖「未初始化即报错」的检查失效,也可能把未初始化读的 bug 掩盖成正常零值。规则库对每条存储替换应输出:目标资源类型与数量、行为配置(含写穿透/冲突语义)、引入的额外延迟与仲裁、初始化策略、等价性等级(周期精确/功能等价/近似),并据此生成定向验证用例(同址读写、满写满读、所有掩码组合)。只有这一级别的台账粒度,67 篇的回映才能正确解释存储实例的活动数据,69 篇的签核消费方才知道哪些存储活动是真实的、哪些是复制读改写的产物。
十、IO/PHY 替换的协议分层:在哪一层「接缝」最划算
把芯片的高速 IO 搬进 FPGA,核心决策是选择协议栈的哪一层作为替换接缝,接缝位置不同,保真度和可移植性完全不同。以 PCIe 为例,有三种典型接缝:事务层替换——DUT 的事务层逻辑保留,下面的数据链路层和物理层用 FPGA 商用 PCIe 硬核加适配桥替换,DUT 看到的是 TLP 接口,软件能跑真实驱动通过原型板的 PCIe 金手指与主机通信;保真度最高,代价是硬核接口协议与 ASIC 实现不同,适配桥要处理流控、重试、序列号的时序差。PIPE 接口替换——保留 DUT 自己的数据链路/物理编码逻辑,只把串行/解串和模拟前端替换成 FPGA GT,接缝在 PIPE 标准接口;这能验证更多自研逻辑,但 FPGA GT 的 PIPE 时序、宽度、速率档与目标 PHY 不完全一致,且 FPGA 无法直接出金手指完整链路时要做环回。管脚级替换——最底层,几乎只有 IO 缓冲器换成 FPGA IO,SerDes 无法这样做。DDR 类似:可在控制器与 PHY 界面替换(用 FPGA MIG 提供相同控制器接口的模型),或更上层直接用一块行为 BRAM 模型冒充内存(保真度最低,只能验证访存逻辑的功能、完全不含刷新/时序/调度效应)。接缝选择原则:验证目标决定接缝——软件联调优先选能端到端出真实链路的事务层替换;自研控制器/链路层验证选 PIPE 级;纯数据通路功能可用行为模型。每个接缝的替换模型都要记录它不代表什么:PIPE 替换不代表均衡与抖动,MIG 替换不代表 ASIC DDR PHY 的训练与读延迟分布。多片系统中接缝 IP 占用的 GT、时钟资源和它们引入的固定延迟,还要反馈给分区(56 篇)和频率预算(63 篇),因为物理 IO 的位置往往反向决定 DUT 该切在哪。
十一、替换规则库的版本化与回归:规则也是需要验证的代码
替换规则库本质上是一份随工艺、平台、IP 版本演进的软件:FPGA 器件家族换代会改变可用存储/GT 类型,商用替换 IP 升级会改变延迟参数,编译器自身优化升级会改变规则触发条件。如果规则库不版本化、不回归,它会成为系统里最隐蔽的不可复现来源。工程上把每条规则当作有版本号的对象:规则标识、适用的源单元模式、目标替换模型及版本、参数映射函数、可信度等级、引入/废弃日期、已知问题。每次规则变更触发两类回归:规则级回归——一组覆盖各类 ASIC 原语的小设计,断言替换后的网表结构(资源类型、数量、连接)符合规则定义,行为级回归用周期精确参考模型比对替换前后的关键时序行为(尤其写穿透、冲突、CDC 同步拍数)。系统级回归——在大型参考设计上重跑全流程,比对规则变更前后的分区、频率、活动数据,任何指标的非预期跳变都要人工解释。规则库版本必须进入构建 manifest,与 RTL、适配层、网表、比特流、info_table 并列绑定——因为「这次数据是用规则库 3.2 还是 3.4 替换的」直接影响活动数据的可比性,3.3 若修过 ICG 扇出处理,跨版本的时钟网络活动趋势就不能直接连成一条线。规则台账还应支持反向查询:给定一个替换后实例,能列出所有生效规则;给定一条规则,能找到它作用的全部实例——这两条查询在问题复盘(「这批 RAM 的异常活动从哪来」)中使用频率极高。把规则当代码评审、当代码回归、当代码版本管理,是替换体系长期可信的唯一出路。
十二、DSP、算术与数据通路的替换:乘法器不是免费的
存储和 IO 之外,第三大替换类是算术资源,它的问题表现得更隐蔽——综合通常「能过」,但资源和频率会悄悄失控。ASIC 设计里乘法器由标准单元综合生成,位宽、时序、流水级完全按设计定制;映射到 FPGA 时,正确目标是 DSP 硬核(如 DSP48/DSP58 系列),每个硬核支持固定位宽的乘法累加、带输入输出寄存器和多种加法链模式。位宽失配:一个 22×18 的乘法器能干净落进一个 DSP,但 19×19 或 33×33 就会触发级联或拆分,资源成倍变化;一个本来以为用四个 DSP 的滤波器实际用了九个,分区账本随之失真。替换规则库应在综合前对每个乘法/乘加实例做推断预测,报告 DSP 映射结果,而不是等实现报告出来才发现用 LUT 堆了几百个乘法器。结构推断失败:乘法器周围的写法决定能否被推断——累加器要对齐 DSP 的级联结构、输入寄存器要在位宽匹配的位置、复位极性和使能要符合硬核支持的模板;ASIC 风格的自由流水在 FPGA 上可能打散成 LUT 实现,频率和功耗双输。规则库提供「DSP 友好」的包装模板,要求数据通路类 IP 在交付时已按目标硬核风格写好,或在适配层替换为厂商运算核。流水级与延迟语义:硬核乘法器插几级流水是性能关键,但加级改变延迟;适配改动要保持对外的有效/反压协议一致,延迟变化登记台账,供 67 篇的延迟校正使用。活动数据的影响:DSP 内部的翻转采集粒度与门级网表不同,回映到 RTL 时一个 DSP 实例对应一大段算术逻辑,活动只能按实例统计;签核侧要理解这一分辨率限制。验证重点:算术替换属于功能等价容易证明的一类(位精确),定向测试覆盖极值、符号、饱和与累加溢出即可,真正要盯的是资源账本和时序,而不是功能——这也是它和存储/IO 替换在验证策略上的分工。
十三、替换覆盖率报告:项目健康度的一面镜子
每次构建除了产出网表,还应产出一份「替换覆盖率报告」,它从另一个角度描述原型与原设计的距离,是评审和签核都需要的文件。报告的第一部分是按类别的覆盖率:存储实例多少个、其中周期精确/功能等价/行为模型各占多少;IO/PHY 多少个、接缝层级分布;时钟门控转换覆盖率(剩余未转换的 ICG 是漏网还是有意保留);算术资源的 DSP 推断率;剩余裸黑盒与 stub 清单。数字要同时给绝对个数和实例加权(一个 DDR 控制器与一个小 FIFO 不能算同等重要性)。第二部分是变化趋势:对比上一构建,哪些替换新出现、哪些模型升级了版本、哪些从高保真退化成了 stub(退化往往意味着 RTL 改动引入了规则不认识的新配置,是必须追查的信号)。第三部分是功能覆盖映射:把替换清单与验证计划/特性清单交叉,列出哪些芯片特性在当前构建上「可被真实执行」「仅被近似模拟」「完全缺席」;这份映射直接喂给 50 篇能力声明和 68 篇覆盖率分析——在 stub 上采到的「覆盖」不算数。第四部分是签核影响清单:69 篇活动数据交付时,功耗团队需要知道哪些层次的活动是真实 DUT、哪些来自替身、哪些被 ICG→CE 这类转换改变了语义;覆盖率报告的签核视图把这些一次性列清。报告由构建系统自动生成、随 manifest 归档,评审时任何「这块在原型上测过了吗」的提问,都应能在报告里查到确定答案而不是开会争论。替换工程的成熟标志,就是这份报告从「凑不出来」变成「构建结束两分钟后自动躺在收件箱里」。
十四、规则库团队的日常:规则提案、评审与退役
替换工程长期运转靠的是规则库的组织能力,本节描述一条规则从提出到退役的完整生命周期,给建设这类团队一个操作模板。提案通常来自三个源头:新 RTL 交付触发的「未识别单元」清单、新平台/新器件带来的资源变化、验证中发现的现有替换行为偏差。提案必须附带最小源设计、期望网表结构、行为差异分析、影响的 ID 与台账字段,不接受「给这类宏随便找个模型」式的口头需求。评审分三个视角:正确性视角(行为配置是否覆盖写穿透、冲突、复位等边界,谁来写定向验证)、性能/资源视角(目标资源与延迟、对分区和频率的影响)、可追溯视角(来源标记、平台插入命名空间、回映时活动语义是否可解释)。评审结论是规则的可信度等级,等级不由作者自封。上线伴随规则级回归和一次大型参考设计系统级回归(55 篇正文第十一节),并写入变更公告:新版本规则可能改变存量构建的资源和活动结果,下游团队有知情义务。运行期监控:统计每条规则的触发频率、关联的未映射率、由它替换的实例在验证中暴露的问题数;触发为零的规则进入候选退役名单,高频高等级规则获得更严格的回归保护。变更与退役:规则修改按新版本处理而不是原地覆盖,旧版本保留在历史 manifest 的引用中;退役一条规则要先确认没有任何受支持的构建配置仍依赖它。故障复盘的特殊性:规则错误不同于普通软件 bug,它可能已经污染了多版采集和签核数据,复盘必须回溯影响面——哪些历史 run 使用了坏规则、结论是否需要撤回或加注,这个追溯能力正是台账和版本绑定存在的意义。团队结构上,规则库需要明确的 owner 制和跨团队评审委员会(ASIC 设计、原型、验证、签核消费方代表),使规则库既不是平台团队闭门造车的产物,也不是谁提需求谁改的公共脚本。把替换规则当作受监管的工程标准来治理,原型数据的公信力才有制度保障。
十五、替换工程的终极判据:让签核数据经得起追问
所有替换工作最终在一个场合接受审判——ASIC 签核会议上,功耗或验证负责人拿着基于原型活动的数据,被问到:「这些数字凭什么代表即将流片的芯片?」替换工程的全部纪律,都是为了让这个问题有确定答案。回答链条是这样的:每个活动数字都能定位到 RTL 层次(映射表);该层次的每个特殊单元都能查到替换记录(台账);每条记录标明了替身的行为等价级别和它改变了什么(规则库);ICG 转 CE、存储复制、端口延时等已知失真都有校正或标注(时钟台账);本次数据的所有输入版本都自硬件自证(manifest);替身覆盖不到的功能特性没有出现在结论中(能力声明)。这条链上缺任何一环,答案都只能是「我们相信差不多」,而「差不多」不进入流片决策。反过来,链条完整时,即使某个替身只是近似模型,结论依然成立——因为近似的边界被显式声明,统计只使用了模型可信的部分。这就是替换分级、覆盖率报告、数据可信度标记这些看似繁琐机制的共同归宿:它们不是流程负担,而是让 FPGA 原型这种「替代执行」在最严肃的工程决策中获得合法地位的证据系统。建设这套系统的人,应当始终以签核席上的那个追问为设计输入;检验自己工作的最终标准不是「构建跑通了没有」,而是「半年后一个不认识我的工程师,能不能凭我留下的记录复核我的结论」。
知识脉络
与系列及现有篇目的衔接
- 前置:08 不可综合构造识别与存根替换 模拟IP/时钟门控、10 RTL ID 体系 分配规则/层次绑定/稳定性
- 资源背景:29 BRAM 与分布式 RAM、12 BRAM/URAM 设计、32 PLL/MMCM
- 分区衔接:12 多 FPGA 分区算法 割集/容量/图划分
总结
一句话总结:单元替换在 Elaboration 与 RTL ID 之后、分割与综合之前执行,才能按模块名和参数自动匹配实例树上的黑盒、并让替身挂住原 RTL ID;替换库最大一类是存储——成百上千的 SRAM 实例靠 wrapper 规则按宽深选 LUTRAM/BRAM/URAM 并拼条级联,但必须显式对齐同口读写冲突模式、字节使能粒度、初值/X 态、0/1/2 拍延迟和位选写等行为差异,ROM 走 mem 初始化、BIST 口常量化;时钟侧头号规则是 ICG→触发器 CE(test_en 固定功能态),PLL 参数化映射同源 MMCM、内部造钟一律人工确认转 CE,复位释放单元替换为多片可对齐的同步释放模块;IO/PHY/模拟按硬核直连(DDR/PCIe/MGT/LVDS,周期精确)、环回加数字行为模型(协议软件可练、训练与 margin 无效)、外部仪表或仿真器 co-model 三档处理;FIFO/DSP/DFT/电源单元各有标准替身(扫描链不实现、电源折叠常上电);每条规则自带周期精确/功能等价/仅接口替身三级可信度与失真声明,以「匹配谓词+替身+参数映射+owner」的 YAML 规则库工程化,坚持自动匹配但覆盖不了就报错停下、替身对 ASIC 模型周期回归、规则与模型一起版本化;每次替换写台账(原 RTL ID→替身与资源→规则版本→等价等级),阶段 3 汇入 info_table,后续才能把 BRAM/CE 活动正确解释回 SRAM/ICG,保住真实激励反哺 ASIC 签核的整条数据链。