iverilog VCD 波形:$dumpvars 层级控制与大文件瘦身实测
用 Icarus Verilog 做仿真,看波形离不开 VCD(Value Change Dump,值变化转储)文件:testbench 里写一句 $dumpvars,仿真完得到一个 .vcd,丢给 GTKWave 就能逐拍看信号。但设计稍大、仿真稍长,VCD 就膨胀到几百 MB,打开卡、传输慢、磁盘满。其实 iverilog VCD 波形 的大小完全掌握在你手里:$dumpvars 的层级参数加 $dumpoff/$dumpon 的时间窗控制,组合起来能把文件砍掉大半。本文用同一设计、同一激励做真实对比实验,把每个系统任务的用法和瘦身效果用实测数字摆出来。完整编译运行流程见同池的 iverilog 仿真入门,本文专注「dump 怎么控」。
本文要回答的问题
$dumpfile/$dumpvars/$dumpon/$dumpoff/$dumpflush五个系统任务各管什么?$dumpvars(0, tb.dut)和$dumpvars(1, tb)的深度参数到底怎么算?- 同一设计同一激励,全量 dump 和「限定层级 + 跳过预热段」的 VCD 大小差多少?
- 日常调试该按什么清单给 VCD 瘦身,又不丢排错需要的信号?
一、环境与实验设计
代码获取:本实验完整可编译代码(
counter.v、tb_full.v、tb_slim.v)、Makefile 与实测数据见公开仓库 derekzhuo/geek-doc.cn 的experiments/eda-lab-iverilog-vcd-wave/。克隆后make run即可复现。
工具链为 geek-eda:0.1 容器(Icarus Verilog 12.0 stable / Ubuntu 24.04),运行命令:
docker run --rm --user $(id -u):$(id -g) -e HOME=/tmp \
  -v ~/Project/geek-doc.cn/experiments:/work \
  -w /work/eda-lab-iverilog-vcd-wave geek-eda:0.1 make run
被测设计是刻意做成两层层级的小电路 counter.v:顶层 counter_top 是 8 位计数器,内挂 baud_gen 分频子模块,并故意多放几个「仿真可见、看波形很少关心」的内部信号——tick_total、div_cfg、u_baud 里的 cnt_next / hit / cnt。这些就是 VCD 膨胀的来源,也是瘦身要切掉的部分。两个 testbench 跑完全相同的设计和激励(100MHz、20000 拍、同一复位序列),唯一区别在 dump 写法:
| 对比项 | tb_full.v | tb_slim.v |
|---|---|---|
| dump 语句 | $dumpvars;(全层级全信号) | $dumpvars(1, tb_slim);(只 dump TB 顶层 1 层) |
| 时间窗 | 全程记录 | $dumpoff 跳过前 1000 拍预热,$dumpon 恢复 |
| 输出文件 | full.vcd | slim.vcd |
二、五个 dump 系统任务各管什么
| 系统任务 | 作用 | 常用写法 |
|---|---|---|
$dumpfile | 指定 VCD 输出文件名 | $dumpfile("full.vcd"); |
$dumpvars | 选择记录的层级/信号并开始记录 | $dumpvars; 或 $dumpvars(depth, 模块) |
$dumpoff | 暂停记录 | $dumpoff; |
$dumpon | 恢复记录 | $dumpon; |
$dumpflush | 缓冲数据立刻刷盘 | $dumpflush; |
几个容易踩的细节:
- 深度参数:
$dumpvars(0, tb.dut)表示从dut向下所有层(0=无限深);$dumpvars(1, tb)只记录tb这一层,子模块内部不进 VCD。裸$dumpvars;等价于从顶层无限深,即全量。 $dumpfile必须写在$dumpvars之前,否则文件名不生效,新手高频坑。$dumpon恢复时会把选中信号的即时值重写一遍 checkpoint,波形不会断档。$dumpflush在长仿真里实用:仿真还在跑就能先把已产生的 VCD 拖出来看,也能防异常退出丢数据。
三、真实运行:全量 vs 瘦身实测对比
make run 真实输出(节选):
vvp sim_full.vvp
VCD info: dumpfile full.vcd opened for output.
VCD warning: $dumpvars: Package ($unit) is not dumpable with VCD.
FULL DONE count=225
vvp sim_slim.vvp
SLIM DONE count=225
两个 testbench 最终 count 都是 225——激励一致、功能结果一致,变的只有 VCD。make report 实测对比:
| 指标 | full.vcd(全量) | slim.vcd(瘦身) | 变化 |
|---|---|---|---|
文件大小(ls -l) | 1244000 字节 | 863136 字节 | -30.6% |
文件行数(wc -l) | 150081 | 98630 | -34.3% |
声明信号数($var 行) | 21 | 6 | -71.4% |
三行数字各说明一件事:信号数 21 砍到 6 是 $dumpvars(1, tb_slim) 的功劳,dut 和 u_baud 内部共 15 个信号全部不进 VCD;文件大小只降 30.6%,因为 VCD 体积大头是「高频跳变信号 × 时间长度」,时钟 clk 两边都还在,砍低频内部信号收益有限,砍时窗才是大头;行数降幅(34.3%)略大于字节降幅,因为 slim 版剩余跳变以多比特总线为主,单条记录更长。这个小设计只有 21 个信号,绝对值只省约 380KB;但比例关系普适——真实项目内部信号成千上万、时窗以毫秒计,同样手法砍出来的就是数量级差异。VCD 格式细节见 VCD/SAIF 活动率数据格式。
四、产物解读:VCD 内部结构与两张波形图
VCD 是纯文本,分头部定义段($var 声明信号名、位宽、短标识符)和跳变段(#时间戳 + 「新值 标识符」)。full.vcd 真实摘录(make wavecheck 可复现):
$var reg 1 # clk $end          ← clk 在 tb/dut/u_baud 三层各声明一次,共用标识符 #
$var reg 8 . cnt [7:0] $end    ← u_baud 内部信号,slim 版没有这一行
#40000
1$                             ← 40000ps:en 变 1
#45000
b1 . ← 45000ps:u_baud.cnt 变 1每个时间戳下有几行,取决于那一刻有几个被记录的信号在动——被裁掉的信号在每个时间戳下都不再产生记录,所以瘦身效果随时长线性放大。
下面两张波形图的数据来自本次 full.vcd 的真实跳变,不是手绘示意。第一张是复位后最初 240ns 的顶层视角,即 slim.vcd 实际记录的 5 个信号:
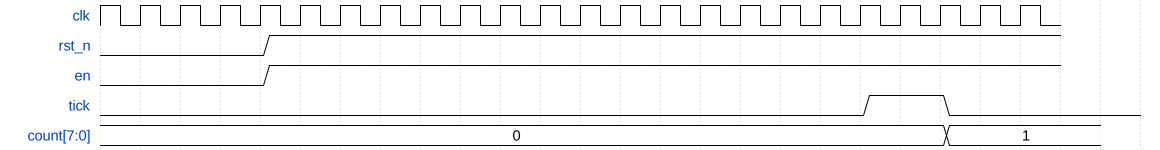
对照 VCD 真实时间戳:rst_n 和 en 在 40ns 同时拉高;baud_gen 的 cnt 每拍加 1,数到 15 时命中,于是 195ns tick 拉高、205ns 拉低,恰好一个时钟;count 在 205ns 的时钟沿从 0 变 1。这就是「瘦身版能看到的全部信息」——顶层行为一目了然,但 cnt 怎么数到 15 的,这里看不见。
第二张图推进 u_baud 内部(这些信号只在 full.vcd 里有),看 150–230ns 的 tick 生成窗口:
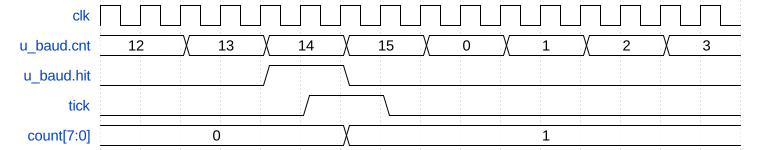
逐沿解读:cnt 在 155–185ns 依次走到 12、13、14、15;cnt >= div(div=15)成立,hit 于 185ns 拉高;195ns cnt 归零、hit 回落,tick 输出一个完整高脉冲;count 在 205ns 加 1。「分频计数 → 命中 → 出 tick → 计数器累加」的因果链只有全量 dump 才看得到。两张图合起来就是层级控制的本质:顶层信号管「对不对」,内部信号管「为什么」——平时回归只留顶层,出问题再打开内部层级重跑。商用调试器(Verdi + FSDB)也是同样思路,见 Verdi 波形调试。
上面两张 wavedrom 是人工转译的精简窗口,日常排错真正面对的是查看器里的全量波形。同一份 full.vcd 用 GTKWave 打开、缩放到复位后的头几微秒,长这样:
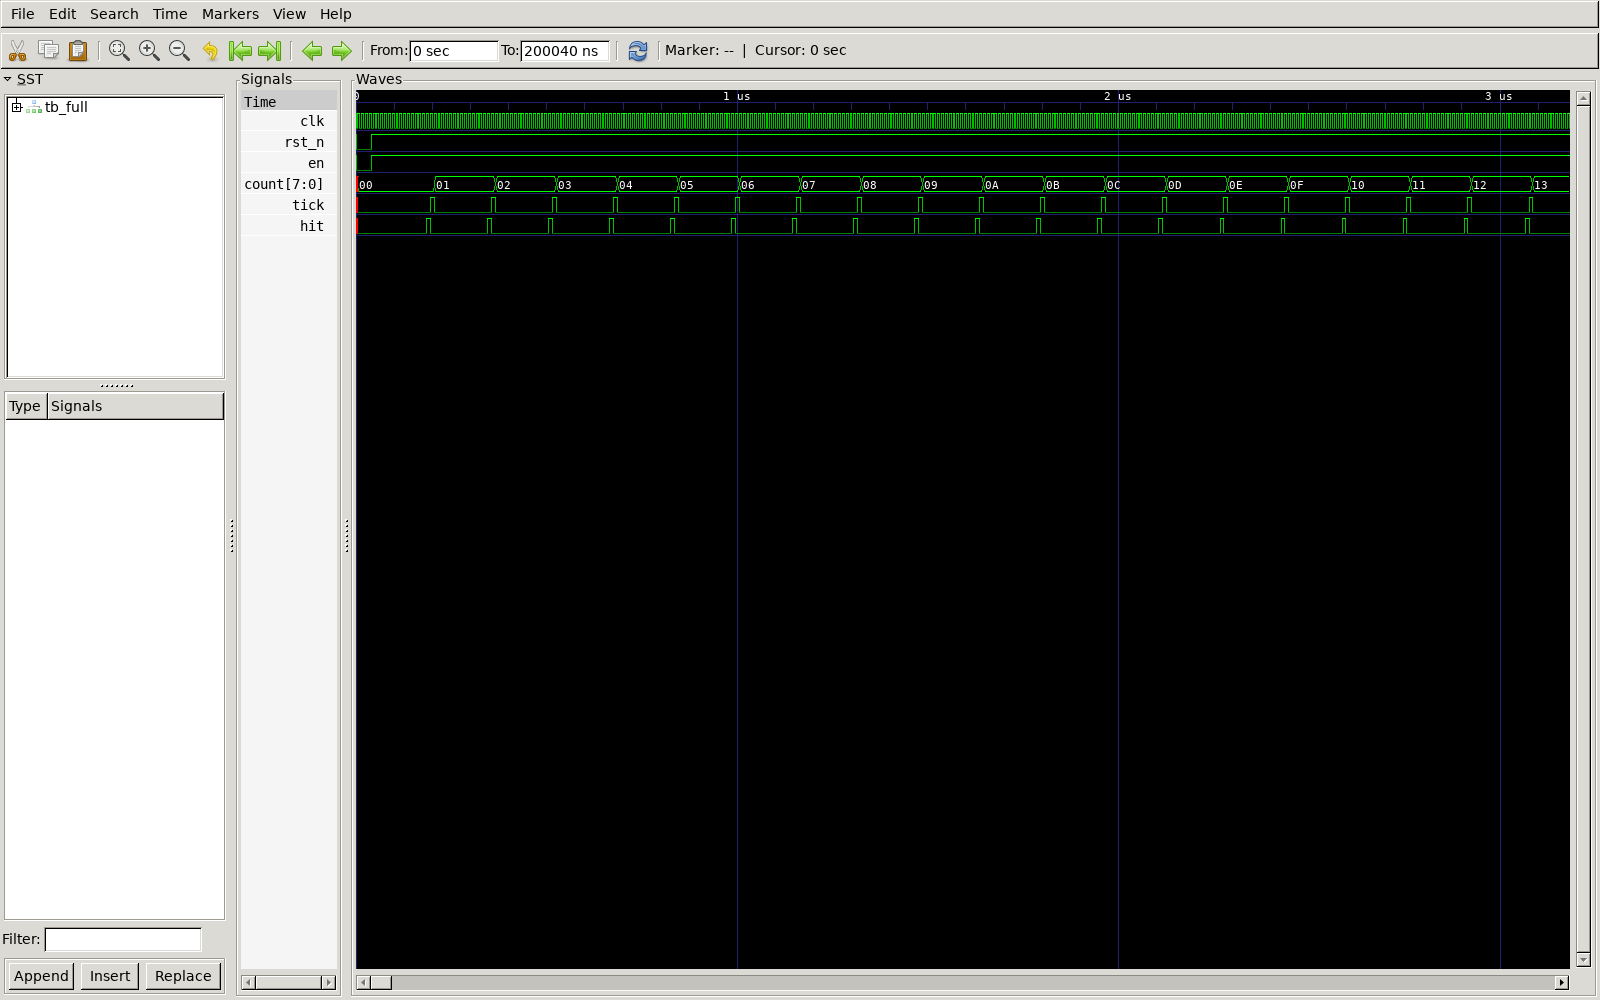
读这张图抓三组对应关系:count[7:0] 总线以十六进制从 00 一路数到 13,每个数值带的右沿都精确落在一个 tick 高脉冲上——这正是「分频命中一拍、计数器加一」在全量视图里的样子;hit 脉冲总是比 tick 早一个时钟出现,因为它在 baud_gen 内部、是 tick 的直接来源,这个「内因一拍超前」的先后关系只在 full.vcd 里可见,slim 版砍掉的正是这一层;最上面密成实带的 clk 则直观解释了为什么 VCD 体积的大头是高频信号——一条时钟的跳变记录比其余五条加起来还多。
五、大文件瘦身实战清单
按收益从大到小排:
- 先砍时窗,再砍信号:
$dumpoff/$dumpon包住复位、初始化等「确定没问题」的段落,收益最直接——真实 SoC 的上电初始化常占一半仿真时间。 $dumpvars永远带深度和模块参数:回归默认$dumpvars(1, tb),失败重跑用$dumpvars(0, tb.dut.u_suspect)只深挖可疑子树。- 用 plusarg 做运行时开关:
if ($test$plusargs("dump")) begin ... end,调试时vvp sim.vvp +dump打开,不改代码重编译;可再做+dumpfull切深度档。 - 层级路径写全写对:
$dumpvars(0, tb.dut.u_baud)里的实例名以 RTL 例化名(u_baud)为准,不是模块名baud_gen;写错会报Unable to find scope或 dump 出空文件。 - 超大设计考虑换格式:FST/FSDB 是压缩二进制,同等信息量小一个数量级;长仿真配
$dumpflush防跑崩丢波形。
六、常见报错与坑
VCD warning: $dumpvars: Package ($unit) is not dumpable:本文实验真实出现。编译单元存在包级作用域,VCD 不支持 dump,无害警告,忽略即可。- VCD 是空的或只有头部:九成是
$dumpvars写在$dumpfile前面,或仿真在刷盘前被杀。检查顺序,必要时显式$dumpflush。 - 看不到 dut 内部信号:不是 bug,是深度参数生效了,调大深度或换
$dumpvars(0, tb.dut)。 - 仿真明显变慢:全量 dump 时每次跳变都写文件,I/O 开销可观,瘦身也省仿真时间。编译语法类错误移步 iverilog 常见报错。
这一篇在知识体系里的位置
本文是 eda-lab 开源工具实操池「波形」主题的第一篇:上游是 iverilog 仿真入门(编译运行与第一个 VCD),下游接 波形查看工具对比(同一个 VCD 用 wavedrom/GTKWave/文本三轨呈现)。与商用知识体系互链:仿真器版图见 仿真器工具链,格式细节见 VCD/SAIF 活动率数据格式,商用波形调试见 Verdi 波形调试。
总结
iverilog VCD 波形的体积由「记录多少信号 × 记录多长时间」决定:用 $dumpvars(深度, 模块) 收窄层级、$dumpoff/$dumpon 跳过无问题时窗、$test$plusargs 做运行时开关,本文实测同一设计下 VCD 从 1244000 字节降到 863136 字节(-30.6%)、信号数从 21 砍到 6,功能结果完全一致。