PPR 内存修复:DDR Post Package Repair 的 hPPR/sPPR 流程与系统 RAS 联动
承 memory-ras-ecc-patrol-scrub 对 ECC 与巡检擦洗的介绍,以及 machine-check-architecture-ras 对整机 RAS 框架的梳理。ECC 能纠正单比特错误,Patrol Scrub 能及时发现它们,但当某一行反复出错、错到 ECC 都快兜不住时,就需要更重的手段——把这行物理换掉。这就是 PPR 内存修复(Post Package Repair,封装后修复)要解决的问题:DRAM 颗粒里预留了备用行,运行时可以把失效行重映射过去,让一根「有坏点」的 DIMM 继续服役而不是直接报废。
本文要回答的问题
- PPR 内存修复到底是什么?它和 ECC、Patrol Scrub 在 RAS 防线里各站哪一班岗?
- hPPR(硬修复)和 sPPR(软修复)的流程差在哪?各自要付出什么代价?
- 一条 DIMM 上有多少修复资源?用完了会怎样?
- PPR 触发时系统要做什么配合?为什么说「正在修复」是内存子系统的一个特殊状态?
- 在 Linux 上怎么观测 PPR 事件?运维上应该盯哪些信号?
一、RAS 防线上的第四班岗
内存子系统的可靠性是一个分层递进的防御体系,PPR 内存修复位于比较靠后的位置——前面几层都兜不住、或者兜得太吃力时才轮到它。
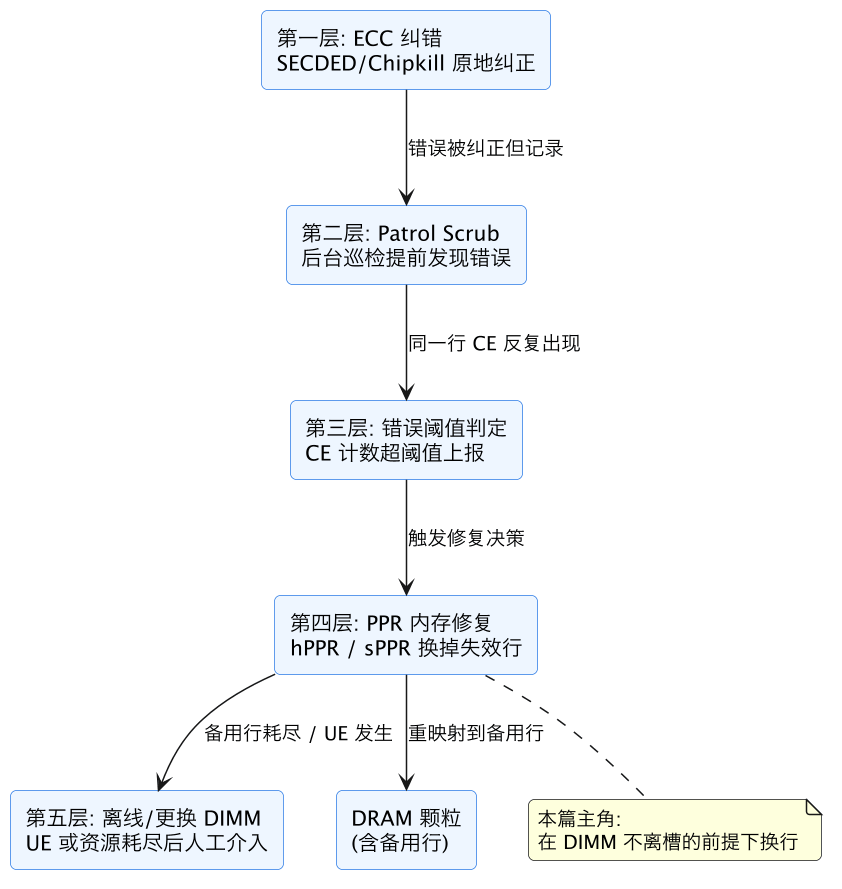
这张图把五层防线串起来看:ECC 是「每秒都在发生」的无感纠正;Patrol Scrub 是主动翻检,趁错误还没攒成多比特就先纠掉;当某一行在短时间内反复产生可纠正错误(CE,Correctable Error),内存控制器的阈值逻辑会判定「这行是硬伤不是瞬时干扰」,把决策交给 PPR。PPR 把失效行的地址重映射到颗粒内部的备用行(spare row),之后所有访问透明地落到新行上——上层软件完全无感,地址还是原来那个地址。只有当备用行耗尽、或者错误已经恶化成不可纠正错误(UE,Uncorrectable Error)时,才走到第五层:标记 DIMM、告警、择机更换。
理解这个递进关系很重要:PPR 不是「修好了内存」,而是「把一处确定的物理损伤隔离掉」。颗粒的退化往往是持续的,一个 rank 上触发过 PPR,往往意味着这个 rank 的整体健康度已经在下坡路上。
二、hPPR 与 sPPR:一次修复的两条路径
JEDEC 从 DDR4 开始标准化了 PPR,定义了两种模式,核心区别在于重映射信息是否持久化。
hPPR(hard PPR,硬修复) 是永久性的。内存控制器向 DRAM 发出 hPPR 命令序列后,颗粒内部通过熔丝(electrical fuse)烧制,把失效行地址写进非易失的修复寄存器。这个过程一旦完成就不可撤销,颗粒每次上电初始化时自动加载修复映射——重启、掉电都不影响。代价是:备用行烧一行少一行,每个 bank group 的备用资源极其有限(DDR4 典型是每个 bank group 1 行备用),烧完这个 bank group 就再也没有硬修复能力了。
sPPR(soft PPR,软修复) 是临时性的。修复映射只存在于 DRAM 的易失寄存器里,重启即失效。它的价值在于「先顶住」:半夜三点某行开始狂报 CE,值班不可能立刻停机换 DIMM,sPPR 几秒钟内把行换掉,系统继续跑;等下一个维护窗口再决定是做 hPPR 永久固化,还是直接换条。DDR5 还强化了 sPPR 的语义,允许更细粒度的管理。
两条路径的命令流程对比:
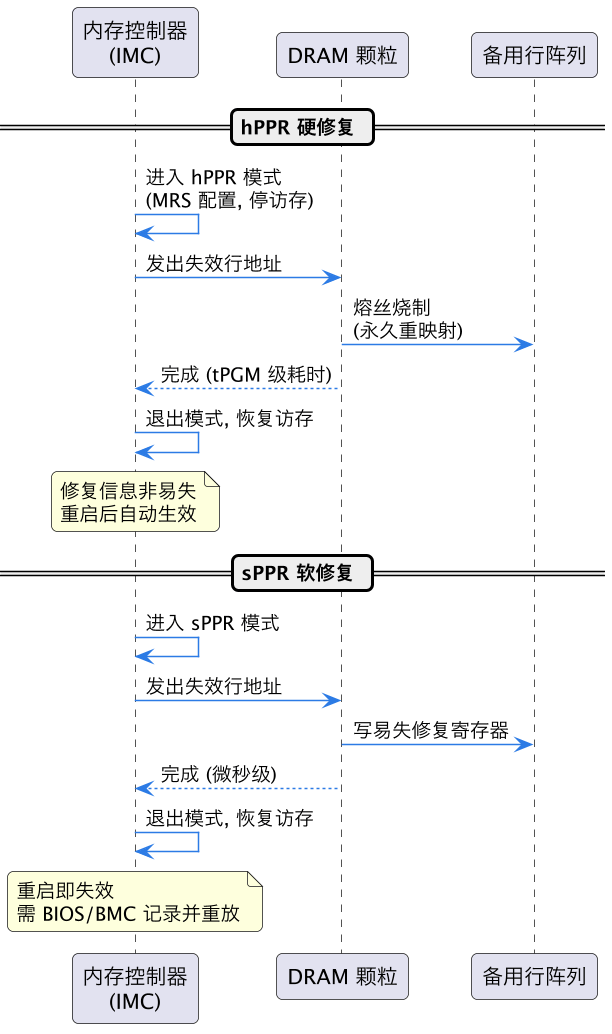
这张图有两个要点。其一,无论软硬,修复期间目标 bank group 的访存必须暂停——hPPR 因为涉及熔丝烧制,耗时在毫秒级(tPGM,编程时间),这段时间该 rank 不能服务请求;sPPR 快得多,但也不是零成本。其二,sPPR 的「重启即失效」带来一个工程要求:固件(BIOS/BMC)必须把软修复记录存到自己的闪存里,下次开机时重放,否则重启后坏行又暴露了。这也是各家服务器厂商实现差异最大的地方——JEDEC 只定义了 DRAM 侧的命令,「谁来记、记在哪、什么时候重放」全是平台自己的事。
三、修复资源有多稀缺
PPR 内存修复不是无限弹药。DDR4 颗粒的备用行按 bank group 分配,典型配置是每个 bank group 只有 1 条备用行。一颗 x4 颗粒有 4 个 bank group,也就是说整颗颗粒只能硬修复 4 行。DDR5 稍有改善,但量级没变——这是以「行」为单位的急救,不是以「页」为单位的翻新。
| 维度 | hPPR 硬修复 | sPPR 软修复 |
|---|---|---|
| 持久性 | 永久(熔丝烧制) | 易失(重启失效) |
| 耗时 | 毫秒级(tPGM) | 微秒级 |
| 资源消耗 | 烧一条少一条,不可逆 | 不占永久资源,可反复 |
| 可撤销性 | 不可撤销 | 清除寄存器即恢复 |
| 重启处理 | 自动生效 | 需固件记录并重放 |
| 典型用途 | 确认的永久损伤 | 应急顶住、待观察的疑似损伤 |
这张表背后是平台厂商的通用策略:先 sPPR 试探,确认是永久损伤再 hPPR 固化。因为一行反复出错也可能是插槽接触不良、信号完整性抖动这类「假性硬伤」——直接烧熔丝就浪费了不可再生资源。Intel 平台的实现里,这个「先试后烧」的策略由内存控制器的 Patrol Scrub 引擎和固件协同完成;AMD 平台也有类似的 DRAM repair 机制,命名略有差异。
修复期间的系统状态也值得单独看一眼:
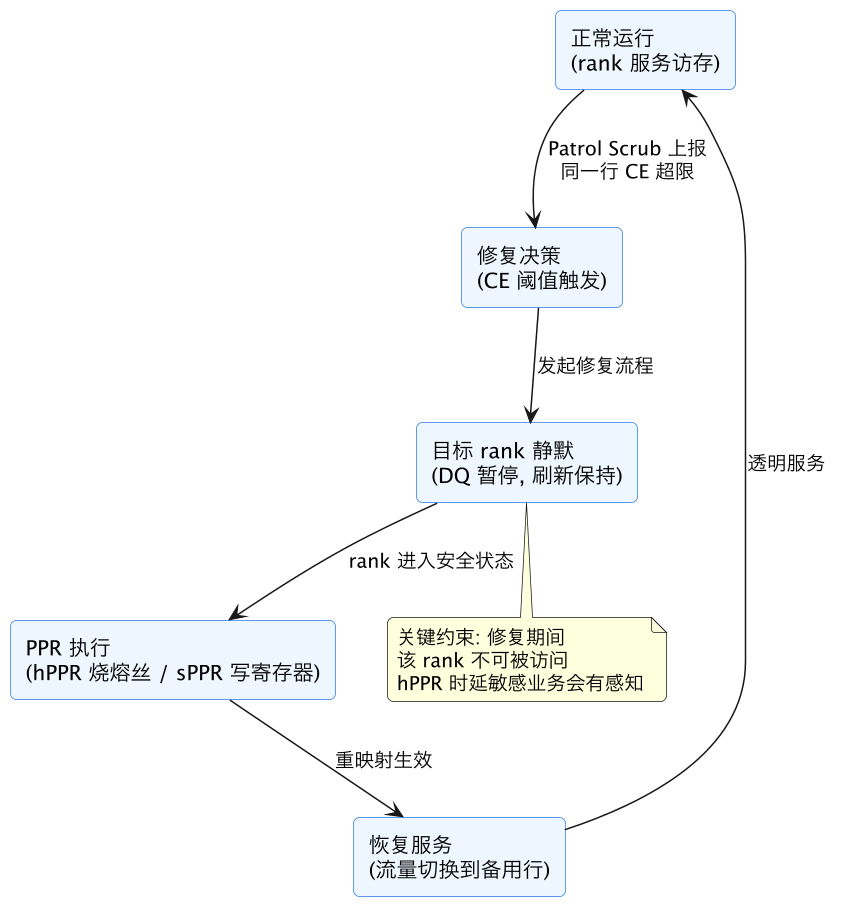
从这张状态图能看清「修复时刻」系统的处境:进入修复前要把目标 rank 静默下来(队列排空、刷新照发、DQ 暂停传输),修复完成后流量透明切换到备用行。对业务来说,sPPR 几乎无感,hPPR 的毫秒级停顿在延迟敏感场景(比如内存数据库的尾延迟)上可能表现为一根毛刺。这也是为什么有些平台允许管理员通过 BIOS 选项或 BMC 命令手动调度 hPPR——把它挪到业务低谷执行。
四、DDR4 与 DDR5 的实现差异
PPR 内存修复在两代 DDR 之间的演进,方向是「修复更频繁、粒度更细、对业务更友好」。背后原因很现实:DDR5 单颗粒容量更大、速率更高、工作电压更低,行级缺陷的暴露概率在上升,修复机制必须从「偶尔用一次的救命招」变成「常规保养手段」。
| 维度 | DDR4 | DDR5 |
|---|---|---|
| 标准化版本 | JEDEC DDR4 起引入 hPPR/sPPR | 语义扩展,sPPR 地位提升 |
| 修复粒度 | 整行替换 | 整行替换,但管理更灵活 |
| 触发时机 | 多依赖固件/平台策略 | 支持更主动的在线修复 |
| sPPR 资源 | 与 hPPR 共用 spare 行管理 | 调度更细,先软后硬策略更普遍 |
| 与刷新交互 | 修复需避开刷新窗口 | 配合 refresh management 协调更好 |
| 典型平台 | Intel Xeon SP 全系、AMD EPYC | Granite Rapids、Turin 起的新平台 |
DDR5 时代还有一个背景变化:片上 ECC(on-die ECC)成为标配——颗粒内部自己先纠一遍单比特错,再往链路 ECC 报送。这意味着「CE 计数」的语义变了:链路侧看到的 CE 是片上 ECC 没兜住的部分,真正颗粒内部的退化被吃掉了一层。运维上做趋势分析时,DDR5 平台的 CE 率不能直接和 DDR4 的老数据横比,阈值也要重新标定。
hPPR 烧熔丝的物理过程也值得多说一句:熔丝是颗粒里的一次性可编程单元,烧制时要给编程引脚加高于工作电压的脉冲,把选定的熔丝单元物理熔断。DRAM 收到 hPPR 命令序列(MRS 进入模式 → 地址送达 → 编程脉冲 → 退出)后内部自动完成这一切,控制器要做的只是守住时序、保证期间没人来访问。tPGM 的毫秒量级就是这么来的——不是传输慢,是熔断本身要时间稳定。
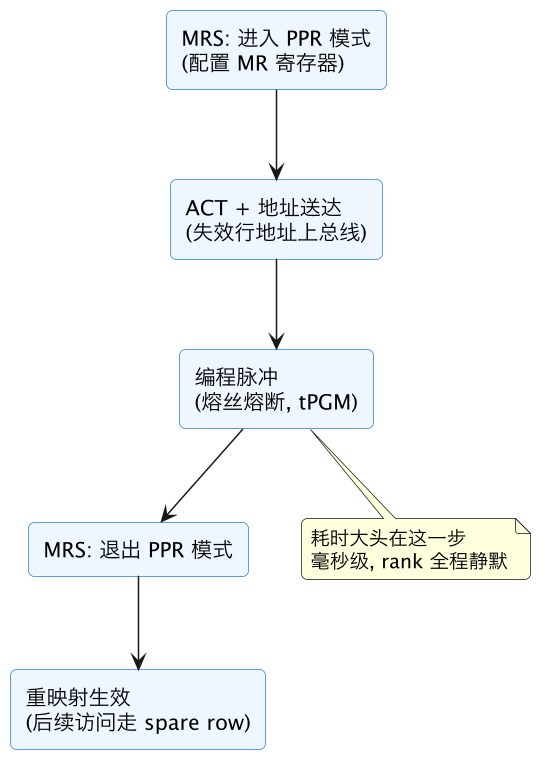
这张流程图把 hPPR 的命令序列拆成五步,毫秒级开销集中在编程脉冲那一步。对照第二节的软硬对比可以看清:sPPR 省掉的恰恰是最贵的第三步,所以它快;而第三步一旦做完就物理不可回退,所以 hPPR 才需要「先软后硬」的谨慎策略。
五、PPR 与系统 RAS 的联动
PPR 内存修复从来不是孤立事件,它嵌在整个 RAS 报告链里。一次典型的联动路径是这样的:
- Patrol Scrub 发现:巡检引擎读到某行,ECC 纠出单比特错,记录 CE 并把物理地址(socket/channel/DIMM/rank/bank/row)上报。
- 阈值判定:固件或内存控制器的泄漏检测逻辑跟踪同一地址的 CE 频率。DDR 颗粒的瞬时错误(alpha 粒子、宇宙射线)是随机的,同一行短时间反复出错几乎必然是硬损伤。
- 触发修复:平台策略决定 sPPR 还是直接 hPPR,执行重映射。
- 事件上报:通过 MCA(Machine Check Architecture,见 machine-check-architecture-ras)或平台专用通道,把「PPR 已执行、修复了哪个地址、用的是软还是硬」报给操作系统和 BMC。
- 后续跟踪:修复后的行不再报错,但固件会持续盯这个 rank 的其他行——备用资源消耗情况进入 DIMM 健康档案,作为「是否建议更换」的依据。
这个链条里还有一个容易忽略的邻居:错误注入与 poison 消费。如果 PPR 还没来得及执行,一个 UE 已经被消费了(CPU 真把坏数据拿去算了),就走上了 ras-poison-consumption-flow 描述的数据毒化传播路径——那是另一条更凶险的故事线,PPR 的意义恰恰是尽量不让事态走到那一步。
把联动关系画成一张结构图:
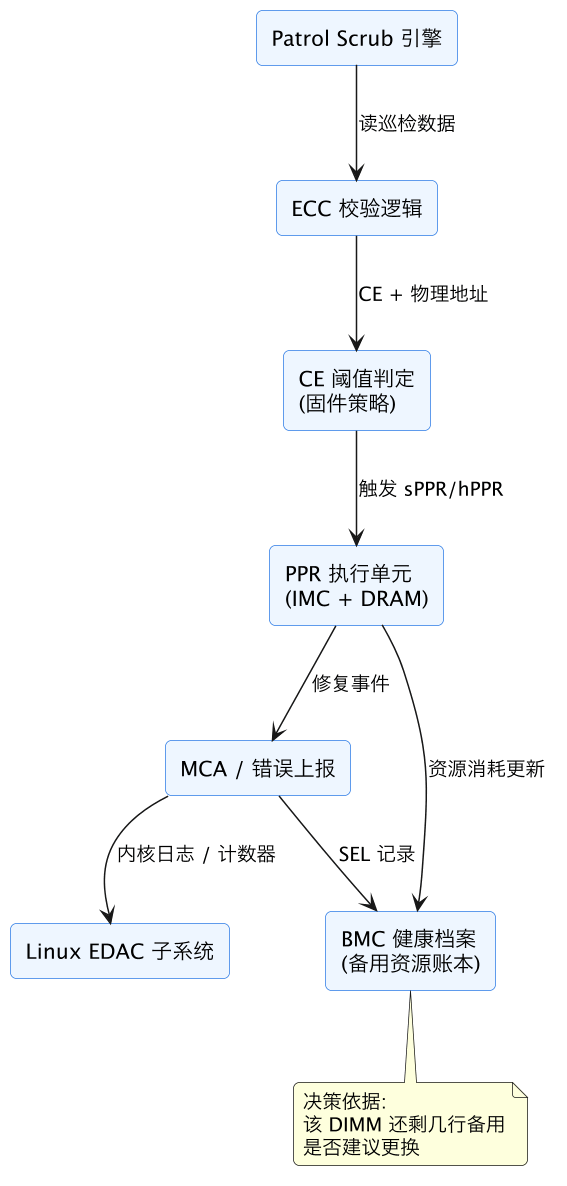
这张图的核心信息:PPR 的每个动作都会沉淀成两条数据——一条进操作系统(EDAC 日志),一条进 BMC 的 SEL(System Event Log)和健康档案。运维要回答「这根条子还能撑多久」,靠的就是 BMC 侧那本备用资源账。
六、Linux 观测与运维信号
在 Linux 上,PPR 相关事件的可见性取决于平台固件往 OS 暴露了多少。常规能看到的:
# EDAC 计数与事件
edac-util --report=full
grep -i edac /var/log/messages | tail -20

# rasdaemon 持续采集(推荐生产部署)
rasdaemon --enable --record
ras-mc-ctl --summary
ras-mc-ctl --errors
典型的 PPR 事件日志会长这样(具体格式随平台而异):
mce: [Hardware Error]: Memory PPR executed: soft repair,
  socket 0 channel 1 dimm 0 rank 1 bank 12 row 0x3a7f2
EDAC MC0: 1 CE memory read error on DIMM0 (before PPR)
运维上值得盯的信号,按优先级排:
- PPR 事件本身——一次 sPPR 是「黄牌」,密切观察;同 DIMM 短期内多次 PPR 或 hPPR 资源耗尽是「红牌」,排期更换。
- 修复前后的 CE 速率——修复后 CE 应该立刻归零。如果换了个行继续涨,说明损伤在扩散(颗粒级退化),不是单行问题。
- BMC 侧的备用资源余量——
ipmitool sel elist或厂商 Redfish 接口能查到每根 DIMM 的修复历史,备件采购和更换窗口按这个排。 - hPPR 执行时刻的延迟毛刺——对尾延迟敏感的业务,在 APM 里关联 PPR 时间戳和延迟尖峰,避免把硬件事件当成应用回归去排查。
另外一个实战提醒:云主机里这些事件大多被宿主机屏蔽了,你看到的最多是「实例被热迁移」或一封维护通知——那往往就是宿主机做完 PPR 之后的手笔。裸金属和自建机房才把整条链路握在自己手里。
最后补一个容量视角:一台双路 32 槽的机器,把 BMC 里所有 DIMM 的 PPR 历史按月拉出来画趋势线,通常能提前两到三个月看出哪台机器的内存健康在加速退化。把这个趋势接入容量管理系统,备件到货周期、更换窗口排期都能从容安排——这是把 PPR 从「被动响应」用成「主动运维」的关键一步。
这一篇在知识体系里的位置
本篇是 RAS 子系列的「修复层」,前置阅读是 memory-ras-ecc-patrol-scrub(纠错与巡检)与 machine-check-architecture-ras(错误上报框架);PPR 失败后的毒化传播见 ras-poison-consumption-flow;DRAM 颗粒内部组织(bank/bank group/row 的概念)见 dram-subsystem-organization;刷新与修复的时序交互见 dram-refresh-management。
总结
PPR 内存修复是 DDR4/DDR5 给「出厂后坏行」准备的最后一道就地手段:hPPR 用熔丝永久烧制重映射、不可逆但重启无忧,sPPR 写易失寄存器、微秒级应急但需固件重放;每个 bank group 的备用行屈指可数,所以平台策略一律「先软后硬」;它与 ECC、Patrol Scrub、MCA/EDAC 构成完整防线——PPR 事件本身就是 DIMM 健康度的风向标,修复一两次是黄牌,资源耗尽就是换条的最后通牒。