PMU 编程:性能计数器的事件选择、采样溢出与 perf 后端全解
更新时间:2026-10-02。CPU 微架构总览 里说过,现代处理器是一头「看不见的怪兽」——乱序、投机、多级缓存,跑得好不好从外面根本看不出来。PMU(Performance Monitoring Unit,性能监测单元)就是芯片设计师留给外界的一扇窗:一组可编程的硬件计数器,能数指令数、缓存未命中、分支误预测、流水线停顿周期,几乎覆盖微架构的每个角落。工具侧的 perf stat 硬件计数器 和 perf record 采样 大家天天用,但「敲一行命令」到「硅片上的计数器跳了一下」之间隔着一整条编程链路:事件编码、MSR 配置、溢出中断、采样缓冲、内核抽象。这一篇就把这条链路逐段拆开,讲清 PMU 编程的硬件接口和 Linux perf 后端。它是 PMU 性能计数器 概念篇的深水续集,也是理解 采样偏差 skid 与 PEBS 的地基。
本文要回答的问题
- PMU 里的固定功能计数器和可编程计数器有什么区别,各自怎么数?
- 一个 perf 事件名(如
cache-misses)是怎么变成 MSR 寄存器里的位模式的? - 计数器溢出之后发生了什么——中断怎么触发、采样记录怎么进 ring buffer?
- 采样为什么有 skid,PEBS/IBS 这类精确采样硬件做了什么?
- Linux perf 子系统在多路复用、每核与每线程计数上做了哪些包装?
一、PMU 的硬件形态:两种计数器和一组 MSR
PMU 在物理上就是核内的一组寄存器,分两类。
第一类是固定功能计数器(fixed-function counters)。芯片设计师把「大家永远关心的几件事」焊死成专用计数器:Intel 上是三条——已退休指令数(instructions retired)、非停机核周期(core cycles)、参考周期(reference cycles)。它们不需要选事件,使能位一置就开始数,开销和配置都最省。
第二类是可编程计数器(general-purpose counters),一般每核 4-8 个(开超线程时每逻辑核减半)。每个可编程计数器成对出现:一个事件选择寄存器(IA32_PERFEVTSELx,决定数什么)加一个数据寄存器(IA32_PMCx,48 位,存计数值)。数 L1D 未命中还是分支误预测,全看你往 PERFEVTSEL 里写什么事件编码。
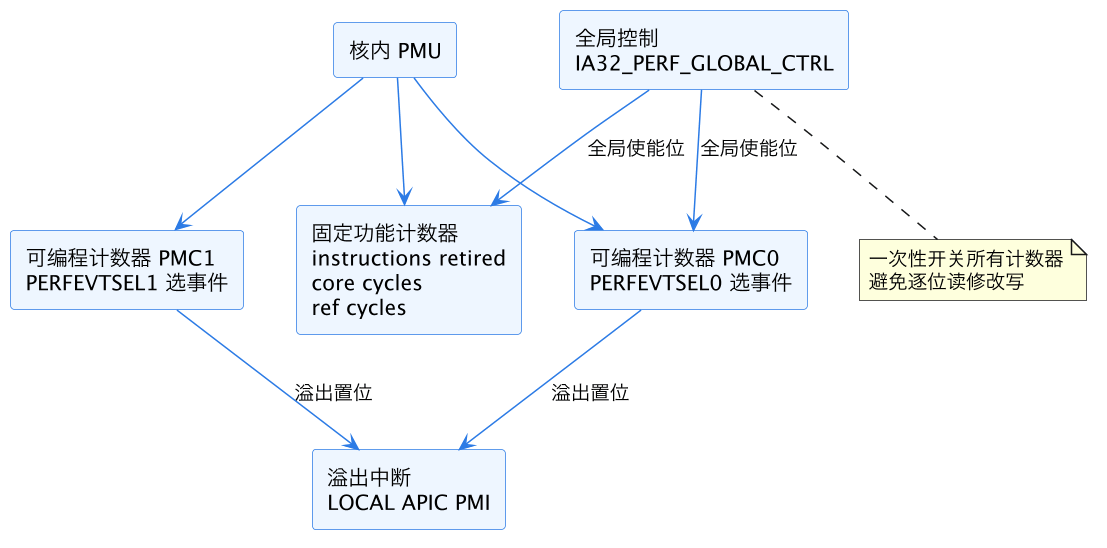
上图是一个核的 PMU 轮廓。全局控制寄存器(IA32_PERF_GLOBAL_CTRL)是总闸:每一位对应一个计数器的使能,内核在上下文切换时用它一次开关整组计数器,比逐个写 PERFEVTSEL 的 EN 位快得多。溢出路径通向本地 APIC,产生 PMI(Performance Monitoring Interrupt),这是后面采样机制的扳机。
事件选择的位布局值得细看。PERFEVTSEL 里关键的字段有:Event Select(8 位事件号)+ UMASK(8 位单元掩码,细化事件语义)+ USR/OS(只在用户态/内核态计数)+ EN(使能)+ INT(溢出时是否发中断)。「数什么」完全由 Event Select + UMASK 这对组合决定——这就是下一节的主题。
二、事件编码:从 cache-misses 到 0xD1/0x04
架构文档里每个事件有一个编号,比如 Intel 的 MEM_LOAD_RETIRED.L1_MISS 事件号是 0xD1、UMASK 是 0x04。内核和硬件打交道时,最终就是把这个 16 位组合写进 PERFEVTSEL 的低 16 位。但没人愿意背十六进制,所以生态里分了三层命名。
第一层是架构预定义事件(architectural events)。Intel 承诺跨代保持语义的七件事:未停机周期、退休指令、LLC 引用、LLC 未命中、分支指令、分支误预测、总线周期。perf 里的 cycles、instructions、cache-references、cache-misses 这些通用名就映射到它们。语义稳定,但粒度粗——cache-misses 只告诉你 LLC 未命中总数,分不出读/写/预取。
第二层是原始事件编码(raw events)。perf 接受 rNNNN 语法,NNNN 就是 UMASK 和事件号的拼接。想数 L1D 被驱逐的脏行这种冷门事件,查 SDM(Intel 软件开发者手册)卷 3 的性能事件附录,拼出原始编码直接喂给 perf。威力最大,可移植性最差——下一代微架构可能整个事件族都改了。
第三层是厂商事件表。内核树里的 pmu-events 数据库(来自 Intel 的 JSON 事件表)给每个微架构维护了一份全量事件清单,perf list 列出的几百个事件、Topdown 的 retiring/bad_speculation 指标,都是从这张表翻译来的。Linux 的 perf events 体系 把这三层统一在 perf_event_attr 的 config 字段里:低 7 位是事件类型(硬件/软件/缓存/原始),类型为原始时高位直接塞 UMASK 和事件号。
事件表有两个常被忽略的细节。其一,同一个逻辑事件在不同微架构上编码完全不同,语义也会有微妙漂移:混合架构(如 P 核加 E 核)上两个核族各有一份 PMU 事件表,perf 用 cpu_core/、cpu_atom/ 这样的 PMU 前缀区分,事件在哪类核上计数取决于线程当时被调度到哪里;做跨机型对比前先确认编码和语义一致,否则两边数字可能根本不是一回事。其二,offcore 响应类事件是「特快车」:它们要额外配一个专用 MSR 来指定响应类型(本地 DRAM、远程节点、监听命中等),编码长度超过普通的 16 位组合,perf 里以事件参数形式传入,是原始编码都盖不住的特殊路径。
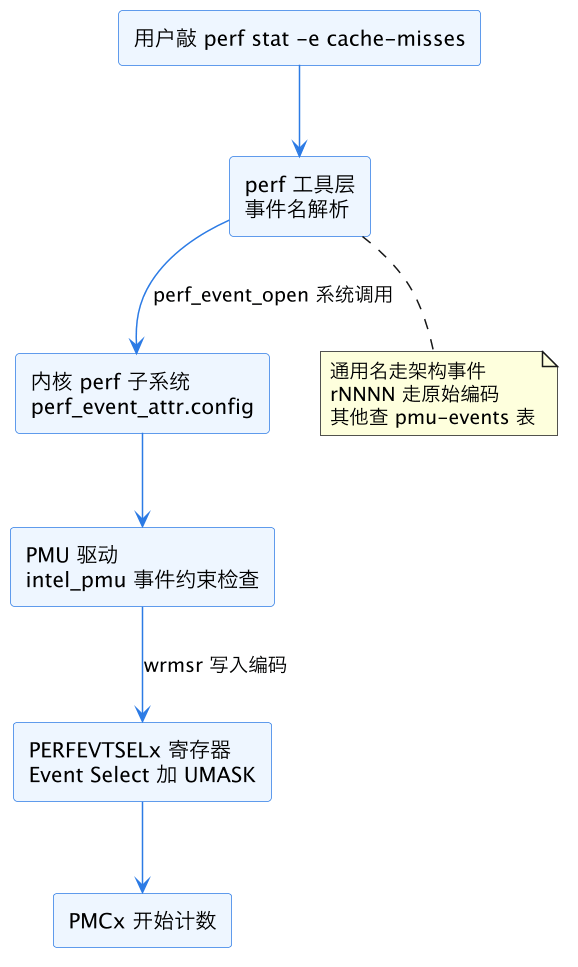
上图是从命令行到寄存器的翻译链。注意中间那道「事件约束检查」:不是所有事件都能放在所有计数器上,有些事件只能用 PMC0-PMC3,有些要求特定 UMASK 组合,Hyper-Threading 下计数器还要在两个逻辑核间分配。驱动发现约束冲突时会拒绝调度该事件——这就是 perf stat 输出里偶尔出现 <not supported> 的原因。
三、从计数到采样:溢出中断与 ring buffer
纯计数(perf stat 模式)只需开始和结束各读一次 PMC 做减法。采样(perf record 模式)则是一条更复杂的链路,PMU 编程的精髓大半在这里。
采样的基本思路是「倒数触发」:往 PMC 里写一个负的初值(比如 -100000),计数器从负数往上加,每数一个事件就离零近一步,数满 100000 次正好翻正——这叫溢出。溢出瞬间硬件做三件事:把全局状态寄存器(IA32_PERF_GLOBAL_STATUS)里对应计数器的溢出位置位;通过本地 APIC 发出 PMI 中断;如果 OS 位允许,把指令指针等现场信息留给处理程序。
CPU 收到 PMI 后跳进内核的 NMI(不可屏蔽中断)处理路径:先确认是 PMU 溢出(而不是其他 NMI 源),再遍历计数器找出溢出的那个,读出当前 RIP、寄存器、调用栈,组装成一条采样记录写进该事件的 mmap ring buffer,最后把计数器重载回负初值、清溢出位、从中断返回。用户态的 perf 工具轮询 ring buffer,把记录解析成符号。
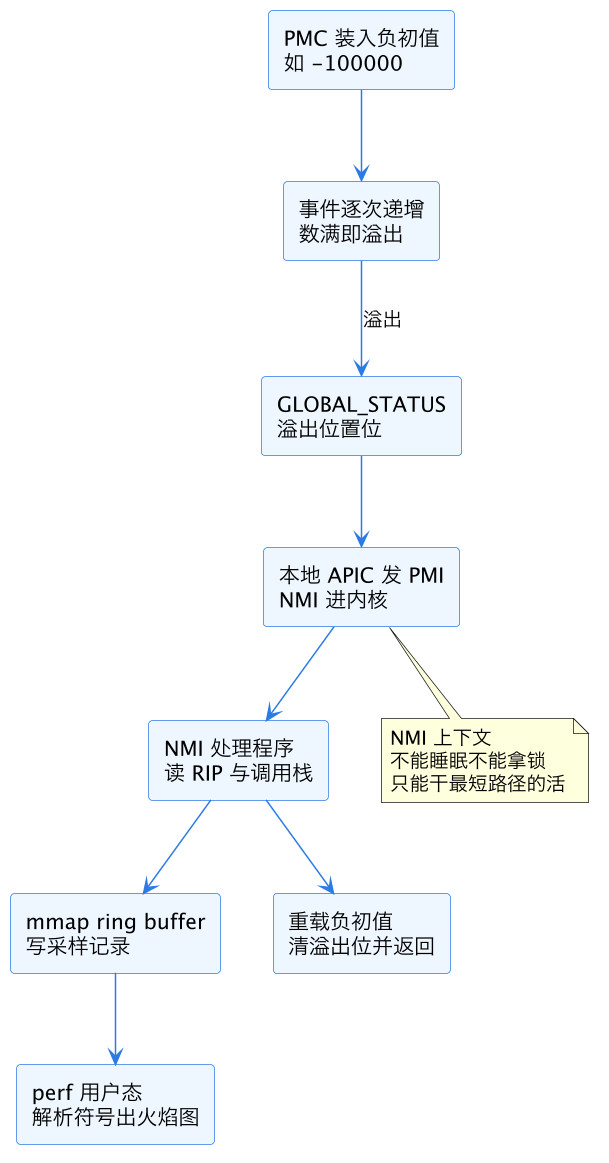
上图是采样的完整生命周期。两个细节决定了这条链路的性格。其一,采样周期是动态的:perf 默认按频率采样(如 99Hz,即 perf record -F 99),内核用一个校准循环把「每秒 99 次」换算成「每次溢出多少事件」,计数器跑得快就把周期拉长,跑得慢就缩短——频率上限故意取质数是为了避开和程序周期性行为的共振。其二,NMI 上下文极其受限:不能睡眠、不能拿可能竞争的锁,所以解析、符号化、写磁盘全都推给用户态,NMI 里只做「抓现场 + 塞 ring buffer」这一小段,几百纳秒内必须完事。
溢出本身也要花周期,这就是采样开销的来源。频率 999Hz 和 99Hz 的开销能差好几倍;而硬件加速(下一节的 PEBS)正是为了把这段成本从 NMI 路径里搬走。
四、skid 与精确采样:PEBS 为什么准
PMI 采样有个先天缺陷:溢出发生到 NMI 处理程序读出 RIP,中间隔着中断响应、流水线冲刷、乱序核里几十上百条在飞指令,读到的 RIP 往往已经跑偏了好几条指令。这个偏差叫 skid(打滑)。后果很实际:perf record 说热点在某条指令上,真正烧周期的可能是它前后几条——在微架构分析里,几条指令的归属错误足以让你优化错对象。这个话题的展开见 采样偏差 skid 与 PEBS,这里只讲硬件侧的机制。
PEBS(Processor Event Based Sampling,基于事件的处理器采样)的思路是:不等中断,溢出瞬间由硬件自己把现场快照写进一块预先配好的内存缓冲(PEBS buffer)。快照内容包括 RIP、通用寄存器,以及关键的一句——事件触发的那条指令本身的地址(不是中断到达时的 PC)。等缓冲区快满了才发一次中断,内核批量收割记录。这样 skid 归零,中断次数还降了一个量级。
PEBS 还带来计数器做不到的副产品:数据地址采样。MEM_LOAD_RETIRED.L3_MISS 类事件的 PEBS 记录里带被访问的线性地址和数据源信息(命中 L1/L2/L3/远程节点),perf 的 mem 模式和 perf c2c 伪共享检测 全靠它。AMD 侧的对应物叫 IBS(Instruction Based Sampling),ARM 有 SPE(Statistical Profiling Extension),思路同构。
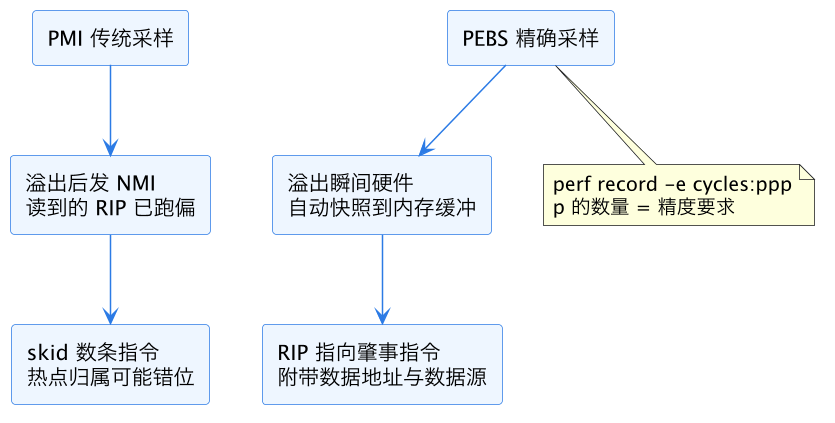
上图对比两条路径。perf 事件名后的 :p 修饰符就是精度档位:一个 p 是尽力消 skid,两个 p 要求 skid 尽量小,三个 p 强制必须精确(硬件不支持 PEBS 时事件直接创建失败)。做指令级归因、内存访问分析时,:ppp 和 mem-loads/mem-stores 这组 PEBS 事件是标配。
五、Linux perf 后端:perf_event_open 与多路复用
硬件只有 4-8 个可编程计数器,用户却可能同时丢给它几十个事件,这个矛盾由内核 perf 子系统消化,入口是唯一的系统调用 perf_event_open。理解它的几个关键参数,PMU 编程的另一半就通了。
perf_event_attr 里最要紧的字段:type 和 config 决定数什么(第二节的三层编码都落在这里);sample_period 或 sample_freq 决定采样模式;disabled 决定创建后是否立即开数;exclude_user/exclude_kernel/exclude_hv 控制计数域。系统调用的 pid 和 cpu 两个参数定义了计数范围:pid=进程, cpu=-1 是跟线程计数(线程被调度到哪个核,事件就迁移到哪个核);pid=-1, cpu=N 是每核系统级计数(需要 root 或放开 paranoid 设置)。返回值是一个文件描述符,read() 读计数值,mmap() 拿采样 ring buffer,ioctl(PERF_EVENT_IOC_ENABLE) 开关——perf 命令行的一切都是这套原语的组合。
多路复用(multiplexing)是核心机制。当事件组里的事件多于物理计数器,内核给它们分时:每毫秒级的 tick 里轮换驻留计数器,每个事件只在自己的时间片里真实计数。读数时内核按 time_running/time_enabled 比例外推。这就是为什么事件开太多时 perf stat 末尾会多出一行 (83.33%)——那个百分比就是 time_running 占比,外推值的可信度随它下降。perf stat 指标深入 里反复强调的「事件分组不要超过计数器数量」,根源就在这里。
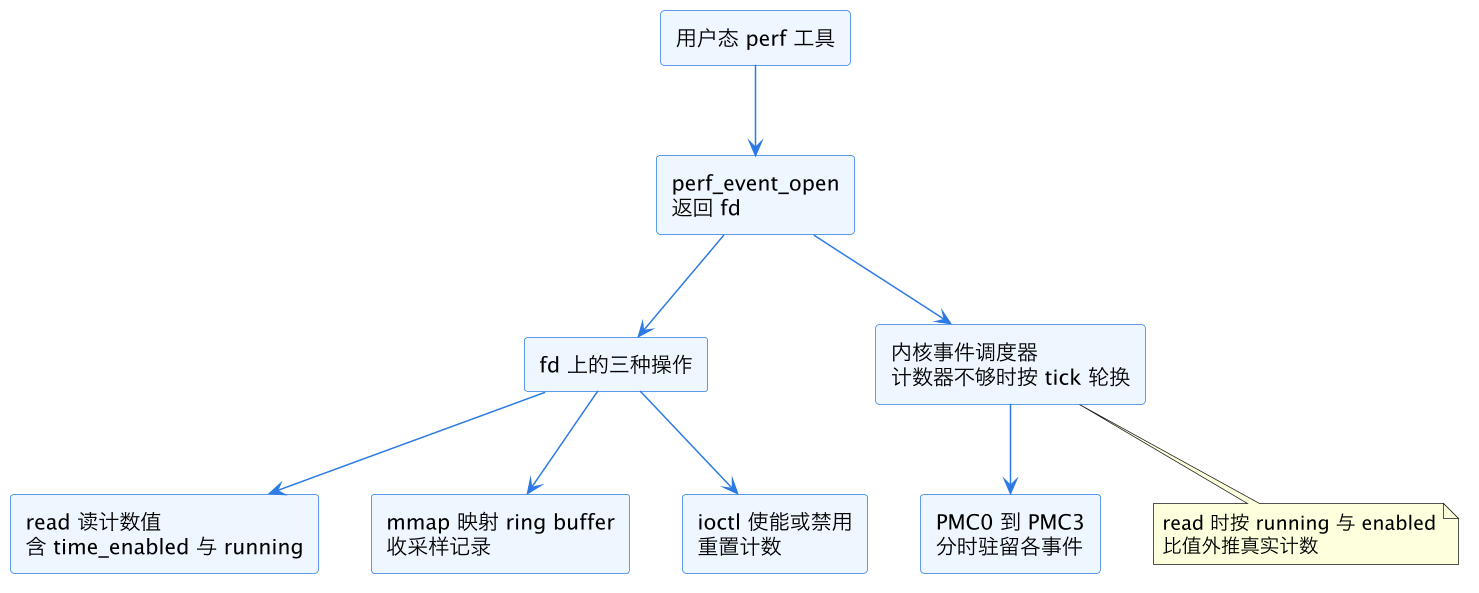
上图是 perf 后端的接口全貌。再补两个工程上经常踩的点。一是事件组:把多个事件放在同一个 group(创建时用 group_fd 关联)可以保证它们同进同出、用同一批计数器驻留,time_running 一致,算 IPC、缓存命中率这类比值时分子分母才是同一时间窗——这是 Top-down CPI 分析 拿到可靠比率的前提。二是安全性:/proc/sys/kernel/perf_event_paranoid 控制着非特权用户能做什么,默认值收紧后普通用户只能数自己进程的用户态事件,想数内核态或做系统级每核采样得调低到 1 或 0——性能环境搭建的第一步通常就是它。
最后把计数语义和微架构知识接起来:PMC 数的「cycles」是非停机核周期,频率随 DVFS 波动(见 C-state 与 P-state);「instructions retired」以退休为准,投机执行掉的指令不计(投机的代价见 分支预测);端口压力类事件要和 执行端口争用 对照着读。PMU 数字本身没有结论,结论来自你对被测微架构行为的假设。
这一篇在知识体系里的位置
本篇是微架构模块里「可观测性」方向的核心篇:上游概念是 PMU 性能计数器 与 CPU 微架构总览;同线深入的是 采样偏差 skid 与 PEBS 和 perf events 体系;下游工具侧落到 perf stat 硬件计数器、perf record 与火焰图、perf stat 指标深入,方法论出口是 Top-down CPI 栈的应用。
总结
PMU 编程的本质是「用事件号加 UMASK 配置可编程计数器、让 PMC 在溢出时经 APIC 发 PMI 进内核抓现场、把采样记录经 mmap ring buffer 交回用户态」的一条链路:Linux perf 子系统用 perf_event_open 把它包装成文件描述符加 read/mmap/ioctl 三原语,用多路复用外推解决计数器不够分的矛盾,用 PEBS 硬件快照消掉 skid、顺手拿到数据地址——理解了这条链路,perf 输出的每个数字、每个百分比括号、每个 p 修饰符的含义就都有了出处。