精确异常机制:乱序流水线里的「断点回放」——ROB 冲刷时序全解剖
本篇是微架构目录下的中间篇。乱序执行让「后面的指令先跑完」成为常态,可一旦除零、缺页、非法指令这些异常出现,硬件必须给操作系统一个「看起来像顺序执行」的现场——这就是精确异常机制。前置知识见 ROB 重排序缓冲 与 乱序执行总览。
本文要回答的问题
- 什么叫「精确」异常?乱序核心里异常现场为什么会「不精确」?
- ROB 怎样靠提交序把异常点钉死在唯一一条指令上?
- 冲刷(flush)时序具体做什么:哪些要撤销、哪些保留?
- 一次冲刷的代价是多少拍?缺页异常和分支误预测的冲刷有何不同?
一、为什么乱序会把异常搞「不精确」
顺序流水线里,异常天然精确:指令一条接一条走完五级,第 N 条出异常时,第 N+1 条还没动过任何状态。但乱序核心完全不是这么回事:
① div rax, rbx        ; rbx=0,除零,但要 20 拍才执行到
② add r8,  r9         ; 无依赖,第 2 拍就算完
③ mov [rdi], r10      ; 无依赖,第 3 拍就发出 store
④ load r11, [rsi]     ; 无依赖,第 4 拍就拿到数据
如果①的除零在第 20 拍才被发现,此刻②③④早已「执行完毕」。若它们的结果直接写进了架构寄存器或内存,操作系统看到的现场就是:除零指令之后的状态已经被改了——异常点不精确,内核无法安全地重启或终止进程。
精确异常机制要解决的就是这件事:无论 µop 在流水线里飞得多乱,对外呈现的异常现场必须等价于「①之前的都完成了,①及之后的都没发生」。
二、核心思想:执行可以乱,提交必须排队
解法的钥匙在 ROB:执行阶段允许乱序,但所有 µop 的结果先落在物理寄存器和 store buffer 这些「暂存区」里,只有轮到 ROB 队头退休(retire)时,结果才变成架构可见的状态。异常检查也只在退休这一刻做:
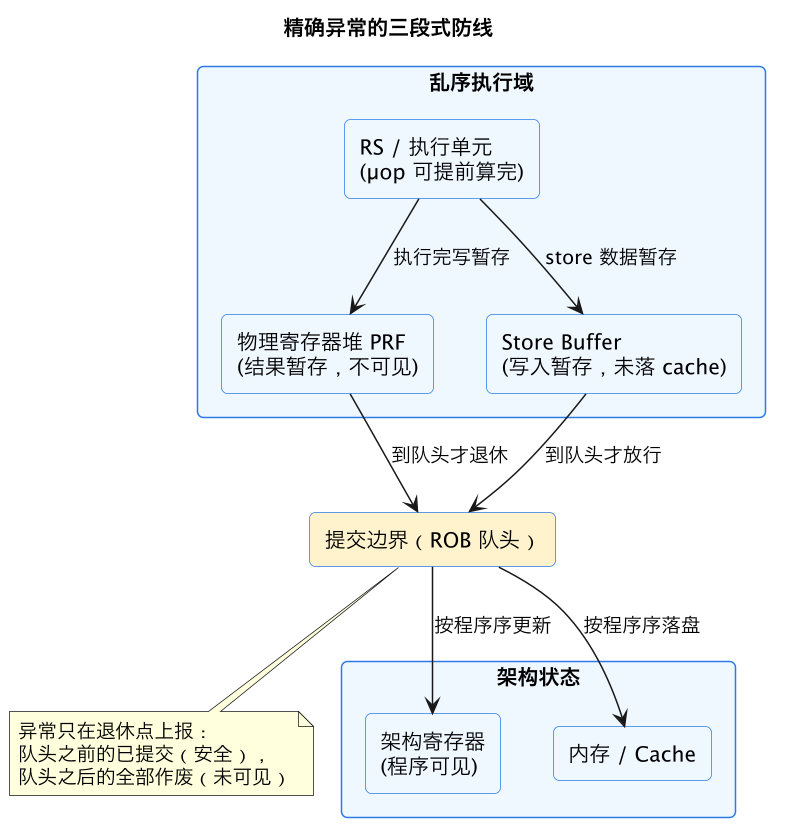
这张图的三段式防线是精确异常机制的全部精髓:
- 乱序执行域:µop 随便飞,结果只写 PRF 和 store buffer,这些是「推测态」,程序不可见;
- 提交边界:ROB 严格按程序序退休,每条 µop 到队头时才检查异常标志——异常上报被推迟到该指令成为「最老未提交指令」的时刻;
- 架构状态:只有过了提交边界的更新才落到架构寄存器和内存。
这样一来,无论除零的 µop 后面有多少条已经算完,只要它还没到 ROB 队头,异常就不上报;等它排到队头时,前面的指令已全部退休完毕,后面的指令全部没碰过架构状态——现场自然精确。
三、冲刷时序:异常上报之后硬件做什么
异常在队头被确认的同一拍,核心启动流水线冲刷。下面这张时序图展示一次缺页异常从发现到恢复的完整过程:
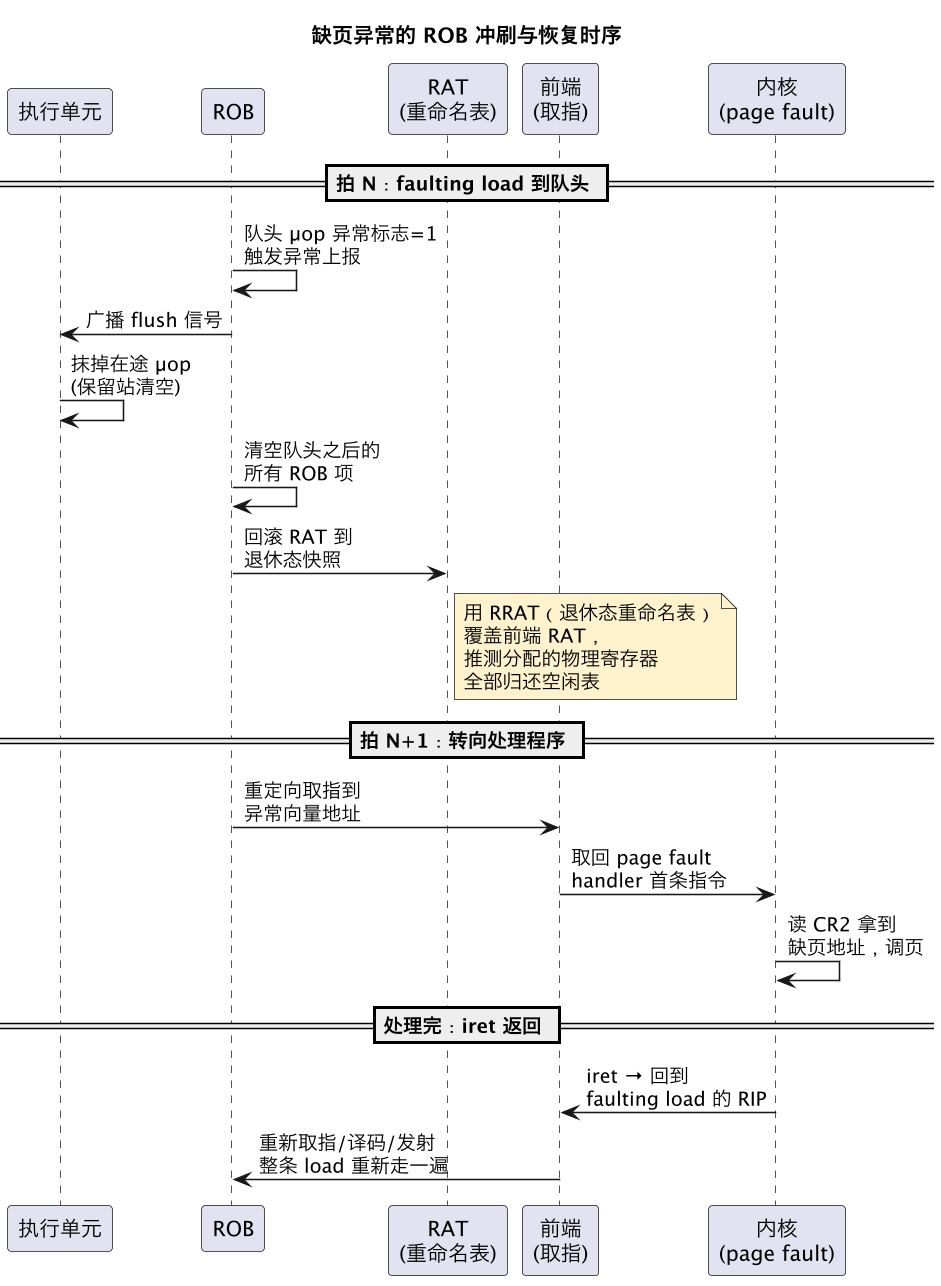
时序里有四个关键动作,一个都不能少:
- 抹在途:flush 广播后,保留站、执行流水线里所有比队头年轻的 µop 全部作废——它们的结果本来就没提交过,直接丢弃即可;
- 清 ROB:队头之后的 ROB 项清空,物理寄存器回收;
- 回滚重命名表:这是最容易被忽略的一步。年轻指令推测执行时改的是前端 RAT 和物理寄存器,冲刷时用 RRAT(退休态重命名表,只随提交更新)快照覆盖前端 RAT,把「推测的寄存器映射」一笔勾销;
- 重定向取指:前端跳到异常向量(缺页是 0xE 号),内核处理完用
iret回到 faulting 指令的 RIP,整条指令从头再走一遍。
注意第 4 点的含义:faulting 指令本身没有被「部分执行」的概念——它被完整撤销、完整重放。这就是「精确」的另一层含义:指令是原子的,要么全发生,要么全没发生。
四、恢复代价:一次冲刷烧掉多少拍
冲刷不是免费的。代价由两部分组成,不同触发源差别巨大:
| 触发源 | 冲刷深度 | 典型代价 | 发生频率 | 说明 |
|---|---|---|---|---|
| 分支误预测 | 仅推测路径 | 15–25 拍 | 每几十到几百条指令一次 | 最常见,现代预测器把它压到 1–2% |
| 缺页异常(page fault) | 全流水线 + 内核往返 | 数千到数百万拍 | 罕见 | 处理程序可能触发磁盘 I/O |
| 除零 / 非法指令 | 全流水线 + 信号递送 | 数千拍起 | 极罕见 | 通常进程直接收信号退出 |
| 自修改代码 / 串行化指令 | 全流水线 | 几十到上百拍 | 取决于代码 | cpuid 等串行化指令强制冲刷 |
有两点值得记住:
- 分支误预测的冲刷和异常冲刷共用同一条通路——都是「清 ROB + 回滚 RAT + 重定向取指」,区别只在重定向的目标地址(正确路径 vs 异常向量)。所以一个核心把误预测恢复做快了,异常恢复自然也快;
- 缺页的代价大头不在冲刷本身,而在内核处理程序。流水线冲刷那 20 来拍,和可能发生的磁盘 I/O(毫秒级,等于数百万拍)相比可以忽略。这也是为什么性能分析里 minor fault 每秒几千次无所谓,major fault 几百次就要警觉。
对程序员的实践推论:别在正常路径上依赖异常做控制流。用 try/catch 或信号处理当「常规分支」用,每触发一次就是一次全流水线冲刷加内核往返,比一次函数调用贵四到五个数量级。
这一篇在知识体系里的位置
精确异常机制是乱序执行「对外守信」的承诺书:执行域可以胡来,提交边界必须一板一眼。它的上游是 ROB 重排序缓冲(提交序的载体)和 乱序执行总览(为什么需要乱序);同层的 寄存器重命名 解释了 RAT/RRAT 快照回滚为什么可行。下游则通向操作系统侧的缺页处理与信号机制——硬件只负责给出精确现场,怎么用这个现场是内核的事。
总结
精确异常机制 = 「执行乱序、提交顺序」契约的兑现方式:µop 结果先放推测态暂存区,ROB 按程序序退休时才检查并上报异常,冲刷时清 ROB、用 RRAT 快照回滚重命名表、重定向取指,把异常点钉死在唯一一条指令上;代价从分支误预测的十几拍到缺页的内核往返不等,所以永远别把异常当常规控制流用。