TAGE 分支预测器:几何级历史长度表、provider/alt 选择与 useful 位更新策略全解
更新时间:2026-09-30。分支预测 那篇建立了整体框架:取指阶段必须猜方向、猜目标,猜错一次流水线清空重来。框架里把预测器分了几代——两位饱和计数器、局部历史、全局历史、gshare——最后提了一句「现代高性能核用的是 TAGE 家族的锦标赛预测器」。这一篇就把这句话展开成完整的一篇:TAGE(TAgged GEometric history length)为什么用一组历史长度按几何级数排列的表,tag 匹配怎么做,provider 和 alternate 两个预测怎么仲裁,useful 位如何驱动分配与替换,以及这些纸面算法落到真实硅片上时工程师做了哪些妥协。它是方向预测的深水区;目标地址预测见 BTB 分支目标缓冲,间接跳转见 间接分支预测,函数返回见 返回地址栈 RAS。
本文要回答的问题
- 为什么单一历史长度的全局预测器不够用,TAGE 的几何级数历史长度解决了什么矛盾?
- TAGE 的多张表各自长什么样,tag 匹配的查询流程是怎么走的?
- 多张表同时命中时,provider 和 alternate 怎么选、最终听谁的?
- 预测错误后更新哪些表、什么时候分配新表项,useful 位在其中扮演什么角色?
- 工业实现(如 AMD Zen、各类开源核)在 TAGE 上做了哪些裁剪和变体?
一、从「一个长度」到「一组长度」:几何级数的动机
全局历史预测器的核心思想是:当前分支的方向,往往和最近若干条分支的结果相关。用一条全局历史寄存器(GHR,Global History Register)记录最近 N 条分支的 taken/not-taken,把 GHR 和分支地址混杂后索引预测表,就能捕捉这种相关性。经典的 gshare 就是把 GHR 与 PC 异或后索引一张两位计数器表。
问题出在 N 的选取上,这是一对解不开的死结:
- N 短(比如 8):只能看到很近的相关性。一个循环套循环的代码,内层循环周期是 3,外层是 100,想预测外层循环的退出分支,需要记住 100 条之前的历史,N=8 完全看不见。
- N 长(比如 200):表项数随历史长度爆炸。N 位历史理论上对应 2^N 种历史模式,哪怕用 hash 折叠,要学到「200 条之前那个分支影响现在」这种稀疏相关性,需要巨量的表项和漫长的训练时间。更糟的是,短历史就能预测的分支也被迫用 200 位历史去索引,hash 冲突把表打得稀烂——这叫「历史污染」:绝大多数分支只需要 4-16 位历史,它们和长历史需求者挤在同一张表里互相踩踏。
TAGE 的破局思路朴素而优雅:不选,全要。用一组(通常 5-8 张)带 tag 的预测表,第 i 张表用长度为 L(i) 的历史做索引,L(i) 按几何级数增长——比如 0、4、8、16、32、64、128。短历史需求者在短表里就能命中,不再去长表里制造冲突;只有真正需要超长历史的分支才会在长表里留下表项。几何级数(而不是等差)的原因是经验观察:相关性的分布大致是「越短的历史覆盖越多的分支」,按 2 倍递增配表,每档覆盖的分支数量大致均匀,硅片面积花得最值。
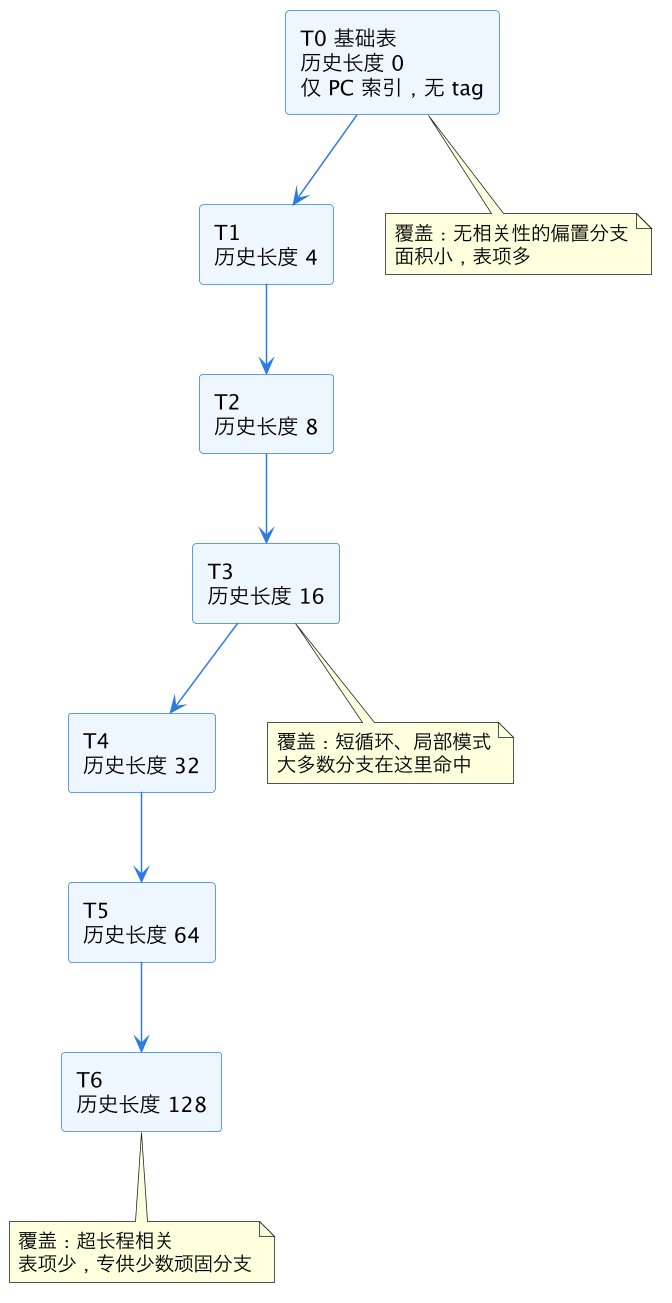
上图是 TAGE 的整体轮廓。T0 是无 tag 的基础表(本质就是一张两位计数器的 bimodal 表,相当于历史长度 0),保证任何分支都有一个兜底预测;T1 到 T6 是带 tag 的分量表,历史长度按几何级数翻倍。查询时所有表并行查,取「命中的表里历史最长的那个」作为主预测——这就是 TAGE 名字里 GEometric 的来历。
二、表项结构与查询:tag 匹配怎么做
每张带 tag 表的表项不是裸计数器,而是三个字段:tag(标签,用于确认「这条历史确实是我存的那条」)、ctr(预测计数器,通常 3 位,高位即预测方向)、u(useful 位,1-2 位,记录这条表项「有没有用」,更新与替换时要用)。
索引和 tag 的生成是同一次 hash 运算的两半。以 Ti 为例:把 PC 与折叠到 L(i) 位的全局历史做一个 hash(论文里用了一系列折叠异或函数),hash 值的低位部分作为索引去选表项,另一部分作为 tag 与表项里存的 tag 比对。索引选中了表项、tag 又匹配,才算真正命中。tag 的意义很关键:长历史表的表项是稀缺资源,没有 tag 的话,不同历史模式 hash 到同一槽位会互相污染预测结果(aliasing);有了 tag,冲突最多导致「不命中、退回短历史表」,而不是「给出错误预测」。
这里有一个容易忽略的细节:每张大表还配了第二套 hash,同一条历史在不同表里落在不同槽位,进一步稀释冲突。历史折叠也是个技术活——GHR 可能有 1000 位深,而 T6 只用 128 位,怎么把长历史折叠进短宽度而不丢掉关键相关性,各实现有自己的折叠树设计,这是 TAGE 论文之后大量后续工作的战场。
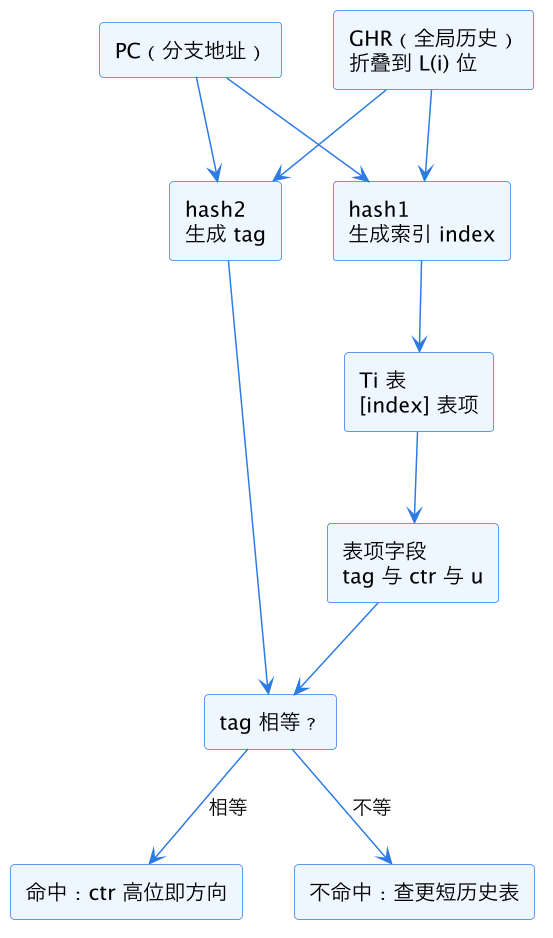
上图是单张表的查询数据流。注意 ctr 用 3 位而不是经典 gshare 的 2 位:多一位迟滞让预测更「黏」,对噪声更不敏感,这对长历史表尤其重要——长历史表项训练机会少(对应的历史模式出现频率低),每次训练信号都很宝贵,不能轻易被偶发的异常结果翻转。
三、provider 与 alternate:命中多张表时听谁的
并行查完所有表,可能有多张命中。规则一句话:历史最长的命中表是 provider(主预测者),历史第二长的命中表(或全不命中时的 T0)是 alternate(备选预测)。最终输出通常就是 provider 的 ctr 高位。
那还要 alternate 干什么?因为存在一类「新分配的 provider 还没训练好」的场景。回想分配策略:一个分支第一次需要长历史时,TAGE 会在长表里给它分配一个新表项,新表项的 ctr 初始值是弱倾向(weak),基本等于抛硬币。如果此时无脑听 provider 的,新表项的实习期会贡献一堆误预测。TAGE 的办法是引入一个全局的动态判断:统计「provider 是弱计数器(新表项)」的情况下 provider 和 alternate 各自的准确率,用一个 4-5 位的全局计数器(论文里叫 USE_ALT_ON_NA)记录「provider 弱时听 alt 是不是更好」。当 provider 的 ctr 处于弱状态且这个统计器说 alt 更靠谱时,改听 alternate 的。
这个机制是 TAGE 相对于它的前辈(如 Michaud 的 PPM-like 预测器)的一个关键简化:不用给每条分支维护置信度,一个全局统计器就够,因为「新表项不可靠」是个统计规律而非个例。
这里可以再往深想一层:为什么弱 provider 的场景偏偏值得单独仲裁?因为 TAGE 的分配策略决定了长表里的新表项几乎全是在「误预测现场」诞生的——它出现的那一刻,周围就是预测器最难啃的硬骨头。一个刚出生的表项面对的都是难题,它最初的几次预测如果直接被采纳,等于让实习生第一天就独立签批关键决策。USE_ALT_ON_NA 做的事,本质上是一套组织上的导师制:实习生(弱 provider)先给出意见,但由已经证明过自己的 alternate 复核,等实习生的 ctr 被训练到强态、证明了自己,再转正独立裁决。全局统计器记录的是「导师复核制度整体上是帮了忙还是添了乱」,动态决定是否启用。
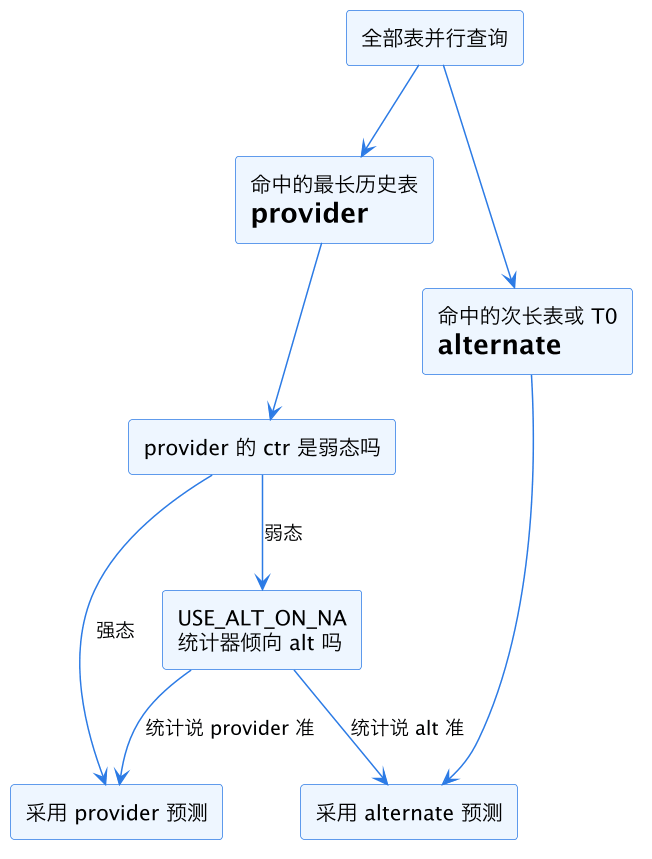
上图是仲裁逻辑。左半边是「正常路径」:provider 计数器足够强,直接听它的;右半边是「实习期路径」:provider 弱,全局统计器投票决定听谁。这个设计在面积上几乎免费(一个全局计数器加几个比较器),但在锦标赛模拟里能把误预测率再压低几个百分点——在分支预测领域,每 1% 的误预测率下降都值真金白银的 IPC。
四、更新策略与 useful 位:新表项从哪来,旧表项谁让位
预测做出去之后,等分支真实结果在提交阶段揭晓,就进入更新环节。TAGE 的更新有三件事要做,纪律很讲究:
第一件,训练 provider:按真实方向增减 provider 表项的 ctr。注意只训 provider,不训所有命中表——这是「赢家通吃」原则,避免多张表为同一条分支重复消耗计数器寿命,也让长短表自然分工。
第二件,纠正 alt 选择:如果 provider 是弱态且 provider 与 alt 预测不同,用这次结果更新 USE_ALT_ON_NA 统计器。
第三件,也是 TAGE 最精妙的部分:分配新表项。触发条件是「provider 预测错了」且「provider 不是历史最长的那张表」——这意味着存在更长历史的信息可能有用,值得尝试在更长的表里开一条新表项。具体做法是在比 provider 长的表里挑一张(论文里是随机挑一到两张,且带一个随误预测率升降的概率节流阀,避免误预测风暴期疯狂分配),找一条 u=0 的表项替换掉。
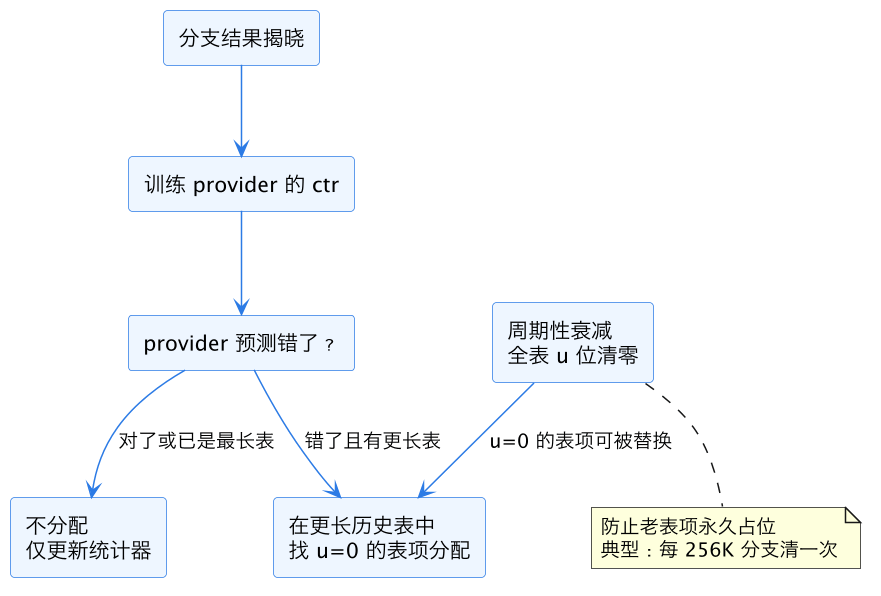
现在 useful 位(u)的真正角色浮出水面了,它回答的是「这条表项还值不值得占着这个槽位」。规则是:每当 provider 命中且它的预测与 alt 不同、而它是对的时候,把 provider 的 u 置位——即「这条表项提供了比短历史表更好的预测,它有用」。如果 provider 和 alt 预测一致,u 不动,因为这条表项没提供额外价值(短表也能给出同样的预测)。分配新表项时只抢 u=0 的槽位。那会不会所有槽位都被 u=1 占死、再也无法分配?这就是上图下方那个「周期性衰减」的作用:每隔一段周期(典型 256K 条分支),把所有表的 u 位全部清零,相当于定期「大赦」,让长期没被证明有用的表项重新变成可替换资源。这个清零节拍是 TAGE 里少数需要调参的旋钮之一:清得太勤,有用的表项还没攒够置位机会就被冲掉;清得太懒,死表项占坑,长表退化。
有人把 TAGE 的更新哲学概括成「保守的乐观」:预测错了才尝试开新资源(乐观地假设更长历史能帮上忙),但只替换被证明没用的旧资源(保守地保护已有投资)。这套哲学和缓存替换策略里的思想一脉相承,对比着读 缓存替换策略 LRU 及其变体 会发现同样的「用元信息标记价值、按价值淘汰」模式。
五、几何级数之外:loop 预测器与统计校正器
原始 TAGE 论文之后,Seznec 又加过两个外挂,后来的工业实现普遍吸收,值得单独讲。
第一个是 loop 预测器。循环退出分支是 TAGE 的软肋:一个固定跑 100 次的 for 循环,前 99 次都是 taken,第 100 次突然 not-taken,全局历史里前 99 次模式完全相同,任何基于历史的表都无法区分「第 99 次」和「第 100 次」。loop 预测器的办法简单粗暴:识别出「方向规律性翻转的分支」,直接数迭代次数,数到上次学到的 trip count 就反转预测。它在 SPEC 一类循环密集的负载上能啃掉 TAGE 剩余误预测的一大块。
第二个是统计校正器(statistical corrector)。思路是把 TAGE 的整体输出当作一个「特征」,再叠加若干独立的小特征(比如各张表 ctr 的加权和、provider 与 alt 的置信度差),过一个小型感知机式的加法器,和阈值比较决定要不要翻转 TAGE 的预测。它捕捉的是 TAGE 结构本身系统性地漏掉的模式。加了校正器的 TAGE-SC-L 在 CBP(Championship Branch Prediction)竞赛里长期霸榜,8KB 预算下误预测率低到每千条分支 3-4 个。
这两个外挂还揭示了一个方法论上的规律:主预测器负责「大面上最优」,外挂负责「结构性盲区」。loop 预测器针对的是「基于历史的表结构天然看不见计数信息」这一盲区,校正器针对的是「分散在多张表里的弱信号没人汇总」这一盲区。每加一个外挂前,先回答「主预测器的哪一类剩余误预测具有可识别的结构」,答不上来就不加——否则外挂之间会互相干扰,训练信号打架,面积花了精度反而倒退。这个「先归因、再补结构」的节奏,值得任何做预测类硬件设计的人抄作业。
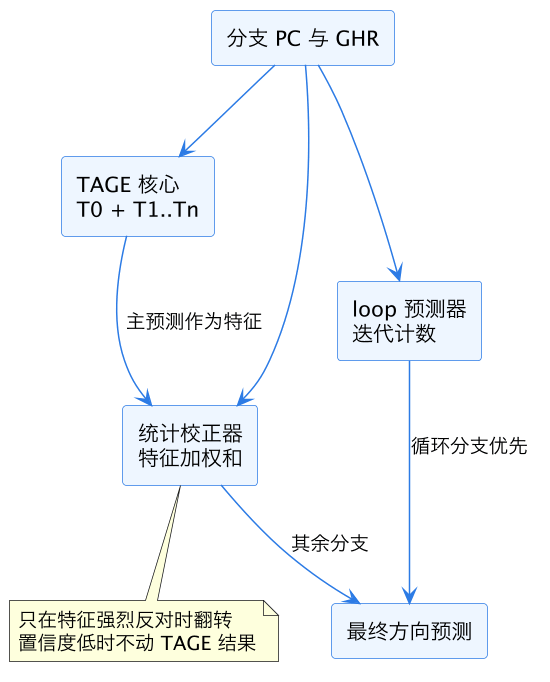
上图是完整形态:TAGE 核心输出主预测,loop 预测器对识别出的循环分支直接给出答案,统计校正器对其余分支做最后一道把关。三者职责清晰,互不抢活——这是好的微架构设计的共性:每个结构只优化一类明确的模式。
六、工业实现:从论文到硅片的裁剪
TAGE 论文是 2006 年的,之后的工业处理器几乎都在它的思想谱系里,但没有任何一家是照抄论文。裁剪主要发生在三个维度。
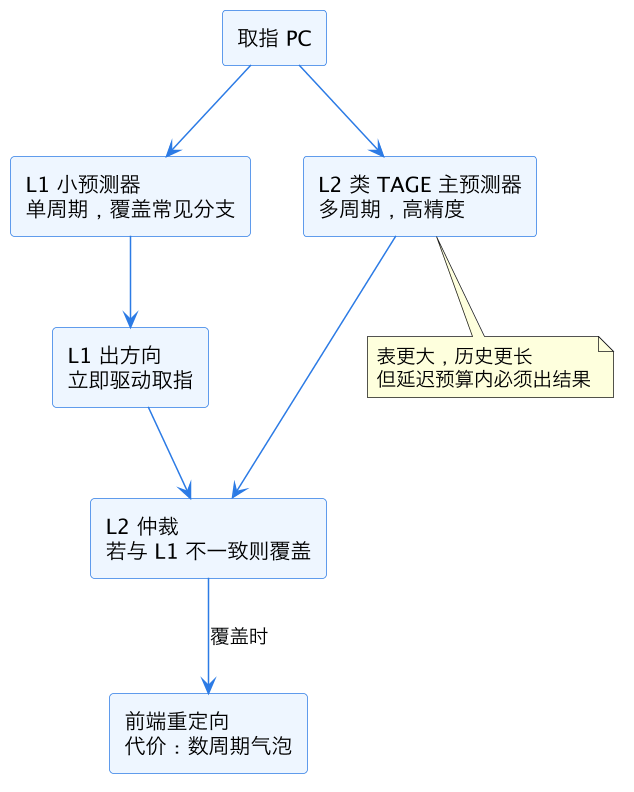
第一是历史长度与表的数量。论文里的 GHR 可以到上千位、表多达十几张,那是锦标赛预算下的奢侈配置。真实硅片上,取指阶段的预测延迟预算是 1-2 个周期,表的容量和访问级数被卡得很死。AMD Zen 家族的公开资料和逆向分析显示,其方向预测器是多层结构:小型 L1 预测器单周期出结果(应付绝大多数分支),大型的类 TAGE 主预测器多周期出结果(发现 L1 错了就覆盖,代价是几个周期的前端气泡)。「快而糙的小预测器 + 慢而准的大预测器」这种覆盖式(overriding)结构,是对「预测精度」和「预测延迟」这对新矛盾的工程回答——论文 TAGE 只优化精度,工业实现必须同时优化延迟。
第二是 hash 与折叠的具体形式。论文的折叠异或函数是公开的,真机的 hash 都是专有且保密的,因为 hash 质量直接决定表项利用率,是核心竞争力。已知的是各家普遍在 hash 里混入更多上下文:不只是 PC 和 GHR,还有目标地址、路径历史(path history,记录最近的取指块地址序列而不仅是方向),以打散别名。
第三是更新的投机处理。TAGE 是投机更新的典范:预测时就把 GHR 移位更新、把预测快照存起来,误预测时从快照恢复 GHR——这部分机制和重命名阶段的检查点紧密耦合,与 ROB 重排序缓冲 的提交语义、以及流水线清空恢复(见 精确异常与流水线冲刷)共享同一套「投机 + 快照 + 回滚」框架。预测器内部的状态恢复和乱序核的状态恢复,本质是同一个问题的两个层面。
还有一个公开实现值得一提:RISC-V 开源世界的香山处理器,其前端文档明确写了方向预测器采用 TAGE 变体(ITTAGE 负责间接目标,主方向预测也是 TAGE 家族),并且开源了参数化配置——表数、历史长度、表容量都可以配。想亲手摸一摸 TAGE 的表怎么配、误预测率随参数怎么变,香山的 RTL 和 CBP 竞赛的开源代码是最好的实验场。
调参时的经验次序也值得记一下:先定总存储预算,再按几何级数摊到各表,然后跑 trace 看每张表的命中率和「命中且独家正确」(即比所有短表都对)的比例。某张长表如果命中率尚可但独家正确率接近零,说明它的历史长度选错了,砍掉或挪位;如果 u 位大面积为零,说明分配策略太激进,要收紧分配概率节流阀。TAGE 的优雅之处在于每个参数都有可观测的对应指标,调参是科学不是玄学。
最后给一个选型视角的对照表,把方向预测器几代人放在一起看,TAGE 的位置就清楚了:
| 预测器 | 历史来源 | 结构 | 典型规模 | 弱点 |
|---|---|---|---|---|
| 两位饱和计数器 | 无(仅本分支) | 单表 PC 索引 | 数 KB | 完全看不见分支间相关 |
| 局部历史 | 每条分支自己的历史 | 历史表 + 模式表两级 | 数 KB | 循环外的相关性抓不到 |
| gshare | 固定长度全局历史 | 单表,GHR 与 PC 异或 | 数 KB | 单一长度,长短需求互踩 |
| 锦标赛(Alpha 21264) | 局部 + 全局 | 两个预测器 + 选择器 | 十数 KB | 仍是单长度全局分量 |
| TAGE | 几何级多长度全局历史 | 多带 tag 表 + provider/alt | 十数到数十 KB | 循环退出、训练时间 |
| TAGE-SC-L 及其工业变体 | 同上 | TAGE + loop + 校正器 | 数十 KB | 面积、延迟、验证复杂度 |
这一篇在知识体系里的位置
本篇是微架构模块里方向预测线的深水篇。上游框架文是 分支预测,建立了「为什么必须预测、预测错多贵」的动机;同线并行的是目标地址侧的三篇——BTB 分支目标缓冲、间接分支预测、返回地址栈 RAS,以及把多层预测思想用到极致的 多层次分支预测。下游,预测与投机牵出的恢复机制见 ROB 重排序缓冲 与 精确异常与流水线冲刷;替换策略的思想对照见 缓存替换策略 LRU 及其变体;整条微架构演进链的地图见 CPU 微架构总览。
总结
TAGE 分支预测器用一组历史长度按几何级数增长的带 tag 预测表,让短历史分支和长历史分支各得其所互不污染,查询时以「命中的最长历史表」为 provider、次长为 alternate 并按全局统计器仲裁弱表项的实习期,更新时赢了才训、错了才在更长表里分配新表项、useful 位加周期清零负责新旧代谢——这套「多长度分治 + 保守分配 + 价值淘汰」的组合,加上 loop 预测器和统计校正器两个外挂,构成了近二十年所有高性能处理器方向预测器的思想底座。