微码 ROM:复杂 x86 指令的译码落点、微码辅助的性能悬崖与 PMU 排查法
更新时间:2026-10-04。x86 前端把变长、复杂到近乎无赖的指令集翻译成规整的微操作(uop)流,靠的不是一台译码器,而是三台:若干台简单译码器各管一条只产 1 个 uop 的指令,一台复杂译码器管产 2 到 4 个 uop 的指令,还有一块微码 ROM(Microcode ROM,简称 MSROM)兜底所有更复杂的东西。前两台的故事在 uop 缓存与译码前端 里讲过,指令在进入译码器之前如何被预解码打标记见 x86 预解码位。本篇的主角是那条最慢但最能扛事的路:微码 ROM。它平时安静得像不存在,可一旦你的热循环里混进一条落入 MSROM 的指令,或者更糟——触发了微码辅助(microcode assist),性能曲线会出现一道没有任何缓存未命中、没有分支误预测能解释的悬崖。
本文要回答的问题
- 一条 x86 指令凭什么被送进微码 ROM,而不是走普通译码器?判定标准是什么?
- 落入 MSROM 的译码带宽损失有多大?它和 uop 缓存是什么关系?
- 微码辅助 assist 和普通的微码译码有什么区别?为什么说它是性能悬崖?
- 微码更新(microcode update)是怎么装进 CPU 的?为什么固件补丁能修硬件漏洞?
- 怎么用 PMU 计数器确认程序正在吃微码的亏,又该往哪个方向优化?
一、三台译码器:微码 ROM 是最后的兜底者
先回忆一下 x86 译码的难处:指令长度 1 到 15 字节不等,前缀可以叠好几层,一条指令的语义可以简单如 nop,也可以复杂如 cpuid——后者要读几十个寄存器、按型号返回特性位,根本无法用硬件逻辑直接铺出来。Intel 从 P6 时代起的答案就是「把 CPU 做成两层」:外层是 x86 指令集,内层是一个类 RISC 的微操作引擎,中间由译码器做翻译。而翻译这件事按指令的「uop 产量」分三路:
| 译码路径 | 覆盖指令 | 每周期产能 | 典型例子 |
|---|---|---|---|
| 简单译码器(多台并行) | 产 1 个 uop | 每台 1 条指令 | add reg, reg、mov、jmp |
| 复杂译码器(仅一台) | 产 2 到 4 个 uop | 1 条指令 | call、带 RIP 相对寻址的算术指令 |
| 微码 ROM(MSROM) | 产 5 个及以上 uop,或行为不可硬布线 | 视微码序列长度而定 | cpuid、rep movsb、除法、xsave |
判定是硬件在译码时自动做的,程序员和编译器都无法直接指定「这条走哪台译码器」——只能通过选指令来间接决定。比如编译器把内存拷贝展开成普通 mov 加循环,走的就是简单译码器加 uop 缓存的快路;而你手写一个 rep movsb,同一台机器上它就落进 MSROM,由微码器逐拍吐出微操作流(现代 CPU 上 rep movsb 有快速字符串增强,但微码的本质没变)。
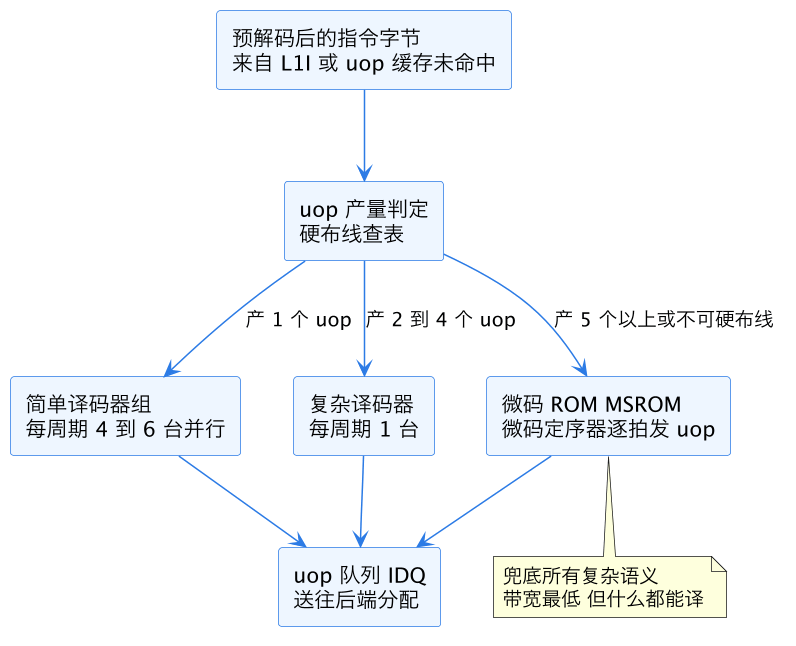
上图是前端译码的三岔口。注意三条路最终都汇入同一个 uop 队列(IDQ,Instruction Decode Queue),后端看到的只有 uop,不关心它出身。但三路的供给能力差距巨大:简单译码器组每周期能喂饱 4 到 6 条指令,复杂译码器只有 1 条,而 MSROM 要先切换到微码定序器(microcode sequencer)接管 IDQ 的写入权,再按微码序列一拍一拍地发,一条长微码指令独占前端几十拍是常事。这就是「热循环里混进一条 MSROM 指令」的代价形态:不是这条指令慢一拍,而是它堵住了后面所有指令的入口。
二、哪些指令会落进微码 ROM
「超过 4 个 uop」是最广为人知的判据,但不是全部。更准确地说有三类指令必走 MSROM。
第一类是天然长序列:字符串操作(rep movs / rep stos / rep cmps)、xsave / xrstor(保存恢复成 KB 级的扩展状态)、cpuid、rdmsr / wrmsr、iret 的某些路径、任务切换相关指令。这些指令的语义本身就是一个循环或一段条件逻辑,微码本质上就是「固化在 CPU 里的程序」,用它来表达最自然。
第二类是可以硬布线但产量超标的:部分乘除法(div / idiv 内部是迭代算法)、较复杂的浮点超越函数指令(fsin、fptan 这类老式 x87 指令)、某些 SIMD 聚集散列类操作。它们在简单的核(比如能效核)上可能整条走微码,在性能核上可能只把头尾交给微码。
第三类是「平时快、特定条件下退化」的:这是最容易坑人的一类。典型的是英特尔较新架构上的部分指令在前缀组合不常见时走快路、组合怪时退化到微码;还有 cmpxchg16b 跨缓存行、锁定操作遇到特殊对齐时的微码展开。这类退化在 Agner Fog 的指令表和 Intel 优化手册的附录里能查到 uop 数的突变,普通文档却不一定写。
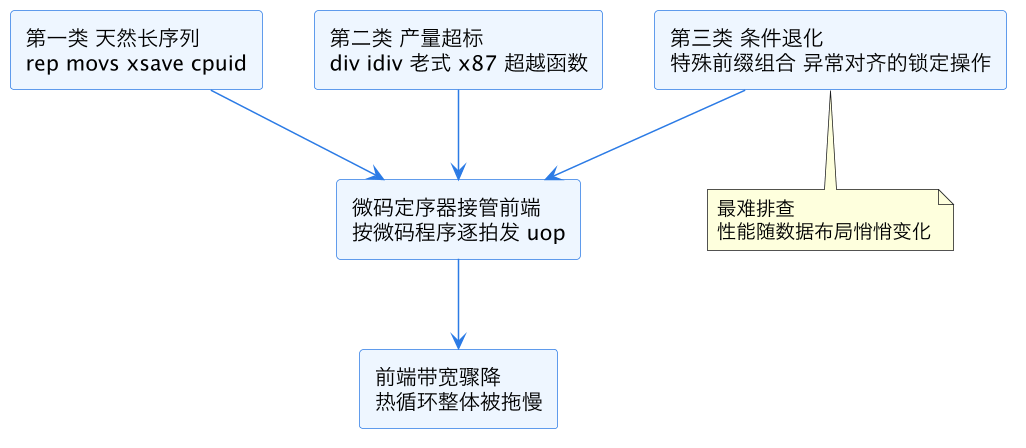
上图里第三类值得盯一眼:它的触发依赖数据(对齐、值)而非静态代码,同一份二进制换一组输入性能就变脸。判断静态属性的办法是查指令 uop 数表,判断动态退化只能靠 PMU,见第五节。
一个常见误解需要顺手澄清:落入 MSROM 译出来的 uop 照样会进 uop 缓存(DSB),下次再执行同一段代码时直接从 DSB 供带,不必重新走微码展开——前提是这段代码的 uop 总量塞得进 DSB 的每路容量限制。所以微码译码的一次性开销常被循环迭代摊薄,真正贵的是下一节的主角。
三、微码辅助 assist:前端让给微码器的「中断现场」
普通的 MSROM 译码是「静态」的:译码器遇到复杂指令,定序器读出对应的微码例程,发完 uop,前端继续往前跑。微码辅助(microcode assist)是另一回事:它是指令在执行途中发现情况不对,举手叫微码器来收拾残局。
触发 assist 的典型场景:
- 次正规浮点数(denormal):乘除、加减的结果落在次正规区间时,很多老微架构直接把操作甩给微码做软件式精修,一次 assist 一百多周期起步。新架构(Ice Lake 之后)大多硬件直算,这也是浮点代码「换台机器突然快一倍」的常见原因。
rep movs跨特定边界或遇到页错误中途恢复:字符串指令的微码要能在任意字节处安全续跑。- 某些系统指令和罕见特权级转换。
- 硬件勘误(errata)的规避:某条指令在特定条件下行为有 bug,厂商用微码打补丁的方式就是「让这种条件组合触发 assist,绕开坏路径」——补丁修了正确性,却可能在热路径上埋了新的慢路径。
assist 贵在哪?它不是「多发几个 uop」,而是一次小型上下文切换:流水线要排到指令到达退休点的安全位置、把相关架构状态转交给微码例程、定序器跳转到 ROM 里的处理程序、执行完再把控制权还回去。期间前端停止取指译码,乱序窗口里的后续指令等待排空,一次 assist 的总代价通常在几十到几百周期。对比之下,一次 L1 未命中命中 L2 才十几周期——assist 是前端能遇到的最贵事件之一,比分支误预测的 15 到 20 周期罚时高出一个量级。
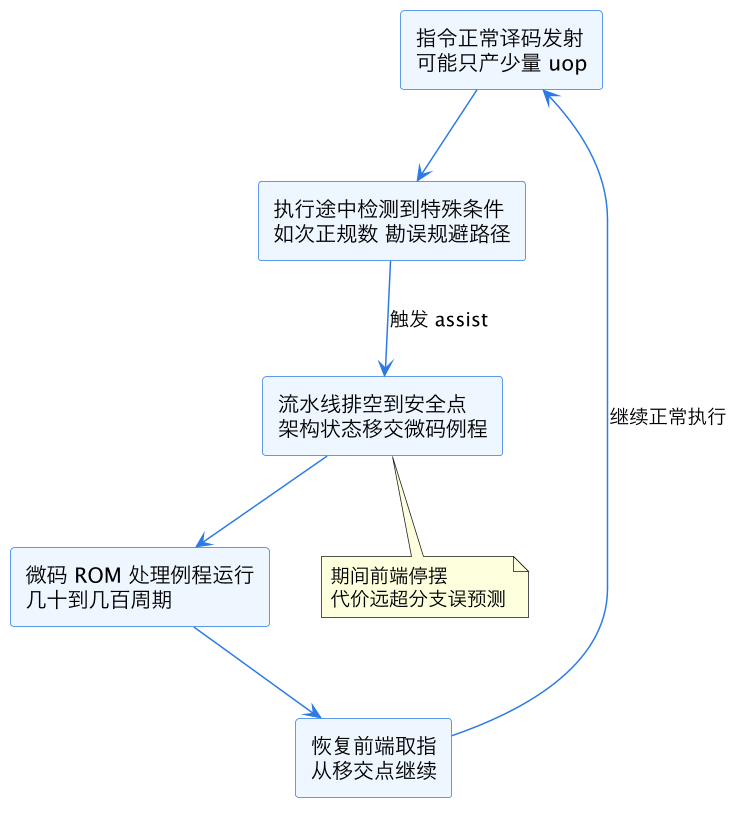
上图的关键是中间那两步:排空与恢复。它们解释了为什么 assist 的伤害不能用「这条指令多花了多少拍」来衡量——它让整个核心在那个瞬间退回了近似按序执行。一个极端但真实的例子:某科学计算程序在旧 Xeon 上因为数据里偶尔出现的次正规数,assist 计数达到每秒几十万次,整核 IPC 从 2.5 掉到 0.3;打开编译器的 -ffast-math 等价选项(FTZ/DAZ,把次正规数当零刷掉)后 assist 归零,性能恢复。硬件背景上,乱序引擎等待排空的行为与 精确异常与流水线冲刷 里讲的冲刷机制同源,只是发起者从异常变成了微码请求。
四、微码更新:能修硬件的「固件补丁」
微码 ROM 这个名字容易让人以为它全部只读。实际上现代 x86 CPU 的微码分两层:出厂固化在 ROM 里的基础微码,和一块可写的 SRAM 区——启动早期(BIOS/UEFI 阶段)或操作系统引导时,可以把一份「微码更新」载进这块 SRAM,对 ROM 里的例程做挂钩与替换,从某个微码地址开始「跳转」到新版本。
这条通道的能力边界很能说明微码的本质:它能改的是「指令怎么被解释执行」,改不了物理电路。所以 Spectre/Meltdown 类漏洞的微码缓解措施(比如引入 IBRS、收紧间接分支预测器行为、给某些指令加序列化语义)才能靠打补丁生效——预测器是电路,但「什么时候允许用预测结果」是策略,策略住在微码里。代价同样体现在微码层面:不少缓解措施本质是给热路径加 uop 或加 assist,这就是打安全补丁后基准测试掉几个点的直接机理。瞬态执行的硬件背景见 Spectre 与 Meltdown 瞬态执行。
装载路径上有个实用细节:Linux 有 early microcode loading 机制,initramfs 里塞微码更新包,内核在最早期就把它压进每个核;也可以通过 late loading 在线更新。Windows 则由系统更新携带。虚拟化环境下客户机看到的微码版本可能被 VMM 过滤或伪装,排查「两台同型号 CPU 行为不一致」时,/proc/cpuinfo 里的 microcode 字段是第一嫌疑。
| 层面 | 载体 | 能改什么 | 不能改什么 |
|---|---|---|---|
| ROM 基础微码 | 出厂固化 | 全部指令的解释框架 | 出厂后不可改 |
| SRAM 微码更新 | BIOS 或 OS 引导加载 | 挂钩替换既有例程、新增特性位(如缓解开关) | 电路本身的缺陷、功耗特性 |
| 软件规避 | 编译器插桩(retpoline 等) | 绕开易触发慢路径的指令形态 | 无法关闭硬件层面的根源 |
五、PMU 排查:三颗计数器锁定微码瓶颈
微码问题最阴险的地方在于「常规画像正常」:缓存未命中率不高、分支误预测不高、IPC 却低。这时候该查微码计数器。Intel PMU 提供了直接的观测面:
| 计数器事件 | 含义 | 异常信号 |
|---|---|---|
IDQ.MS_UOPS | 由 MSROM 供给的 uop 数 | 占总 uop 比例持续超过百分之几就要警惕 |
IDQ_UOPS_NOT_DELIVERED.CORE 分解 | 前端未供带归因 | MS 切换造成的供带气泡可从此侧写 |
FP_ASSIST.ANY(或 ASSISTS.FP 等型号相关名) | 浮点 assist 次数 | 非零即说明有次正规数类问题 |
MACHINE_CLEARS.COUNT | 机器清空总次数 | assist 引发的排空会在此留下指纹 |
用法上用 perf stat -e idq.ms_uops,instructions 先算「微码 uop 占比」,若异常再用 perf record -e fp_assist.any 采样定位到函数。开源界的 toplev(Andi Kleen 的 TopDown 工具)在「前端绑定」分支下专门有 MS 供给的指标,跑一遍就能直接看到百分比。
定位之后怎么优化,按触发源分三招。次正规数类:开 FTZ/DAZ 标志(mxcsr 寄存器的两个位,编译器选项或运行时设置),让硬件把次正规输入输出直接刷零,彻底绕过 assist。长序列指令类:热路径上的 rep movs 换 SIMD 循环或调用优化过的 memcpy(glibc 的实现会按 CPU 特性选最稳的路径)、xsave 换 xsaveopt/xsaves、老式 x87 超越函数换软件多项式逼近(libmvec)。条件退化类:调整数据对齐、避开怪前缀组合的指令形态,必要时看厂商勘误文档确认是不是被微码补丁「修慢了」——是的话评估能否用等价指令绕开。
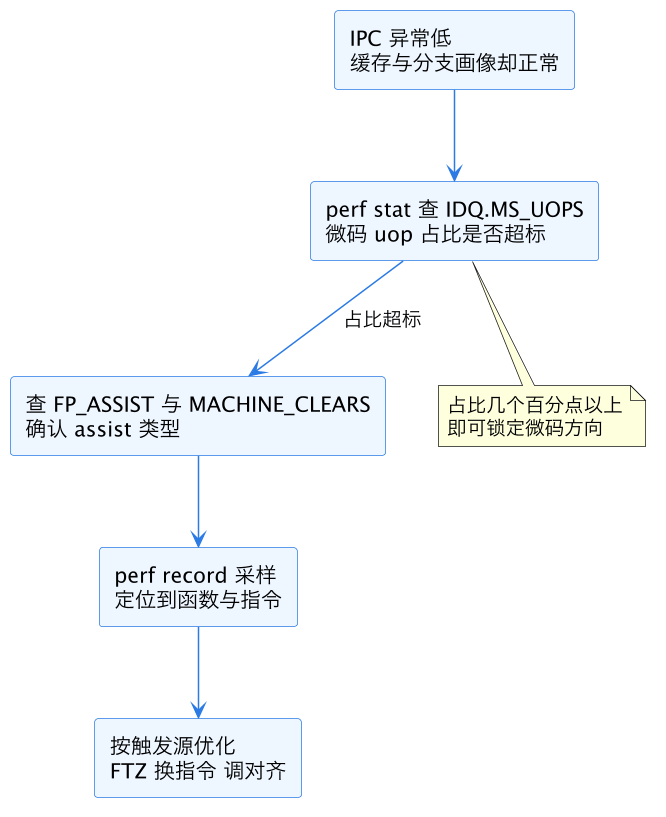
上图是整套排查动线。它的前提是先排除了更常见的嫌疑——前端别的瓶颈(ITLB 未命中、译码缓存失效)画像见 ITLB 未命中前端停顿,后端的端口争用见 执行端口争用。微码永远是排查清单的靠后位置,但一旦轮到它,命中率极高,因为剩下的嫌疑已经不多了。
这一篇在知识体系里的位置
本篇是微架构模块「前端译码线」的收尾篇:指令字节如何被切分见 x86 指令长度译码器,预解码打标记的机制见 x86 预解码位,三台译码器与 DSB/MITE 双路供带的整体设计见 uop 缓存与译码前端,本篇则把最慢那条路——微码 ROM 与 assist——讲透。译出的 uop 往后端的旅程见 乱序执行的重命名与退休,流水线冲刷的共性问题见 精确异常与流水线冲刷,微码补丁缓解的漏洞背景见 Spectre 与 Meltdown 瞬态执行。全景见 CPU 微架构总览。
总结
微码 ROM 是 x86 前端兜底复杂指令的第三台译码器:一条指令产 uop 超过 4 个或语义不可硬布线就落入 MSROM,由微码定序器逐拍展开,供给带宽远低于普通译码器但更通用;真正的性能悬崖是执行途中触发的微码辅助 assist——流水线排空加微码例程处理一次就是几十到几百周期,次正规浮点数和勘误规避路径是最常见的触发源;微码更新通过启动时装载的 SRAM 补丁挂钩替换 ROM 例程,让固件能修硬件策略(Spectre 类缓解即此原理,补丁的慢也正是微码变贵的体现);排查上常规画像正常而 IPC 异常低时,用 IDQ.MS_UOPS 占比、FP_ASSIST 与 MACHINE_CLEARS 三颗 PMU 计数器即可锁定微码方向,再按触发源用 FTZ/DAZ、替换长序列指令、调整数据对齐三招把悬崖填平。