SMT 侧信道:同核超线程共享资源引发的微架构攻击族谱
更新时间:2026-10-06。SMT(Simultaneous Multithreading,同时多线程,Intel 叫 Hyper-Threading)的设计初衷是让一个物理核在两个逻辑线程间共享空闲的执行资源,提高吞吐——背景机制见 SMT 同时多线程。但「共享」在安全语境里就是「泄漏面」:同一核上的两个线程能实时观察到彼此对执行端口、L1 缓存、分支预测器的占用情况,这种观察的分辨率远超跨核共享的 L3,于是 SMT 成了微架构侧信道最肥沃的土壤。2018 年之后,从 PortSmash 到 L1TF 到 MDS 系列,一大批著名攻击的核心条件都是「攻击者与受害者同核」,以至于 OpenBSD 干脆默认关闭 SMT。本篇把 SMT 侧信道的原理、族谱、缓解成本讲透,读完应能独立完成「这台机器要不要关 SMT」的论证,相邻话题见 Spectre 与 Meltdown 瞬态执行 和 KPTI 与 PCID 的微架构成本。
本文要回答的问题
- SMT 兄弟线程之间到底共享了哪些资源,为什么这比跨核共享更危险?
- 代表性的 SMT 侧信道攻击有哪些,各自利用什么资源?
- 缓解手段(关 SMT、core scheduling、L1D flush)各花多少性能?
- 生产环境到底该不该关 SMT,决策依据是什么?
一、共享即泄漏:SMT 的攻击面清单
先回顾 SMT 的共享结构。一个物理核前端译码出两个线程的 µop,混进同一个乱序调度器,按端口空闲情况动态发射。两个线程有各自的架构状态(寄存器、页表基址),但执行资源几乎全共享:执行端口、重排序缓冲区(ROB,现代核按线程静态或动态分区)、load/store buffer、L1d/L1i 缓存、TLB、分支预测器(BTB/PHT)。安全问题的关键是:共享资源的占用状态是可被对方实时测量的——你跑一条指令慢了,可能是因为兄弟线程正占着同一个端口;你访问自己缓存里的数据 miss 了,可能是兄弟线程把你的行挤掉了。
跨核共享的 L3 也有同样问题,但粒度天差地别:L3 的驱逐和命中是几十到上百周期尺度的粗信号,而同核端口争用是单周期尺度的细信号。细到足以逐位重建兄弟线程的密钥运算分支走向——这就是 SMT 侧信道为什么单独成族,也是为什么安全社区的共识是「跨核侧信道要防,同核侧信道要命」。
值得强调的是,SMT 的共享发生在「同时」而不是「先后」。传统缓存侧信道要求攻击者和受害者在同一个核上交替运行(靠调度器切换),残留状态随时间衰减;SMT 下两个线程真并发,攻击者观察的是受害者「当下」的行为,没有衰减窗口,也不用赌调度运气。这个「同时性」是后面所有攻击威力的来源。
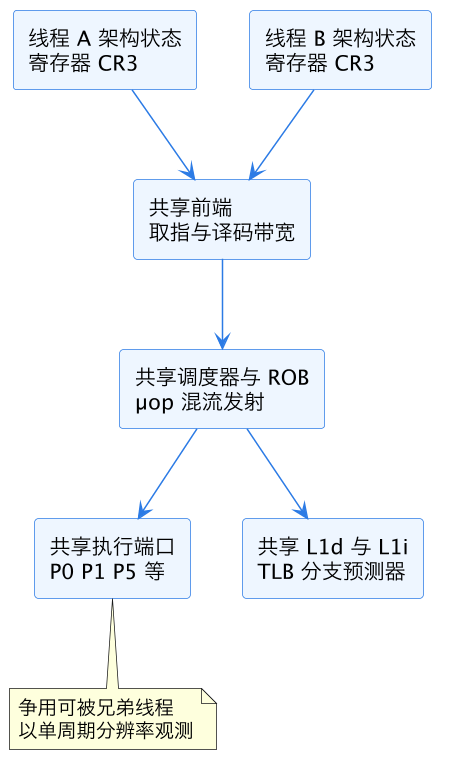
上图里每一项「共享」都对应至少一种已发表的攻击。安全边界画在架构状态(寄存器、CR3 隔开的地址空间)上,而泄漏发生在微架构状态上——这与 Spectre 与 Meltdown 瞬态执行 的教训一致:架构正确不等于微架构安全。
二、族谱:按被共享资源分类
把已发表的代表性攻击按利用的共享资源归类,族谱就清楚了。
| 攻击 | 共享资源 | 信号类型 | 泄漏目标 |
|---|---|---|---|
| PortSmash(2018) | 执行端口争用 | 自己指令延迟变化 | OpenSSL ECDSA 私钥 |
| L1 缓存 Prime+Probe(经典) | L1d 组相联冲突 | 自己数据被驱逐 | 加密查表访问模式 |
| L1TF / Foreshadow(2018) | L1d 在终端错误下的瞬态读取 | 瞬态执行读 L1 残留 | 其他 VM/恩克雷夫内存 |
| MDS/RIDL/Fallout(2019) | 微架构 buffer(FB/存储缓冲)采样 | 瞬态执行读 buffer 残留 | 兄弟线程近期 load/store 数据 |
| 分支预测互扰 | BTB/PHT 共享 | 自己分支被误预测 | 兄弟线程分支走向 |
PortSmash 是最能说明 SMT 独特性的例子:攻击线程和受害者线程跑在同一核的两个超线程上,攻击者循环发一条固定端口指令并精确计时,端口被受害者占用时自己的指令就慢——这个「端口占用时间线」直接编码了受害者分支走向。如果受害者是 OpenSSL 的 ECDSA 签名(其标量乘法分支依赖私钥位),逐位恢复私钥就是信号处理问题。这类攻击不需要任何权限、不触发任何计数器告警,纯靠「同核同居」成立。它还有一个让防御者难受的性质:攻击线程本身的行为(循环发同一条指令)完全合法,PMU 里看不到 cache miss 风暴之类的异常,传统的异常检测手段对它基本失灵。
L1TF 和 MDS 则把 SMT 与瞬态执行结合起来:受害者线程的数据残留在 L1d 或内部 buffer 里,攻击线程通过精心构造的瞬态指令窗口把这些残留「采样」出来再编码到缓存侧信道里。它们的修补依赖微码和内核配合,性能成本后面细说。值得注意的是 L1TF 对虚拟化的打击最大:它让恶意 VM 能读到同核其他 VM 甚至 hypervisor 的内存,直接打破了云厂商最基本的隔离承诺,这也是 2018 年各大云紧急给宿主机做调度策略调整、部分厂商直接给敏感实例类型关 SMT 的直接原因。
三、为什么 SMT 放大一切:分辨率的账
侧信道的本质是信噪比,SMT 把三个关键参数都推向对攻击者有利的方向。一是时间分辨率:同核资源争用无总线传输延迟,信号边沿干净,纳秒级事件可分辨;L3 跨核攻击要经过互连,抖动大得多。二是空间精度:L1 组只有 64 组(典型 32KB/8 路),攻击者用少量探测地址就能覆盖全部组;L3 动辄上千组,Prime+Probe 建组耗时且噪音大。三是同步性:兄弟线程在同一个时钟域里真并发,不存在调度器把两个线程错开的「运气成分」——跨核攻击则要看两个核的相对频率和负载。
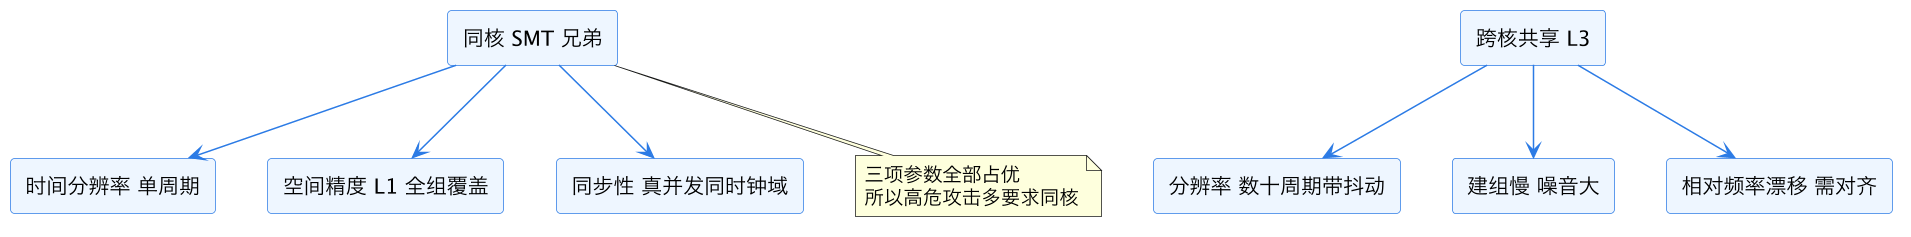
这三项参数解释了为什么多数高危微架构攻击的 PoC 都要求「同核共居」:不是跨核做不到,而是跨核的误码率高到实际攻击(要在有限时间内稳定窃取密钥)不划算。反过来说,只要保证敏感负载不与不可信代码同核,一大批攻击的前提就被釜底抽薪——这正是缓解手段的设计逻辑。
四、缓解手段与性能成本
防御按强度分四层,成本和适用场景各不相同。
| 缓解层 | 做法 | 典型性能成本 | 挡住什么 |
|---|---|---|---|
| 关 SMT | BIOS 关 HT 或 nosmt 内核参数 | 吞吐降 15-30%(视负载) | 几乎全部同核攻击 |
| Core scheduling | 调度器保证同核两线程同信任域 | 调度开销 1-5%,利用率损失 | 跨 VM/跨用户同核攻击 |
| L1D flush | VM 切换/进入用户态前刷 L1d | 每次切换数微秒 | L1TF 类 |
| 微码 + 软件序列化 | VERW 等 buffer 清空指令 | MDS 场景 1-8% | MDS/RIDL 类 |
关 SMT 最彻底也最贵:SMT 的吞吐收益在大流水线气泡负载(数据库、Web 服务)上常见 20-30%,关掉等于白扔这部分硬件预算。OpenBSD 的选择(默认关)是用通用吞吐换安全心智简单,适合威胁模型不明的场景;Linux 生态的主流选择是「按需」——把不可信多租户的云主机和单机高吞吐服务区别对待。
Core scheduling(核级调度)是云厂商的方向:调度器把「信任域」相同的线程才排进同一物理核的两个超线程,不同租户的 vCPU 绝不同核。这样 SMT 的吞吐收益在信任域内部保留,跨域攻击面被消灭。代价是调度器复杂度、负载均衡上的利用率损失(核的两半要成对调度),实测开销通常远小于全关 SMT。Linux 的 core scheduling 用 cgroup 的 cpu.tag 标记信任域,同 tag 的任务才被允许同核;启用方式是内核启动参数或 prctl 接口,生产上多为宿主机 hypervisor 进程打标。L1D flush 和 VERW 类指令则是针对具体 CVE 的精准补丁,成本集中在切换路径上,虚拟化密度高的机器感受明显——每万次 VM entry/exit 各多几微秒,I/O 密集的小实例类型吞吐掉得最狠。
还有一条软件侧的防线:让敏感代码自己「无分支、无查表」。常数时间密码学(constant-time crypto)的整条思路就是不给侧信道留信号——密钥相关的分支全部换成无分支选择(cmov/位运算),密钥相关的查表全部换成 bitslice 或全扫描。主流密码库(OpenSSL 的常数时间路径、BoringSSL、libsodium)在 PortSmash 之后全面加固了椭圆曲线实现。对应用开发者的启示是:自己写的密钥处理逻辑如果存在数据依赖的分支或内存访问,放在开了 SMT 的机器上就是把私钥挂在墙上;要么用库,要么保证部署环境做了核隔离。
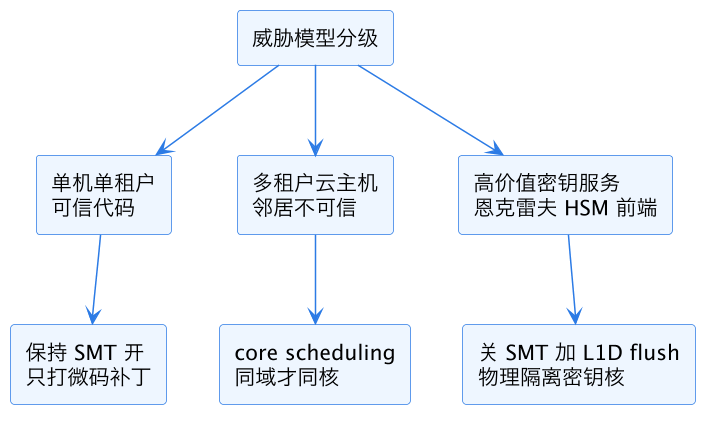
上图的决策树可以落成具体命令:lscpu 看 SMT 拓扑(Thread(s) per core 一行),cat /sys/devices/system/cpu/vulnerabilities/* 一张表列出本机所有已知微架构漏洞及缓解状态(重点看 l1tf、mds、mmio_stale_data 几行),echo off > /sys/devices/system/cpu/smt/control 可在线关 SMT(不用重启,但关的是逻辑核下线,调度器立刻少一半 CPU 可用)。生产变更前务必先压测:关 SMT 后同机吞吐掉多少,取决于负载里流水线气泡的比例,内存密集服务掉得少、计算密集且流水线利用率高的服务掉得多。另外注意虚拟化环境的嵌套视角:宿主机关 SMT 后,VM 内看到的 vCPU 数减半,容量规划和 HPA 阈值都要跟着改,别只改一半。
五、决策框架:该不该关 SMT
把上面的材料收敛成一个可执行的决策清单。第一问:这台机器上会不会跑不可信代码(多租户容器、VM、用户提交的代码、浏览器渲染不可信页面)?不会——保持 SMT 开,只确保微码和内核补丁打满,风险面主要在 Spectre 类进程内攻击,与 SMT 无关。会——进入第二问:不可信代码和敏感负载能不能用 core scheduling 或 cgroup/cpuset 强制分核?能——用它,吞吐损失最小。不能(老内核、异构负载难配)——第三问:敏感负载的价值是否高于 15-30% 的吞吐?是(密钥服务、金融撮合)——关 SMT,物理隔离敏感核;否——接受残余风险,至少开 L1D flush 与全部微码缓解,并用 vulnerabilities 接口审计确认没有漏网项。
还有两个容易被忽略的点。其一,SMT 侧信道对「同核」的定义是物理核,虚拟机里的两个 vCPU 是否同核由 hypervisor 调度决定,租户自己看不到——所以云上敏感负载要么要求 dedicated host/专属核,要么假设邻居不可信并按此设防。其二,侧信道不只偷密钥:PortSmash 类的端口争用信号也能用来做跨 VM 的隐蔽信道(covert channel),在合规要求严格的场景(如某些认证的安全等级),「无共享执行资源」本身就是硬性指标,此时关 SMT 不是权衡而是必须。
性能侧再给一个量化直觉:SMT 的吞吐收益来自「一个线程停顿时另一个线程填流水线气泡」。负载里气泡越多(内存 stall 重的服务),SMT 收益越大,关 SMT 损失越大;负载本身流水线利用率高(密集的 SIMD 计算),SMT 收益本来就小,关了几乎无感。所以「关 SMT 损失 15-30%」是个跨度很大的区间,正确做法是拿自己的负载实测:同一二进制,分别在 smt on 和 smt off(在线切换即可)下打满压测,对比 QPS 与 P99。不少内存密集的在线服务实测关 SMT 后吞吐只掉 5-10%,P99 反而变好——因为少了兄弟线程抢 L1 和端口的干扰,单线程延迟更稳定。这个「P99 改善」的意外收益,让一些延迟敏感团队即便不考虑安全也主动关 SMT。
这一篇在知识体系里的位置
本篇属于 microarch 层「微架构安全」专题的共享资源半边:机制基础见 SMT 同时多线程;横向与 Spectre 与 Meltdown 瞬态执行(瞬态执行维度的攻击)、KPTI 与 PCID 的微架构成本(Meltdown 缓解的性能账)、缓存划分 CAT(用资源隔离压缩共享面的另一个工具)互补。向上回到 CPU 微架构总览。
总结
SMT 侧信道的根源是同核两个超线程以单周期分辨率共享执行端口、L1、TLB 与分支预测器,PortSmash、L1TF、MDS 等攻击把这个共享面变成实时窃听通道;缓解从全关 SMT(吞吐代价 15-30%)到 core scheduling(同信任域才同核)到 L1D flush 分级,正确决策取决于威胁模型——单机可信负载保持开启,多租户云用调度隔离,高价值密钥服务直接关 SMT 加物理隔离。