寄存器重命名实现:RAT 映射表与 RRF 物理寄存器堆的工作原理与恢复机制
更新时间:2026-10-02。寄存器重命名 那篇回答了「为什么重命名」——WAR 和 WAW 这两种假相关纯粹是寄存器名字不够用造成的,给每条指令换一个全新的物理寄存器名字,假相关就凭空消失,乱序执行的空间被打开。那篇结尾留了一个钩子:重命名在硬件里到底怎么做?答案就两件家具——一张映射表 RAT(Register Alias Table,寄存器别名表)和一个物理寄存器堆 RRF(Renamed Register File,也叫 PRF)。这一篇把这两件家具拆开看:表项长什么样、每条指令经过重命名阶段时发生哪三步、物理寄存器什么时候能回收、分支误预测时怎么把整张映射表在几个周期内恢复到正确的旧状态。它是乱序核的中枢神经;上游背景见 CPU 乱序执行 与 CPU 微架构总览,下游衔接 ROB 重排序缓冲 的提交与释放。
本文要回答的问题
- RAT 和 RRF 各自存什么?「架构寄存器」和「物理寄存器」的边界划在哪?
- 一条指令从重命名到提交,映射表经历了哪几步读写?
- 物理寄存器是稀缺资源,旧映射什么时候能安全释放回空闲池?
- 分支误预测或异常时,RAT 怎么快速回滚?检查点快照和 ROB 倒带两条路线差在哪?
- 实际微架构里的合并重命名、move 消除等优化改了哪些环节?
一、两张表的分工:RAT 管「名字」,RRF 管「数据」
先建立一个直觉:程序员看到的 rax、r1、x0 这些寄存器号,在乱序核内部根本不是真实存储单元,只是一个「名字」。乱序核里真正存数据的是一个大得多的物理寄存器堆——比如 ARM 架构名义上只有 31 个通用整数寄存器,而高性能核的整数物理寄存器堆可能有两三百个表项。RAT 就是一张翻译表:给定一个架构寄存器号,查出「它当前的最新值躺在哪个物理寄存器里」。
两类表的分工一句话概括:
- RAT:纯映射,无数据。读端口的输入是架构寄存器号,输出是物理寄存器编号(一个索引)。每个架构寄存器对应一个表项,所以 RAT 很小,几十项而已,但读写端口极多——一个 6 宽的解码重命名级,每周期要读 12 个源操作数映射、写 6 个目的映射,RAT 的端口压力是微架构里数一数二的。
- RRF:真数据存储。表项数是架构寄存器数的好几倍,每项存一个完整的寄存器值(64 位整数、或者 256/512 位向量)。执行单元从 RRF 读操作数、往 RRF 写结果。RRF 很大但端口可以按需做分簇(clustering),代价后面讲。
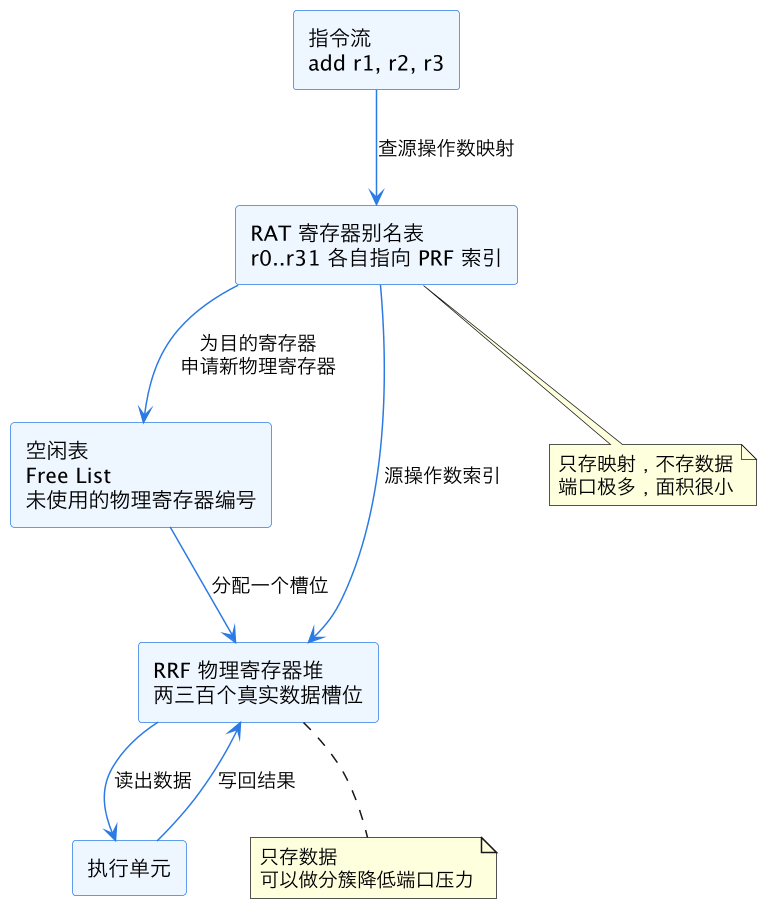
上图是整个重命名舞台的布景。注意信息流的方向:指令到了重命名级,先拿源寄存器号去 RAT 查「现在该读哪个物理槽」,再为目的寄存器从空闲表申请一个全新槽位、把 RAT 里该架构寄存器的表项改成指向新槽位。一条指令走完,RAT 被读两次(两个源)写一次(一个目的)——这就是「重命名」这个名字的实质:目的寄存器被起了一个新名字(新物理槽),旧名字对应的旧数据原封不动留在旧槽里,谁还需要它谁去读。
二、一条指令的三步:查表、分配、改映射
把上面的话拆成精确的三步操作。以 add r1, r2, r3 为例,假设此刻 RAT 里 r2 指向 P17、r3 指向 P23,r1 的旧值在 P05。
第一步,读源映射:用 r2、r3 查 RAT,得到物理编号 P17、P23,随指令一起塞进发射队列(reservation station)。指令在乱序核里游荡期间,记住的永远只是物理编号——它不再关心架构名字,这是假相关消失的关键:下一条指令如果也写 r2,它会申请另一个新物理槽,两条指令的 r2 从此是两套数据,互不干扰。
第二步,分配目的映射:从空闲表头部弹出一个物理编号,比如 P42。空闲表通常就是一个 FIFO 队列,分配是 O(1) 的弹出。物理寄存器耗尽时重命名级直接停摆(stall)——这是乱序窗口被「寄存器数量」而不是 ROB 容量卡住的场景,分析见 ROB 大小与乱序窗口。
第三步,更新 RAT:把 r1 的表项从 P05 改成 P42,同时把旧映射 P05 记进指令的 ROB 项里。注意这里「记旧映射」这个动作是后面释放机制的全部伏笔:RAT 写完后,P05 的命运就悬着了——它存着 r1 的旧值,但当前 RAT 已经没有任何表项指向它。它什么时候能回空闲表?这就是下一节的问题。
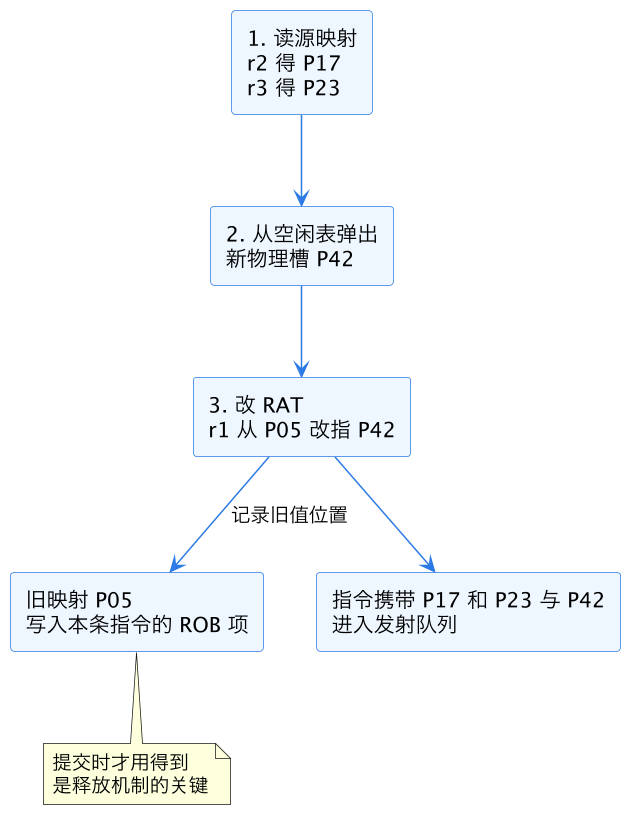
三步里只有第三步写 RAT,而且写的内容(新映射)和 ROB 项里记的内容(旧映射)方向相反——RAT 永远指向「最新」,ROB 项记住「被覆盖前的上一个」。这个一前一后的配对,是理解释放与恢复两条机制的总钥匙。
三、物理寄存器的回收:释放时机为什么必须等提交
P05 什么时候能回空闲表?直觉答案是「当没有任何指令需要它的时候」,但「没有指令需要」这个判断在乱序核里非常微妙,因为有两种看似合理、实际一宽一严的答案。
宽的答案:当覆盖它的那条 add 指令自己执行完、新值 P42 已经写进 RRF 时,P05 就可以释放。错。因为执行完不等于安全——如果这条 add 前面有一条还没执行的分支,而那条分支恰好猜错了方向,整条投机路径要被抹掉,架构状态要回滚到分支之前。回滚后 r1 的正确值恰恰是 P05 里那份旧数据。P05 提前释放了,回滚就没有材料了。
严的答案(也是真实硬件采用的):P05 必须等到「覆盖它的指令正式提交(retire)」才能释放。提交的定义见 ROB 重排序缓冲:指令成为 ROB 头部、之前的指令全部无异常完成,此刻它之前的所有分支都已揭晓、它本身不会再被回滚。此时 P05 代表的那份旧值才真正无人需要——架构状态已经翻篇到 P42。提交逻辑把 ROB 项里记的旧映射 P05 推回空闲表尾部,完成一个物理寄存器的完整生命周期:空闲表弹出 → 被 RAT 指向 → 被新映射覆盖 → 提交后回到空闲表。
这套「提交时释放旧映射」的机制天然保证了精确异常(见 精确异常与流水线冲刷):任何时刻,从已提交指令的旧映射链可以重建出任意历史点的架构状态。释放是性能机制与正确性机制的交汇点。
下面用一张简表把三种「看似可以释放」的时机排个序,错误的直觉往往来自没分清「执行完成」和「提交」:
| 时机 | 能释放吗 | 原因 |
|---|---|---|
| 指令执行完、结果写回 RRF | 不能 | 之前未揭晓的分支可能误预测,需要回滚到旧值 |
| 指令成为 ROB 头但未提交 | 不能 | 指令自身可能触发异常,异常点状态要用旧值重建 |
| 指令正式提交 | 能 | 之前的分支全部揭晓、自身无异常,旧值永久作废 |
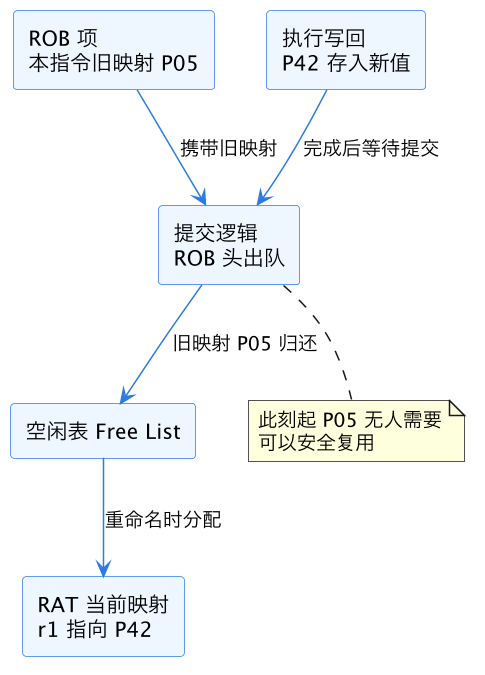
上图是物理寄存器的生命周期闭环。注意箭头「旧映射 P05 归还」是从提交逻辑出发的——不是从执行单元,也不是从重命名级。很多文章画错这张图,把释放箭头画在执行写回之后,那是把「执行完」误当「提交」的典型错误。
四、误预测恢复:RAT 怎么几周期内回到旧状态
分支误预测或异常发生时,问题反过来:RAT 已经被投机路径上的几十条指令改得面目全非,必须恢复到分支点(或异常点)那一刻的映射。两条主流路线。
路线一:ROB 倒带(walk-back / gradual recovery)。利用每个 ROB 项里记的旧映射,从 ROB 尾部往误预测点逐条「撤销」:每撤销一条,把它的目的寄存器 RAT 表项改回旧映射,同时把新物理槽直接扔回空闲表。优点是不花额外面积,所有恢复材料本来就在 ROB 里;缺点是恢复速度和提交端口共享带宽,一次误预测可能要花几十上百个周期倒带。早期的 P6 家族(Pentium Pro/II/III)就是这么干的。
路线二:重命名检查点(checkpoint / flash recovery)。每当重命名级遇到一条分支指令,顺手把整张 RAT 拍一张快照存起来(RAT 才几十项,每项就是个小编号,一张快照只有几百比特,存十几二十张快照的代价可控)。误预测揭晓时,找到该分支对应的快照,一次写回 RAT——这就是所谓「flash restore」,几个周期搞定。空闲表的恢复稍麻烦一点:快照里也要记下当时空闲表的指针或位图,或者用「释放位图」旁路重建。Intel 从 Core 2 时代、ARM 各高性能核基本都走这条路线。这条路线和分支预测器的投机历史恢复共享同一套「预测时拍快照、失败时回滚」哲学,重命名检查点与分支恢复 有专门展开。
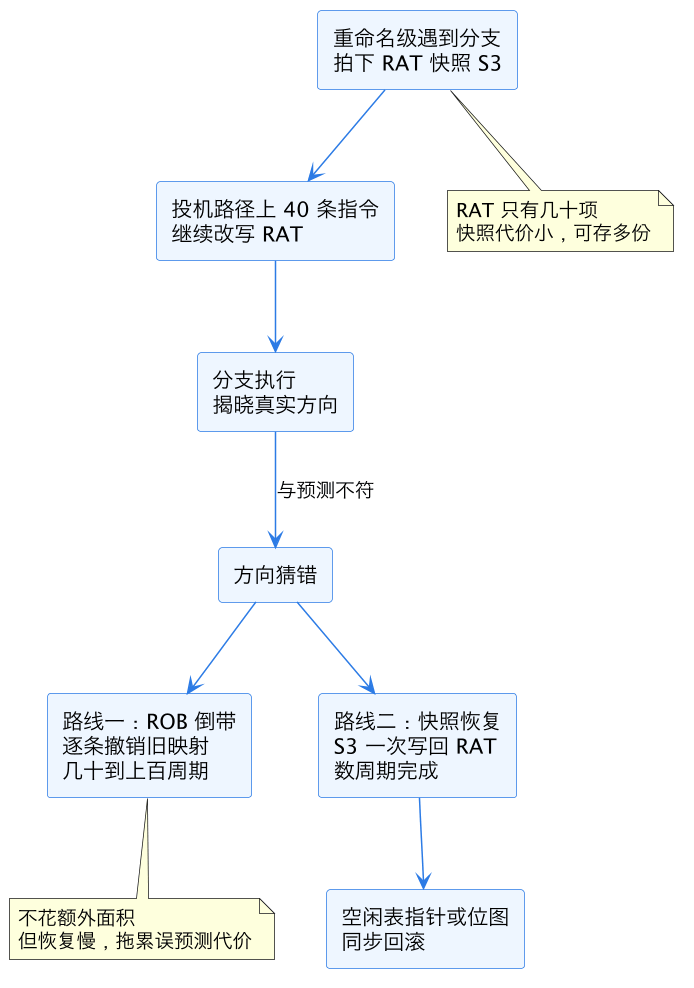
上图把两条路线并排画了出来。现代高性能核的误预测总代价大致是「前端重新取指的十几二十个周期」,如果 RAT 恢复本身就要上百周期,分支预测精度再高也白搭——这就是为什么 checkpoint 路线成了主流。恢复之后还有一件小事:ROB 里误预测点之后的所有项被打上「清空」标记,发射队列里的投机指令作废,这部分与 精确异常与流水线冲刷 里的冲刷流程共用硬件。
五、工程变体:合并 RAT、move 消除与端口分簇
纸面机制之外,真实芯片还有三个值得知道的变体。
第一个是「两张 RAT」问题。前面讲的 RAT 其实是「投机 RAT」(frontend/rename RAT),它跟着投机执行跑。但提交时还要维护一份「退休 RAT」(retirement RAT / RRAT),只记录已提交指令确立的映射,供异常恢复时精确重建。有些设计把两者合并成一张表加每指令快照,有些设计真的做两张物理表。合并省面积,分开则异常恢复不用倒带、直接读 RRAT。这是「投机状态」与「架构状态」分离这一乱序核根本原则在重命名模块的具体投影,乱序、重命名与退休 讲了这个三段式骨架。
第二个是 move 消除与零惯用法。mov r1, r2 这种纯拷贝指令,本质只是改个名字,根本不需要进执行单元:重命名级直接把 RAT 里 r1 改成指向 r2 当前的那个物理槽就完事,零执行资源、零延迟。同理 xor r1, r1(清零惯用法)直接分配一个已知为零的物理槽。这些优化把重命名级从「翻译站」升级成了「半个执行单元」,详见 move 消除与零惯用法。它们不占 ALU、不占发射槽,在跑满的重命名宽度下等于白捡 IPC。
第三个是 RRF 的端口分簇。RRF 两三百项、每项 64 位起,还要给每个执行单元配两个读端口一个写端口,全连通的话读端口面积爆炸。实际做法是把物理寄存器堆切成若干簇(cluster),每个执行单元组只直连自己那簇;结果写到目的槽所在簇,源操作数如果不在本簇,就要走跨簇搬运(多花一两个周期)。调度器挑发射槽时会感知操作数所在的簇——这就是「集群化微架构」(clustered microarchitecture),重命名时分配物理槽要考虑「这个结果被谁消费」,而不是无脑弹空闲表头部。它和 发射队列的唤醒选择 里讲的调度决策是耦合的。
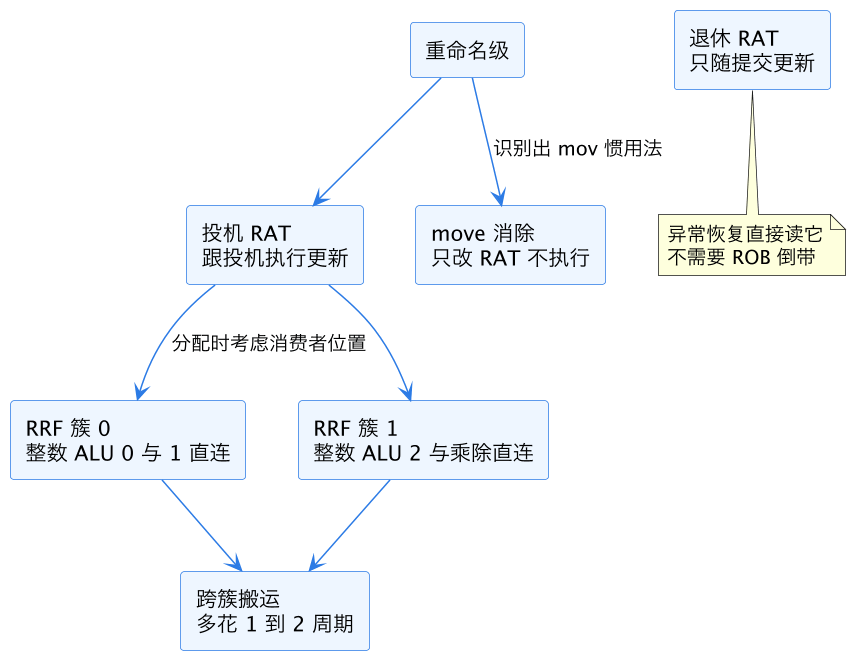
上图把三个变体画在一起:中间是两张 RAT 的分工,两侧是 RRF 分簇和跨簇搬运,旁边是旁路执行单元的 move 消除。三者共同的潜台词是:重命名模块早已不是「一张小表」那么简单,它是决定乱序核宽度能不能喂饱执行单元的咽喉。
最后给一个尺寸直觉表,把上面提到的结构数量级钉死(以 2020 年代高性能核为参照):
| 结构 | 典型规模 | 备注 |
|---|---|---|
| 架构寄存器 | 16 到 32 个 | 指令集定义,RAT 表项数 |
| 物理整数寄存器堆 | 180 到 330 项 | 决定乱序窗口的寄存器侧上限 |
| RAT 检查点份数 | 8 到 32 份 | 限制在飞分支的最大数量 |
| 空闲表分配带宽 | 每周期 4 到 8 个 | 与重命名宽度对齐 |
| 快照恢复延迟 | 数周期 | 倒带路线则要数十到上百周期 |
这一篇在知识体系里的位置
本篇是微架构模块乱序执行线「重命名专题」的实现篇。上游动机文是 寄存器重命名(为什么需要换名字)与 CPU 乱序执行(整体框架),假相关的分类源头见 数据冒险。同线相邻的是 重命名检查点与分支恢复(恢复机制专题)、乱序、重命名与退休(三段式骨架)、move 消除与零惯用法(重命名级优化)。下游衔接 ROB 重排序缓冲 与 ROB 大小与乱序窗口(提交与释放)、发射队列的唤醒选择(重命名的下一站)、精确异常与流水线冲刷(恢复语义)。全景地图见 CPU 微架构总览。
总结
寄存器重命名的硬件实现就两张表:RAT 寄存器别名表维护「架构寄存器到物理寄存器」的映射、只存编号不存数据,RRF 物理寄存器堆存真实数据、容量是架构寄存器的好几倍;每条指令重命名时读源映射、从空闲表弹一个新物理槽、改写目的映射并把旧映射记进 ROB 项,旧物理寄存器必须等覆盖它的指令正式提交才能安全释放回空闲表;分支误预测时,现代核靠重命名级给每条分支拍的 RAT 快照做数周期的一次性回滚,而不是沿 ROB 逐条倒带——这套「映射加快照加提交时释放」的组合,是乱序核能同时做到宽发射、深投机和精确异常的底层地基。