retpoline IBRS 性能成本:间接分支缓解对预测器的真实代价与实测回归
更新时间:2026-10-03。Spectre 与 Meltdown 瞬态执行 讲了漏洞本身的成因——分支预测器的投机执行可以被诱导去访问不该访问的内存,再通过缓存侧信道把秘密漏出来。漏洞公开之后,软硬件厂商各自交了自己的「补丁答卷」:硬件侧是 IBRS(Indirect Branch Restricted Speculation,间接分支受限预测)这组 MSR 开关,软件编译器侧是 retpoline(return trampoline,返回跳板)。两条路线都能堵住 Spectre v2,但堵法完全不同,代价也落在完全不同的微架构结构上——retpoline 折腾的是 返回地址栈 RAS,IBRS 折腾的是整个 间接分支预测 通路和 BTB 分支目标缓冲。这一篇把两种手段在预测器层面的真实代价拆开算,并给出用 perf 实测回归幅度的方法。同批还有一篇姊妹文 KPTI PCID 微架构成本,讲 Meltdown 缓解的页表隔离开销,两篇合看就是当年那场漏洞大补丁的完整账单。
本文要回答的问题
- retpoline 的原理是什么?为什么说它是「用已知安全的预测器替换不安全的预测器」?
- IBRS、STIBP、IBPB 这组硬件开关各自限制了投机执行的哪一环?
- retpoline 为什么会让
ret指令变慢?RAS 污染和 RSB 欠载(underfill)是怎么回事? - 实测回归幅度有多大?哪些负载(系统调用密集、间接跳转密集)最受伤?
- 排查生产环境性能回退时,怎么判断是 retpoline 还是 IBRS 在收税?
一、背景一分钟回顾:Spectre v2 攻击的正是间接分支预测器
Spectre v2(分支目标注入)的攻击面非常具体:间接分支(jmp *%rax、call *%rbx、虚函数调用、函数指针、switch 跳转表)的目标地址不是静态写在指令里的,要靠 BTB 与间接分支预测器 去猜。攻击者只要在自己的地址空间里用精心构造的地址训练预测器,再切到受害者上下文执行一条同地址低比特位相同的间接分支,受害者的投机执行就会跳到攻击者指定的 gadget 上。预测的「历史」是跨上下文共享的,这是问题根源。
防御的逻辑由此只有两条路:
- 别让间接分支用预测器——IBRS 路线,直接在微架构里给投机执行上锁。
- 把间接分支改写成别的东西——retpoline 路线,编译器把所有间接
call/jmp改写成一段「预测器能安全预测」的跳板代码。
两条路线的分水岭在于:IBRS 是「牺牲预测性能保正确性」,retpoline 是「牺牲代码路径换预测可用」。下面分别看它们各自动了哪块结构。
二、retpoline:把间接调用改写成 RAS 可预测的跳板
retpoline 的核心观察是:RAS(返回地址栈)是一个不依赖历史训练的预测器——call 压栈、ret 弹栈,硬件保证栈顶就是正确的返回地址(只要栈没被冲刷或溢出)。既然 BTB 和间接预测器不可信,那就绕开它们,把间接跳转伪装成一次 ret,让 RAS 来做预测。关于 RAS 本身的结构与容量,见 返回地址栈。
以 GCC 生成的 call *%rax 的 retpoline 版本为例,原指令被替换成对一段 thunk(跳板)的调用:
call __x86_indirect_thunk_rax
; thunk 内部:
;   call set_up_target      ; 压入「捕获循环」的地址到 RAS
; capture_speculation:
;   pause; lfence           ; 投机执行陷在这里空转
;   jmp capture_speculation
; set_up_target:
;   mov %rax, (%rsp)        ; 把真实目标写到栈顶,覆盖返回地址
; ret ; RAS 预测跳到 capture_speculation(无害)真实路径上,ret 弹出的返回地址已被 mov 改成真实目标,CPU 最终走对路;投机路径上,ret 用 RAS 栈顶预测,跳进一个 pause; lfence 的死循环——投机执行被无害地困住,摸不到任何 gadget。
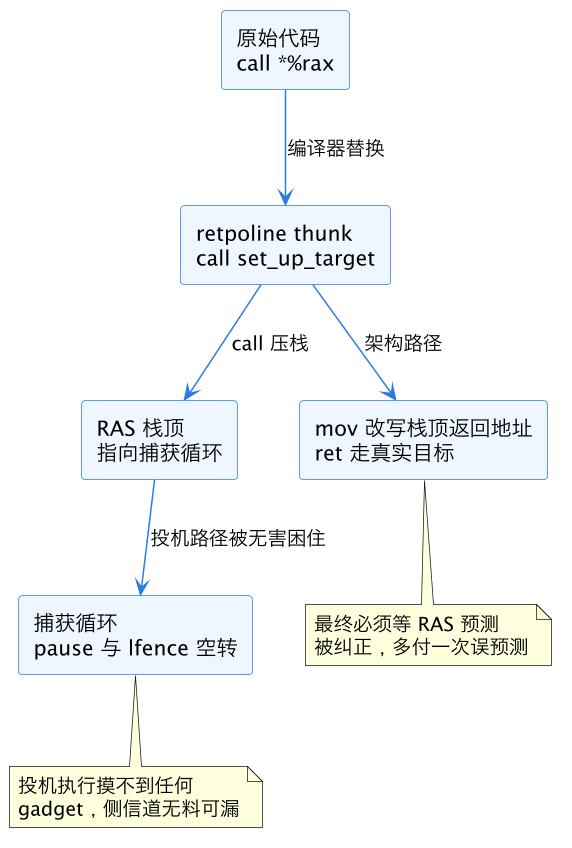
上图的关键在两条路径的分叉:架构路径(真实执行)是对的,但投机路径被故意引到死循环。代价藏在「最终必须等 RAS 预测被纠正」这一步——处理器先按 RAS 猜的方向取指执行,等 ret 指令真正解析出栈顶新值时才发现猜错了,要冲刷重取。也就是说,每一次 retpoline 化的间接调用,都内建了一次「良性误预测」。
retpoline 的三笔微架构税
第一笔,良性误预测税。ret 的投机目标(捕获循环)和真实目标必然不一致,每次间接调用都白付一次约 15-20 周期的前端冲刷,等价于 取指重定向气泡 的代价。间接调用越频繁,税越重。
第二笔,RAS 污染税。thunk 内部的 call set_up_target 会往 RAS 压一个条目,却没配对的 ret 把它正确弹掉(那个 ret 被挪用去跳真实目标了)。多次嵌套调用后,RAS 里混进大量 thunk 地址,把真正 call/ret 配对的栈条目挤出去或盖掉——RAS 容量本就有限(16-32 项),普通函数返回的预测精度随之下降。这就是所谓的 RSB(return stack buffer)污染。
第三笔,RSB 欠载税。更深的坑在上下文切换和中断:某些微架构上,进入内核态或 SMI(系统管理中断)会把 RSB 部分冲刷,回来后 ret 的预测源空了,会退化到 BTB 预测——而 BTB 恰恰是不可信的那个。所以内核还要配合 RSB stuffing(返回前人为压 32 个无害地址填满 RSB)堵漏,这又是一笔每次进入内核都要付的固定开销。这也是为什么开缓解后内核的 entry_SYSCALL_64 路径会比裸机版本长出几十条指令—— stuffing 循环本身就是指令数。
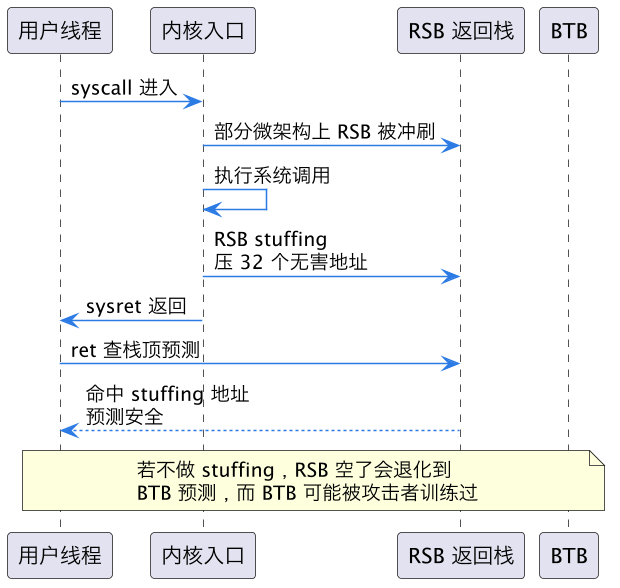
上图是 RSB stuffing 的时序。注意 stuffing 发生在内核返回用户态之前——它本质上是内核替用户线程「预存」了一叠无害的预测弹药,让用户态后续的 ret 即使遇到 RSB 欠载,猜到的也只是内核放的兜底地址而不是 BTB 里可能被污染的目标。这一步在缓解补丁里是隐形的,但它解释了为什么 ltrace/strace 级别的系统调用追踪在开缓解后每条调用都变贵了:路径上多了一整个填充循环。
三、IBRS:直接关掉间接分支的投机引擎
IBRS 的思路简单粗暴:软件通过 MSR(IA32_SPEC_CTRL)置位 IBRS 后,只要该位有效,间接分支预测器的预测结果对投机执行「不可信」——在 IBRS 生效的特权环里,间接分支要么不做目标预测、强制停顿直到目标地址真正算出,要么被限制只能用本特权环训练出来的预测条目(具体行为随微架构代次不同,早期实现接近「冻结」,后期是「隔离」)。
它有两个伴侣开关,合起来才是完整方案:
| 开关 | 全称 | 作用 | 代价落点 |
|---|---|---|---|
| IBRS | Indirect Branch Restricted Speculation | 高特权环运行时限制间接分支投机 | 每次进出内核写 MSR,加预测冻结 |
| STIBP | Speculative Store Bypass 的邻居:Single Thread Indirect Branch Predictors | 禁止 SMT 兄弟线程共享间接预测条目 | 预测容量减半,命中率下降 |
| IBPB | Indirect Branch Prediction Barrier | 上下文切换时冲刷间接预测器历史 | 每次切换清空,冷启动重新训练 |
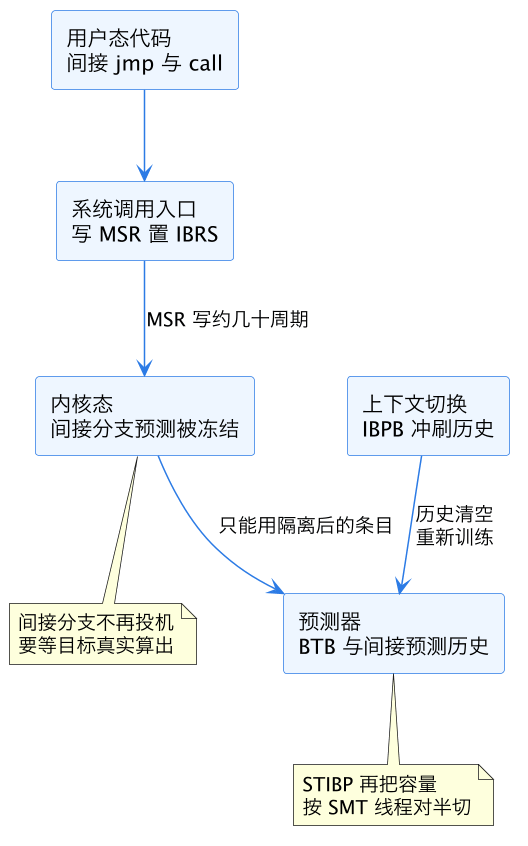
上图里三笔税一目了然:MSR 写的固定开销(wrmsr 是序列化程度较高的操作,几十周期起)、预测冻结带来的流水线停顿(间接分支目标要等真实计算,深流水线里等于每次都吃满冒泡)、IBPB 冲刷后的预测器冷启动(切换后一段时间内间接分支大量误预测)。系统调用密集的负载(网络栈、存储 IO、getpid 级别的小调用高频路径)把这三笔税按调用次数重复缴纳,这就是当年实测里 Nginx、Redis、数据库负载回归 20%-50% 的来源。
四、代价对比:谁动了哪个预测结构
把两条路线的微架构账单并排摊开:
| 维度 | retpoline | IBRS |
|---|---|---|
| 作用位置 | 用户态与内核的每个间接调用点 | 特权环边界,MSR 全局开关 |
| 伤到的结构 | RAS 被污染与欠载,加每次一次良性误预测 | BTB 与间接预测器被冻结或冲刷 |
普通 call/ret 函数调用 | 受伤(RAS 容量被 thunk 挤占) | 基本不伤 |
| 间接调用密集代码(虚函数、函数指针) | 每调用一次约 15-25 周期 | 停顿更深,且不可恢复 |
| 系统调用密集负载 | 几乎无感(税在调用点不在边界) | 每次进出内核双倍收税 |
| 部署方式 | 全量重编译 | 内核开关加微码,无需重编译 |
这张表也解释了为什么 Linux 内核最终走「两者混用」:内核代码自己能重编译,用 retpoline 挡内核内部的间接调用;对不能重编译的固件、虚拟机监控器边界,以及老 CPU 上没有更优解的场景,保留 IBRS。到 Skylake 之后的几代微架构,Intel 又补了 eIBRS(enhanced IBRS,特权环间预测条目真正隔离而不是冻结)和之后的 Automatic IBRS,把「置位后预测器仍可用、只是跨环条目隔离」做进了硬件,税从「冻结」降为「隔离」;再往后(Alder Lake 起)还有 BHI 等变种补丁继续微调。所以「IBRS 很贵」这句话严格说只完整成立在 Skylake 及更早的 CPU 上。
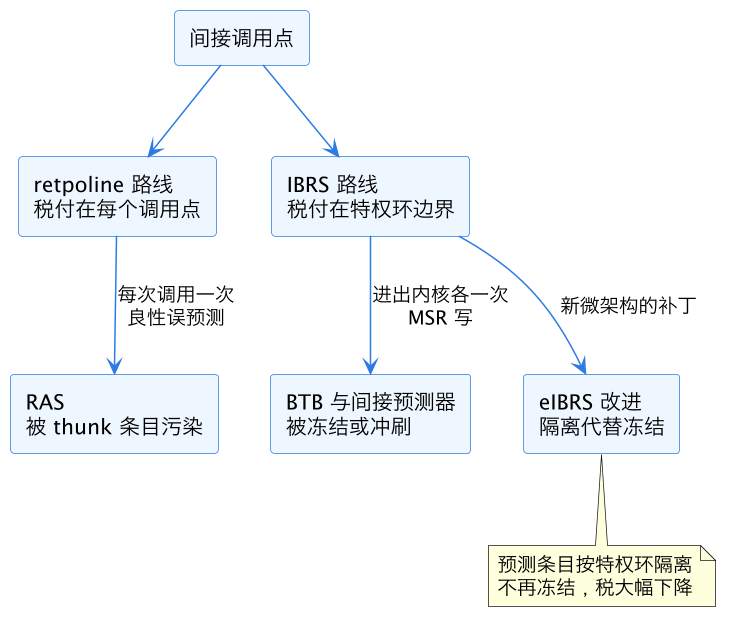
上图把「税付在哪」画成两个不同的落点:retpoline 的税颗粒度是「每个间接调用点」,IBRS 的税颗粒度是「每次特权环穿越」。判断自己的负载谁更贵,数清楚这两个事件的频率之比就有答案了。
五、实测方法:用 perf 把回归拆到结构层面
怀疑缓解手段在收税,不要只看吞吐掉了多少,要把回归归因到预测器事件上。方法分三步。
第一步,看全局指标。perf stat 跑负载前后对比,重点看 branch-misses、instructions(retpoline 会让指令数明显变多,thunk 是实打实多出来的代码)和 IPC。指令数涨了 5%-15% 而 IPC 又掉了,retpoline 的嫌疑很大。
第二步,看具体事件。用 perf 计数器与 PMU 编程 里的方法抓微架构事件:BR_MISP_RETIRED.INDIRECT 类事件看间接分支误预测率,MACHINE_CLEARS 看冲刷次数;RSB 相关有专门事件(如 Intel 的 RSB_UNDERFLOW 或在部分代次上的等效计数)。开/关缓解(mitigations=off 内核参数,仅限实验机)各跑一次,事件增量就是税的精确金额。
第三步,按负载形态归因。给一个经验对照表:
| 负载形态 | 主要税种 | 典型回归幅度 |
|---|---|---|
| 系统调用密集(Redis、Nginx、IO 压测) | IBRS 的 MSR 写与预测冻结 | 老 CPU 上 20%-50%,eIBRS 后 5%-15% |
| 间接跳转密集(解释器、虚函数热路径) | retpoline 良性误预测加 RAS 污染 | 5%-30%,视调用密度 |
| 普通函数调用为主的计算负载 | retpoline 的 RAS 挤占(轻度) | 0%-5% |
| 纯顺序计算(BLAS 类) | 几乎无税 | 1% 以内 |
归因时配合 Top-down 分析方法论:如果 Bad Speculation 槽位占比显著上升,是预测器在交税;如果是 Frontend Bound 上升,多半是 thunk 代码膨胀把取指路径撑大了。两个槽位指向不同的缓解手段,别混在一起猜。
最后提醒一个排错时容易踩的坑:确认当前机器实际启用了哪种缓解,别凭印象。看 /sys/devices/system/cpu/vulnerabilities/spectre_v2 这一行,内核会明确告诉你当前生效的组合(比如 Mitigation: Retpolines; IBPB: conditional; IBRS_FW; STIBP: always-on),再看 /proc/cmdline 里有没有 spectre_v2=、retpoline=、ibrs 之类的覆写参数。同一份二进制在两台「看起来一样」的机器上回归幅度差一倍,十有八九是其中一台的固件没更新微码、IBRS 走的是固件模拟的老路径,或者 SMT 开着导致 STIBP 强制生效。先把「税单开具方」核实清楚,再谈优化——比如对确定无攻击面的内网计算节点,用 mitigations=off 或在支持 eIBRS 的新机器上整体换代,往往比改代码划算得多。
这一篇在知识体系里的位置
本篇是微架构模块「瞬态执行漏洞与缓解」线的代价篇。漏洞原理见 Spectre 与 Meltdown 瞬态执行;被缓解手段波及的预测结构分别在 返回地址栈、间接分支预测、间接分支预测器 ITTAGE 和 BTB 分支目标缓冲 有专门展开;良性误预测的冲刷代价衔接 取指重定向气泡 与 精确异常与流水线冲刷。姊妹篇 KPTI PCID 微架构成本 讲 Meltdown 侧的开销。实测方法论见 perf 计数器与 PMU 编程 与 Top-down 分析方法论,全景见 CPU 微架构总览。
总结
retpoline 与 IBRS 是 Spectre v2 的两条互补防线,代价落在完全不同的预测结构上:retpoline 把每个间接调用改写成「故意让 RAS 猜错再纠正」的跳板,每次调用内建一次 15-20 周期的良性误预测,thunk 的非配对 call 还会污染 RAS 容量、逼内核做 RSB stuffing;IBRS 则在特权环边界写 MSR 冻结间接分支投机,配 STIBP 切半预测容量、IBPB 冲刷历史,系统调用密集负载在 Skylake 及更早 CPU 上实测回归可达 20%-50%,eIBRS 之后靠「隔离代替冻结」才把税压回个位数——用 perf 抓 branch-misses、间接误预测与冲刷事件、再看 Top-down 的 Bad Speculation 与 Frontend Bound 槽位,就能把一笔模糊的「性能回退」精确归因到是哪个缓解手段、动了哪个预测器。