Chiplet 多 Die 一致性:CCD 与 IO-Die 的延迟分层、EMIB 与 Foveros 封装及缓存命中位置敏感度
更新时间:2026-10-03。单 die 时代的缓存一致性协议——MESI/MOESI 等一致性协议、目录式与侦听式一致性——讨论的都是「一个硅片内部」的事:核与核之间走片上互连,一次 snoop 往返几十个周期。chiplet(小芯片)时代把这个假设打破了:一颗处理器被拆成多块硅片,用封装基板上的互连缝起来,一致性协议不变,但协议的「路费」变了——跨 die 一跳就是几十纳秒,比片内贵一个数量级。于是出现了一个新的性能维度:缓存行命中在哪个 die 上,直接决定一次访存是 40 拍还是 200 拍。这一篇把 chiplet 多 die 一致性的延迟分层讲透:AMD 的 CCD 加 IO-Die、Intel 的 EMIB 和 Foveros 各自怎么拼、为什么拼出来的一致性延迟呈现明显的阶梯。上游背景见 NUMA 本地远端延迟 与 CPU 微架构总览,片内互连细节见 NoC 信用流控。
本文要回答的问题
- 为什么厂商要把一颗大 die 拆成多个 chiplet?良率和成本账怎么算?
- AMD 的 CCD 与 IO-Die 各管什么?为什么所有访存都要绕 IO-Die?
- EMIB、CoWoS、Foveros 这些封装互连的带宽和延迟差多少?
- 跨 die 一致性请求比片内慢在哪一跳?延迟阶梯具体长什么样?
- 「缓存命中位置敏感度」对软件意味着什么?调优抓手有哪些?
一、为什么拆:大 die 的良率墙与 chiplet 的成本账
先回答「为什么自找麻烦」。单 die 做 64 核,芯片面积奔着 700 平方毫米以上去,而光刻 reticle 的极限也就 800 多。更要命的是良率:缺陷密度大致不变的前提下,die 面积翻倍,良率不是减半而是指数下滑——一片晶圆上有效 die 数急剧缩水。把 64 核拆成 8 个 8 核的小 die,每个 die 良率接近 99%,封装时挑好的拼(这叫已知良品裸片,KGD),总成本反而更低。还有一个隐性好处:不同部件可以用不同工艺——核心计算部分用最先进的 5nm、4nm 追频率,IO 和内存控制器这些对频率不敏感、对模拟特性敏感的部分留在 12nm、6nm 等成熟工艺上省钱。
代价就一句话:一致性协议的路费变贵了。片内 NoC 一跳 1 到 2 纳秒,跨 die 一跳少则 5 纳秒多则 20 纳秒,而且带宽还受凸点(bump)数量和 PHY 功耗的双重约束。芯片设计师的应对不是消灭跨 die 流量,而是用体系结构手段把跨 die 流量降到最低——这正是后面几节所有设计决策的动机。
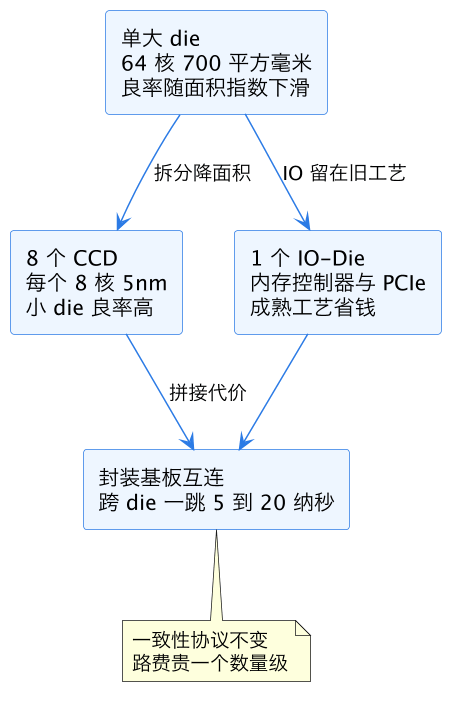
上图是拆分的动机全景:左边是被良率墙逼退的单大 die,右边是拆出来的两类 chiplet——计算 die 和 IO die,底部是所有拆分方案共同的代价中心「封装基板互连」。注意拆分不是免费的午餐,而是把良率成本换成了延迟成本,后面所有优化都是在还这笔延迟债。
二、AMD 路线图:CCD 纯计算,IO-Die 集大成
AMD Zen 2 开始的布局是教科书级的职责切分。CCD(Core Chiplet Die)里只有核和三级缓存:8 个 Zen 核、32MB 的 L3,不带内存控制器、不带 PCIe 根复合体,连「内存地址是什么」都不知道。IO-Die 里装着内存控制器(DRAM PHY)、PCIe 控制器、以及最关键的一致性枢纽——一致性主控和地址映射逻辑。所有 CCD 通过 Infinity Fabric over package 接到 IO-Die。
这个结构引出一个反直觉的事实:CCD 里的核连访问自己 L3 未命中后的内存数据,都必须出 die 走一趟 IO-Die。哪怕这个 CCD 管理的内存地址段就在物理上「最靠近」它的内存通道——决定权不在 CCD,地址到内存通道的映射表只存在于 IO-Die 里。于是任何一次 DRAM 访问的最短路径都是:CCD 发出请求 → 跨 die 到 IO-Die → IO-Die 查地址映射 → 找对应内存控制器 → 读 DRAM → 原路返回。这就是为什么 Zen 的内存延迟比同期单 die 的 Intel 桌面处理器高 10 到 20 纳秒。
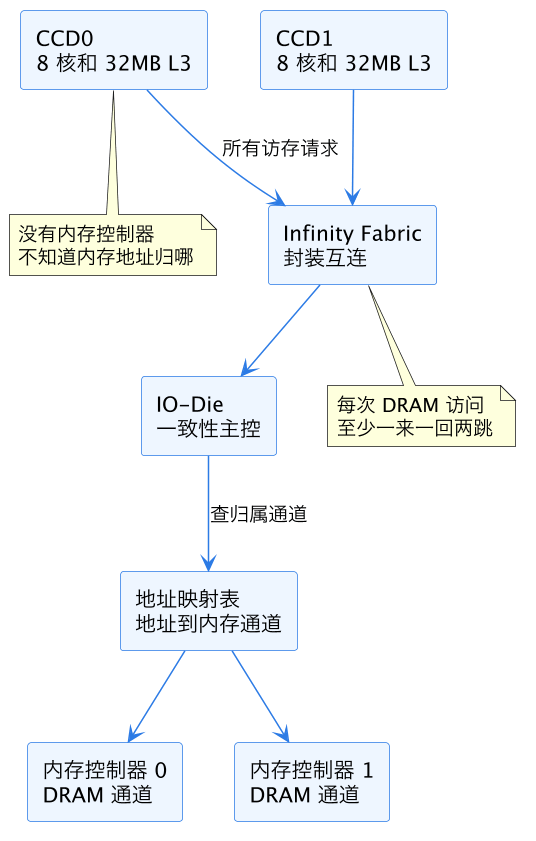
上图把「所有访存必绕 IO-Die」画成了实物流向。两个 CCD 地位完全对称——这是对称多 die 设计的好处,任何核看到的远端延迟结构一致,调度器不用区分「哪个 CCD 离哪个内存通道近」;坏处是没有捷径,本 CCD 缓存没命中就注定要付跨 die 路费。CCD 之间的数据共享也走同一个枢纽:核 A 想读核 B(在另一个 CCD)修改过的缓存行,请求先到 IO-Die 的一致性主控,主控转发到对方 CCD 取数,再送回——三跳起步。
三、Intel 路线图:EMIB 平面搭桥,Foveros 立体堆叠
Intel 走了另一条路:不把 IO 集中到一个 die,而是用更密的封装互连把多个 tile 拼成「逻辑上像一个 die」的形态。两种关键技术。
EMIB(Embedded Multi-die Interconnect Bridge,嵌入式多 die 互连桥):在封装基板里埋一小片硅桥,桥上的布线密度做到微米级线宽,远超有机基板的布线能力。两个 die 通过硅桥对接,接口是 AIB 或 UCIe 这类 die-to-die 标准,单链路带宽密度可以到每毫米边沿几百 GB/s,能效约每比特 1 到 2 皮焦。跨 die 延迟压到 5 纳秒上下。Ponte Vecchio、Sapphire Rapids 的四个 compute tile 就靠 EMIB 互连。
Foveros 更进一步:垂直堆叠。base die 铺在下面(可以用成熟工艺做缓存和 IO),compute die 用 TSV(硅通孔)面对面扣在上面,凸点间距从 EMIB 的 55 微米缩到 36 微米甚至 25 微米,互连密度再上一个台阶。Meteor Lake 和 Lunar Lake 是 Foveros 的量产代表。
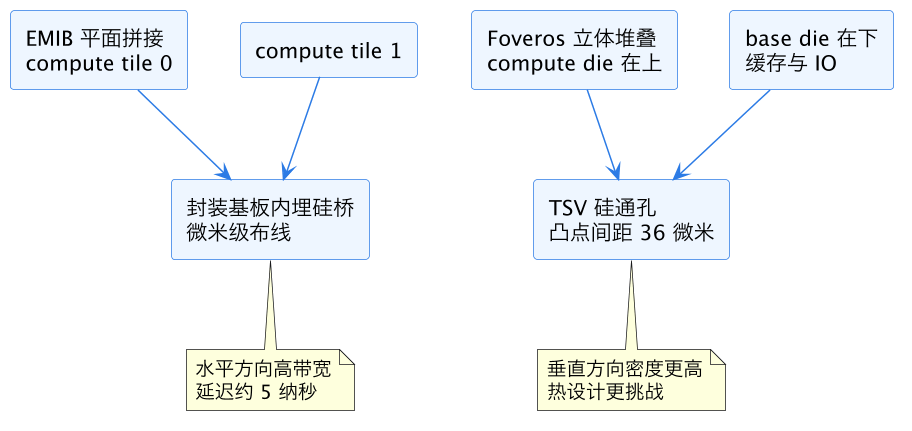
上图把两种封装形态并排。EMIB 是「平面搭桥」:tile 并排躺,靠基板里埋的硅桥横向沟通;Foveros 是「立体盖楼」:上下两层 die 用 TSV 打穿。两者解决的是同一个问题——让 die 间互连的密度和能效逼近片内水平——但工程取舍不同:EMIB 散热好做、die 尺寸灵活;Foveros 密度最高、但上层 die 的热量要穿过下层散出去,热密度是硬约束。把三种主流封装互连的关键指标摆在一起:
| 互连方案 | 带宽密度 | 能效 | 典型跨 die 延迟 | 代表产品 |
|---|---|---|---|---|
| 有机基板 SerDes(Infinity Fabric 早期) | 低 | 约 2 到 4 pJ/bit | 10 到 20 纳秒 | Zen 2 与 Zen 3 |
| EMIB 硅桥 | 高 | 约 1 到 2 pJ/bit | 约 5 纳秒 | Sapphire Rapids |
| Foveros TSV 堆叠 | 最高 | 低于 1 pJ/bit | 数纳秒 | Meteor Lake |
四、延迟阶梯:同一个缓存行,命中位置差几倍延迟
现在把协议层和封装层合起来,看一次访存的延迟到底由什么决定。假设核发起一次 load,L1、L2 都未命中,后续的命中位置决定延迟落在阶梯的哪一级:
第一级,本 CCD 或本 tile 的 L3 命中:Zen 上约 40 到 50 个周期,纯片内流量,无跨 die。
第二级,跨 die 但在另一 die 的缓存里命中(数据被远端核修改过,处于 M 态或 O 态):请求要出 die、经一致性枢纽转发、从远端缓存取数再原路回来。Zen 2 实测这一级约 130 到 190 周期,Zen 4 也在 150 周期上下——比本 die L3 命中贵 3 倍以上。这正是「缓存命中位置敏感度」的核心:同一行数据,躺在本 die 缓存和远端 die 缓存,访问延迟差 3 到 4 倍。
第三级,内存:IO-Die 查地址映射、读 DRAM、返回。Zen 系实测 80 到 110 纳秒(约 250 到 350 周期),比第二级再贵近一倍。注意第三级里已经包含了两跳跨 die,所以 chiplet 架构的「内存延迟」本身就含着封装税。
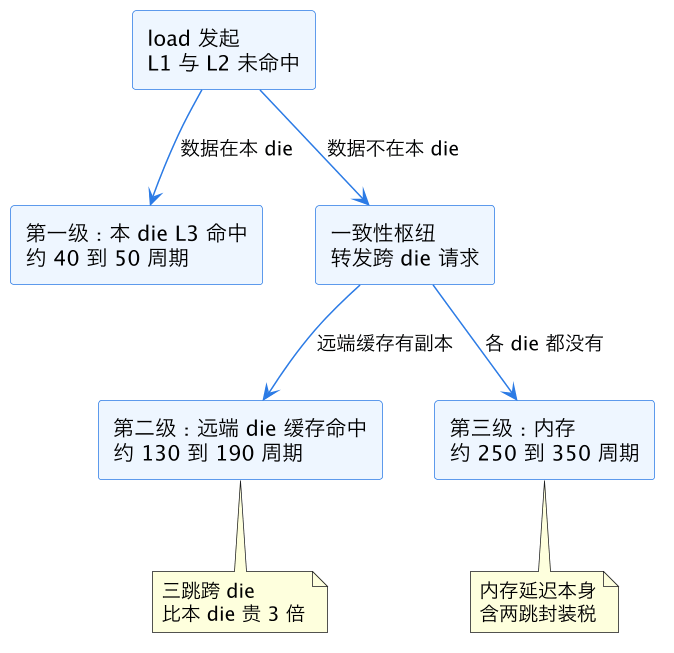
上图是延迟阶梯的决策流向。关键观察是第二级的存在:单 die 时代「缓存命中还是内存命中」是两分法,chiplet 时代变成三分法,而且中间那一级的延迟离内存侧比离缓存侧更近。用 MSHR 未命中状态寄存器 的角度看,第二级未命中占据 MSHR 项的时间是第三级的一半左右——介于两者之间的位置最尴尬:快得不够掩盖,慢得足以拖垮乱序窗口。
第二级还有一层软件看不到的细分:跨 die 一致性流量通常走「主控回探」路径(先问 hub 再找数据),有些实现支持「直接缓存到缓存转发」(probe 响应方直接把数据送给请求方),省一跳;但 hub 仍要参与保序,省不掉协议开销。一致性目录与侦听 里讲的目录方案在 chiplet 场景下几乎必然多一跳——目录本身放在 IO-Die 或 hub 里,片内目录的「查目录再取数」两拍动作被拉成了两个跨 die 往返。
五、软件视角:命中位置敏感度意味着什么
对写代码和做性能分析的人,chiplet 一致性带来三个直接后果。
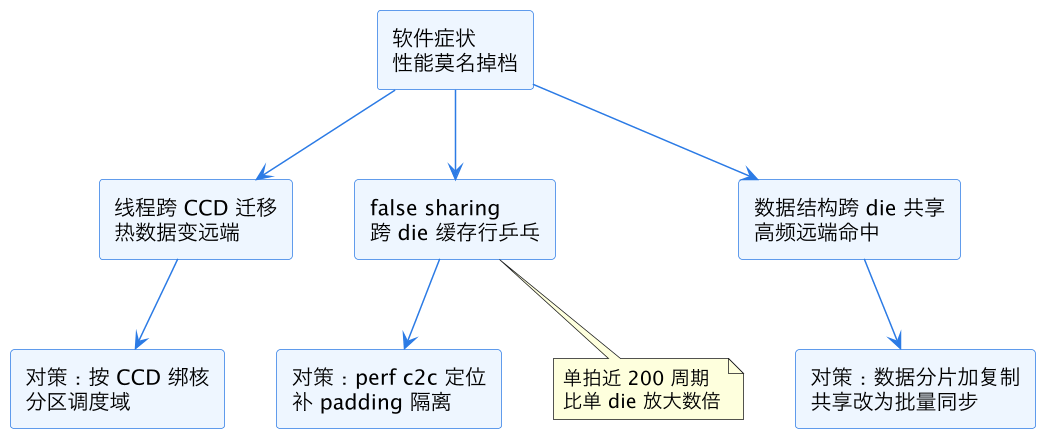
第一个后果:跨 die 数据共享的代价惩罚比 NUMA 节点间还陡。传统双路服务器的远端 NUMA 访问贵约 1.5 到 2 倍(见 NUMA 本地远端延迟),而 chiplet 内部的「远端 die 缓存命中」已经贵 3 倍起——这意味着线程迁移的隐性成本变高了:调度器把一个线程从 CCD0 迁到 CCD1,它之前热在 L3 里的数据全部变成第二级访问。Linux 内核对 AMD 平台有 CCD 感知的调度域划分,负载均衡会尽量在 CCD 内部做;手动绑核(taskset)在 chiplet 机器上的收益比单 die 机器更明显。
第二个后果:false sharing 的代价被放大。原子操作与缓存行实现 讲过一个缓存行在两个核之间乒乓的代价;chiplet 场景下,如果两个核恰好分处两个 die,这个乒乓的每一下都是三跳跨 die 往返,单拍代价从几十周期涨到近两百周期。定位手段不变——perf c2c 照样能抓——但同样一处 false sharing,在 chiplet 机器上的绝对性能损失大得多,修复优先级应当上调。
第三个后果:预取和数据局部性的回报变高。第二、三级的延迟都远超片内,乱序窗口和 内存级并行 MLP 掩盖不住时,唯一能救命的就是「别让请求出 die」:数据结构按 CCD 分片、热点数据复制而非共享、跨 die 共享只走低频的批处理同步。这本质上是把分布式系统里「数据本地化」的思想下沉到了一颗处理器封装内部。
这里补一个容易被忽略的观测细节:perf 的标准事件看到的是「L3 未命中次数」,分不清这次未命中最终落在第二级还是第三级——两级差近百周期,混在一起的平均延迟会误导判断。Zen 平台要用 IBS(基于指令的采样)或者专门的一致性相关性能计数器才能把「远端 die 取数」单独拆出来;Intel tile 化产品则用 uncore 的 mesh 计数器区分本地 tile 命中与跨 tile 流量。做性能归因时不拆这一层,很容易把「跨 die 共享过多」误判成「内存带宽不够」。
上图把三个典型症状和对应抓手连成因果链。三者共同的病根都是「高频的第二级访问」——只要跨 die 一致性流量降不下来,任何微架构层面的优化(更宽的乱序窗口、更聪明的预取器)都只能缓解不能根治,因为延迟阶梯是物理决定的。
这一篇在知识体系里的位置
本篇是微架构模块缓存一致性线向封装层的延伸。上游协议基础是 MESI/MOESI 一致性协议 与 目录式与侦听式一致性,片内互连机制见 NoC 信用流控 和 缓存 slice 哈希寻址。同线相邻的是 NUMA 本地远端延迟(系统级的延迟分层,本篇是封装级版本)、缓存行原子与锁实现(跨 die 乒乓的协议机制)。下游衔接 内存级并行 MLP 与 MSHR 未命中状态寄存器(掩盖跨 die 延迟的硬件手段)、内存一致性模型 TSO(跨 die 保序的软件可见语义)。全景见 CPU 微架构总览。
总结
chiplet 多 die 一致性的本质是把不变的一致性协议架到了变贵的物理通道上:AMD 用「CCD 纯计算、IO-Die 集大成」的对称布局换来良率和成本优势,代价是所有访存必绕 IO-Die;Intel 用 EMIB 硅桥和 Foveros TSV 堆叠把跨 die 延迟压向片内水平,代价是封装复杂度。落到性能上就是一条三级延迟阶梯——本 die L3 命中约 40 到 50 周期,远端 die 缓存命中跳到 130 到 190 周期,内存 250 周期起步——「缓存行躺在哪个 die 上」从此成为和「命中还是未命中」同等重要的性能变量,软件侧的应对收敛成一句话:按 die 边界做数据分片和线程绑定,把跨 die 一致性流量从高频路径上赶走。