写合并缓冲区:store buffer 如何把零散写攒成整条 cache line 再出手
在 LSU:load/store 单元 里我们看过存储指令的完整流水线,在 store-to-load 前递 里看过 store buffer 怎么把未提交的数据前递给后续 load。这两篇里 store buffer 的任务是"保住顺序与可见性"。这一篇换个角度:当写的目标是不可缓存(或刻意绕过缓存)的内存时,另一条以"攒批"为核心的路径——写合并缓冲区(Write Combining Buffer,WC buffer)——决定了你能否打满内存带宽。
本文要回答的问题
- store buffer 和写合并缓冲区是不是同一个东西?分工边界在哪?
- 写合并缓冲区按什么规则把多次写"攒"成一条 cache line?
- non-temporal store(流式写)为什么依赖 WC buffer,半路驱逐会发生什么?
- 什么代码写法能吃满合并,什么写法会把合并打碎?
一、两条写出路径:可缓存写走 store buffer,不可缓存写走 WC buffer
普通写指令(目标是 write-back 可缓存内存)退休后被扔进 store buffer,等拿到 L1D 的对应 cache line(可能要先发 RFO 把行读进缓存),再把数据写进 L1——这个流程见 写分配与写回策略。这条路适合"写了还会读、或者零零散散改几个字节"的场景。
但如果目标是 frame buffer 这类 USWC(Uncacheable Speculative Write Combining)显存,或者程序员主动用了 non-temporal store(如 x86 的 MOVNTDQ),数据不能进缓存——写一个字节也要一次总线事务的话,带宽立刻被事务开销打死:DDR/PCIe 一次突发最小粒度是 64 字节,你只写 8 字节,有效带宽利用率 12.5%。
写合并缓冲区就是为这个问题生的:一小撮(Intel 现代核心里典型 10~12 个)每项 64 字节的"行大小缓冲槽",每个槽绑定一条 cache line 地址,槽里带 64 个字节有效位(byte-enable mask)。零散写先落进对应槽、点亮对应字节位,等一行攒满(或超时/被驱逐)再一次性以整条行事务写出去——8 次 8 字节写合并成 1 次 64 字节事务,带宽效率从 1/8 拉回接近满值。
| 维度 | store buffer(普通写路径) | WC buffer(写合并路径) |
|---|---|---|
| 目标内存 | write-back 可缓存 | USWC 内存 / NT store 目标 |
| 数据去向 | L1D cache line | 绕过缓存直写内存/显存 |
| 攒批方式 | 不攒批,按指令逐条写 L1 | 按行攒批,byte mask 记覆盖 |
| 可见性 | 参与前递、保内存序 | 弱序,SFENCE 才保证刷出 |
| 条目规模 | 几十项(按指令) | 十来个(按 cache line) |
一句话分工:store buffer 管"顺序和可见性",WC buffer 管"把细粒度写聚合成整行事务"。两者都在 LSU 的存储路径上,但解决的是完全不同的问题。
二、合并规则图解:槽位、字节掩码与三种下场
WC buffer 的合并逻辑可以用一张结构图说清楚:
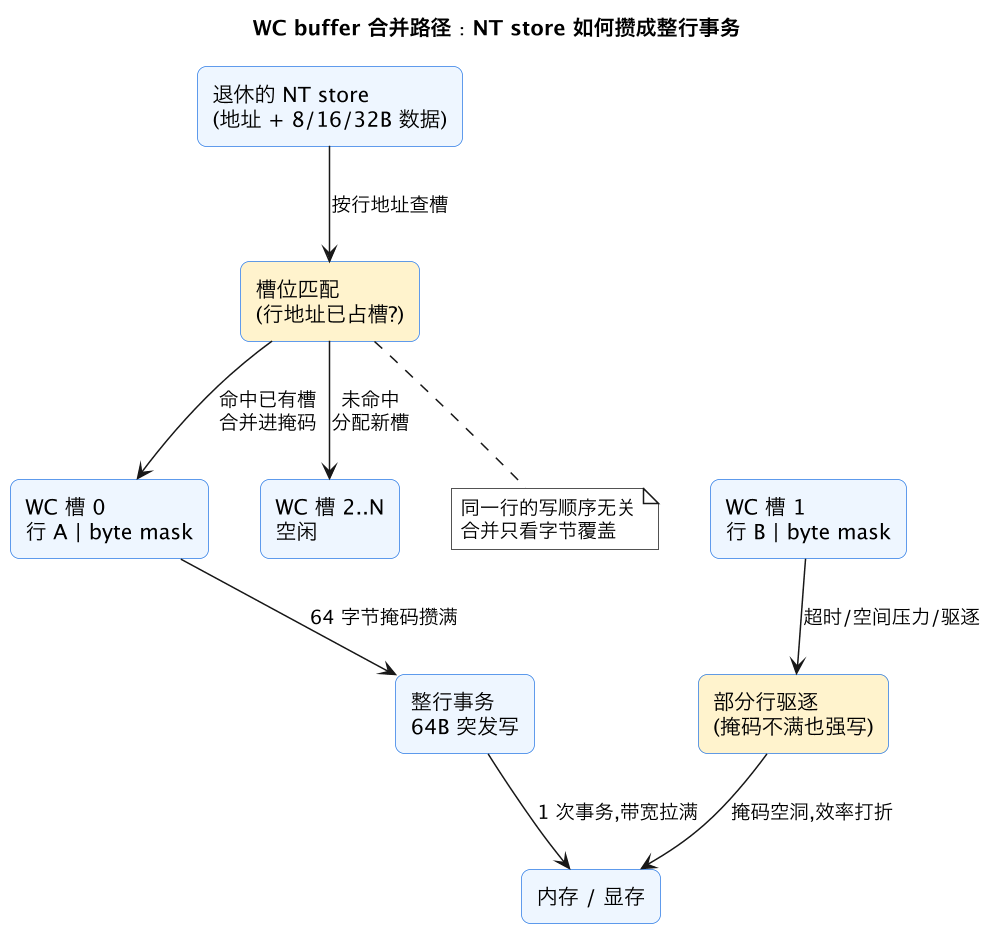
读这张图要抓住三个要点:
合并只看字节覆盖,不看写的先后顺序。 同一个槽里,第 0~7 字节是第一条 store 写的还是最后一条写的,对最终写出的整行数据没有影响(字节不重叠时)。所以连续 MOVNTDQ 写 0、16、32、48 偏移和倒着写,合并效果一样——前提是它们落在同一行且都在槽被驱逐前完成。
攒满是最好结局,驱逐是常态。 槽位有限(十来个),循环里一旦同时活跃的写入流超过槽数,就会发生"某槽还没攒满就被迫腾出"的部分行驱逐(partial line eviction)。部分行写出时内存控制器拿到的是带空洞的掩码,很多平台上会退化成读改写或者多笔小事务,有效带宽直接腰斩。此外中断、上下文切换、SFENCE 也会强制把在飞的槽全刷掉。
NT store 的语义靠 WC buffer 兑现,但不靠它保证。 MOVNTDQ 只承诺"绕过缓存、弱序",合并是微架构给的性能红利;要保可见性必须 SFENCE,这点在 load/store 流水线与缓冲 的缓冲篇里也有铺垫。
三、non-temporal store:什么时候用,怎么用才对
NT store 的价值定位很窄但很强:写一次、短期内不读、数据量远大于 LLC 容量的流式写。典型场景是几十 GB 的内存清零、大矩阵拷贝的目标侧、媒体编码的输出帧。用普通写,RFO 会先把目标行读进来(白白消耗一半带宽),再把 LLC 里真正有用的数据挤出去;用 NT store,省掉 RFO 的读流量,又不污染缓存,大 memcpy 场景实测能多出 30% 以上的有效带宽。
但要拿到这个红利,代码必须配合合并规则:
| 写法 | 合并行为 | 带宽表现 |
|---|---|---|
| 顺序 64B 对齐、每次 16/32B 连续写满整行 | 完美合并,整行突发 | 接近理论峰值 |
| 顺序写但跨行跳跃(一次写 2~4 条流) | 多槽并行,仍可满 | 接近峰值(槽数内) |
| 同时写 8+ 条流(如 strided 多路输出) | 槽不够,频繁部分驱逐 | 腰斩甚至更低 |
| 随机/稀疏写(隔 128B 写 8B) | 每槽写不满就被逐 | 比普通写还差 |
| NT 与普通写混用同一行 | 行状态打架,合并失效 | 严重退化 |
工程上有三条经验:一是写入流条数控制在 WC 槽数以内(稳妥口径 ≤4 条活跃流);二是每行的写尽量在时间上集中,别写半个行就跑去干别的;三是别对小数据用 NT——小于 LLC 量级的工作集,普通写回缓存复用更划算。SIMD 写指令本身的宽度选择(128/256/512 bit)也会影响每拍往槽里灌的速度,宽度话题见 SIMD 向量执行单元。
另外提醒一个反直觉点:NT store 之间、以及 NT store 与后续 load 之间是弱序的,多线程生产者-消费者场景里,写完标志位前必须 SFENCE,否则消费者可能先看到标志后看到数据还没落内存。这类顺序问题的基础篇是 load/store 数据冒险。
四、观测与验证:怎么确认合并在发生
想知道自己的流式写有没有被好好合并,最直接的证据在 PMU(性能监控单元)计数器里。Intel 平台关注 UNC_IMC_DRAM_DATA_WRITES(内存控制器实际写流量)与核心侧 MEM_INST_RETIRED.ALL_STORES 的比率——如果写 64 GB 数据、DRAM 侧也只看到约 64 GB 写流量,说明合并干净、没有 RFO 放大;如果 DRAM 写流量翻倍,说明部分行驱逐触发了读改写。Linux 下用 perf stat 配合对应的 uncore 事件即可量化这类放大。另一个旁证是带宽天花板:纯 NT 写基准测试能摸到内存写带宽的上限(通常比读带宽低 10%~20%),摸不到就先查流的条数和对齐。还有一个更朴素的判别法:同一份拷贝代码,分别用普通写版本和 NT 写版本跑一遍,数据量取 LLC 容量的 4 倍以上。若 NT 版反而更慢,十有八九是合并被打碎了——常见原因是拷贝循环里穿插了对目标区域的读(比如边写边校验),或者目标地址没按 64 字节对齐,导致每条写都横跨两行、槽位被两头扯。把对齐和读写分离做干净,NT 版通常立刻反超。
这一篇在知识体系里的位置
本篇是微架构长尾层,向上承接 LSU:load/store 单元 与 load/store 流水线与缓冲(存储路径全景),向旁连接 写分配与写回策略(可缓存写的对照路径)、store-to-load 前递(store buffer 的另一副面孔)与 load/store 数据冒险(弱序带来的顺序问题)。
总结
写合并缓冲区是 CPU 为"绕过缓存的写"准备的攒批器:十来个按 cache line 组织的槽位用字节掩码把零散写合并成整行 64 字节事务,把有效带宽从 1/8 拉回满格;non-temporal store 能不能发挥威力,全看代码是否让每条流顺序、集中地写满整行——流太多、写太碎都会触发部分行驱逐,让合并红利瞬间清零。