AutoNUMA 页迁移:NUMA hinting fault 采样、迁移抖动与关闭时机
承 numa-local-remote-latency 对本地/远端访问延迟差距的量化,以及 numactl 的手工绑核绑内存套路。手工绑定是「我知道该放哪」,但现实里大量服务没人绑、线程还在漂移——内核于是提供了一个自动纠偏机制:AutoNUMA 页迁移。本篇拆它的采样原理、记账方式,以及它帮倒忙时的识别与关闭方法。
本文要回答的问题
- AutoNUMA 页迁移不插桩、不改应用,内核靠什么「看见」谁访问了哪一页?
- NUMA hinting fault 是怎么周期性地制造缺页来采样的?开销多大?
- 线程热度与页热度两份账是怎么记的?迁移决策什么时候触发?
- 什么是迁移抖动(page ping-pong)?用什么指标识别?
- 哪些负载会被 AutoNUMA 误判?什么时候应该关掉
numa_balancing?
一、为什么需要自动迁移:手工绑定的盲区
NUMA 机器的常识结论(见 numa-local-remote-latency):远端内存访问延迟大约是本地的 1.5-2 倍,跨 socket 带宽还受 UPI/Infinity Fabric 链路容量限制。理想做法是用 numactl 把进程钉在一个节点、内存也分在本节点。
但三类场景手工绑定罩不住:
- 没人绑的杂七杂八服务。一台机器跑十几个容器/进程,挨个写绑定策略运维成本太高。
- 线程漂移。调度器为了均衡负载会把线程在节点间搬来搬去,首次触碰(first-touch)分好的内存留在原地,CPU 和内存就错配了。
- 共享数据。多节点线程共同读写一片数据,放哪个节点都不完美,只能动态跟随主要访问者。
AutoNUMA 页迁移(内核配置 CONFIG_NUMA_BALANCING,开关 /proc/sys/kernel/numa_balancing)就是为这些盲区设计的兜底:不用改应用,内核周期性采样页表,发现「页在节点 A、访问者主要在节点 B」就把页迁过去,同时尽量把线程调度到内存所在节点。它管的是CPU-内存错配的事后纠偏,不是首次分配策略——首次分配仍然是 first-touch 规则,AutoNUMA 只在错配已经发生后负责慢慢修正。理解这一点很重要:它是个渐进收敛的闭环控制器,不是一次性最优分配器,所以评价它要看「收敛后的稳态 locality」,而不是某一时刻的快照。
二、NUMA hinting fault:用「故意缺页」做采样
AutoNUMA 最巧的设计是:它不插桩、不开 PMU,而是复用缺页异常这个现成的拦截点来做访问来源统计。机制分三步。
第一步,周期扫描。内核的 task_numa_work(挂在调度器的周期性回调上)按 numa_balancing_scan_period(默认 1000ms)唤醒,把进程虚拟地址空间(VMA)里下一批页(数量受 numa_balancing_scan_size 控制,默认按 256MB 窗口折算)的 PTE 打上 _PAGE_PROTNONE 标记——页还在,但硬件访问权限被收掉了。
第二步,等访问者自投罗网。任何线程再访问这些页时触发缺页异常,走进 handle_pte_fault 的分支 do_numa_page——这就是 NUMA hinting fault。异常处理里内核读到两件关键信息:当前 CPU 在哪个节点(访问者是谁),以及这页的物理页帧在哪个节点(页在哪)。两者一比对,访问来源的统计就入账了。
第三步,恢复权限。记完账把 PTE 权限改回去,后续访问照常,直到下一个扫描周期再被打标。
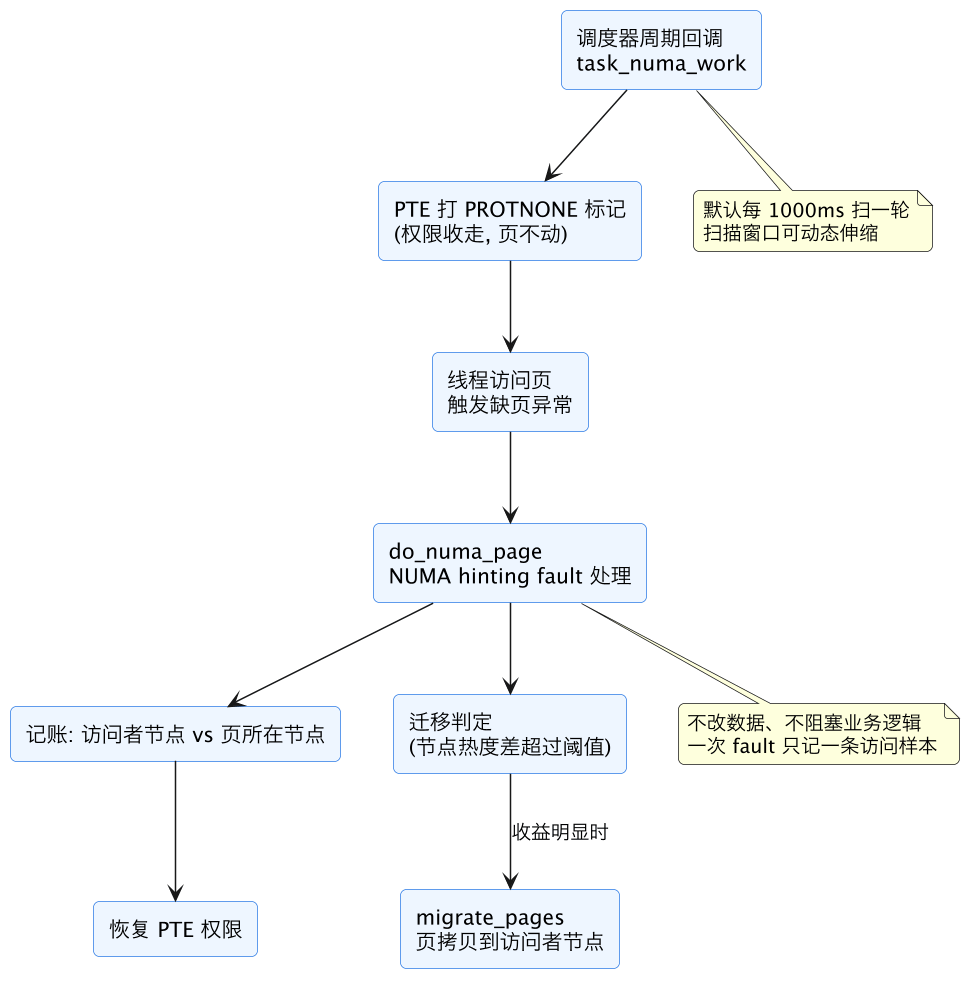
这张图要点:采样的代价就是缺页异常的代价。一次 NUMA hinting fault 几百纳秒到几微秒,扫描窗口内的页每周期各吃一次。内核用两个自保护旋钮控制总量:numa_balancing_scan_period_min/max 限制扫描频率,扫描窗口大小随「上次扫描发现的错配比例」动态调整——错配多就加快采样,基本没错配就把周期拉长到几秒,把开销压到 1% CPU 以下。
可以用 perf stat -e 'numa_hint_faults, numa_hint_faults_local' 或看 /proc/vmstat 里的 numa_hint_faults 计数器确认采样量。hinting fault 暴涨本身就是信号:要么刚发生大规模错配(进程被迁移),要么工作集被反复打标——下面讲抖动时还会用到。
三、两份热度账:task 偏向与页偏向
AutoNUMA 的迁移决策靠两组统计,方向相反、互相配合。
线程侧(task NUMA 偏向):每个线程维护一份「我在各节点各访问了多少次」的直方图。调度器的 task_tick_numa 据此算出线程的 preferred node,在负载均衡时倾向于把线程拉回这个节点——这是让 CPU 去就内存的方向。
页侧(page NUMA 偏向):每次 hinting fault 给「页帧所在节点 × 访问者节点」的组合计数。页的统计不是存在页描述符里(放不下),而是以共享内存组(share group,按 VMA/进程聚合)的形式记账——这是让内存去就 CPU的方向。
迁移判定逻辑大体是:某页(或其所在组)的访问绝大多数来自另一个节点,且该节点空闲内存够,就调 migrate_pages 做实际拷贝。迁移本身是昂贵的:4KB 页要摘映射、拷贝、重填页表、刷 TLB,期间对该页的并发访问要么等迁移完成、要么被短暂地反复 fault;大页(THP,见 ept-npt-second-level-translation 对二级页表的介绍)则按 2MB 整体搬,单次更贵但摊到每 4KB 反而便宜。所以内核设了滞后阈值:热度差要足够明显才动手,避免为一时波动付迁移费——这与控制器里的「死区」设计同理,宁可欠迁不可过迁。
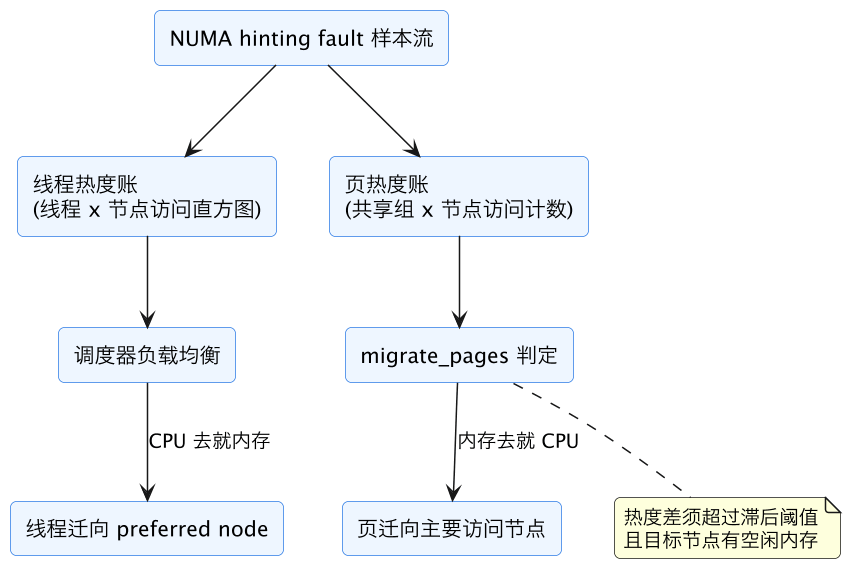
两条纠偏路径共用同一份采样数据但独立生效,这也是为什么有时只看到线程被调度收敛、有时只看到页在搬——取决于哪一侧更容易先满足阈值。
四、迁移抖动:page ping-pong 的成因与识别
AutoNUMA 最经典的翻车模式是迁移抖动:一页(或一组页)在两个节点间来回搬,迁过去发现对面访问又多了,再迁回来。典型诱因有三个。
对称访问。两个节点的线程以相近频率读写同一片共享数据——比如跨节点的环形缓冲区、全局计数器数组。热度账两边轮流占优,每次越过阈值就触发一次反向迁移,页永远在路上,而 TLB shootdown 和拷贝开销全由业务买单。
扫描周期与访问相位错开。负载的访问模式本身有周期(例如批处理任务轮流激活不同节点的 worker),采样窗口恰好总落在「相位切换」附近,每次记账都采到过渡态。
线程迁移与页迁移互相追逐。调度器把线程拉向页,AutoNUMA 又把页搬向线程刚离开的节点——两份账基于不同时刻的样本,各自优化局部,合成全局震荡。
识别抖动看这几个指标(都能从 /proc/vmstat 或 numastat-numa-balance 拿到):
| 指标 | 正常态 | 抖动态 |
|---|---|---|
numa_pages_migrated 增速 | 启动后冲高,随后趋平 | 长期高速线性增长 |
numa_hint_faults | 稳态低位 | 持续高位(反复打标反复 fault) |
pgmigrate_success / pgmigrate_fail | success 占绝对多数 | fail 占比升高(目标节点紧张) |
| 业务尾延迟 | 平稳 | 与迁移高峰相关的毛刺 |
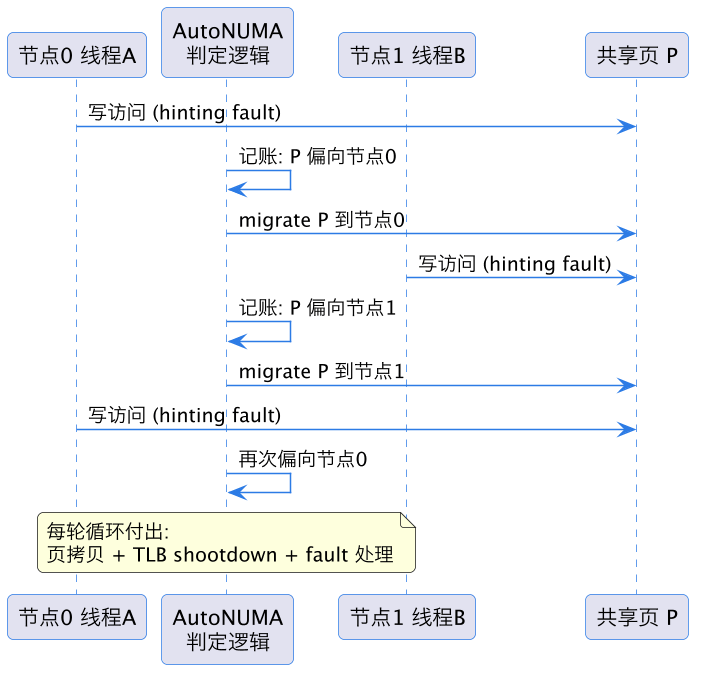
这张时序图展示的就是典型的乒乓循环:A、B 交替访问共享页,判定逻辑每次都「滞后一步」地跟随上一个访问者,迁移永远追不上访问相位的切换。判断是不是抖动,看 numa_pages_migrated 在一段时间窗内的增量与业务收益是否匹配——迁了几十万页而远程访问占比纹丝不动,基本可以确诊。更精细的办法是用 perf record -e migrate:mm_migrate_pages 抓一段时间的迁移事件,按页地址聚合统计,如果少数热点页贡献了大部分迁移次数,乒乓页就直接现形了;这类页的正确归宿通常是手工 fixup——改应用把它拆成按节点分片的副本,或者用 mbind 把它钉死在折中节点上。
五、常见误判场景与关闭时机
AutoNUMA 是启发式,以下几类负载它大概率帮倒忙,应果断关闭或绕行。
已经手工绑好的负载。numactl/interleave 策略(含容器运行时配的 cpuset.mems)已经把 CPU-内存对齐,AutoNUMA 的采样和偶发迁移纯属白开销,还可能干扰大页布局。关闭方式:echo 0 > /proc/sys/kernel/numa_balancing。
大规模共享内存多线程。上面讲的对称访问场景——数据库 buffer pool 被全节点连接线程打、科学计算的多节点线程共写结果矩阵。这类负载的正解是交错分配(numactl --interleave=all)摊平延迟方差,而不是让页追着访问者跑。
低延迟敏感型服务。hinting fault 的异常路径、迁移时的 TLB shootdown(IPI 广播让其他核刷 TLB)都是微秒到几十微秒级的毛刺源。对 p99 在几十微秒量级的业务,这点毛刺就是预算的全部。
短生命周期进程。采样需要若干周期才能收敛出热度图,进程活几秒就退出的场景,AutoNUMA 还没学完访问模式进程就没了,纯贡献 fault 开销。
内存紧张节点。目标节点没有足够空闲页时迁移大量失败(pgmigrate_fail 涨),内核还要做内存规整(compaction)腾出大页,双重开销。这种时候先解决容量问题,再谈 locality。
反过来,什么时候该留着它:没人维护绑定策略的通用多租户机器、线程池跨节点漂移明显的长驻服务、访问模式有明显主从结构(一个节点为主写者)的共享数据——这些场景 AutoNUMA 的收敛收益是实打实的,上游报告的典型提升在 10-30%。
判断流程一句话版:先看 /proc/vmstat 的 numa_hint_faults、numa_pages_migrated、numa_pte_updates 是否稳态低位;再配 numa_hit/miss/local/remote 看远程访问占比;迁移在涨而 remote 占比不降,就是负收益,关掉或上手工策略。
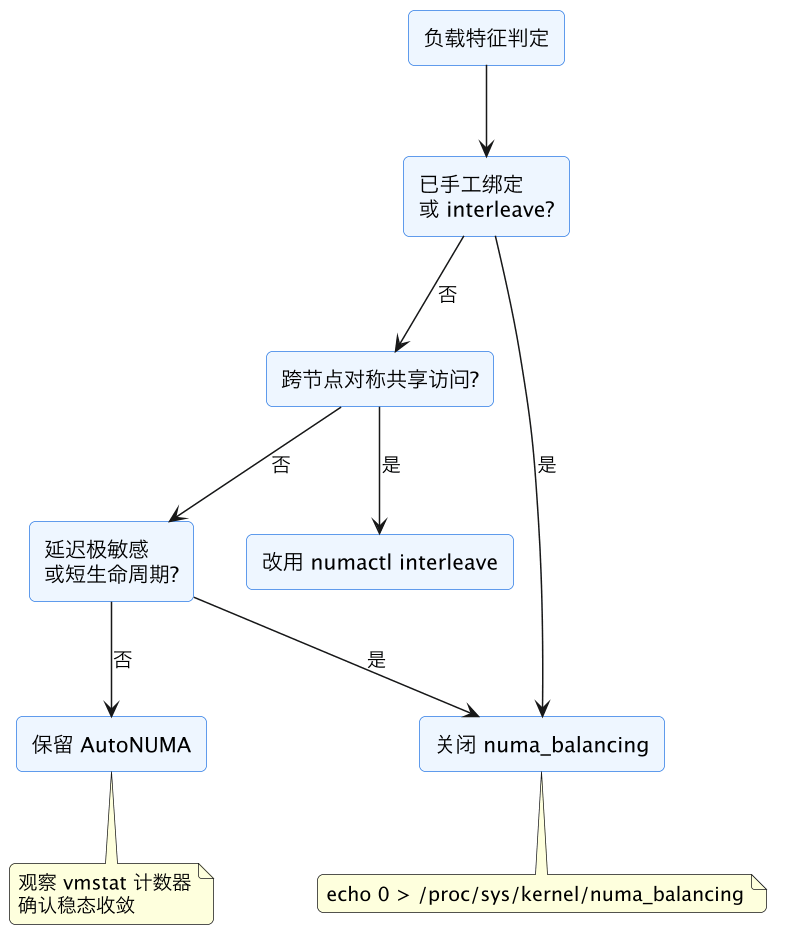
这张决策图把上面五类场景浓缩成一条判定链:先查有没有显式策略(有就让显式策略独占),再看访问模式是不是对称共享(是就交错),再看延迟与生命周期约束,三条都通过了才轮到 AutoNUMA 上场。
六、观测与调参实战
确认 AutoNUMA 是否在工作、工作得好不好,靠三类数据源。
vmstat 计数器(/proc/vmstat 或 numastat -p <pid>)。numa_hint_faults 是采样总量,numa_hint_faults_local 是其中「访问者和页同节点」的部分——local 占比越高说明 locality 越好,纯远端错配时 local 占比会很低。numa_pages_migrated 是累计迁移页数,numa_pte_updates 是被打标的 PTE 数。稳态下这四个计数器都应该低速增长;任何一条高速爬坡都值得查。
perf 事件。perf stat -e 'numa_hint_faults, numa_hint_faults_local, numa_pages_migrated' -p <pid> 能按进程粒度看;perf sched 配 NUMA 相关 tracepoint(migrate:mm_numa_migrate_ratelimit 等)可以精确抓到每次迁移的页地址与源/目的节点,深挖抖动时好用。
调度统计。/proc/<pid>/sched 里的 numa_migrations、numa_faults_memory(分节点列出)给出单个线程的视角——某个线程的 numa_faults_memory 里远端节点计数猛涨,基本就是它漂了或者它的内存被放在别处。
可调参数集中在 /proc/sys/kernel/ 下,常用四个:
| 参数 | 默认 | 作用 | 何时动它 |
|---|---|---|---|
numa_balancing | 1(开) | 总开关 | 帮倒忙时置 0 |
numa_balancing_scan_period_min_ms | 1000 | 扫描最小周期 | 抖动时调大降采样频率 |
numa_balancing_scan_period_max_ms | 60000 | 扫描最大周期 | 一般不动 |
numa_balancing_scan_size_mb | 256 | 每轮扫描窗口 | 工作集大、收敛慢时调大 |
调参的顺序建议:先用 numa_balancing_scan_period_min_ms=2000 这类温和手段降采样压力观察收益;抖动依旧再考虑总开关。不建议一上来就把扫描窗口调到 GB 级——hinting fault 总量随窗口线性涨,采样本身会变成新的开销源。
还有一个容易忽略的细节:AutoNUMA 与透明大页(THP)的交互。2MB 大页迁移是一次性搬 2MB,单个迁移操作更贵,但覆盖同样内存量的迁移次数只有 4KB 页的 1/512;而 hinting fault 在 THP 上按整个大页打标,样本粒度变粗,小热点藏在大页里可能永远采不到。极端追求 locality 精度的场景,有人会选择关 THP 换细粒度采样——这又是「测量精度与测量开销」的老权衡。
这一篇在知识体系里的位置
本篇是 NUMA 主题的机制篇:延迟背景见 numa-local-remote-latency,NUMA 总览见 numa,页表遍历机制见 tlb-pagewalk-cache,二级地址翻译见 ept-npt-second-level-translation;手工策略工具见 numactl,观测计数器见 numastat-numa-balance。远端流量在整机视角下的表现可对照 uncore-ring-mesh-interconnect。
总结
AutoNUMA 页迁移用「周期性收走 PTE 权限、等访问者触发 NUMA hinting fault」的零插桩方式采样页访问来源,同时维护线程热度与页热度两份账,分别驱动「CPU 去就内存」的调度偏向和「内存去就 CPU」的页迁移;它适合无显式绑定、访问有主从结构的长驻负载,而在已手工绑定、对称共享访问、低延迟敏感或短生命周期场景下会因迁移抖动(page ping-pong)和 fault 毛刺帮倒忙——判据很朴素:numa_pages_migrated 持续高涨而远程访问占比不降,就该 echo 0 > /proc/sys/kernel/numa_balancing 了。