TSX 事务内存:硬件事务与锁省略的 cache line 跟踪粒度、中止原因统计与真实收益
更新时间:2026-10-04。多线程程序里最贵的指令往往不是加法乘法,而是那把保护临界区的锁:抢锁时的缓存行弹跳、排队自旋、上下文切换,每一项都在烧周期,背景见 原子操作与锁的缓存行实现。Intel 从 Haswell 开始引入的 TSX 事务内存(Transactional Synchronization Extensions,事务同步扩展)换了一条思路:不抢锁,直接把临界区当成一个「硬件事务」投机执行——CPU 在缓存里悄悄盯住事务碰过的每一行数据,没人冲突就一口气提交,有人冲突就整体回滚、退回老路老老实实加锁。这套机制把「乐观并发」从数据库搬进了硅片。本篇是微架构模块并发线的专题,衔接 内存一致性模型与 TSO 与 缓存一致性协议,下游观测手段见 PMU 性能计数器编程。
本文要回答的问题
- TSX 的两套接口 RTM 和 HLE(锁省略)分别怎么用?语义差别在哪?
- 硬件拿什么跟踪事务的读集和写集?为什么粒度是 cache line 而不是字节?
- 事务为什么会中止?六大类原因各占多大比例,怎么用 PMU 数出来?
- 锁省略相比普通自旋锁,真实收益有多大?什么负载下反而是负优化?
- TSX 有哪些工程上的坑(伪共享、容量上限、指令限制、历史漏洞)?
一、从锁到事务:TSX 解决什么问题
先看传统锁的代价。一个 lock cmpxchg 抢锁,本质是让缓存行在所有核之间打乒乓球:锁所在的 cache line 在 MESI 协议下被拉到独占(Exclusive/Modified)状态,别的核一读一写就要发起总线事务把它抢回去,机制细节见 原子操作与锁的缓存行实现。临界区短、竞争少时这点开销无所谓;临界区多线程高频进出时,锁行本身就成为串行点——就算八个线程访问的是哈希表里八个完全不同的桶,只要走同一把全局锁,它们就一个都并行不了。
TSX 事务内存的想法是:让锁只活在「逻辑」里。线程进入临界区时不真的获取锁,而是开启一个事务,在事务里随意读写;硬件用缓存一致性协议盯住事务碰过的所有 cache line。如果整个事务期间没有别的核碰这些行,提交时一切写入原子生效,锁变量从头到尾没被写过——八个线程访问八个桶,就真的八个并行。只有当两个事务的读集写集真的相交时,其中一个才被硬件强行中止,回滚后走 fallback 路径老老实实加锁。这把「锁是否串行」的判定从编译期/运行前的静态决策,推迟到了「是否真的发生数据冲突」的动态判定。
TSX 提供两套接口,语义差别值得先分清:
| 接口 | 全称 | 编程方式 | 冲突时的行为 |
|---|---|---|---|
| RTM | Restricted Transactional Memory | 显式 xbegin/xend/xabort,程序员写 fallback 路径 | 跳转到 xbegin 指定的回退地址,状态码在 EAX |
| HLE | Hardware Lock Elision | 给加锁指令加 xacquire/xrelease 前缀,二进制兼容旧锁 | 自动回退为真加锁(锁变量被写,其他事务观察到冲突而中止) |
HLE 的巧妙之处在于二进制兼容:xacquire 前缀在老 CPU 上是被忽略的空前缀,同一份代码在新 CPU 上自动享受锁省略。glibc 的 pthread_mutex 就曾经内置过 HLE 自适应路径。RTM 则给了程序员完整控制权——中止原因码、重试次数、回退策略全自己写,数据库和运行时系统(如 JVM 的锁省略实验)走的多是这条路。
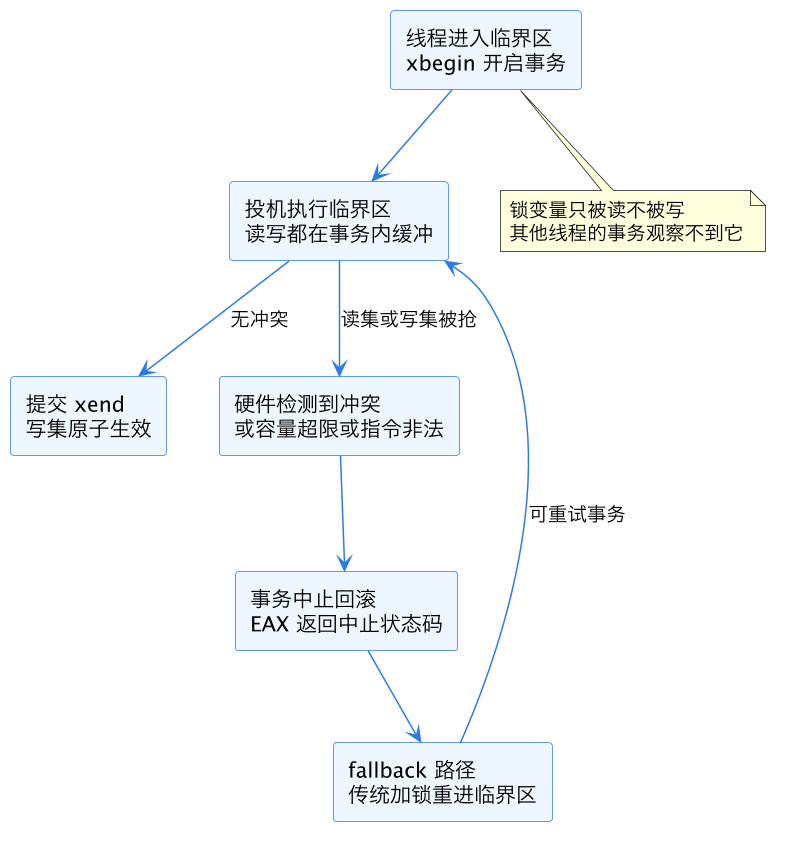
上图是 RTM 事务的生命周期。注意那个关键细节:进入事务时锁变量被「读」而不是「写」——它被纳入读集,只要没人真去写这把锁(即没人走 fallback),所有事务都读同一个共享状态的锁行,互不冲突。一旦有线程回退加真锁,锁行被写,所有在途事务的读集被踩,集体中止。这个「一个叛徒拖垮全队」的效应后面还会回来。
二、硬件怎么盯:读集写集与 cache line 跟踪粒度
TSX 的实现完全复用现有的缓存一致性基础设施,没有为事务单独造一套跟踪器。原理一句话:读集用 L1 缓存里的「行在不在」来近似,写集用 L1 缓存行的 M/E 状态来缓冲。
具体来说,事务执行期间:
- 每次读,把该 cache line 纳入读集——硬件表现就是该行必须以 S 或更高级别驻留在本核 L1,且被打上「事务读」标记。
- 每次写,把行拉成 M 状态但不对外可见(不发失效消息时就靠延迟),写进 L1 并打上「事务写」标记——写集就是这些被弄脏但还没广播的行。
- 任何来自其他核的一致性请求(读或写)命中本核某个带事务标记的行,且与读写集语义冲突(写集被读或写、读集被写),本事务立即中止:写集所在行全部失效丢弃,寄存器状态恢复到
xbegin时存的检查点。 - 提交时,打标动作批量撤销,写集的 M 行正式对外可见——对外界而言这一批写是原子的,因为一致性协议保证在事务期间没人看到过中间态。
这套设计决定了 TSX 的第一个硬约束:跟踪粒度是 64 字节的 cache line,不是字节也不是字。两个线程写同一个 cache line 里两个不相邻的变量,在锁语义下完全不冲突,在 TSX 眼里却是实打实的写-写冲突——这是伪共享问题在事务世界的复刻,而且更隐蔽:普通伪共享只是慢,事务里的伪共享直接让事务永远提交不了,性能掉得比加锁还惨。
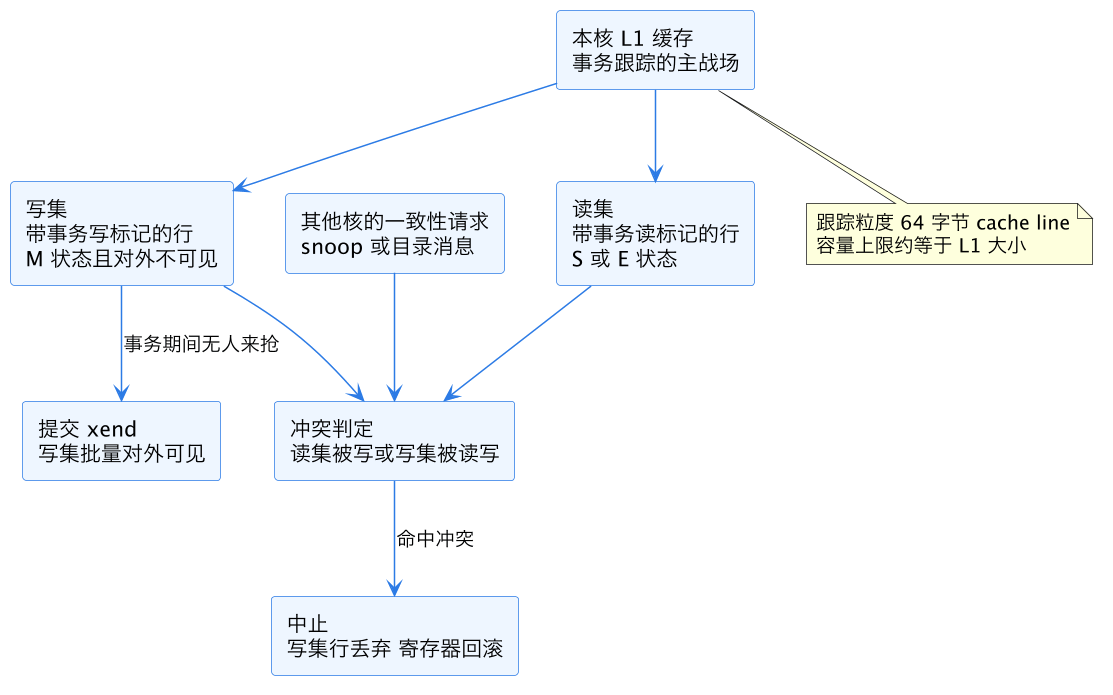
上图是事务跟踪的硬件舞台。第二个硬约束也藏在图里:容量上限。读集超出 L1(现代核 32KB 到 48KB)能容纳的行数、写集超出 L1 写缓冲能力(写集一般不允许被踢出 L1,踢出即中止),事务就只能中止。经验数字:临界区内碰的独立 cache line 数控制在几百个以内比较稳,碰上千个就基本别想提交了。用大结构体、长链表遍历、大数组扫描的临界区,天然和 TSX 八字不合。
第三个约束是指令白名单:事务内不允许执行会导致「无法回滚的副作用」的操作——系统调用、cpuid、部分 x87 控制指令、I/O 指令、PAUSE 的早期定义等,一执行就无条件中止。这意味着事务里不能 malloc(glibc 分配器内部有锁和系统调用风险,需用 TSX 感知的分配器)、不能打印日志、不能访问映射可能触发缺页的冷内存(缺页处理本身会让事务中止)。
三、事务为什么会中止:原因分类与 PMU 统计
中止不是异常,是 TSX 的日常。生产负载下中止率百分之几到百分之几十都正常,关键是搞清楚「为什么中止」——不同原因的优化方向完全不同。xbegin 回退时 EAX 寄存器带回状态码,硬件 PMU 也提供配套计数器,用法见 PMU 性能计数器编程。
| 中止类别 | EAX 位 | 典型原因 | 优化方向 |
|---|---|---|---|
| 数据冲突 | bit 2(重试可能成功) | 两事务读写集真的相交;同行伪共享 | 缩小临界区、拆锁、消除伪共享 |
| 容量超限 | 无专用位(常归到杂项) | 读集或写集超过 L1 容量 | 减小事务工作集、拆成多个小事务 |
| 显式中止 | bit 0(xabort 指令) | 程序自己调用 xabort(如嵌套锁检测) | 查代码逻辑 |
| 调试相关 | bit 1 | 调试器断点 | 生产环境忽略 |
| 嵌套深度 | bit 3(重试不会成功) | 嵌套事务超硬件深度 | 拍平嵌套 |
| 指令与事件类 | bit 4 等 | 系统调用、缺页、中断、被驱逐 | 事务内只碰热内存、屏蔽可屏蔽因素 |
实战统计用 perf 就能干。Intel 提供三组 PMU 事件:RTM_RETIRED.START(事务启动数)、RTM_RETIRED.COMMIT(提交数)、RTM_RETIRED.ABORTED(中止数),中止率就是中止除以启动;HLE 对应 HLE_RETIRED.*。进一步拆中止原因,看 TX_EXEC.MISC* 系列或 RTM_RETIRED.ABORTED_MEM(容量类)、RTM_RETIRED.ABORTED_MEMTYPE 等细分事件。一次典型的排查会话长这样:
perf stat -e rtm_retired.start,rtm_retired.commit,rtm_retired.aborted,rtm_retired.aborted_mem ./app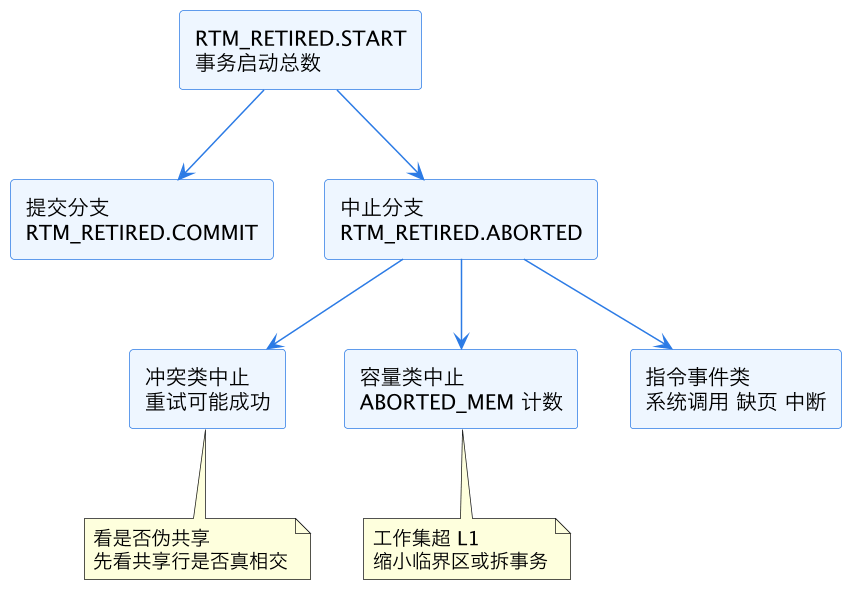
上图是中止统计的分诊树:先看启动到提交的转化率,转化率低再按三个分支分诊。冲突类中止最值得细分——如果冲突集中在某几个 cache line(配合 PEBS 采样可定位),而代码里这些行上的变量逻辑上并不共享,那就是伪共享;真共享则要回到数据结构层面拆锁或换无锁算法。容量类中止的信号很明确:临界区代码路径上的访存足迹太大,要么缩小临界区,要么把大事务拆成小事务序列。指令事件类通常靠代码审计就能排掉——事务里偷偷调了个会 malloc 的库函数是最常见的翻车姿势。
四、锁省略的真实收益:什么时候赚、什么时候赔
HLE 锁省略的收益模型可以写成一句话:收益等于「省掉的锁行串行化」减去「中止与回滚的浪费」。把这笔账算清,适用边界自然就出来了。
赚钱的场景有三个特征:临界区短(几十个到几百个周期)、数据冲突天然稀少(线程访问不同数据分片)、锁竞争只是「 precautionary 」(防御性加锁,实际很少真撞上)。典型代表:哈希表桶级逻辑共享一把大锁的遗留代码、Java synchronized 里大量无竞争锁、读多写少的统计计数结构。这类负载上公开实测的收益相当可观:Intel 早期对 SPECjbb 类负载的演示给出过两位数的吞吐提升;TSX 友好的 hash map 相比全局锁版本在 8 线程下能有数倍的扩展性改善,曲线逼近桶级细锁。
赔钱的场景同样三个特征:临界区长(事务工作集大,容量中止)、真冲突频繁(数据本身热点,比如全局计数器——所有线程写同一个变量,TSX 只会把所有事务变成串行回退重试,比自旋锁还浪费)、有「叛徒线程」反复走 fallback(一个线程不断写锁行,把全队事务踩掉,全队回退,它也抢不到时间窗,进入活锁式震荡)。
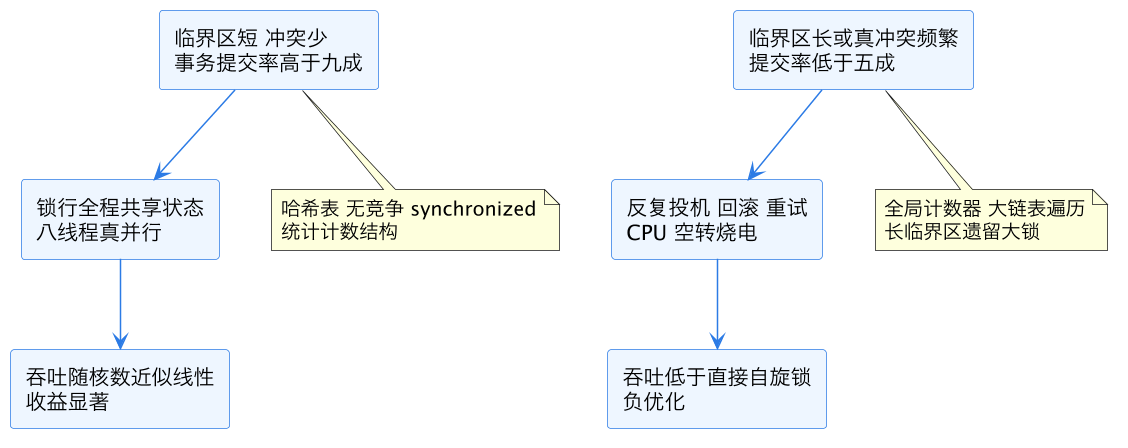
上图把两种结局并排画出来,分岔点就是提交率。工程上的经验阈值:提交率稳定在 90% 以上,TSX 是稳赚的;掉到 50% 以下,投机浪费开始反超锁开销;中间地带要看回退路径的质量——好的自适应策略(重试 N 次后真加锁、指数退避、提交率动态降级关闭锁省略)能把中间地带也变成正收益。glibc 当年的做法是给锁加一个「省略命中率」统计,命中率差就自动退回普通锁,这正是自适应思想。另外别忘了事务路径和 fallback 路径之间的内存序语义衔接:HLE 下锁行的读写次序仍受 内存一致性模型与 TSO 约束,回退加锁后的可见性由锁本身的 acquire/release 语义保证,配合 内存屏障开销 一起评估。
| 负载特征 | 预期提交率 | 建议 |
|---|---|---|
| 短临界区加数据分片 | 九成以上 | 直接上 RTM 或 HLE,收益最大 |
| 中等冲突加好回退策略 | 五到九成 | 上自适应方案,盯住 PMU |
| 热点真共享数据 | 低于五成 | 别用,换分片或无锁数据结构 |
| 长临界区大工作集 | 容量中止为主 | 先缩临界区再谈事务 |
五、工程红线:漏洞史、平台支持与落地清单
TSX 的历史本身就是一条红线。Haswell 和早期 Broadwell 的 TSX 实现有硬件 erratum,被微码更新整体禁用;Skylake 时代重新可用;2021 年 Intel 又因 TAA(TSX Asynchronous Abort)侧信道漏洞在部分型号上默认关闭 TSX——攻击者能借事务中止时序窥探数据,与 Spectre Meltdown 瞬态执行 同属瞬态执行攻击家族。到 Ice Lake 之后,Intel 干脆在大量客户端和服务器 SKU 上移除了 TSX。结论很残酷:写新代码押注 TSX 之前,先确认目标机器还开着它——grep tsx /proc/cpuinfo 看一下,云厂商实例尤其要逐型号核实。
落地清单按顺序过一遍:
- 平台确认:CPU 型号支持且微码未禁用 TSX,虚拟化环境下确认 hypervisor 透传了该特性。
- 临界区审计:事务内无系统调用、无分配器调用、只碰热内存,工作集控制在几百行以内。
- 数据布局:事务内访问的共享变量按 cache line 对齐隔离,消除伪共享,参考 缓存行实现 的对齐手法。
- 回退路径:fallback 必须是真锁且与事务路径读写同一锁变量,保证「叛徒机制」能正确串行化。
- 观测埋点:上线即挂
rtm_retired.*计数器,提交率进监控面板,劣化自动告警。
这一篇在知识体系里的位置
本篇是微架构模块「并发与一致性线」的事务内存专题。上游基础是 原子操作与锁的缓存行实现(锁本身的硬件代价)、内存一致性模型与 TSO(回退路径的次序语义)与 缓存一致性协议(读集写集跟踪复用的基础设施)。相邻的机制篇包括 store buffer 与写合并(事务写缓冲与常规写缓冲的交互)和 内存屏障开销(锁省略省掉的那部分开销)。观测侧衔接 PMU 性能计数器编程,安全侧背景见 Spectre Meltdown 瞬态执行,全景见 CPU 微架构总览。
总结
TSX 事务内存把临界区变成硬件事务:CPU 复用缓存一致性协议,以 64 字节 cache line 为粒度在 L1 里跟踪读集(驻留标记)和写集(M 状态对外不可见),无冲突则 xend 原子提交、锁行全程保持共享状态从而实现锁省略,有冲突则整体回滚走 fallback 加锁;收益等于省掉的锁行串行化减去中止回滚的浪费——短临界区、数据天然分片的负载上吞吐随核数近似线性,而真共享热点、长临界区负载会因冲突中止和容量中止变成负优化;工程落地必须用 RTM_RETIRED 系列 PMU 计数器盯住提交率、按冲突、容量、指令事件三类原因分诊,并且先确认目标平台的微码还没把 TSX 关掉。