SIMD 向量执行单元:宽度、lane 组织与掩码/gather/scatter 的硬件实现
在微架构地图里,SIMD 向量执行单元位于流水线最末端:前面超标量流水线和乱序执行把「每拍几条指令」堆到 4~6,向量执行单元再乘上「每条指令几个数据」的 4~16 倍,两者相乘就是单拍理论吞吐的完整答案。本篇把这一级放大器拆开看。
本文要回答的问题
- 向量宽度从 128 位扩到 512 位,硬件上到底加了什么?为什么不是简单地「把 ALU 加宽」?
- lane(泳道)是怎么组织的?为什么跨 lane 操作(shuffle、归约)比同 lane 操作贵得多?
- 掩码(mask)执行是怎么做到「不写就不写」的?它和分支向量化是什么关系?
- gather/scatter 这种「一条指令访问一堆不连续地址」的操作,硬件里到底走了哪条路,为什么比连续访存慢 5~10 倍?
- 用 perf 怎么判断程序是真吃满了向量单元,还是被 lane 利用率、掩码、跨 lane 操作拖了后腿?
一、宽度扩展史:从 MMX 到 AVX-512 到 SVE
SIMD(Single Instruction Multiple Data,单指令多数据)的思路一句话:一次算 4 个 float,何必发 4 条 FADD。过去二十五年,x86 的向量寄存器宽度走了这样一条路:
| 指令集 | 年份 | 寄存器宽度 | 单拍 float 数 | 代表微架构 |
|---|---|---|---|---|
| MMX | 1997 | 64 位(复用 x87 栈) | 2 | Pentium MMX |
| SSE | 1999 | 128 位 XMM | 4 | Pentium III |
| AVX | 2011 | 256 位 YMM | 8 | Sandy Bridge |
| AVX-512 | 2017 | 512 位 ZMM | 16 | Skylake-SP |
| SVE(ARM) | 2019 | 128~2048 位可变 | 与实现相关 | Neoverse V1 |
宽度翻倍看起来只是「寄存器加宽」,但硬件上要同时动三样东西:向量寄存器文件(物理寄存器池变宽)、数据通路(ALU、转发网络、load/store 端口全加宽)、执行单元本体。其中执行单元才是本篇的主角。
值得注意的两个拐点:
- Sandy Bridge 的「倍速」实现:AVX 的 256 位 FMA 单元,实际是拿两条 128 位半通路拼的,指令进单元后分成两个 128 位 µop 在两个端口上并行执行。这说明「512 位单元」不一定是真的一条 512 位数据通路,也可能是两条 256 位拼出来的——Skylake-SP 的低端型号就是这么干的,高端 Xeon 才给两条真 512 位 FMA。
- SVE 的「宽度不可知」:ARM SVE 不固定宽度,同一份机器码在 256 位和 512 位实现上都能跑,靠谓词寄存器(predicate)和
whilelt之类的长度查询指令循环。代价是编译器向量化的复杂度上升,但代码可移植性解决了。
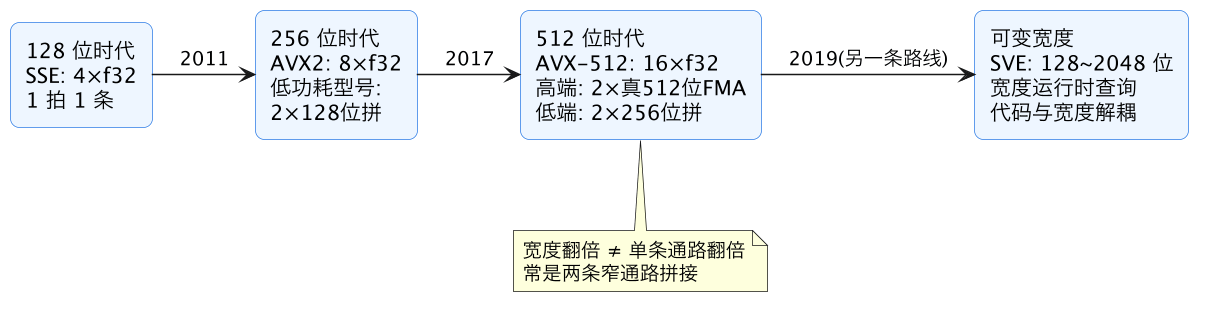
这张图想说明的是:宽度的「名义值」和「物理实现」经常不是一回事。查一台机器的向量能力,光看 ISA 支持表不够,还要看它有几个 512 位 FMA 端口——这直接决定双精度浮点峰值是乘 8 还是乘 16。
还有一个经常被性能工程师拿来当「玄学」的话题:宽向量与频率的联动。Skylake-SP 时代,512 位重负载会触发许可证降频(license-based downclocking),全核频率掉 10%~20%,部分场景「用 AVX2 反而比 AVX-512 快」。Ice Lake 之后这个惩罚大幅缩小,Sapphire Rapids 基本只在极端功耗墙下才显现。判断手上的机器是否受影响,最简单的办法是跑一个纯 FMA 循环,对比 -mavx2 和 -mavx512f 两版的全核实际频率(turbostat 或 /proc/cpuinfo 轮询)——频率不动,就放心上 512 位。
二、lane 组织:为什么跨 lane 操作天生贵
向量执行单元内部不是一整条 512 位宽的加法器阵列,而是按 lane(泳道)组织的 N 个基本同构的子单元。以 AVX-512 为例,16 个 32 位 lane 通常被组织成 4 组,每组 128 位,组内各 lane 完全并行、组间数据通路有限。
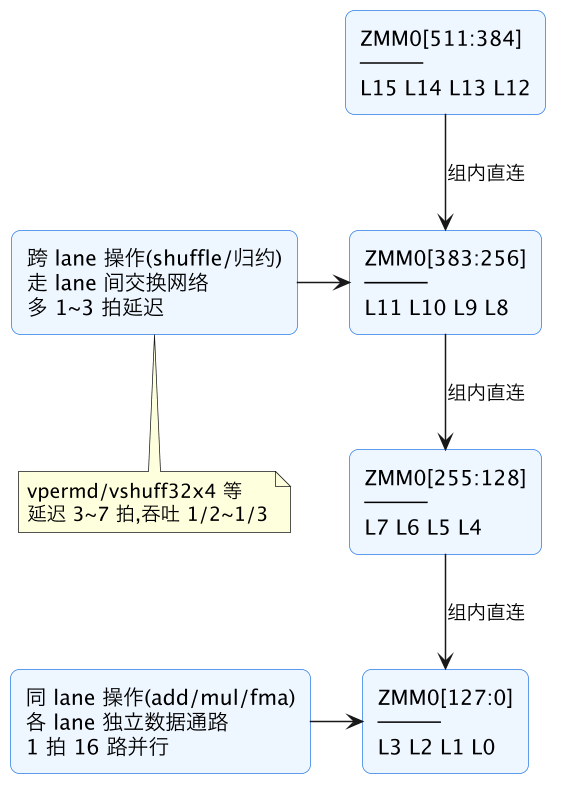
lane 组织对性能的直接后果有三条:
- 同 lane 的
vpaddd/vfmadd是满血的:16 路并行,延迟 1~4 拍,吞吐每拍 1~2 条。 - 跨 lane 的 shuffle 是半血的:
vpermd、vshufps要走一个单独的 shuffle 端口(Intel 上通常是 port 5),延迟 3 拍以上,吞吐降到每拍 1 条甚至更低。循环里每迭代一次都要 shuffle 的算法(比如某些卷积布局),实际吞吐被 shuffle 端口卡住,加法器闲着。 - 归约求和是最贵的:把 16 个 lane 加成一个标量,要 log2(16)=4 级跨 lane 操作,每一级都是 shuffle + add。这就是为什么高性能代码尽量把归约移出内层循环,或改成「多个累加器、循环外归约」的写法。
这就是为什么向量化不总是「宽度越大越快」:如果你的算法本质是相邻元素互相依赖(前缀和、递归滤波),lane 并行帮不上忙,强行向量化只会把跨 lane 开销摊进去。
lane 组织还影响一个工程决策:数据布局选 AoS(Array of Structs)还是 SoA(Struct of Arrays)。AoS 下 struct {x,y,z,w} points[N] 求所有 x 的和,每个 lane 要跨步取值、还要做 lane 间转置;SoA 下四个分量各成一个连续数组,load 进来 lane 天然对齐,一行 vaddps 就是满血吞吐。GPU 世界里这条经验早已是常识,CPU 向量编程同样成立——很多「向量化没收益」的案例,问题不在执行单元,而在喂给它的数据布局。
关于跨 lane 操作的具体代价,Intel 各代微架构的指令延迟表里有清楚的数字:vpermd(32 位粒度任意置换)延迟 3 拍、只占 port 5;vshuff32x4(128 位块粒度置换)延迟 3 拍;而同为「搬运」的 lane 内 vpshufd 只要 1 拍、可以在多个端口上发射。写向量化代码时,把数据重排尽量安排在循环外做一次,循环体内只留 lane 内操作,是性价比最高的一档优化。
三、掩码执行:分支向量化的硬件基石
标量代码里的 if (a[i] > 0) b[i] = sqrt(a[i]); 是向量化的噩梦——分支让「一条指令处理 16 个数据」的模型破了。掩码(mask)执行的答案:分支不转跳,改成「每个 lane 一个写使能位」。
AVX-512 引入 7 个掩码寄存器 k1~k7(k0 保留为「全开」),每条向量指令可以带一个 {k1} 后缀,表示「k1 里为 1 的 lane 才执行、才写结果;为 0 的 lane 结果寄存器原样保留(merge)或清零(zero)」。
vpcmpd  k1, zmm0, zmm1, 4    ; 16 个 lane 各自比较 → k1 是 16 位掩码
vsqrtps zmm2{k1}, zmm0       ; 只对掩码为 1 的 lane 做开方并写回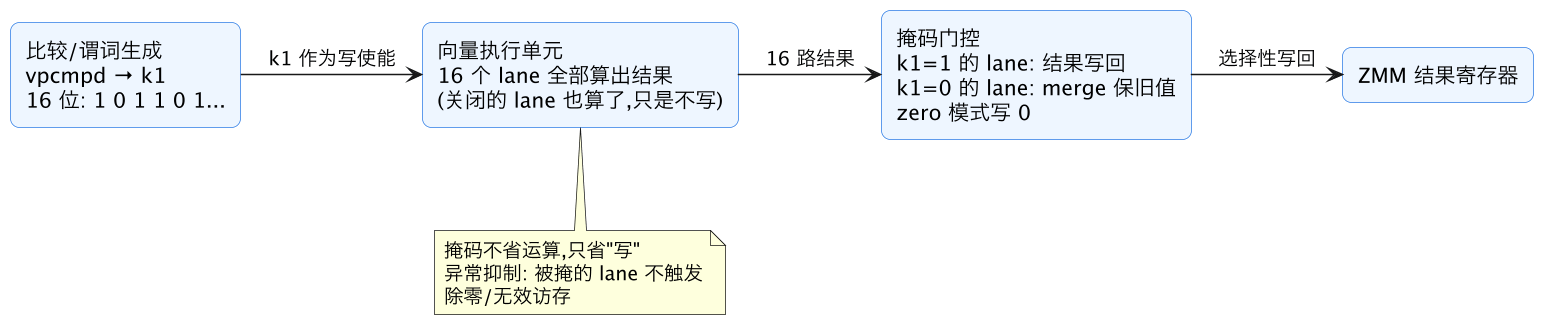
理解掩码有三个要点,每一个都对应一个真实的性能认知:
- 掩码不省功耗也不省拍:所有 lane 的运算照常做,只是写回被门控。所以「掩码一半 lane 是 0」的指令和全开的指令耗时一样——指望靠掩码跳过计算省钱是错觉。它的价值是消灭分支、消灭分支误预测,不是减少运算量。
- 异常抑制是隐藏福利:被掩掉的 lane 不触发浮点异常、也不触发访存缺页。这让「先算后筛」的向量化写法在有 0 除、空指针风险的代码里也安全,是编译器敢自动向量化的前提之一。
- ARM NEON 没有硬件掩码:NEON 用
vbsl(位选择)指令做软件 merge,效果一样但多占指令和寄存器。SVE/SVE2 才引入真正的谓词寄存器 p0~p15,思路与 AVX-512 的 k 寄存器同源。
掩码最常见的落地场景是循环尾处理。数组长度 1000,向量宽度 16,主循环吃掉 992 个元素后剩 8 个。没有掩码的时代要再写一段标量收尾循环(remainder loop),代码量翻倍、还带分支;有了掩码,收尾就是「生成一个低 8 位为 1 的掩码寄存器,再执行一次带掩码的同一套向量指令」。GCC/Clang 在 -mprefer-vector-width=512 配合下会自动生成这种结构,SVE 的 whilelt 更是把「生成收尾谓词」做成了指令集原语。看懂编译器输出的尾块是不是带 {k} 的指令,是检查自动向量化质量的快捷方法。
掩码寄存器本身也是稀缺资源:AVX-512 只有 7 个可用 k 寄存器,复杂的嵌套条件(if (a && b || c) 向量化后需要多个谓词做与/或运算)会耗尽它们,编译器只能把掩码 spill 到通用寄存器甚至内存。perf 里看到向量循环里夹着 kmov 到内存的操作,基本就是掩码寄存器不够用了——简化条件表达式或拆分循环通常能救回来。
四、gather/scatter:一条指令访问 16 个不连续地址
连续向量化到这一步只剩最后一个拦路虎:数据不连续。稀疏矩阵、哈希表、邻接表,下标 idx[i] 本身是数据,要访问 base[idx[i]]——这就是 gather(聚集加载),反方向的写是 scatter(散播存储)。
vpgatherdd zmm1{k1}, [r8 + zmm0*4] ; zmm0 是 16 个下标,一条指令取 16 个数硬件路径上,一条 gather 指令被译码拆成一串标量访存 µop,逐个 lane 走 load 流水线:算地址、查 TLB、查 L1、命中就填进对应 lane。16 个 lane 最多要访问 16 条不同的 cache line,最坏情况就是 16 次独立访存。
| 访存方式 | µop 数 | 最坏 cache line 数 | 典型吞吐(相对连续 load=1) |
|---|---|---|---|
| 连续 load(vmovups) | 1 | 2(跨行时) | 1.0 |
| 跨步 strided load | 若干 | 与步长相关 | 0.5~0.8 |
| gather(16 lane) | 16+ | 16 | 0.1~0.2 |
| scatter(16 lane) | 16+ | 16 | 0.1~0.2(还涉及写合并冲突) |
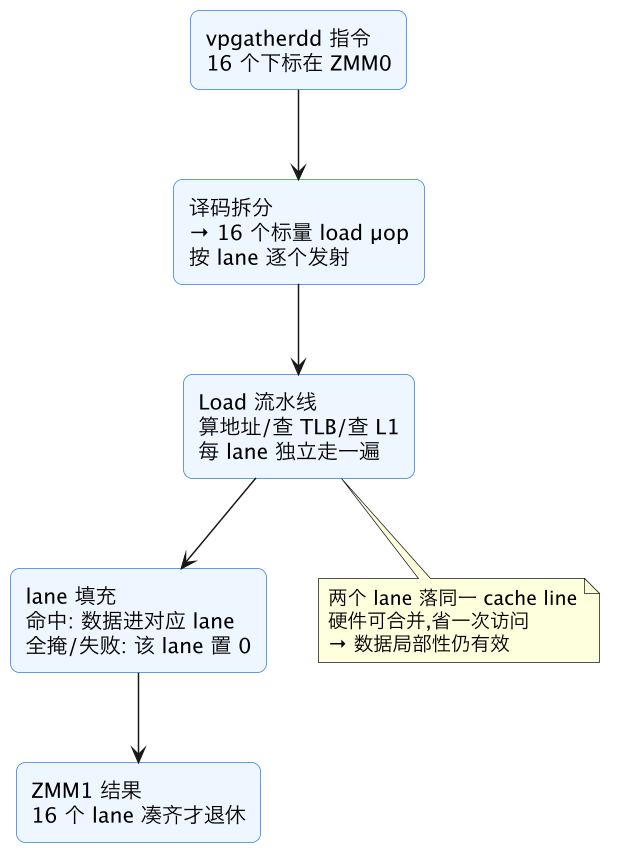
这张图解释了 gather 的两个反直觉事实:一是它慢但不是「16 倍慢」,落在同一 cache line 的 lane 会被硬件合并,局部性好的下标序列能快好几倍;二是 gather 的全部 16 个 lane 凑齐指令才退休,任何一个 lane 缺页或 L2 miss 都拖住整条指令——tail latency 由最慢的那个 lane 决定。
实践结论:能用连续或 strided 布局就别用 gather;必须 gather 时,把下标排序/分桶提高同 line 命中率,收益常常超过换更快的 CPU。
scatter 比 gather 还要再差一档。写操作涉及 cache line 的所有权获取(MESI 协议下要先把 line 拉成 Modified 状态),16 个 lane 散到 16 条 line 就是 16 次所有权协商;更糟的是两个 lane 写同一 line 时硬件还要处理写合并与顺序。所以真实代码里 scatter 极其罕见——大多数「散写」算法(直方图、稀疏矩阵装配)宁可改成两遍法:第一遍按目标分桶,第二遍每桶连续写,彻底避开 scatter。
还有一个容易踩的坑:gather 与掩码组合时,被掩掉的 lane 不发起访存(这也属于异常抑制的一部分),所以「先比较出有效下标、再带掩码 gather」是安全的惯用法。但如果掩码大部分为 0,这条 gather 依然要按有效 lane 数逐个走 load 流水线,省不下多少拍——稀疏到这种程度时,标量代码配合乱序执行往往反而更快,这是向量化「不是越宽越好」的又一个例证。
五、观测:怎么知道向量单元吃没吃满
判断向量执行单元的利用率,perf 给了一组直接可测的计数器:
perf stat -e fp_arith_inst_retired.scalar_single,\
fp_arith_inst_retired.128b_packed_single,\
fp_arith_inst_retired.256b_packed_single,\
fp_arith_inst_retired.512b_packed_single ./app
四个事件的组合能还原出向量化的全貌:512b 占比高说明编译器用上了 AVX-512;256b 高可能是编译器保守(-mavx2 而不是 -mavx512f),也可能是故意规避 512 位降频(早期 Skylake-SP 的 AVX-512 offset 让重向量负载全核降频 10~20%,新架构 Ice Lake 之后基本消除)。scalar_single 占比高则说明代码根本没被向量化,或者向量化失败退化成了标量回退路径,此时该先查编译器优化报告(GCC 的 -fopt-info-vec-all)而不是怪硬件。
另外三个常见瓶颈信号:
- 端口 5 压力大(
uops_dispatched_port.port_5占比异常高)→ shuffle/跨 lane 操作过多,考虑换数据布局。 - 向量指令多但 IPC 低 → 掩码利用率差(大半 lane 是空转)或 gather 拖尾。
vpgatherdd出现在 perf annotate 热点 → 稀疏访存是真正的墙,别在算上加优化了。
最后还有一个工程师经常忽略的点:向量单元和标量单元共享发射端口和物理寄存器文件。一个满是 AVX-512 的循环 IPC 掉到 1 以下很正常——它每拍只能发射 2 条 512 位 FMA,但每条干 32 个标量运算的活,换算成标量等效 IPC 是 60+。看向量代码的性能,永远要换算成「等效标量吞吐」再下结论。
把整条观测路径串起来,可以形成一套固定的排查顺序:先看 fp_arith_inst_retired.* 的宽度分布,确认编译器到底生成了什么;再看端口分布,排除 shuffle 端口堵塞;接着用 perf annotate 找热点指令,gather/scatter 上榜就回到数据布局;最后对纯计算循环做一次频率对比,排除宽向量降频。四步走下来,「向量单元是不是瓶颈」这个问题基本能给出定量答案,而不是凭感觉猜。
这一篇在知识体系里的位置
本篇是 concepts/microarch 序列里执行单元侧的一块拼图:上游是流水线基础和超标量设计(每拍几条指令),同层是乱序执行(指令怎么找到并行度),本篇回答「每条指令内部还能再并几份」。向量单元的性能最终会被访存系统封顶,与 LSU 的 load/store 端口、数据预取联动阅读;遇到实际程序吞吐不达标时,回到 IPC 瓶颈 用本文第五节的事件做归因。
总结
SIMD 向量执行单元是 CPU 吞吐的最后一级乘法器:宽度从 128 位扩到 512 位靠的是 lane 并行组织而非单条巨宽通路,跨 lane 操作因此天生半血;掩码用「全算、选择性写」消灭了分支向量化的障碍但不省运算;gather/scatter 把一条指令拆成 16 次标量访存,性能上限由数据局部性而非向量宽度决定——判断它是否被吃满,看 packed 指令计数器的宽度分布和端口 5 占用,并把 IPC 换算成等效标量吞吐再说话。