超标量宽度:发射宽度扩展的收益递减与 wakeup/select 复杂度墙全解
更新时间:2026-10-02。流水线与超标量 那篇建立了基本概念:一条流水线每个周期处理一条指令,超标量(superscalar)就是复制多条流水线,让一个周期能同时推进多条指令,用宽度换 IPC。那篇里留了一个尾巴——「既然加宽能提 IPC,为什么主流核停在 6 宽、8 宽,没人做 16 宽、32 宽?」这一篇就把这个问题展开成完整的一篇:超标量宽度的确切定义、它加在流水线的哪些段、每加一路宽度收益为什么递减,以及真正的硬天花板——发射阶段 wakeup/select 逻辑的平方级复杂度。它是理解现代 CPU「宽度竞赛为什么在 2010 年代后熄火」的关键;乱序执行的整体框架见 CPU 乱序执行,发射队列本身的结构见 发射队列的唤醒与选择。
本文要回答的问题
- 「超标量宽度」到底指流水线哪一段的宽度?取指宽、译码宽、发射宽、提交宽是不是一回事?
- 宽度从 N 加到 N+1,理想收益是多少,实际收益为什么随 N 增大而递减?
- 发射阶段的 wakeup(唤醒)和 select(选择)逻辑复杂度为什么随宽度平方增长?
- 除了发射队列,还有哪些结构的成本随宽度超线性增长(寄存器堆端口、旁路网络)?
- 工业界绕开宽度墙的几条路线(簇式发射、宏融合、更聪明的前端)各自解决了什么?
一、宽度不是一个数:流水线各段的宽度剖面
谈论「超标量宽度」前先要拆清楚一件事:一颗标称「6 宽」的处理器,不是说整条流水线从头到尾都是 6 条车道。宽度是分段的,每一段有自己的宽度,而且各段宽度可以不同。
一条现代乱序核的流水线大致是:取指(fetch)→ 译码(decode)→ 重命名(rename)→ 派遣(dispatch,写入发射队列和 ROB)→ 发射(issue,从发射队列挑就绪指令送执行单元)→ 执行(execute)→ 提交(retire)。x86 阵营常说的「6 宽 decode / 8 宽 dispatch / 10+ 执行端口」,就是指各段宽度不一样:前端窄一点,执行端宽一点,用缓冲队列吸收两段之间的速率差。
三个最容易混淆的宽度概念:
- 取指/译码宽:每周期从指令缓存取多少字节、译出多少条微操作(uop)。受限于指令对齐和跨缓存行问题,x86 变长指令的译码宽度扩展特别痛苦,见 x86 变长指令译码。
- 发射宽(issue width):每周期从发射队列选出多少条就绪指令送执行。这是本篇的主角,通常也是「超标量宽度」默认指的那个数。
- 提交宽(retire width):每周期按程序序从 ROB 头部提交多少条。它必须不小于平均 IPC,否则 ROB 头部堵死反压全流水线,见 ROB 重排序缓冲。
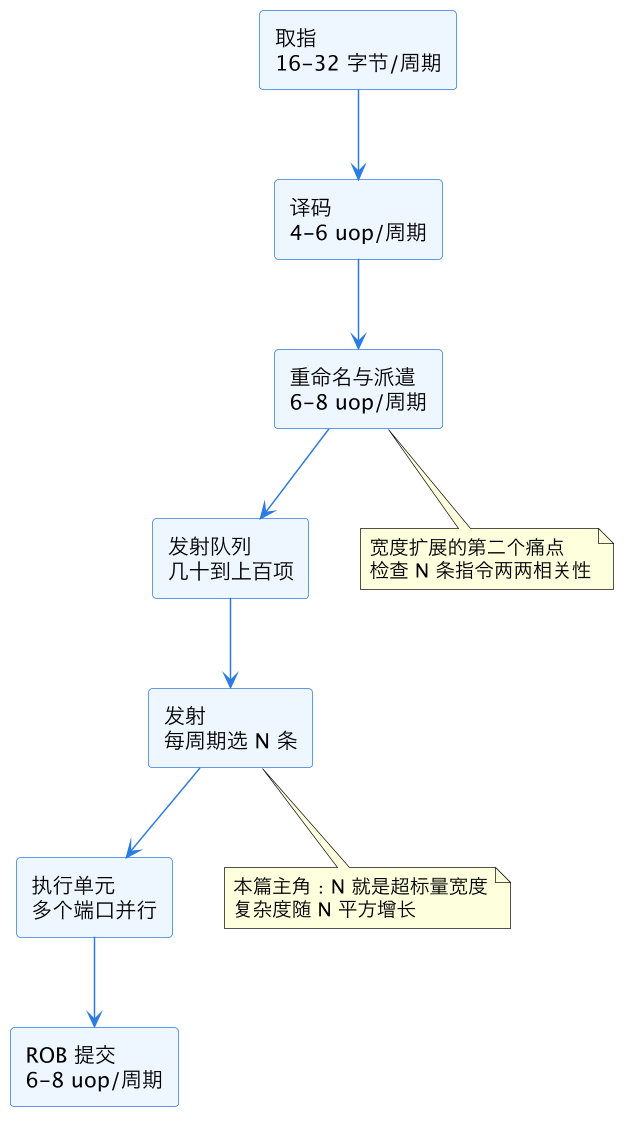
上图把各段宽度画成一个漏斗加缓冲的形态:前端像漏斗,发射队列是蓄水池,执行端摊得最开。之所以允许各段宽度不同,是因为指令流天然不均匀——一段循环体可能连着 4 条整数加法、又来 2 条访存,前端按平均速率喂,蓄水池削峰填谷,执行端按端口类型分流。理解这一点后,「加宽」这个问题就具体化了:你要加宽的是哪一段?每一段加宽的成本和收益完全不同,而本篇要论证的是:所有段里,发射段是成本最恐怖的那一段。
二、收益的数学:为什么第 N 路的贡献越来越小
先看理想世界。如果指令间完全独立、执行单元永远不冲突、分支从不误预测,N 宽发射的 IPC 就是 N,宽度翻倍性能翻倍。真实世界离这个理想有多远,可以用一个简化的模型感受:假设每条指令与「窗口内它之前的任意一条指令」存在真相关的概率为 p,那么 N 条指令「两两全部无关、可以同拍齐发」的概率是 (1-p)^(N(N-1)/2)。注意那个指数——组合数是平方级增长的,N 稍大,这个概率就雪崩。
这就是收益递减的第一个来源:指令级并行度(ILP)是程序本身的属性,不是微架构能无限榨取的资源。大量研究(从 1990 年代 Wall 的经典研究到近年的模拟)都指向同一个数字区间:主流整数应用的可持续 ILP 大致在 2-4 之间,个别向量密集的循环内核能到 6-8。当宽度超过程序能提供的 ILP,新增的车道大部分时间在空跑。
收益递减的第二个来源是配套的队列资源必须同步放大。发射宽度只有配合足够大的乱序窗口才有意义——窗口里凑不出 N 条可并行指令,发射端再宽也白搭。而 ROB、发射队列、load/store 队列的容量扩大,本身又会拖累访问延迟和功耗(见 乱序执行的边界),形成「宽度要窗口、窗口要容量、容量拖频率」的连环约束。
第三个来源是分支误预测的惩罚随宽度放大。W 宽的机器误预测一次,冲刷的是「误预测点之后已流入流水线的所有投机指令」,流水线越深越宽,浪费的取指槽位越多。一个直观估计:平均分支间隔约 5-6 条指令,W 宽机器每个周期平均遇到 W/5 条分支,前端预测器的压力随宽度线性上升,而误预测率不可能无限压低(见 分支预测 与 TAGE 分支预测器)。宽度越大,赌博的筹码越大,而赢面没有同比例变好。
| 宽度 | 理想 IPC | 典型整数负载实测 IPC 区间 | 新增一路的边际收益 |
|---|---|---|---|
| 2 宽 | 2 | 1.5-1.8 | 基准 |
| 4 宽 | 4 | 2.0-2.6 | 明显 |
| 6 宽 | 6 | 2.4-3.0 | 可见但减弱 |
| 8 宽 | 8 | 2.6-3.2 | 进一步收窄 |
| 12 宽以上 | 12+ | 提升进入噪声区间 | 趋近于零 |
这张表是大量公开模拟与实测数据的浓缩口径:从 2 到 4 是最划算的一步,4 到 6 还值,6 到 8 开始犹豫,8 以上基本是为特定负载(向量、数据库、特定科学计算)服务,通用整数负载已经喂不饱。Apple 的 Firestorm/Avalanche 一代把宽度推到 8 宽 decode,靠的是配合巨大的乱序窗口(ROB 600+ 项)才把收益留住——这恰好从反面证明了宽度和窗口是捆绑销售。
三、成本的物理:wakeup/select 的平方级复杂度墙
收益递减是「软」约束——你肯烧钱,总还能挤出一点。真正把宽度卡死的是「硬」约束:发射逻辑的物理复杂度。这是全篇的核心,值得一步步推。
发射队列每周期干两件事。第一件是 select(选择):从队列里所有「源操作数已就绪」的指令中挑出最多 N 条(N 即发射宽度),送上 N 个执行端口。第二件是 wakeup(唤醒):本周期被执行完成、刚产出结果的指令,要把「结果就绪」的消息广播给队列里所有等待这个结果的指令,把它们对应源操作数的就绪位置位,好让它们在下个周期成为 select 的候选。
问题的关键在于 wakeup 是背靠背的。一串依赖链 A → B → C,A 周一拍执行完,B 必须周二拍就能被选上(背靠背调度),否则依赖链每环多一个气泡,IPC 直接打七折。也就是说 wakeup+select 的完整环路——「结果产生 → tag 广播 → 就绪位匹配置位 → 仲裁选出下一条 → 送出」——必须在一个时钟周期内闭合。这个环路是全芯片时序最紧的路径之一,处理器设计师叫它「关键环路」。
现在数一下这个环路的规模随宽度怎么长:
- tag 比较器:W 宽发射意味着每周期最多有 W 条指令完成、要广播 W 个目标物理寄存器 tag;队列里 Q 个表项、每项 2 个源操作数,每个源都要和全部 W 个 tag 比一遍。比较器数量 = 2 × Q × W。宽度翻倍,比较器翻倍;队列容量 Q 也得随宽度加大(前面说过窗口捆绑),所以实际是 W 和 Q 一起涨。
- 广播线网:W 条 tag 总线要拉到队列里每一个表项的比较器上,线长、扇出、线间耦合全部随 W 和 Q 增长。在深亚微米工艺里,延迟越来越由互连线主导而不是门延迟主导——比较器本身很快,慢的是「把 tag 拉到全场」这件事。
- select 仲裁器:从就绪候选里挑 N 条,是个多输入优先级选择器,输入是全部 Q 项的就绪标志,逻辑级数随 Q 增长;而「每个执行端口一条」的分配逻辑(尤其端口和指令类型不完全对称时)又是一个 W × 端口的匹配问题。
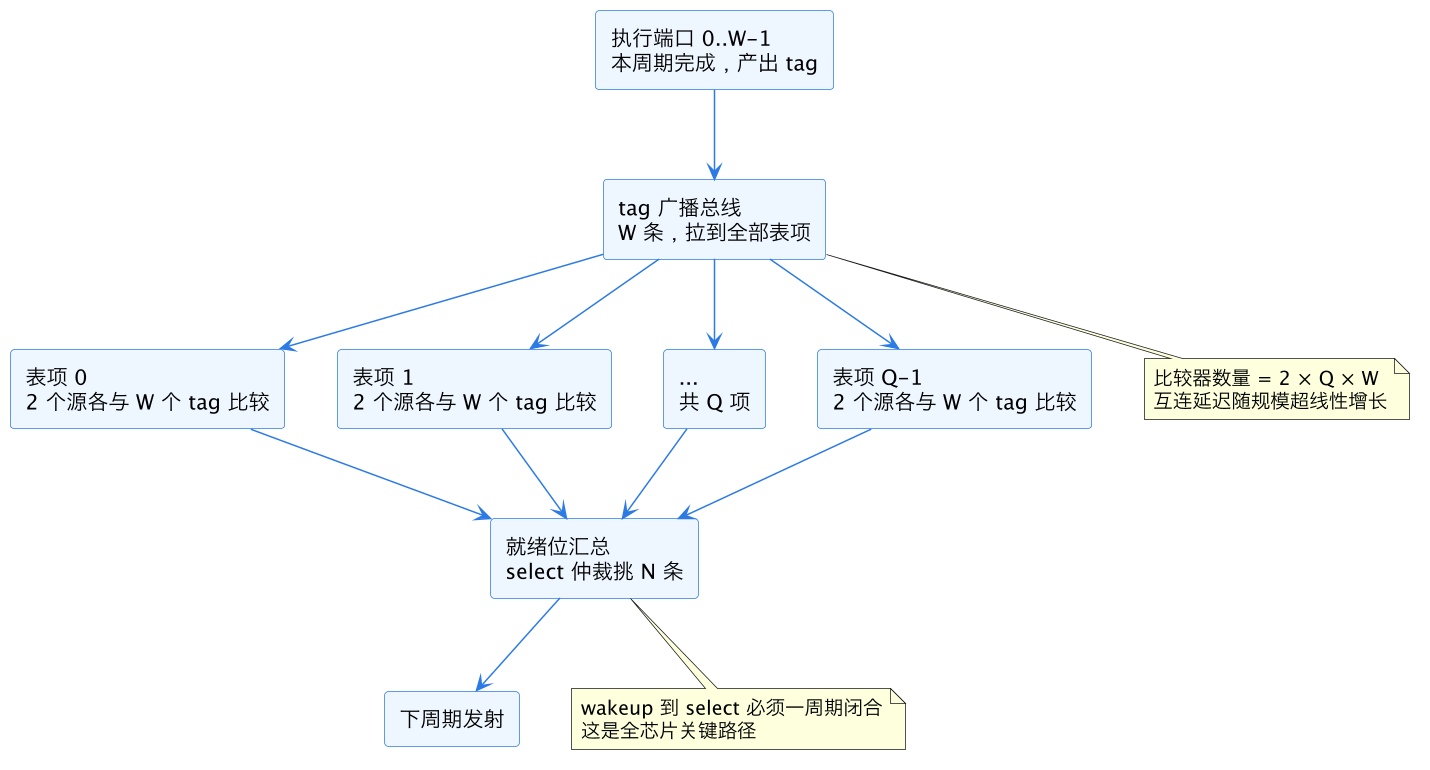
上图把 wakeup 环路画出来了:W 个完成端口的结果 tag 通过总线打到全部 Q 个表项的比较器上,置位就绪标志后汇总进 select 仲裁。箭头数量就是比较器数量的物理意义——每一根箭头都是一条要在一个周期内跑完电平、做完比较、翻好触发器的真实导线。综合效应是:wakeup/select 环路的面积和延迟大致随 W × Q 增长,而 Q 又必须随 W 增长才有意义,于是复杂度随宽度接近平方。这就是教科书里说的「发射逻辑的平方复杂度墙」。经典文献(Palacharla 等人 1997 年的著名研究)用具体电路模型算过:发射宽度从 4 到 8,这个环路的延迟恶化会直接吃掉相当一部分频率余量;要么降频,要么把 wakeup/select 拆成两周期(引入背靠背气泡、IPC 受损)——横竖都是付账。
经验法则可以记成一句话:加宽一路发射,买到的是「最多 +1 IPC」的期权,付出的是「整个核心时序风险重新谈判」的实价。宽到一定程度,时钟频率被迫下调的损失会超过发射槽位增加的收益,净效果为负。
四、不止发射队列:其他平方级成本的帮凶
wakeup/select 是最出名的一面墙,但不是唯一一面。加宽发射会在好几个地方同时触发超线性成本,值得一起点名,因为它们经常在同一份设计评审里被一起摆上桌。
寄存器堆读端口。W 宽发射、每条指令最多 2 个源操作数,物理寄存器堆就需要最多 2W 个读端口(加少量写端口)。多端口寄存器堆的面积大致随端口数平方增长(每个端口都要纵横走线到所有存储单元),这也是「寄存器堆端口是微架构师最舍不得花的预算」这句话的由来。常见对策是读端口「借用」(操作数刚从旁路网来就不用读堆)和寄存器堆分簇复制,详见 物理寄存器堆读端口。
旁路(转发)网络。结果不等人——上一条 ALU 指令的输出要在下一周期直接喂给下一条的输入,绕过寄存器堆。全互联旁路的复杂度是「执行端口输出数 × 执行端口输入数」,即 W 平方量级。8 宽全旁路的布线在先进工艺下都令人头疼,很多设计实际做成「半旁路」:只有延迟敏感的 ALU 簇之间全互联,跨簇或多周期单元走慢速路径。
重命名段的相关性检查。每周期重命名 N 条指令,要把每条指令的源寄存器和「同组内它前面 N-1 条的目的寄存器」两两比对,检查组内 RAW/WAW 相关。比较次数是 N(N-1)/2——又是一个平方。好在重命名段不在背靠背关键环路上,可以用两周期流水缓解,见 寄存器重命名。
load/store 消歧。发射宽度放大后,窗口里同时在飞的访存指令也增多,每条 store 要和窗口内所有更老的 store、每条 load 要和所有更老的 store 做地址比对,CAM 比较阵列同样随窗口平方增长,见 Load/Store 队列与访存消歧。
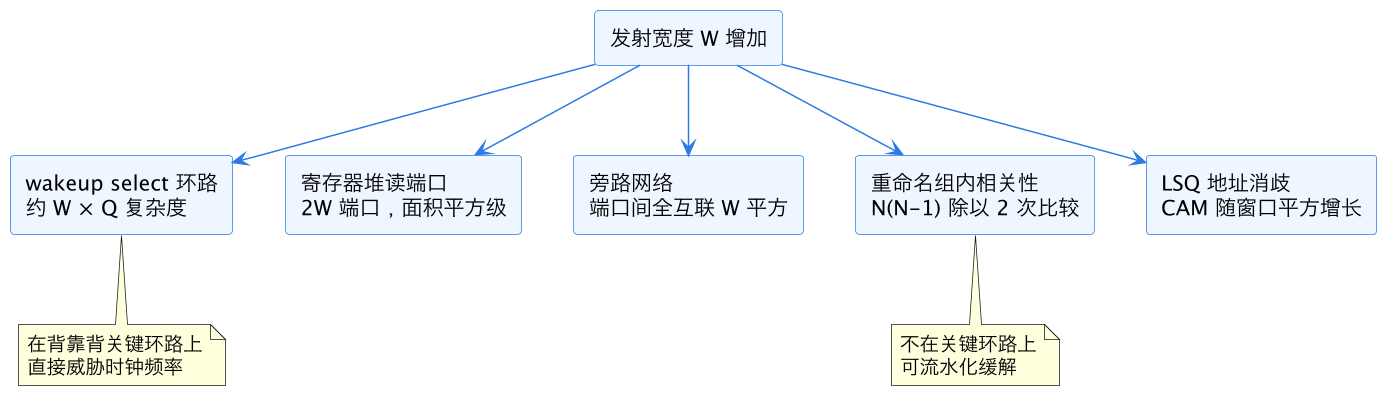
上图把五个平方级成本挂到同一个源头。注意它们的「痛感」不一样:wakeup/select 因为在单周期关键环路上,是最致命的那个;重命名相关性检查逻辑规模类似但时序宽松,可以打拍子消化。做宽度决策时,本质是拿这一整张成本清单去和上一节的收益表对赌。
五、绕墙的路线:簇式发射、融合与前端的补偿
平方墙撞不死工程,只撞死「无脑加宽」。过去二十年,工业界发展出几条绕墙路线,每一条的思路都是「不再追求全局统一的大发射器,改从结构上把平方拆开」。
簇式(clustered)发射:把一个大发射队列拆成 2-4 个小队列,每个小队列只管自己的一部分执行端口(比如一个整数簇一个浮点簇)。簇内 wakeup/select 的规模是 Q/2 × W/2,复杂度降为四分之一;代价是派遣时要做负载均衡,且跨簇依赖的 wakeup 可能慢半拍。早期的 Alpha 21264、很多嵌入式多发射核都走这条路——用一点 IPC 换时序,把墙拆掉一角。
宏融合与微融合:不增加发射槽位,而是让每个槽位干更多活。x86 的 cmp + jcc 宏融合让两条指令占一个发射槽,load-op 微融合让一条访存算一体指令只占一个队列项。等效于「不拓宽马路,让每辆车变双层巴士」,见 宏融合与微融合。
更强的前端与预测:既然宽度瓶颈在「凑不出足够多可并行指令」,那就提高供给质量——更准的分支预测(见 TAGE 分支预测器)、更深的取指缓冲、uop cache 跳过译码(见 循环流检测器 LSD)。前端省下的每一个气泡,都是对现有宽度的更好利用,边际成本远低于加宽。
转向线程级与数据级并行:这是战略层面的回答。单线程 ILP 榨干之后,增量性能预算转向 SMT(一个核的宽度由两个硬件线程共享,发射槽位利用率天然提高)、SIMD/向量宽度(512 位向量一条指令顶 16 个标量操作)、以及干脆多放几个核。AArch64 阵营近年甚至出现了「宽度往回收一点、频率和能效往上抬」的设计取向,因为功耗墙下每瓦性能比峰值 IPC 更值钱。
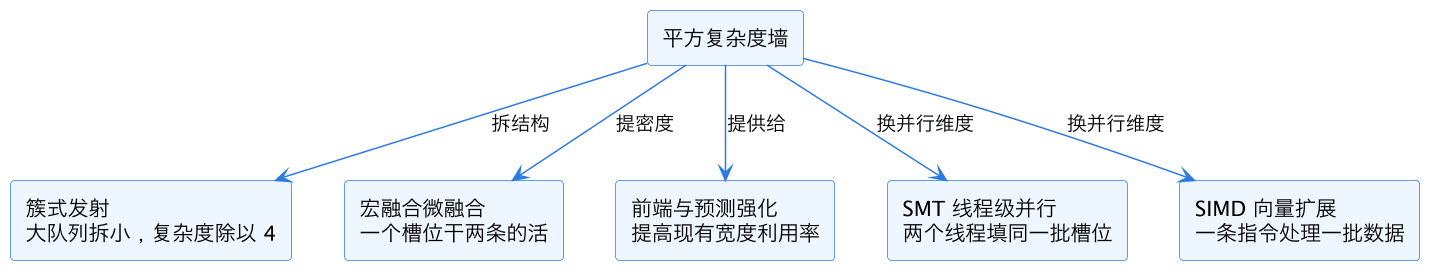
五条路线的共同点是:没有一条试图把 wakeup/select 的单周期环路继续做大,全部选择「绕」而不是「撞」。这本身就说明了墙有多硬——不是没人想撞,是撞过的人(比如安腾那种把复杂度甩给编译器的 EPIC 路线)都没撞到便宜。
最后给一个落地视角:怎么看一颗真实 CPU 的宽度设计取舍。看三组数字就够——decode 宽度、发射端口数、ROB 容量。decode 宽而 ROB 小,是「宽前端窄窗口」,宽度利用率必然差;端口多而 decode 窄,是「前端喂不饱后端」。三者协调、且与目标负载的 ILP 匹配,才是平衡设计。Intel Golden Cove 的 6 decode + 12 端口 + 512 ROB、Apple M 系的 8 decode + 大 ROB,AMD Zen 的 4-6 decode + 分簇调度器,都是在这张成本收益表上选了不同的落点。
这一篇在知识体系里的位置
本篇是微架构模块里「乱序执行」线的一篇深水篇,回答「超标量宽度为什么不能无限加」。上游基础是 流水线与超标量 和 CPU 乱序执行;本篇核心的 wakeup/select 环路细节在 发射队列的唤醒与选择 单独展开,配套的队列结构见 保留站 与 ROB 重排序缓冲。横向相关:重命名侧的成本见 寄存器重命名,端口争抢的运行时表现见 执行端口竞争,宽度利用率的观测视角见 IPC 瓶颈分析,全图见 CPU 微架构总览。
总结
超标量宽度的扩展是一场收益递减与成本递增的对赌:程序固有 ILP 只有 2-4,让第 N 路发射的边际收益迅速归零;而 wakeup/select 的背靠背环路、寄存器堆端口、旁路网络、重命名检查的成本都随宽度近平方增长,其中最致命的发射环路直接卡时钟频率——于是工业界在 6-8 宽附近停手,改用簇式发射、宏融合、前端强化、SMT 与 SIMD 绕开这堵墙,把「更宽」换成了「更密、更准、更多维」。