HBM 与 GDDR 控制器差异:宽接口多伪通道与高频窄接口的调度分野
更新时间:2026-10-03。DRAM 子系统组织 那篇把通道、rank、bank 这套层次讲清楚了,DRAM 控制器 FR-FCFS 调度 讲了通用内存控制器怎么在请求队列里挑行缓冲命中的请求先发。但那两篇有一个隐含前提:它们描述的是「经典 DDR 式」控制器——几十条数据线、每通道一两个 rank。当你走进 GPU 和 AI 加速卡的世界,前提崩塌了:同一块卡上可能焊着八颗 GDDR6,也可能封装内堆着六个 HBM3 堆栈,两者都叫「高带宽内存」,带宽数字也接近(单颗都在几百 GB/s 到 1 TB/s 量级),但它们的内存控制器几乎是两种动物。这一篇把 HBM 与 GDDR 控制器差异拆开看:接口物理形态怎么决定控制器的通道组织、伪通道(pseudo channel)为什么把调度粒度腰斩、突发长度差异怎么改变行缓冲策略、以及落到延迟和能效上的真实后果。下游的 bank 并行性背景见 DRAM Bank 并行性与 Rank,刷新管理见 DRAM 刷新管理。
本文要回答的问题
- HBM 和 GDDR 在接口宽度、频率、颗粒数上走的是哪两条相反路线?
- HBM 的伪通道是什么?它和普通 DDR 通道在控制器眼里差在哪?
- 突发长度 32 字节对 64 字节的差异,怎么改变控制器的调度与预取策略?
- 同样一笔读请求,在两类控制器里的队列旅程和延迟构成有何不同?
- 什么负载适合 HBM、什么负载适合 GDDR?选型背后的控制器原因是什么?
一、两条物理路线:把宽度摊平,还是把频率拉高
要理解控制器差异,先看它们服务的内存颗粒长什么样。
GDDR(Graphics DDR,图形双倍数据率内存)走的是「单颗窄接口、拼命拉频率」的路线。一颗 GDDR6 颗粒的数据接口只有 32 位宽(拆成两个 16 位的独立通道),但 I/O 引脚上的数据率高达 16 到 24 Gbps——靠 PAM3 之外的编码、极端均衡的走线和大量信号完整性工程硬堆出来的。一张显卡要凑 384 位总线,就焊 12 颗颗粒,控制器侧对应 12 到 24 个窄通道。
HBM(High Bandwidth Memory,高带宽内存)走的是完全相反的路线:把 4 到 16 层 DRAM die 用 TSV(Through-Silicon Via,硅通孔,在硅片里垂直打孔布线)堆成一摞,整摞提供 1024 位的超宽接口,但单引脚数据率只有 6 到 8 Gbps(HBM3 约 6.4 Gbps,HBM3E 到 9.x)。它不拼引脚速度,拼的是引脚数量——1024 根数据线通过硅中介层(interposer)上的短走线直连处理器,距离只有几毫米,信号完整性压力小得多,所以可以用低电压、低频率跑出总带宽。
| 维度 | GDDR6 / GDDR6X | HBM3 / HBM3E |
|---|---|---|
| 单颗粒接口宽度 | 32 位(2 个 16 位通道) | 1024 位(16 个 64 位伪通道) |
| 单引脚数据率 | 16 到 24 Gbps | 6.4 到 9.2 Gbps |
| 单颗粒带宽 | 64 到 96 GB/s | 约 819 GB/s 到 1.2 TB/s |
| 典型配置 | 8 到 12 颗环绕 GPU | 4 到 6 堆栈封装内集成 |
| 走线距离 | PCB 上数厘米 | 中介层上数毫米 |
| 每比特能耗 | 约 15 到 20 pJ/bit | 约 3 到 5 pJ/bit |
表里最后一行是能效,它是两条路线分野的经济学根源:频率拉高的代价是 I/O 功耗随数据率超线性增长,宽度摊平的代价是封装成本(中介层、TSV 良率)。控制器是这场物理分工的「软件侧镜像」——物理层选了宽而慢,控制器就要管大量窄通道;物理层选了窄而快,控制器就要在少量通道上做极高频的调度。
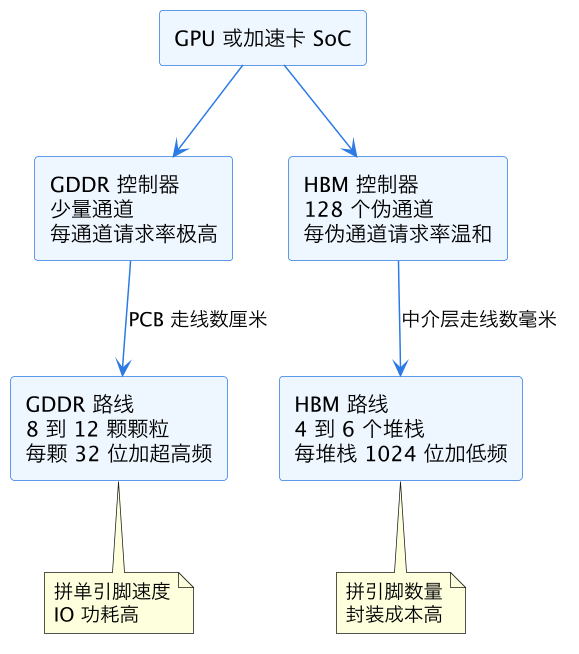
上图是两条路线的总对照。注意一个容易看漏的细节:GDDR 控制器管的是「个位数到二十几个」通道,HBM 控制器管的是「上百个」伪通道(一个 6 堆栈 HBM3 系统有 6 乘 16 共 96 个伪通道,HBM3E 类似)。通道数量差了一个数量级,这直接决定了下面每一节的差异。
二、伪通道:HBM 把调度粒度腰斩的设计
HBM 接口里最反直觉的概念是伪通道(pseudo channel)。HBM2 开始,一个物理上 128 位的「真通道」在控制器眼里被劈成两个 64 位的伪通道,各自有独立的命令总线、独立的地址空间视图、独立的 bank 状态机,但共享同一组数据引脚的一半——准确说是各自独占 64 位数据线,只共享命令地址引脚的一部分时序资源。HBM3 延续并强化了这个结构:一个堆栈 1024 位接口 = 16 个伪通道,每个 64 位。
为什么要劈?因为 DRAM 内部 bank 的激活、预充速度几十年没怎么进步(tRC 仍在 45 纳秒上下),而接口带宽翻了几十倍。如果还按 1024 位一个通道管,一次激活要喂饱 1024 位数据线,需要的行缓冲带宽和突发长度会把 bank 内部结构逼疯;劈成 16 个伪通道后,每个伪通道只对应一部分 bank group,命令密度和 bank 并行度匹配上了。劈通道的深层动机——用更多独立 bank 状态机消化更高带宽——正是 DRAM Bank 并行性与 Rank 讲的 bank 并行性原理在接口层的延伸。
对控制器而言,伪通道带来三个直接后果。
第一,调度器实例数量爆炸。每个伪通道需要一套独立的命令调度器(维护该通道的 bank 状态、时序约束检查、读写周转),96 到 128 个伪通道就是上百个小调度器并行跑。HBM 控制器因此普遍采用「地址哈希到伪通道 → 每伪通道一个小队列」的两级结构,没有一个全局大仲裁器——做全局仲裁在 128 个端口下物理上收敛不了时序。
第二,单次传输粒度变小。64 位接口一次突发 16 拍(HBM3 的 BL16 等效)传 128 字节,但常见的原子操作单位是 64 字节(伪通道模式下 BL8),正好对上一个缓存行的一半到一行。GDDR6 那边是 16 位通道加 BL16 一次传 32 字节,控制器要连续发两次突发凑齐一个 64 字节缓存行。粒度差异看起来琐碎,实际决定了下一节的突发与合并策略。
第三,局部性放大。地址哈希让相邻缓存行散到不同伪通道,空间局部性好的流式负载天然获得并行度;但哈希也意味着「同一行内的两次访问」必然落在同一伪通道,控制器内部的行缓冲命中优化只在伪通道粒度内有效。
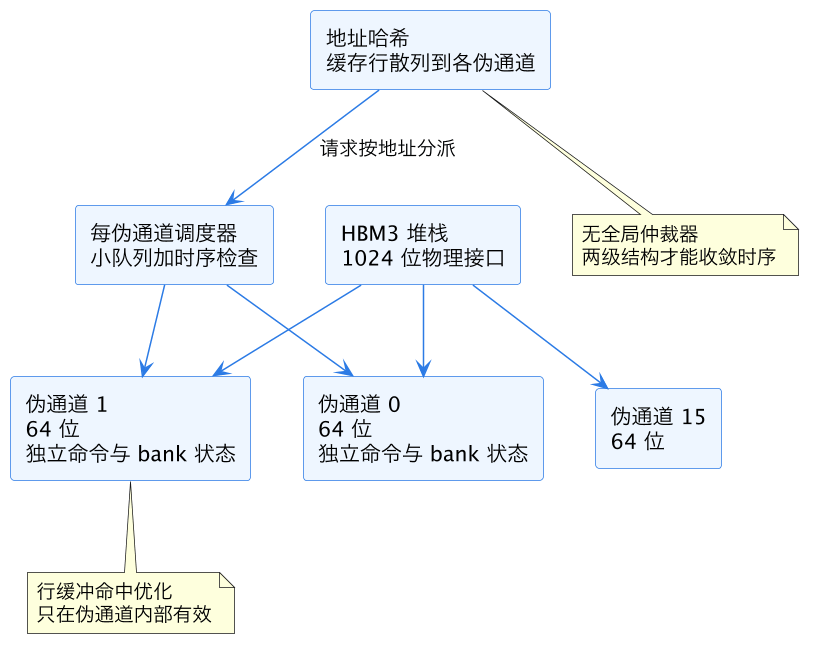
上图画的是一个 HBM 堆栈内部的伪通道分解与请求流。请把「伪通道」理解成一个完整但微缩的 DDR 通道:它有自己的请求队列、自己的 bank 表、自己的刷新计时器(刷新的协同见 DRAM 刷新管理,HBM 的刷新按堆栈统一发但各伪通道内部自行安排)。GDDR 控制器没有这一层——它的通道就是物理通道,数量少得多,每个通道反而更「重」。
三、突发长度与请求合并:32 字节世界和 64 字节世界
突发长度(BL,Burst Length)是一次读或写命令在数据线上连续传多少拍,它是连接接口物理与控制器调度的关键参数,也是 HBM 与 GDDR 控制器差异里最「战术」的一环。
GDDR6 的每个 16 位子通道突发 16 拍,一次命令传 32 字节。一个 CPU 风格的 64 字节缓存行需要两条连续命令(或一条命令跨两个子通道交织)。更要命的是 GDDR 的 WCK(写时钟)模式让读写切换有可观的周转代价(bus turnaround,总线换向),控制器必须尽可能把同方向的请求攒成批再发——这直接催生了 GDDR 控制器里比 DDR 更激进的请求重排与方向批处理:队列不只是按「行缓冲命中优先」(FR-FCFS,见 DRAM 控制器 FR-FCFS 调度)排,还要按「读批与写批」分组,一整批读完再一整批写,把总线换向次数压到最低。
HBM3 伪通道一次突发传 64 字节,正好一个缓存行,一拍一行的世界里「凑行」问题消失了。但新问题是:每个伪通道带宽相对温和(64 位乘 6.4 Gbps 约 51 GB/s),单个伪通道的队列深度有限,控制器更依赖「多伪通道同时流水」而不是单通道深挖。HBM 控制器的写合并策略也相应调整:写请求倾向于尽快下放到伪通道队列空着的位置,利用伪通道间的天然并行吸收写流量,而不是像 GDDR 那样攒大批。
可以用一个直觉比喻收尾这一节:GDDR 控制器像管理几条高速公路的调度中心,每条路车速极快,重点是减少出入口匝道切换(总线换向);HBM 控制器像管理上百条城市小路的调度中心,每条路车速普通,重点是把车流均匀撒到所有路上(哈希与负载均衡)。
| 调度关注点 | GDDR 控制器 | HBM 控制器 |
|---|---|---|
| 单命令传输粒度 | 32 字节 | 64 字节 |
| 凑齐一个缓存行 | 两次突发或子通道交织 | 一次突发 |
| 读写换向代价 | 高,需方向批处理 | 中等,伪通道并行可掩盖 |
| 重排激进度 | 激进,大队列深挖行命中 | 温和,依赖多伪通道并行 |
| 主要并行来源 | 时间上的重排 | 空间上的通道散布 |
四、一笔读请求的旅程:延迟构成对比
把上面三节收拢,跟踪一笔 64 字节读请求在两类控制器里的完整旅程,看延迟从哪来。
GDDR 路线:请求进控制器 → 按地址落到某颗颗粒的某个 16 位子通道队列 → 调度器在队列里等待重排窗口(攒同向批、找行命中)→ 发激活、等 tRCD → 发读命令、等 CL → 第一个 32 字节经高数据率引脚几纳秒内到达 → 第二个 32 字节紧随其后 → 合并成完整缓存行返回。高数据率让「线上时间」极短,但队列等待(为了批处理而主动引入的延迟)和总线换向是主要变量。空载下 GDDR 读延迟和高端 DDR 相当,重载下尾部延迟明显更差——这是重排调度的固有代价。
HBM 路线:请求进控制器 → 地址哈希确定伪通道 → 进该伪通道的小队列 → 调度相对简单(队列短、换向少)→ 激活加 CL 之后,64 字节一次突发走完 → 返回。线上时间比 GDDR 长一点(引脚慢),但队列行为温和、尾延迟更平。加上走线只有几毫米、无需复杂均衡,物理层往返也更短。综合下来,HBM 的负载下平均延迟与 P99 延迟通常都优于同代 GDDR 方案——这不是「HBM 颗粒更快」,而是「宽接口让控制器不用做激进重排」的直接红利。
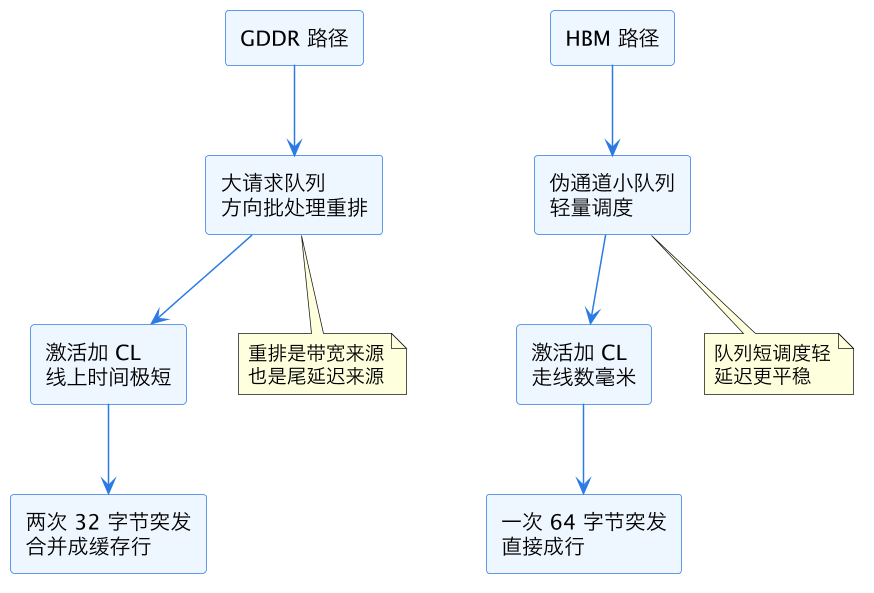
上图把两条路径并排,延迟差异的来源一目了然:GDDR 的延迟变量集中在队列(重排策略的代价),HBM 的延迟变量集中在 bank 冲突本身(伪通道多了之后,单个伪通道里的 bank 数量不变,高并发下同伪通道 bank 冲突仍是主要停顿源,只是被上百个伪通道的统计复用摊薄了)。
五、选型背后的控制器逻辑:什么负载配什么内存
最后落到工程选型。控制器差异决定了两种内存各自的「甜区」。
GDDR 的甜区是「带宽敏感但延迟容忍、访问模式可被重排利用」的负载:游戏渲染是典型——纹理流、帧缓冲都是大块顺序访问,请求重排几乎总能找到行命中和大批同向传输,高数据率引脚全程跑满,重排的尾延迟代价被流水掩盖。成本上 GDDR 用普通 PCB 封装,单比特成本低,消费级显卡别无选择。
HBM 的甜区是「极致带宽加可预测延迟、能效敏感」的负载:AI 训练推理(权重流加激活流并发、延迟直接影响流水线气泡)、HPC stencil 计算(多方向流并发,正好被多伪通道吸收)、以及任何「瓦特即金钱」的数据中心场景。能效差 3 到 4 倍这一点在千卡集群里是决定性的——内存子系统功耗可能占整卡三分之一,HBM 省下的功耗预算可以直接换成算力频率。
还有一条中间路线值得知道:部分数据中心 GPU 用「GDDR 加宽总线」(更多颗粒、更宽板级总线)压低每通道速率换取能效,本质是用 GDDR 的封装经济学逼近 HBM 的宽接口哲学——再次印证控制器结构是被物理接口形态决定的,而不是反过来。
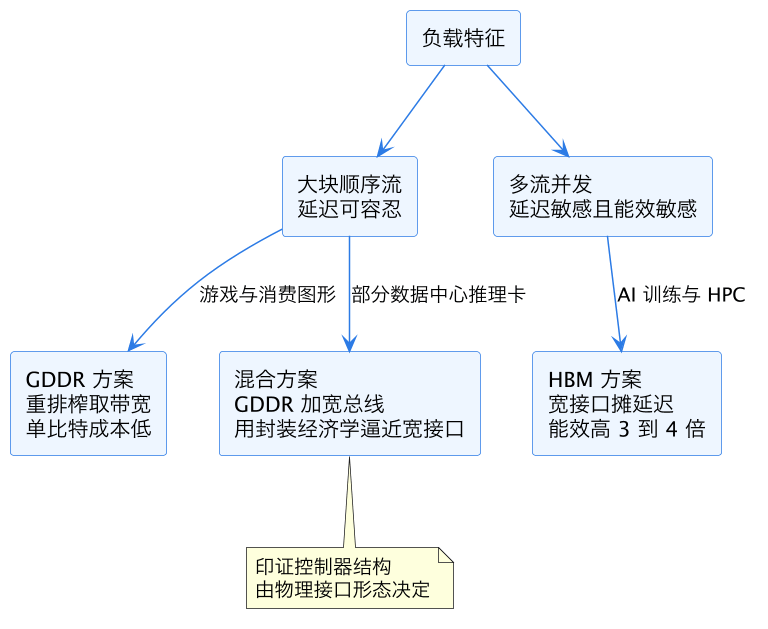
上图是选型决策的归约。它同时是全文论点的一句话版本:内存控制器不是独立设计的,它是接口物理形态(宽慢对窄快)在数字逻辑层的投影——理解了物理层的分工,调度粒度、突发策略、延迟特征全部可以推导出来。
这一篇在知识体系里的位置
本篇是微架构模块内存子系统线「高带宽内存专题」的控制器篇。上游基础是 DRAM 子系统组织(通道、rank、bank 的通用层次)、DRAM 控制器 FR-FCFS 调度(通用调度策略,本篇的「重排」与「方向批处理」是它的特化)、DRAM Bank 并行性与 Rank(伪通道并行的原理源头)。同线相邻的是 DRAM 行缓冲命中策略(行命中在两控制器里的不同权重)、内存通道交织(地址哈希的通用版)、DRAM 刷新管理(HBM 堆栈刷新的协同)。延迟分析的顶层方法论见 IPC 瓶颈分析 与 Top-Down 分析方法论,全景见 CPU 微架构总览。
总结
HBM 与 GDDR 控制器差异的根源是物理接口的两条相反路线:GDDR 用 32 位窄接口加 16 到 24 Gbps 超高引脚速率,控制器只有少数几个通道,必须在每个通道的大队列里做激进重排和读写方向批处理来喂饱高速引脚,代价是重载尾延迟;HBM 用 TSV 堆叠加硅中介层做出 1024 位超宽接口、单引脚只有 6 到 9 Gbps,接口被劈成每堆栈 16 个 64 位伪通道,控制器用地址哈希加每伪通道小队列的两级结构,靠上百个伪通道的空间并行而不是时间重排拿带宽,换来更平的延迟和 3 到 4 倍的能效优势——一句话,GDDR 控制器在时间里挤带宽,HBM 控制器在空间里摊带宽,选型时游戏渲染选前者、AI 与 HPC 选后者,看的正是这个分野。