树形伪 LRU:位树维护、命中翻转与牺牲路径选择,和真 LRU 的偏差到底有多大
更新时间:2026-10-02。缓存替换策略 LRU 及其变体 那篇把替换策略的家谱铺开讲过:真 LRU 精度最高但硬件代价随相联度爆炸,于是工程上出现了一整个「伪 LRU」家族,用少得多的状态位换「足够接近」的替换质量。这一篇把家族里最经典的一员——树形伪 LRU(tree-PLRU,也叫二叉树伪 LRU)单独拆透:一棵每层只有一个标志位的二叉树怎么编码「谁最久没用」,命中时翻哪几位、替换时怎么沿树走下潜,它和真 LRU 在哪些访问序列上会产生分歧,以及为什么从 PowerPC 到 Intel 的 L2/L3 都爱用它。它是缓存微架构里「用 7 个 bit 冒充 8 路全序信息」的教科书案例,和 MESI/MOESIF 一致性协议 一样属于「懂缓存的人必须能默写」的基础结构。
本文要回答的问题
- 真 LRU 在 8 路组相联上到底要存多少状态,为什么硬件吃不消?
- 树形伪 LRU 的位树是怎么布局的,每个 bit 表示什么含义?
- 命中一路时翻转哪些位,替换时怎么沿位走下潜选出牺牲路?
- 树形伪 LRU 和真 LRU 在哪些访问序列上会选不同的牺牲者,偏差有多大?
- 为什么它是「路数为 2 的幂」的缓存的标配,非 2 幂路数怎么办?
一、真 LRU 的代价:全序信息存不起
组相联缓存里,一个 set 有 W 路(way)。真 LRU 要求替换时精确回答「这 W 路里哪一路最久没被访问」——这等价于维护 W 路的一个全序(total order)。全序的信息量是多少?W 个元素有 W! 种排列,编码一个排列需要 log2(W!) 位。8 路就是 8! = 40320 种排列,需要约 15.3 位,取整 16 位。16 位听起来不多,但麻烦不在存储,在更新逻辑:每命中一次,要把「刚被访问的路提到最新、其余路顺次后移」,这是一个依赖当前完整排列状态的全局重排,译码成组合逻辑后级数深、面积大,而且必须在一个缓存访问周期内完成。
相联度还在涨。现代 L2 常见 8-16 路,L3 常见 12-16 路。16 路真 LRU 需要 log2(16!) 约 44.3 位,更新网络的复杂度随 W 超线性增长。更要命的是,缓存替换决策躺在命中路径的关键时序上——命中返回数据的同时就要完成 LRU 状态更新,为下一拍做准备,任何多余的逻辑级数都在直接吃掉频率。
树形伪 LRU 的出发点是一句话:放弃全序,只维护「足够区分最老候选」的部分信息。它用 W-1 个 bit——8 路只要 7 位,16 路只要 15 位——就给出了一个确定性牺牲者。存储从 log2(W!) 降到 W-1,更新从全局重排变成「翻转一条根到叶路径上的 log2(W) 个位」,逻辑浅到可以忽略。代价是:它选出的牺牲者不总是真正最老的那一路。这笔账划不划算,是后面三节要算的事。
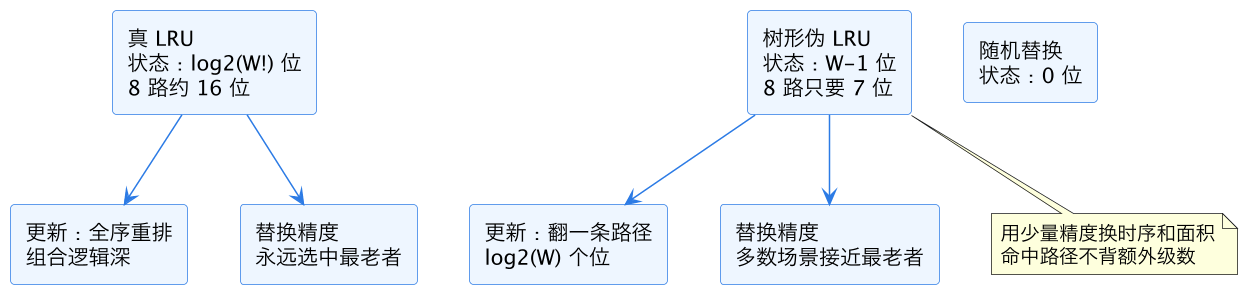
上图是三种策略在状态开销上的定位。树形伪 LRU 站在「真 LRU 的精度」和「随机替换的零开销」中间的甜点位:状态位数和路数线性相关(而不是阶乘相关),更新只动一条路径。它因此成为「想要比随机好、又不想付全序账单」场景下的默认答案。
二、位树布局:每个 bit 是一句「哪边更旧」
树形伪 LRU 把 W 路组织成一棵满二叉树的 W 个叶子(所以 W 必须是 2 的幂,8 路 = 3 层 7 个内部节点)。每个内部节点存 1 个标志位,总共 W-1 位。这个位的语义一句话说清:它指向自己两个子树里「更旧」的那一边。约定位为 0 表示「左子树更旧、替换往左走」,位为 1 表示「右子树更旧」。
于是整棵树就是一个分布式的「最老路指北针」:从根出发,每个节点用自己的位告诉你下一步往哪边走,走 log2(W) 步到达的叶子,就是当前的牺牲候选。不需要任何比较器网络,一次替换决策就是顺着 7 个位做 3 次查表。
以 8 路(way0 到 way7)为例:根节点 B0 管「左半(way0-3)和右半(way4-7)谁更旧」;第二层 B1 管 way0-1 对 way2-3,B2 管 way4-5 对 way6-7;第三层 B3/B4/B5/B6 各管一对兄弟路。7 个位、3 层、8 个叶子,刚好把 8 路组织成一个可下潜的结构。
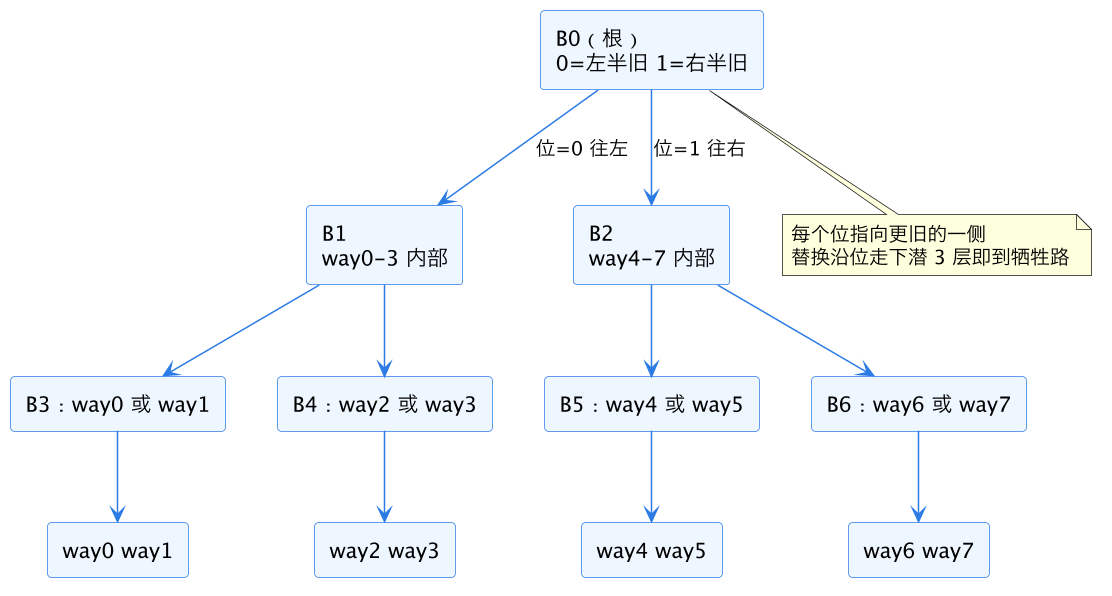
上图是 8 路位树的完整布局。注意一个容易误读的点:位的语义是「指向旧侧」,不是「指向新侧」——替换时顺着位走就是朝旧走;而命中更新时,要反着写,把路径上的位拨向「另一侧更旧」,等价于声明「我刚访问的这边是新的」。下一节把这个对称动作展开。
三、两个动作:命中翻路径、替换走下潜
树形伪 LRU 的全部机制就两个动作,都可以在一张表里背下来。
命中更新(access):命中第 k 路时,把从根到 way k 这条路径上经过的每个内部节点的位,写成「指向 way k 不在的那一侧」。也就是说,每经过一个节点,都告诉它「我刚摸了这边,这边现在是新的,旧的去对面找」。3 层树只翻 3 个位,互不依赖,一拍完成。效果等价于把 way k 推到「最新」位置——不是通过移动它,而是通过改写路径上所有「新旧判断」。
替换选择(victim selection):从根开始读位,位是 0 走左、是 1 走右,走到叶子就是要淘汰的路。把这个叶子换掉后,同样执行一次命中更新式的路径翻转(新填入的行现在是「最新」的)。
用一个具体序列感受一下。初始全 0 状态(位 0 = 左旧),此时替换会一路向左选中 way0。假设依次访问 way4、way2、way4:
- 访问 way4:路径 B0→B2→B5,三个位都拨向「way4 不在的一侧」:B0=0(右半是新的,旧在左)、B2=0(way4-5 这半是新的,旧在 way6-7)、B5=1(way4 是新的,旧在 way5)。
- 访问 way2:路径 B0→B1→B4。B0=1(左半刚被摸,旧在右半)、B1=1(way2-3 是新的,旧在 way0-1)、B4=1(way2 新,旧在 way3)。
- 再访问 way4:B0=0、B2=0、B5=1,回到第一步的状态。
三步之后,替换下潜路径是 B0=0(往左)→B1=1(往 way0-1)→B3=0(往 way0),牺牲者是 way0——这正好是真 LRU 也会选的路(way0 自始至终没被碰过)。多数日常序列上两者就是这么一致,分歧只在特定模式下出现,下一节专门拆。
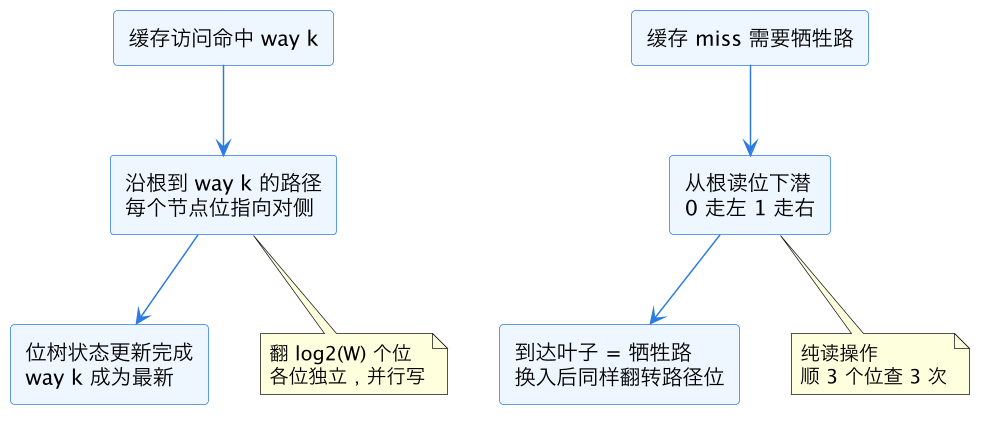
上图把两个动作并排画出来,对称性一目了然:替换是「顺着位读下去」,命中是「逆着语义写回去」。一个只读、一个只写,且不共享中间结果——这意味着两者在流水线里可以良好地并行,miss 处理里的下潜读不会和相邻命中路径的位翻转互相堵塞。这种「读写解耦」是它在时序上讨人喜欢的第二个原因(第一个是状态少)。
四、与真 LRU 的偏差:什么时候选错人
到这里关键问题来了:7 个位编码的信息量(2^7 = 128 种状态)远小于 8 路全序(40320 种),必然有些访问历史压缩进同一个位树状态,树形伪 LRU 无法区分它们,牺牲者就可能偏离真 LRU 的选择。偏差有两类典型场景。
第一类:兄弟子树内部的粒度损失。位树只回答「哪个子树更旧」,不保留子树内部的完整顺序。举个 4 路的例子:访问序列 way0、way1、way2、way3 各摸一次(此时真 LRU 顺序 way0 最老),然后再摸 way0。真 LRU 现在认为 way1 最老。树形伪 LRU 呢?摸 way0 会把 B0 拨向「右半旧」、把 B1 拨向「way1 旧」;此时下潜:B0 指向右半(way2-3),B2 位的状态取决于 way2/way3 那次访问——它拨向 way2 旧还是 way3 旧取决于最后一次碰这对兄弟的是谁。最后选中 way2 或 way3,而不是真 LRU 选的 way1。错了吗?way2/way3 也确实很旧(只被摸过一次,且在 way0 复用之前),所以这是「不完美但不离谱」的偏差:它可能淘汰第二旧或第三旧的,却很少淘汰刚用过的。
第二类,也是真正会咬人的:扫描序列(scan)下的退化。一个长度刚好等于 W+1 的循环扫描(比如 9 个行轮流映射进同一个 8 路 set),真 LRU 会每次淘汰「下一轮马上要用的」那一路——100% miss,这就是著名的 LRU 对扫描的病理行为。树形伪 LRU 在这种序列上同样全 miss,并没有更糟。但有些精心构造的短序列能让它表现反而比真 LRU 好,也有些让它略差——学术界用模拟测过大量 workload,经验结论是:在 SPEC 这类真实负载上,8 路组里树形伪 LRU 与真 LRU 的 miss 率差距通常在 1% 以内甚至测量噪声之下;相联度越高、工作集越接近组容量,差距会拉大,但到 16 路也普遍在可接受范围。
有意思的是「偏差何时为零」的一个充分条件:如果访问模式保证「同一子树内的路总是被一起复用」(局部性恰好按树的边界对齐),位树记录的部分信息就足以还原全序,此时 PLRU 与 LRU 完全等价。真实程序的局部性当然不会乖乖对齐树边界,但这个观察解释了为什么差距普遍很小——缓存局部性本身就意味着「最近用的集中在少数几路」,而位树恰好最擅长保护「最近被摸过的子树」。
| 维度 | 真 LRU | 树形伪 LRU | 随机替换 |
|---|---|---|---|
| 状态位数(8 路) | 约 16(log2(8!)) | 7 | 0 |
| 单次更新复杂度 | 全序重排,逻辑深 | 翻 3 个位,并行 | 无 |
| 牺牲者精度 | 永远最老 | 多数接近最老,少数偏差 | 无保证 |
| 扫描序列表现 | 100% miss(病理) | 同样退化 | 反而可能最好 |
| 路数限制 | 无 | 2 的幂(非 2 幂要裁剪) | 无 |
| 典型应用 | 低相联度、研究基准 | 工业 L2/L3 主流 | 高相联度 L3 补充 |
这张表把三者摆在一起,树形伪 LRU 的定位就很清楚了:它不是「更准的替换」,而是「按时序和面积预算买得起的、足够准的替换」。工程上评估替换策略从来不是比谁 miss 率最低,而是比谁在给定面积、给定时序预算下 miss 率最低——在这个口径下它赢了两代处理器。
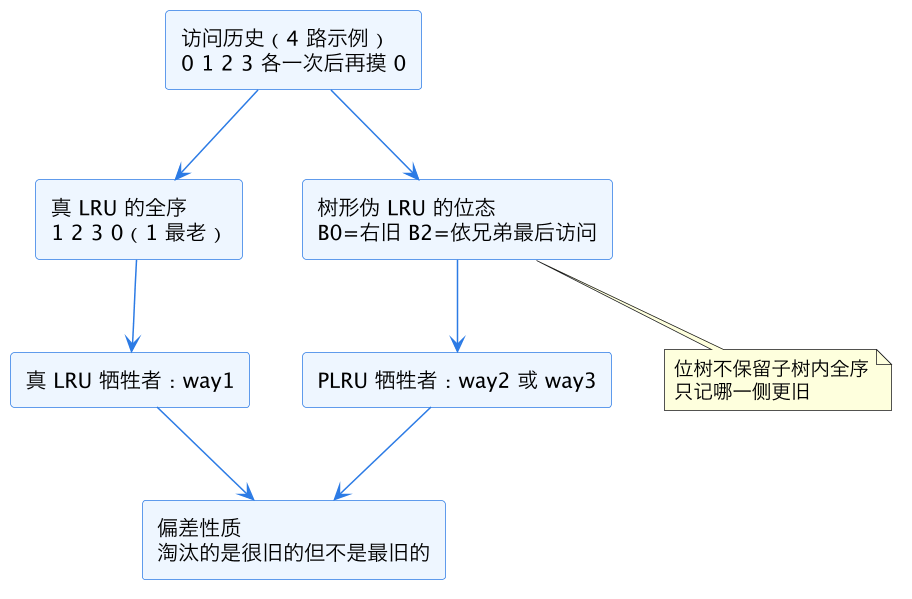
上图固定住偏差的核心机制:全序信息被压缩成「子树级的新旧判断」后,子树内部谁先谁后就丢了,替换只能在「更旧的子树」里按同样的规则递归找。偏差不会传播放大——选错的代价被限制在「淘汰了一个本来也快该淘汰的路」,这是它敢用 7 个位冒充 16 位的底气。
五、非 2 幂路数与工业变体
树形伪 LRU 有个结构上的硬约束:满二叉树要求路数是 2 的幂。可真实的缓存不总是 8 路、16 路——12 路的 L3 并不少见。怎么办?主流做法有两派。
一派是裁剪树:先按下一个 2 的幂(12 路就按 16 路)建树,再把不存在的叶子对应的子树永久标记为「旧」——即把通往空叶子的路径位硬连线成「优先淘汰那边」。空叶子永远先被选中,等于不存在,剩下的真叶子构成一个略不对称但可用的树。逻辑简单,代价是剩下的路之间的新旧记录略微偏斜。
另一派是拆组:把 12 路看成 3 个 4 路小组,组内用 4 路树形伪 LRU,组间再加一层小状态机。IBM 和 Intel 的一些多路 L3 设计走的就是这种「分层伪 LRU」路线。还有更激进的:高相联度 L3(如 16 路以上、多核共享)干脆放弃任何 LRU 近似,改用插入策略类的新方案(RRIP 家族,用 2 位预测代替排序),这是另一个故事了,家谱脉络见 缓存替换策略 LRU 及其变体。
工业应用上,树形伪 LRU 的履历很漂亮:PowerPC 604 时代的 4 路 L1 就是它;Intel 从 Pentium 家族到 Core 时代的多代 L2(8 路)用的都是树形伪 LRU 或其微调版;ARM 的不少 L2 设计文档里也能见到同样的位树结构。它真正让位给更新方案,是在共享 L3 面临「多核扫描型线程互相污染」这种新病理之后——但那已经超出单核缓存的传统假设了。
和替换策略打交道的相邻机制也值得串一下:换出的脏行要写回,写回缓冲的安排见 Victim Cache 与写缓冲;替换决策和预取器抢路的问题见 硬件预取器:步长与流;牺牲路里如果躺着未写回的脏数据,一致性侧的动作见 缓存写失效与写更新。替换从来不是孤立决策,它牵着写回、一致性和预取三条线。
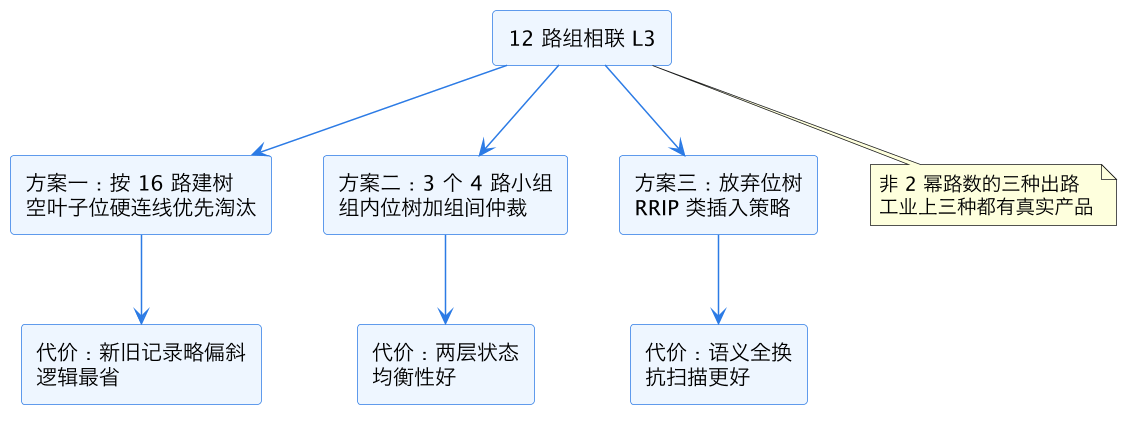
上图给出非 2 幂路数的三条工程出路。选哪条取决于定位:方案一 cheapest,适合面积敏感的中低相联度;方案二保留了较均衡的近似质量;方案三则是承认「LRU 这个抽象本身在共享大缓存上已经不灵」,换一套语义。理解树形伪 LRU 的价值,也在于理解它的适用边界在哪里。
这一篇在知识体系里的位置
本篇是缓存微架构线里「替换策略」专题的深水篇。上游框架文是 缓存替换策略 LRU 及其变体,那篇给出整个替换策略家谱和选型口径,本篇把家谱里工业应用最广的一支拆到晶体管视角。横向相邻的缓存结构话题:一致性问题见 MESI/MOESIF 一致性协议,写回与换出的缓冲安排见 Victim Cache 与写缓冲,L2/L3 的包含关系(它决定替换决策要不要跨级联动)见 缓存包含性:L2 与 L3。下游,替换状态位的多核干扰和划分见 缓存划分 CAT;整条微架构地图见 CPU 微架构总览。
总结
树形伪 LRU 把 W 路组相联缓存的替换信息压缩进一棵 W-1 位的满二叉树——每个内部节点的位指向「哪一侧子树更旧」,命中时逆着语义翻转根到叶路径上的 log2(W) 个位把刚访问的路标记为最新,替换时顺着位从根下潜 log2(W) 层直达牺牲路;它用线性级(而非阶乘级)的状态位和一拍能完成的浅逻辑,换来了与真 LRU 在真实负载上普遍 1% 以内的 miss 率差距,偏差来源是位树只记子树级新旧、丢了子树内全序,代价被限制在「淘汰很旧但非最旧的路」——这正是它成为几代工业处理器 L2/L3 默认替换策略的原因,也是理解 RRIP 等后继方案「为什么要换一套语义」的起点。