ARM SME 流式矩阵模式:ZA 存储、流式 SVE 与按需矩阵加速的编程模型全解
更新时间:2026-10-04。向量长度无关:ARM SVE 编程模型 那篇讲清了 SVE 如何用谓词寄存器和 whilelt 循环把「向量宽度」从软件里抹掉,同一份二进制跑遍 128 到 2048 位实现。但 SVE 解决的是「一维向量」的问题,矩阵乘这类二维访算一体的负载,SVE 仍要靠外层循环不断 load、外积、累加,向量寄存器数量成为天花板。ARM 在 2021 年公布的 SME(Scalable Matrix Extension,可伸缩矩阵扩展)是对这个天花板的回答:在 SVE2 的基础上引入一个全新的处理器模式——流式模式(Streaming Mode),以及一块与向量长度平方成正比的二维寄存器存储 ZA。它和 Intel 的 AMX(Advanced Matrix Extensions)几乎同时代出现,却走出了截然不同的设计路线,对比见 AMX 瓦片矩阵扩展。这一篇把 ARM SME 的编程模型拆到底:流式模式是什么、ZA 怎么读写、和 SVE2 是什么关系,以及它与 AMX 背后两种「矩阵加速哲学」的分歧。
本文要回答的问题
- ARM SME 为什么不直接在 SVE2 里加矩阵指令,而要单独发明一个「流式模式」?
- ZA 存储长什么样?它的容量和向量长度是什么关系,行列怎么访问?
- 流式模式切换的硬件语义是什么?进入和退出各有什么代价和约束?
- SME 的矩阵外积指令如何把两个向量变成一个 ZA 瓦片的更新?
- 同样做矩阵加速,SME 和 Intel AMX 在编程模型上的核心分歧在哪里?
一、为什么 SME 需要「流式模式」:矩阵加速的供电与状态难题
先看 SME 要解决的真问题。矩阵乘法(尤其是神经网络里的 GEMM,通用矩阵乘)的算术强度极高:每读一个字节的数据,可以做几十次乘加。要把这种负载跑满,需要数量远超传统向量的寄存器状态来持有累加器——一个 N×N 的浮点累加器块就是 N 平方个元素。对 SVE 那种最长 2048 位(256 字节)的向量来说,一个完整的 ZA 阵列在最大实现下是 256 字节乘 256 字节,也就是 64KB 的寄存器存储,比很多核的 L1 数据缓存还大。
64KB 的寄存器堆带来两个硬问题。第一是面积与功耗:它必须用独立的 SRAM 阵列实现,常驻供电会让所有不用矩阵指令的程序白白交电费。第二是上下文切换:进程切换时内核要保存恢复这块巨大状态,绝大多数进程根本不用它,纯粹浪费切换时间。
ARM 的解法是模式化:默认状态下 SME 硬件是关闭的,程序通过修改 PSTATE 里的两个位——SM(Streaming Mode)和 ZA——显式申请进入。进入流式模式后,SVE2 向量寄存器换用更长的「流式向量长度」(SVL),ZA 存储随 ZA 位置位而激活;退出或关闭 ZA 后,硬件可以整块断电,上下文切换也不用保存它。这是一个把「谁付电费谁申请」写进指令集的设计。
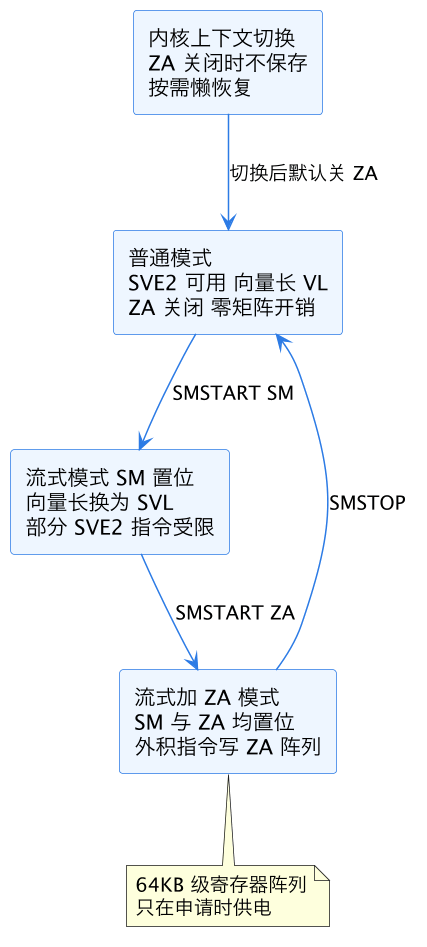
上图的三个状态是理解 SME 的钥匙。注意最下面那条从内核到普通模式的边:Linux 这类操作系统把 ZA 当成「懒保存」状态——进程不用 ZA,切换时那 64KB 就根本不读写,这与 AVX-512 时代「用没用都按最大状态保存」的做法形成鲜明对照,背后正是 CPU 微架构总览 里反复强调的「状态即成本」原则。
二、ZA 存储:一个按向量长度平方伸缩的二维阵列
ZA 是 SME 的核心创新。它不是一组新向量寄存器,而是一块二维的「寄存器存储阵列」:行数和列数都等于流式向量长度 SVL 换算出的字节数。SVL 为 128 位(16 字节)时 ZA 是 16×16 共 256 字节;SVL 顶格的 2048 位(256 字节)时 ZA 是 256×256 共 64KB。这个「平方关系」是刻意的:矩阵乘的算力随向量宽度线性增长时,累加器容量必须随平方增长才能维持算术强度,否则寄存器不够,数据还得频繁倒回内存。
ZA 的访问方式有三种视角,每一种对应一组指令:
- 外积写:矩阵指令(如
fmopa)不直接寻址 ZA 字节,而是把 ZA 看成一个逻辑瓦片,一条指令完成「两个输入向量的外积累加到整个瓦片」。 - 行与列访问:ZA 可以按水平行(slice)或垂直列读写,用普通的向量 load/store 把一行搬进 Z 寄存器或从内存直接灌入一列。
- 瓦片视图:64 位浮点数据下 ZA 被划分为若干逻辑瓦片(如 ZA0.d 到 ZA7.d),每条外积指令指定目标瓦片,多个瓦片可以并行承担多个独立的累加任务。
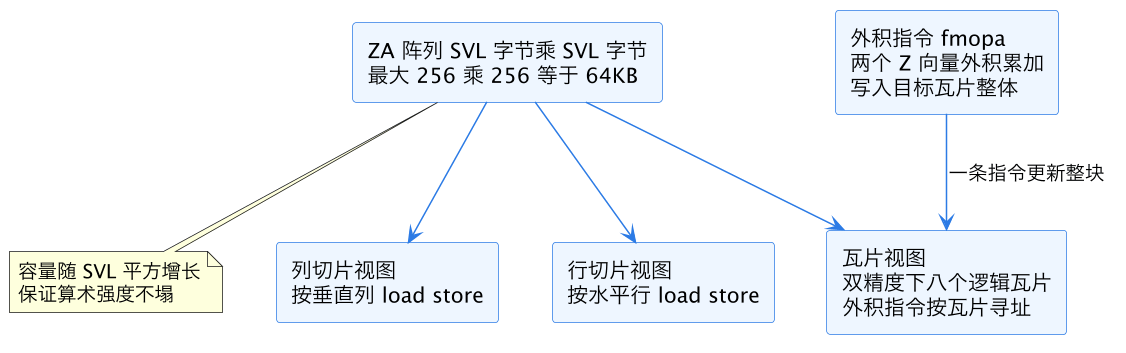
上图中「外积指令到瓦片」这条边是 SME 吞吐的来源:一条 fmopa 在传统向量机上等价于几十条 FMA 加寄存器重排。下面的指令对照表给出 SME 编程最常用的几组指令及其角色:
| 指令族 | 作用 | 备注 |
|---|---|---|
smstart / smstop | 进入退出流式模式或开关 ZA | 用户态即可执行,无需特权 |
fmopa / smopa / umopa | 浮点、有符号、无符号整数外积累加 | 核心计算指令 |
ld1b 等到 ZA | 内存直接灌入 ZA 行或列 | 支持按谓词掩码 |
st1b 等从 ZA | ZA 行或列写回内存 | 结果落地的标准路径 |
addha / addva | 对 ZA 行或列整体加向量 | 偏置累加类操作 |
zero | 清零一组 ZA 瓦片 | 每个 GEMM 内层循环开头 |
值得强调:行列 load/store 让 ZA 与内存之间的数据搬运完全走向量通路,不经过 Z 寄存器中转。这意味着内层循环可以「内存到 ZA、外积到 ZA、ZA 回内存」三步流水,Z 寄存器只负责喂外积的两个输入向量——这正是 SME 把寄存器压力从 Z 文件卸载到 ZA 的核心手法。
三、流式模式的切换语义与代价
流式模式不是免费的开关,切换有明确的硬件语义和软件纪律。
进入流式模式(smstart sm)后,向量长度从 VL 切换为 SVL,二者可以不同(很多实现上 SVL 等于 VL,但架构允许 SVL 是独立值)。Z 寄存器内容在切换时被架构定义为「不可依赖」——实现可以选择清零或保留,软件必须当作已丢失处理,进出流式模式前后要自行 save/restore 需要保留的向量。谓词寄存器同理。
退出时更大的坑在 ZA:smstop za 之后 ZA 内容架构上作废,硬件可以立刻断电。也就是说,计算结果必须在退出 ZA 模式前用行列 store 写回内存,否则白算。这与 AMX 的 tilerelease 语义几乎一致,都是「用完主动归还,不然代价自负」。
流式模式内还有指令白名单约束:SVE2 指令集的一个子集(主要是需要复杂跨车道重排的指令,如某些 permute 类)在流式模式下不可用,执行会触发异常。理由很实际——流式实现往往采用更「长而窄」的向量物理结构,跨车道连线被简化以换取面积和频率,换得的面积正是 ZA 阵列的预算。
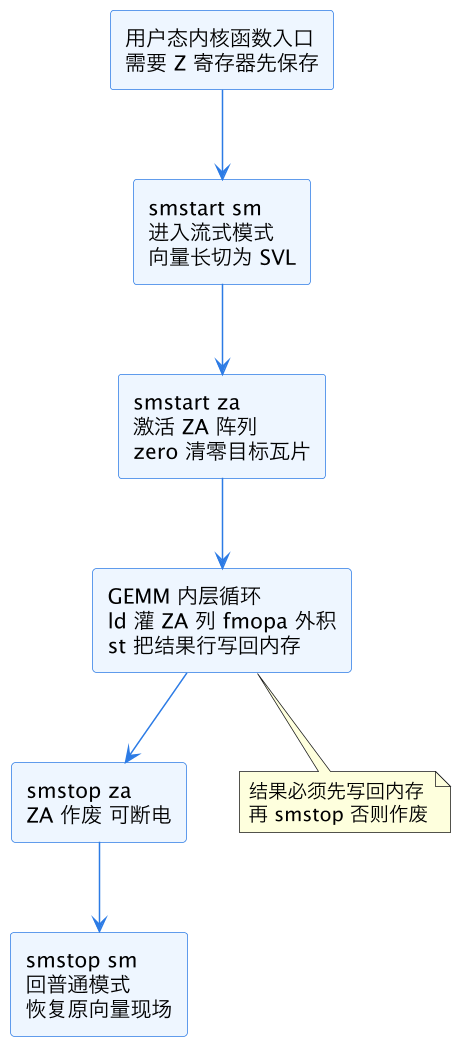
上图是一个 SME GEMM 函数的完整生命周期。关键点在于进出模式全在用户态完成、不需要系统调用,切换开销大约是几十到几百周期量级——比一次缺页便宜几个数量级,但也不便宜到可以逐指令切换。工程上的纪律是:以「整个矩阵 kernel」为粒度进出,绝不把 smstart 写进内层循环。
对操作系统,SME 引入了一个有趣的上下文切换优化:内核跟踪当前进程是否用过 ZA(通过陷阱或脏标记),没用过的进程切换时 ZA 完全不动。这和 perf 性能计数器编程 里讲的「按需使能计数器」是同一哲学——硬件资源默认休眠,谁用谁唤醒。
四、外积指令:一条 fmopa 干了多少活
SME 计算的核心是外积累加。给定两个向量:一个来自 A 矩阵的列向量(长度等于 SVL 车道数),一个来自 B 矩阵的行向量,fmopa za0.s, p0/m, p1/m, z0.s, z1.s 一条指令完成:对 ZA0 瓦片的每一个元素 za[i][j] += z0[i] * z1[j],也就是两个向量的外积整体累加进瓦片,两个谓词寄存器分别控制哪些行列参与。
以 SVL 等于 512 位(16 个 32 位车道)为例,这条单指令完成 16×16 共 256 次乘加。等价的 AVX-512 代码需要 16 条广播 FMA,且累加结果占满 16 个 ZMM 寄存器——寄存器文件瞬间被吃光。这就是 ZA 存在的意义:累加器不占向量寄存器,256 次乘加的结果落在独立的 64KB 阵列里,Z 寄存器只承担输入搬运。
一个完整的 FP32 GEMM 内层循环骨架长这样:
// K 维循环:每次取 A 的一列、B 的一行,外积累加
loop:
  ld1w  z0.s, p0/z, [a_ptr, k]   // A 的一列(K 步进)
  ld1w  z1.s, p1/z, [b_ptr, k]   // B 的一行
  fmopa za0.s, p0/m, p1/m, z0.s, z1.s
  add   k, k, #1
  whilelt p2.s, k, k_end
  b.first loop
// 循环结束后:把 ZA0 各行写回 C 矩阵
st1w  za0v.s[w12, #0], [c_ptr]
注意循环体里没有一条显式的乘法指令指向 Z 寄存器——所有算术都通过 fmopa 直接注入 ZA。多瓦片并行时,循环里可以并列两条 fmopa 分别写 ZA0 和 ZA1,承担两个独立的 C 子块,进一步摊薄 load 开销。
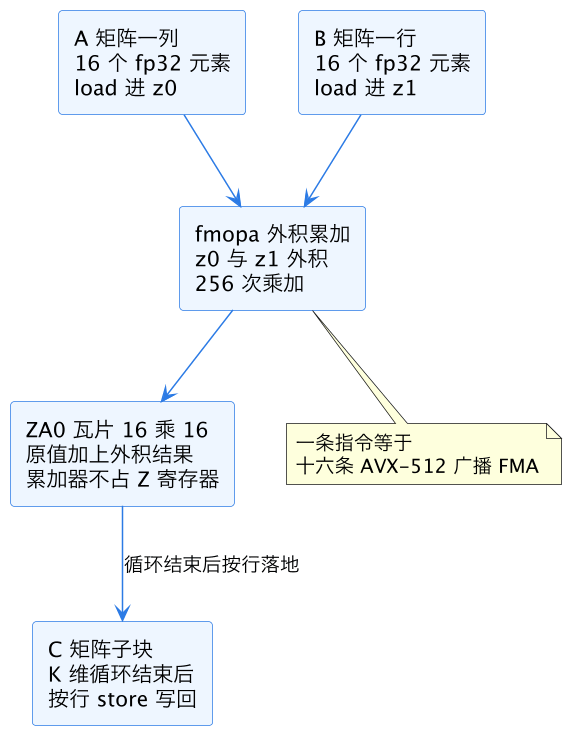
上图的数据流有一个容易忽略的方向性:A 的列和 B 的行分别从内存进 Z0、Z1,但累加器从头到尾不离开 ZA。对比传统向量 GEMM 每 K 步都要对 16 个累加寄存器做 FMA,SME 把「累加器流量」从寄存器文件的重命名、写回通路里整个抽走了,乱序引擎只需调度 load 和 fmopa 两类指令,发射压力骤降。这与 store buffer 与写合并 中「把写流量从关键路径挪走」的思路异曲同工。
五、SME 与 SVE2、AMX:三种设计哲学的对照
SME 与 SVE2 是叠加而非替代关系。SME 自己不含基础向量指令,流式模式下跑的就是 SVE2 指令(流式 SVE 子集);SVE2 的 VLA 模型被 SME 完整继承——fmopa 同样不编码位宽,同一份二进制在任何 SVL 实现上都正确。ARM 的路线是「一层一层往上叠,每层都保持长度无关」。
Intel AMX 的路线完全不同。AMX 定义了 8 个固定几何的瓦片寄存器(每个最大 16 行乘 64 字节,由 ldtilecfg 配置),tdpbf16ps 一条指令完成「一个瓦片乘一个瓦片累加进第三个瓦片」。瓦片形状是运行时配置的固定参数,而非实现相关参数——同一份 AMX 代码在所有 CPU 上看到同样的 16×64 瓦片几何,软件按固定瓦片形状做循环分块。
| 维度 | ARM SME | Intel AMX | SVE2(基线) |
|---|---|---|---|
| 累加器存储 | ZA 二维阵列,随 SVL 平方伸缩 | 8 个固定几何瓦片寄存器 | 复用 Z 向量寄存器 |
| 计算粒度 | 向量外积累加进瓦片 | 整块瓦片乘瓦片 | 逐车道 FMA |
| 位宽哲学 | 长度无关,同份二进制跨实现 | 固定瓦片形状,跨实现一致 | 长度无关 |
| 开关方式 | 用户态 smstart/smstop | 用户态 ldtilecfg/tilerelease,需 XFEATURE 授权 | 常开 |
| 上下文切换 | ZA 懒保存,不用不付 | 8KB 瓦片状态懒保存 | 向量状态常存 |
| 软件分块 | 按运行时查询的 SVL 分块 | 按固定 16 行瓦片分块 | whilelt 免分块 |
两条路线的分歧本质是「谁适应谁」。SME 让硬件把宽度藏起来,软件写一次到处跑,代价是编译器和程序员要在运行时查询 SVL 并据此分块,调优参数不能写死;AMX 让硬件暴露固定几何,软件循环结构简单确定、静态可分析,代价是未来想要更大瓦片只能等新指令集。二者都通过「显式开关加懒上下文切换」回避了大寄存器状态的常驻成本——这一点倒是殊途同归。
对性能工程师的实践含义:在 ARM 服务器(如 Neoverse V 系后续带 SME 的实现)上跑矩阵负载,先确认内核暴露了 SME(hwcap 中 HWCAP2_SME 位),再用运行时 cntw 类指令或 sysconf 拿到 SVL 做分块;代码结构照抄 SVE2 的 VLA 习惯,不要假设任何固定宽度。观测侧,SME 负载的瓶颈通常不在算力而在 ZA 与内存间的行列搬运带宽,PMU 里关注 load/store 端的 stall 计数即可,方法见 perf 性能计数器编程。
这一篇在知识体系里的位置
本篇是微架构模块「向量与矩阵计算线」的 ARM 矩阵专题。上游是 向量长度无关:ARM SVE 编程模型(VLA 模型与谓词机制,SME 的流式 SVE 子集建立其上)与 向量 SIMD 执行单元(向量硬件的车道化执行基础)。同线对照阅读是 AMX 瓦片矩阵扩展——同一时代 x86 阵营对矩阵加速的另一份答卷。观测手段见 perf 性能计数器编程,内存搬运侧背景见 store buffer 与写合并,全景地图见 CPU 微架构总览。
总结
ARM SME 用「流式模式」这个显式的处理器开关,把一块最大 64KB、随向量长度平方伸缩的二维 ZA 寄存器阵列引入 SVE2 世界:程序在用户态 smstart 申请进入,外积指令 fmopa 一条完成两个向量的外积累加并直接写进 ZA 瓦片,结果用行列 store 写回内存后 smstop 归还、硬件断电、内核上下文切换对不用 ZA 的进程零开销。与 Intel AMX 固定 16×64 瓦片几何的路线相比,SME 完整继承了 SVE 的长度无关哲学——同一份二进制在任何流式向量长度实现上正确运行,软件按运行时查询的 SVL 分块;两条路线在「硬件暴露几何还是隐藏宽度」上分道扬镳,却在「大寄存器状态必须显式开关加懒保存」上殊途同归,这正是矩阵加速从「特殊协处理器」走向「通用指令集一层」的共同代价与共识。