NUMA 本地与远端访存延迟:差距从哪来,first-touch 与 numactl 怎么把它管住
承 uncore-ring-mesh-interconnect——那一篇的延迟阶梯走到"远端插槽内存"就停住了:为什么跨过插槽边界,一次内存访问就平白多出 50%~100% 的延迟?这一步就是 NUMA(Non-Uniform Memory Access,非一致性内存访问)的世界。多插槽服务器上,内存物理上贴着某一颗 CPU,逻辑上却是全系统统一编址——"看得见"和"够得着"是两回事。NUMA 入门概念可以先看 numa,本篇专攻一个量化问题:本地与远端访问的延迟差到底从哪几个环节长出来,以及 Linux 的 first-touch 策略、numactl 工具和调度亲和怎么把这个差异变成你能利用的武器,而不是随机砸中你的坑。
本文要回答的问题
- NUMA 系统里"本地内存"和"远端内存"在硬件路径上差在哪几段?UPI 链路贵到什么程度?
- 远端访问除了链路本身,还有哪些隐性开销(目录协议、排队、SNC 配置)?
- Linux 的 first-touch(首次触碰)页分配策略到底在什么时候、按什么规则把页放到某个节点?
- numactl 的
--cpunodebind/--membind/--interleave/--preferred各自适合什么场景? - 绑了内存不绑核(或反过来)会发生什么?
numa_balancing自动迁移是帮手还是干扰?
一、NUMA 的硬件图景:两颗 CPU 各自抱着自己的内存
单插槽时代,所有核对所有内存的距离相等,"一次 DRAM 访问 60~90 ns"是个可以写进教科书的常数。双插槽服务器把这个假设打碎了:每颗 CPU(socket)集成自己的内存控制器,挂着本地的一排 DIMM;两颗 CPU 之间用 UPI(Ultra Path Interconnect,Intel 的插槽间一致性互连,前身叫 QPI)连起来。任何核都能访问任何地址,但访问本地控制器管理的内存走片内 Mesh 就到,访问对端的内存要额外穿一次 UPI 隧道。
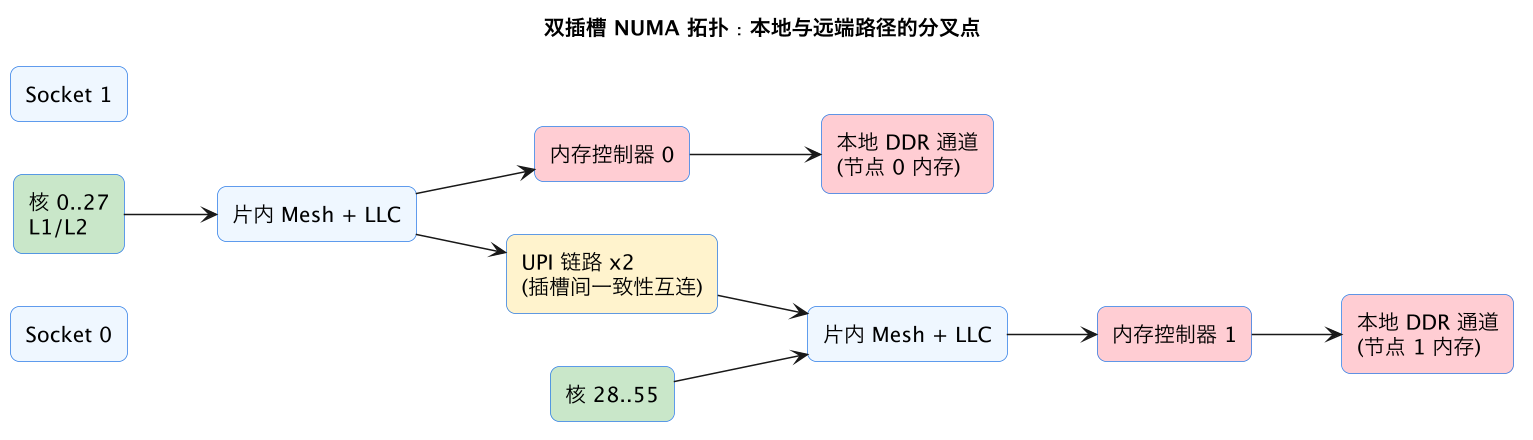
这张图里只有一处需要注意:两颗 socket 之间唯一的桥就是 UPI。Socket 0 的核要读节点 1 的内存,路径是"核 → 片内 Mesh → 本端 UPI 端口 → UPI 链路 → 对端 UPI 端口 → 对端 Mesh → 对端内存控制器 → 对端 DIMM",然后原路扛回数据。本地路径上的每一段片内跳数(Mesh 路由的细节见 uncore-ring-mesh-interconnect)在远端路径上全都要走,还要再叠加 UPI 这一段。
Linux 把每颗 socket 的"核 + 本地内存"抽象成一个 NUMA node(节点),lscpu 里能看到 NUMA node0 CPU(s): 0-27、NUMA node1 CPU(s): 28-55 这样的划分;numactl --hardware 则直接给出节点间的 node distances——一个相对延迟矩阵,本地通常是 10,跨节点常见 20~21,意思是远端访存代价约为本地的两倍。
二、延迟差的三层来源:链路、协议、排队
账面数字先给出来:典型双路 Xeon 服务器上,本地内存访问延迟约 75~90 ns,远端约 120~140 ns,差距 40~50 ns、比例 1.5~1.7 倍;四路、八路系统里跨两跳 UPI 的访问能冲到 200 ns 以上。这个差距不是单一环节造成的,它由三层叠加。
第一层是 UPI 链路本身的物理代价。 UPI 是串行高速链路,包要经过串化、传输、解串,两端还有协议层的流水级。单程几十纳秒就花在这里,往返翻倍。更要紧的是 UPI 的带宽远不如片内 Mesh——一颗 socket 的本地内存带宽可以上百 GB/s,而 2~3 条 UPI 加起来的有效带宽往往只有本地的一半到三分之二。延迟和带宽双重缩水,这是"远端惩罚"的主体。
第二层是一致性协议的升级。 片内 LLC miss 去本地内存,协议相对简单;跨 socket 的访问要引入**目录(directory)**机制——每个 socket 的本地内存配一份目录,记录哪些缓存行被对端 socket 缓存过、处于什么状态。一次远端读可能触发目录查询、跨 socket 的 snoop、甚至先让对端把脏行写回再取数。目录与 snoop 两种一致性形态的来龙去脉见 coherence-directory-vs-snoop。协议每多一次往返,延迟就再抬一截。
第三层是排队与拥塞。 这一层最容易被忽视,却是生产环境体感最差的部分——均值看着还行、尾巴爆炸的问题,多半就出在这第三层: UPI 端口是共享资源:远端读、远端写、跨 socket 的一致性流量、甚至对端 DMA 都可能挤在同一组链路上。负载轻时远端延迟接近下限,负载重时 UPI 队列变长,延迟尾巴急剧拉长——这也是远端访问方差远大于本地的原因。本地的排队规律(内存控制器怎么调度读写请求)见 dram-controller-frfcfs-scheduling,远端路径上这些排队一样不少,只是多排在 UPI 这道更窄的闸门上。
| 环节 | 本地访问 | 远端访问 | 代价增量 |
|---|---|---|---|
| 核到 LLC/Mesh | 有 | 有(两端各一次) | 多一段对端 Mesh |
| 内存控制器排队 | 有 | 有 | 相当 |
| DRAM 颗粒访问 | 约 40~50 ns | 约 40~50 ns | 相同 |
| UPI 串化/传输/解串 | 无 | 有 | 数十 ns 往返 |
| 目录查询与跨 socket snoop | 简单 | 复杂 | 依状态 0~数十 ns |
| UPI 端口拥塞 | 无 | 有 | 负载相关,尾延迟放大 |
| 典型总延迟 | 75~90 ns | 120~140 ns | 1.5~1.7 倍 |
把这张表和上一节的拓扑图叠起来看,结论很直白:NUMA 延迟差不是"内存变慢了",而是"路变长了、中间多了一道窄桥、桥上还会堵车"。DRAM 颗粒本身两端完全一样快。
代际差异也值得提一句:UPI 从 QPI 演进而来,速率从 QPI 的 6.4~9.6 GT/s 一路提到 UPI 2.0/3.0 的 10.4~16+ GT/s,链路条数也从双路标配 2 条涨到 3 条。所以"远端惩罚 1.5 倍"不是铁律——老平台(QPI、单链路)上惩罚可能逼近 2 倍,新平台上带宽项缓解明显,但延迟项的物理下限始终在:光速跨不过去,串化解串的流水级省不掉。给自己的平台做一次实测(用 numactl --membind 分别钉两端跑同一个延迟探针,或 Intel MLC 工具)比背任何数字都可靠。
还有一个配置级的变量值得知道:较新的 Xeon 支持 SNC(Sub-NUMA Clustering,子 NUMA 集群),把一颗 socket 内部再切成两个伪节点,让核优先走本侧的内存控制器。SNC 开启后 numactl --hardware 会显示 4 个节点,片内的"远端"惩罚变小,但调度与绑核的复杂度上升——socket 内外出现了两级 NUMA 距离。
三、first-touch:页落在哪个节点,由第一次写它的核决定
硬件把内存分成节点,但一个进程 malloc 出来的虚拟地址,物理页到底进节点 0 还是节点 1 的 DIMM?Linux 默认的答案是 first-touch(首次触碰)策略:虚拟地址分配时只建映射、不落物理页;第一次真正读写触发缺页异常的那一刻,由执行这次访问的 CPU 所在的节点分配物理页。
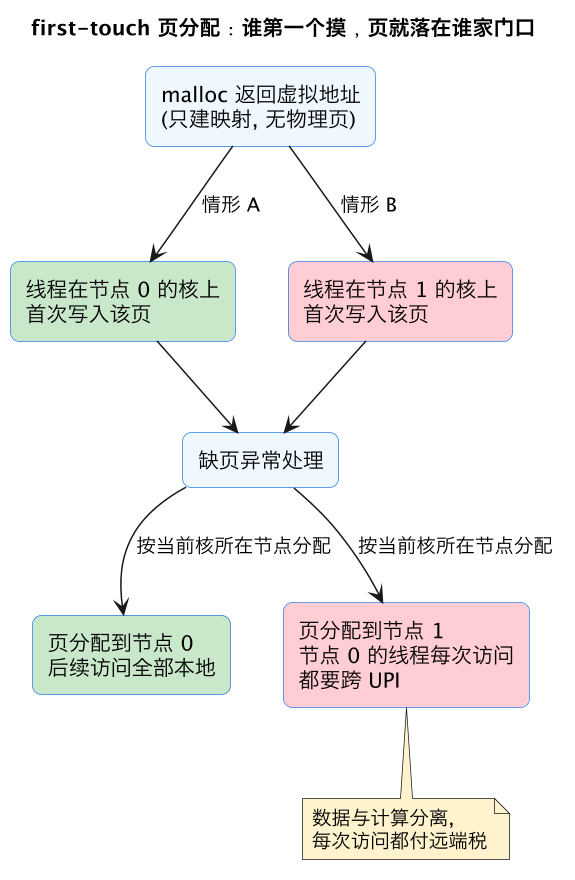
这条规则带来 NUMA 编程里最常见的翻车现场:主线程初始化了全部数据,再把计算分给 worker 线程。初始化阶段主线程跑在节点 0 上,所有页都落在节点 0;worker 线程被调度到节点 1 的核上开始干活,结果每一次数据访问都要跨 UPI——程序"自动"变成了全远端访问模式,性能比单线程还差。first-touch 的初衷是好的(让页贴近第一个使用它的核),但它把"数据放哪"的决定权悄悄交给了初始化代码的运行位置。
顺带一提,swap 和页回收也与节点有关:节点 0 内存紧张时,内核倾向回收节点 0 上的页(包括冷页换出),哪怕节点 1 还空着——zone_reclaim_mode 等参数控制这个倾向。这解释了为什么有的系统"总内存看着够用,却开始 swap":紧张的只是某个节点。
正确的姿势是让使用和初始化发生在同一个节点上:要么 worker 线程自己 first-touch 自己要用的那片数据(并行初始化,每个线程摸自己的分片),要么干脆用 numactl 显式规定内存策略,不跟缺页异常玩捉迷藏。
四、numactl 实战:四种策略各管什么
numactl 是 NUMA 策略的命令行入口,四种用法覆盖绝大多数场景:
# 1. 绑核绑内存:只在节点 0 的核上跑, 内存也只从节点 0 分配
numactl --cpunodebind=0 --membind=0 ./app

# 2. 只绑内存倾向, 不绑核
numactl --preferred=1 ./app

# 3. 内存按页轮流铺到两个节点 (交织)
numactl --interleave=0,1 ./app

# 4. 查看现状:每个节点的内存占用与命中率
numastat
四种策略的分工:
| 策略 | 语义 | 适用场景 | 主要风险 |
|---|---|---|---|
--cpunodebind=N --membind=N | 核和内存都钉死在节点 N | 延迟敏感、内存能装进单节点 | 节点内存耗尽直接 OOM,不降级 |
--preferred=N | 内存优先从 N 分配,满了可溢出到其他节点 | 想要本地性又要容错 | 溢出后部分访问变远端,性能不匀 |
--interleave=all | 页按 round-robin 铺到所有节点 | 带宽型应用、内存超单节点容量 | 每次访问 50% 概率远端,延迟摊平但不低 |
| 默认(不设置) | first-touch | 单节点应用、无所谓 | 初始化线程决定一切,容易翻车 |
选哪条的决策逻辑很朴素:进程内存小于单节点容量、又对延迟敏感 → cpunodebind 加 membind 钉死;内存必须跨节点、追求总带宽 → interleave 把远端访问均匀摊开;想要"尽量本地但别 OOM"的软约束 → preferred。 注意 membind 的硬语义:节点内存不够时宁可 OOM 也不去别的节点借,这在内存估算失误时是生产事故的常见来源。
五、绑内存必须绑核:调度亲和是另一半
只设 --membind 不设 --cpunodebind 是一个隐蔽的坑:内存乖乖落在节点 0,但 Linux 调度器照样可以把线程甩到节点 1 的核上——于是每次访问照旧跨 UPI,绑内存绑了个寂寞。NUMA 优化的完整动作永远是成对的:线程待在哪个节点,数据就放在哪个节点。
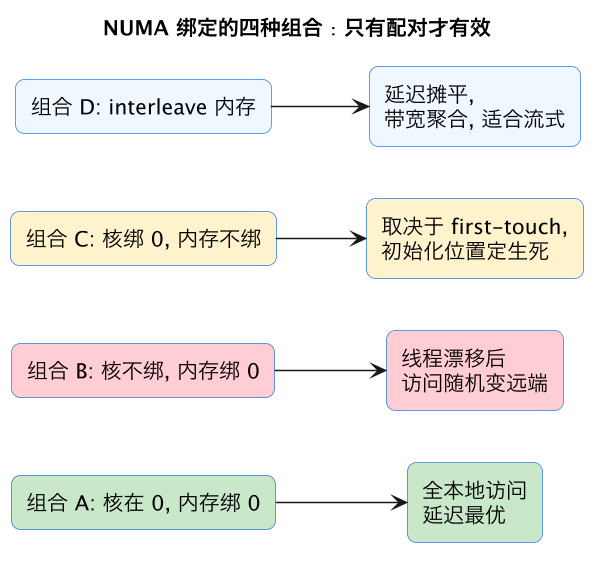
图中组合 B 就是"绑了个寂寞",组合 C 则把命运交回给 first-touch。容器环境还要多看一层:cgroup 的 cpuset 限定了可用 CPU,但不限制内存分配节点——容器里的进程即使被钉在节点 0 的核上,默认策略下页仍可能落到节点 1(取决于 first-touch 时实际运行的核,或者干脆继承宿主上残留策略)。跑 K8s 上的延迟敏感服务时,要么给 Pod 开 NUMA 亲和的静态 CPU 管理策略,要么在入口脚本里显式 numactl --membind,别假设 cgroup 帮你把这事办了。进程内还可以用 sched_setaffinity 把单个线程钉到具体 CPU(配合节点的 CPU 列表实现线程级绑核),多线程服务常见做法是把线程按节点分组、每组处理落在本节点的数据分片。
还有一个内核级的搅局者要知道:numa_balancing(自动 NUMA 均衡)。内核在后台统计各线程访问的页的节点分布,发现"线程在节点 0、页在节点 1"时会尝试迁移页或迁移线程来撮合它们。它对完全没做绑定的通用负载是净收益,但对已经手工绑好的延迟敏感应用,它带来的页迁移抖动(缺页、TLB shootdown、迁移期间的访问停顿)可能弊大于利。判断是否被它干扰的证据藏在 numastat-numa-balance 讲的 numa_pages_migrated、numa_pte_updates 这些计数器里;确认干扰后,sysctl kernel.numa_balancing=0 一键关掉,换回确定性。
验证优化效果的闭环也很简单:numactl --hardware 看拓扑 → 按策略启动 → 跑负载时看 numastat 的 numa_hit(在本节点命中分配)与 numa_miss(本该在别的节点却分到本节点,或反之)比例 → 再用 numastat 和 perf 的 node-loads / node-stores 事件确认远端流量确实下降。延迟敏感服务做这一步,P99 常有肉眼可见的改善——因为远端访问不只是均值高,它的尾延迟(UPI 拥塞那一段)才是 P99 的真正推手。
把「翻车现场」和「配对绑定」两种结局并排摆一张卡,能直观看到 first-touch 不加干预时本地/远端占比是怎么翻转的:
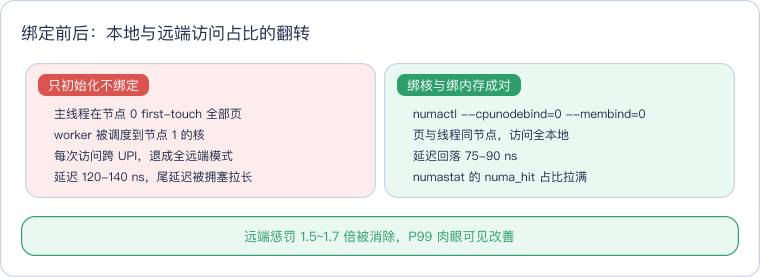
这张卡要传达的不是「绑了就快」这句废话,而是占比的结构性翻转:不绑定时 first-touch 把决定权交给了初始化线程,访问近乎 100% 远端;成对绑定后同一份数据访问近乎 100% 本地——中间没有渐进地带,这正是 NUMA 问题「要么全对要么全错」的特性。
这一篇在知识体系里的位置
本篇把微架构的延迟阶梯从"片内"补全到"跨插槽",与下列文章互相支撑:
- numa:NUMA 的入门概念与节点抽象,本篇是它的延迟机制深挖。
- uncore-ring-mesh-interconnect:片内互连骨架决定本地延迟的形状,本篇的 UPI 是骨架向片外的延伸。
- coherence-directory-vs-snoop:远端访问延迟差的协议层来源。
- dram-controller-frfcfs-scheduling:两端内存控制器共用的排队调度规律。
- 工具侧落地:numactl、numastat、numastat-numa-balance。
总结
NUMA 本地与远端访存延迟的差距由三层叠加而成——UPI 跨 socket 链路的物理代价、目录一致性协议的额外往返、UPI 端口排队放大的尾延迟,典型比例 1.5~1.7 倍;Linux 用 first-touch 策略按"第一个触碰页的核所在节点"分配物理页,所以初始化代码的运行位置悄悄决定了数据的落点;管住它的完整动作是 numactl 的绑核与绑内存成对使用(内存小于单节点用 membind 钉死、跨节点带宽型用 interleave 摊平),并在确认干扰后关掉 numa_balancing 换回确定性——NUMA 优化的本质就一句话:让线程和数据待在同一个节点,一次都不跨那座桥。