侦听过滤器:多核一致性探测的减带宽结构,snoop filter 如何滤掉九成无效侦听
更新时间:2026-10-04。多核系统里,每个核的私有缓存(L1/L2)都可能藏着同一份数据的副本,靠 MESI 一类协议维持一致,协议背景见 缓存一致性协议 MESI 与 MOESI。问题来了:当核 0 想写一行数据时,它必须确认「别的核手里有没有这行的副本」,这个确认动作叫一致性探测(snoop,侦听)。最笨的办法是广播——把探测发给所有核的缓存控制器,每个核都查一遍自己的 tag。核数一多,广播流量和每个核被打断查 tag 的次数都会失控。侦听过滤器(snoop filter)就是为此而生的减带宽结构:它在 LLC(Last Level Cache,末级缓存)旁边放一份「谁可能持有哪些行」的摘要,探测先到过滤器,过滤器说「这行只有核 3 可能有」,探测就只发给核 3;过滤器说「谁都没有」,探测直接终结,一个核都不打扰。本篇上承 目录式与侦听式一致性 的路线之争,旁接 L2 L3 缓存包含关系——snoop filter 和 inclusive LLC 是一对共生设计,拆开任何一边,另一边的效果都会打折。
本文要回答的问题
- 广播式侦听为什么在多核下不可持续?带宽账怎么算?
- 侦听过滤器到底记了什么?它和 LLC 的 tag 是什么关系?
- 为什么说 snoop filter 与 inclusive LLC 是共生结构?换成 non-inclusive 会怎样?
- 过滤器容量失效(capacity miss)会发生什么?为什么会造成「探测风暴」反噬?
- snoop filter 和全目录(directory)方案的分界线在哪里?什么规模该换路线?
一、广播的代价:一致性流量为什么会爆炸
先建立一个直观模型。8 核 CPU,每个核有自己的 L1 和 L2,共享一个 LLC。核 0 的一次 L2 未命中触发一次一致性事务:要么这行只在内存/LLC 里(谁都没缓存),要么在某个核的私有缓存里是脏的(得从那里取回来)。在不设过滤器的纯侦听式协议里,LLC 控制器无法区分这两种情况,只能把探测广播给其余 7 个核,每个核用自己的 L1/L2 tag 阵列查一遍,回报「没有/有共享副本/有脏副本」。
这笔账有三个昂贵的部分。第一是互连带宽:每个一致性事务都要在环网或 mesh 上跑 N-1 份探测消息,核数翻倍,流量近似翻倍。第二是 tag 阵列的端口争用:私有缓存的 tag 是稀缺资源,本核的 load/store 每个周期都在查它,外来探测每来一次就抢一次端口,本核访存被顶到后面排队。第三是功耗:一次广播意味着 7 个核的 tag 阵列都被激活读一遍,其中绝大多数查出来是「没有」——纯浪费。
关键在于第三个事实:绝大多数探测本来就是无效的。服务器负载里,一个缓存行被多个核同时持有的比例并不高——线程私有数据、只读代码段、绝大多数堆内存都只属于一个核。实测和学术论文的共识是:广播出去的探测里 80% 到 95% 在所有核上都查不到副本。也就是说,广播方案把 90% 左右的带宽和功耗花在了「确认一件不存在的事」上。这正是侦听过滤器要消灭的部分。
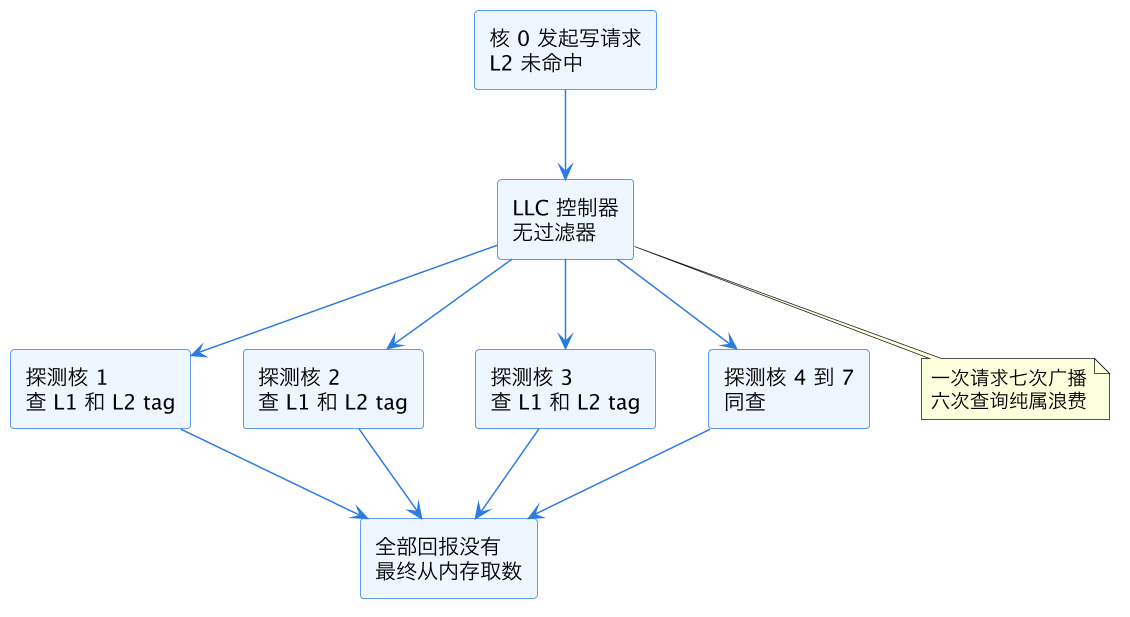
上图里 7 次探测全部落空是典型的私有数据访问场景。核数越多这张图越难看:32 核时同样一次访问要发 31 份探测。互连拓扑(环形还是 mesh)只影响这些消息在路上怎么绕,改变不了「份数」本身,拓扑背景见 ring 与 mesh 互连。要压份数,必须在源头加一份「谁可能持有」的备忘录——这就是过滤器。
二、侦听过滤器的结构:一张「存在性摘要」表
侦听过滤器在物理上是一块小型 SRAM 表,坐在 LLC 控制器旁边,按组相联组织,用地址索引。每一项回答的问题是:「这个地址(或这片地址)的行,可能出现在哪些核的私有缓存里?」实现上主要有两种粒度。
第一种是精确向量式:每个表项存一个地址 tag 加一个核位图(presence vector,存在向量),位图第 i 位为 1 表示核 i 可能持有该行。命中且位图为 0,说明这行只在 LLC/内存里,探测零广播;命中且位图只有第 3 位为 1,探测只发核 3。这种方案精度最高,但表项数和「可能被缓存的行数」同量级,SRAM 开销大。
第二种是稀疏摘要式:不逐行记录,而是用类似 Bloom filter 的哈希摘要记录「哪些行出现过」。IBM Power 系列用过的 JETTY 结构、AMD 用的 probe filter 都属于这个家族——查的时候可能假阳性(过滤器说「可能有」,实际没有,多发几份探测),但绝不假阴性(说「没有」时一定没有,一致性不会错)。假阳性只损失一点带宽,假阴性损失的是正确性,所以摘要式设计宁可误报。
| 维度 | 精确向量式 | 稀疏摘要式 |
|---|---|---|
| 记录粒度 | 每个缓存行一项 | 哈希到桶,多行共桶 |
| 假阳性 | 无 | 有,多过滤不掉 |
| 假阴性 | 无 | 无(正确性底线) |
| SRAM 开销 | 高,与私有缓存容量成正比 | 低,可做得比私有缓存小得多 |
| 典型代表 | 研究原型、部分 ARM 实现 | AMD probe filter、IBM JETTY |
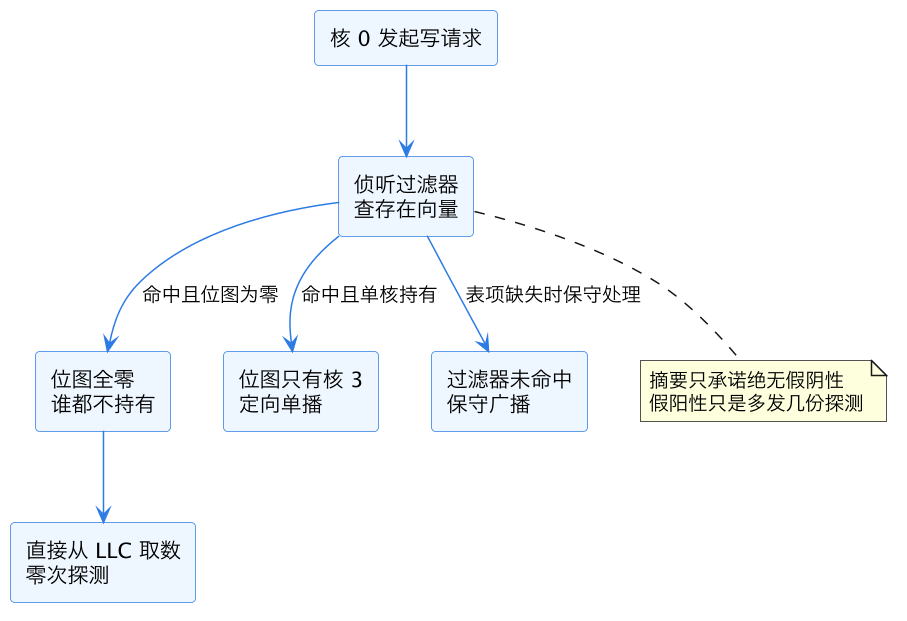
上图的三条出边就是过滤器对每一次一致性事务的裁决。注意「表项缺失时保守广播」这条退路:过滤器是性能结构不是正确性结构,它查不到时必须退化为广播,绝不能猜。这条退路的存在意味着过滤器容量一旦不够,系统会悄无声息地滑回广播模式——这是第四节的主题。
三、与 inclusive LLC 的共生:为什么 Intel 的过滤器几乎免费
侦听过滤器和 LLC 的包含策略之间有一层深刻的耦合,理解这层耦合才算真正理解 snoop filter。
inclusive(包含式)LLC 的定义是:任何存在于某个核 L1/L2 里的行,必然也在 LLC 里有一份,包含关系的完整讨论见 L2 L3 缓存包含关系。这条不变式带来一个免费礼物:LLC 的 tag 阵列本身就是一张精确的存在性表。想过滤探测,只需给 LLC 每项加几个状态位,记录「这行被哪个核持有」——这就是 Intel 从 Nehalem 到 Skylake-SP 之前一直用的方案:LLC 每行带 core valid bits(核有效位),查 LLC tag 时顺手就知道探测要不要发、发给谁。LLC 查不到这行,等于所有私有缓存都没有这行,探测直接终结。过滤器与 LLC 共用 tag 阵列,增量成本只有每行几个比特。
到了 Skylake-SP 及之后的服务器核,Intel 把 LLC 改成了 non-inclusive(不保证包含,私有缓存驱逐的行 LLC 可能同步踢掉),免费礼物没了,只好在 LLC 之外单独建一张 snoop filter——这张独立过滤器必须覆盖所有核 L1+L2 的总容量,才能承诺「查不到即没有」。这也是为什么 Skylake-SP 之后 Intel 服务器的一致性实现里出现了一个叫 SF(snoop filter)的独立 uncore 部件,配合 mesh 上的 CHA(Caching and Home Agent)工作,mesh 与服务器 SKU 差异见 服务器与桌面 SKU 的 mesh 差异。
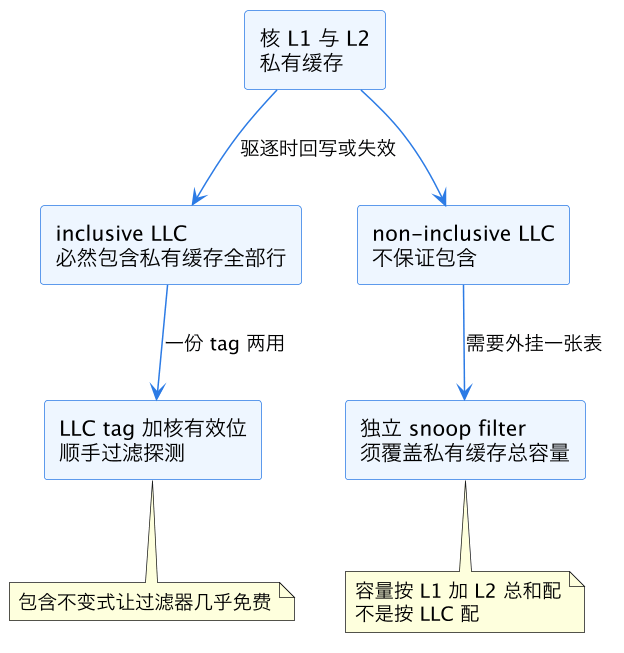
上图把两条路线的成本结构摆在一起。左边是「一份 tag 两用」的便宜方案,代价是 inclusive LLC 本身要忍受重复存储;右边 LLC 省了重复存储,代价是多一张独立的、容量必须看齐所有私有缓存的过滤器。两条路没有绝对优劣,是「SRAM 花在哪」的预算分配问题。
四、容量失效的反噬:过滤器不够大时的探测风暴
snoop filter 最隐蔽的坑是容量。过滤器要承诺「查不到即没有」,它的有效容量就必须大于等于所有私有缓存可能持有的行数。一旦出现以下任一情况,这个承诺就守不住:
- 工作集超过过滤器容量:大量不同地址挤进来,老表项被驱逐。被驱逐不等于数据从私有缓存里消失——核的 L1 里可能还好好存着那行——过滤器被迫把这些地址标记为「不确定」,之后的探测全部退化为广播。
- 组冲突:组相联结构下,某些索引组被热点地址挤爆,即使总容量还有富余,那一组也在疯狂驱逐。
- 摘要式结构的哈希饱和:Bloom 类结构里 1 的比例升高,假阳性率飙升,定向单播退化成事实广播。
反噬的可怕之处在于它是悬崖式的。过滤器工作时,系统一致性流量很低、IPC 很稳;工作集一旦越过容量拐点,广播突然全开,互连带宽和 tag 端口争用同时恶化,IPC 出现与「缓存容量」无关的莫名下跌——工程师按常规思路查 L2/LLC 命中率会发现一切正常,因为问题不在数据缓存,而在那张看不见的过滤表。
观测上怎么抓?Intel 服务器的 uncore PMU 里有针对 CHA/SF 的事件族(如 SF 驱逐、目录查询miss 等计数),配合核心侧的 MEM_LOAD_L3_MISS 类事件对比,可以在「核心侧未命中率没变但 uncore 侧一致性事务暴增」的剪刀差里定位它。PMU 的用法背景见 PMU 性能计数器编程,uncore 自身频率也会影响过滤器和互连的吞吐,见 uncore 频率调节。
缓解手段分软硬两边。硬件侧是加大过滤器、提高相联度、用更聪明的驱逐策略(优先驱逐「位图全零」的表项)。软件侧的思路和对抗缓存冲突一脉相承:减少多核活跃工作集的总容量、用大页摊薄地址跨度、把线程私有数据按核聚簇而不是交错排布——线程绑核和内存本地化的价值在这里又多了一层理由,跨插槽视角见 NUMA 本地与远端访问延迟。
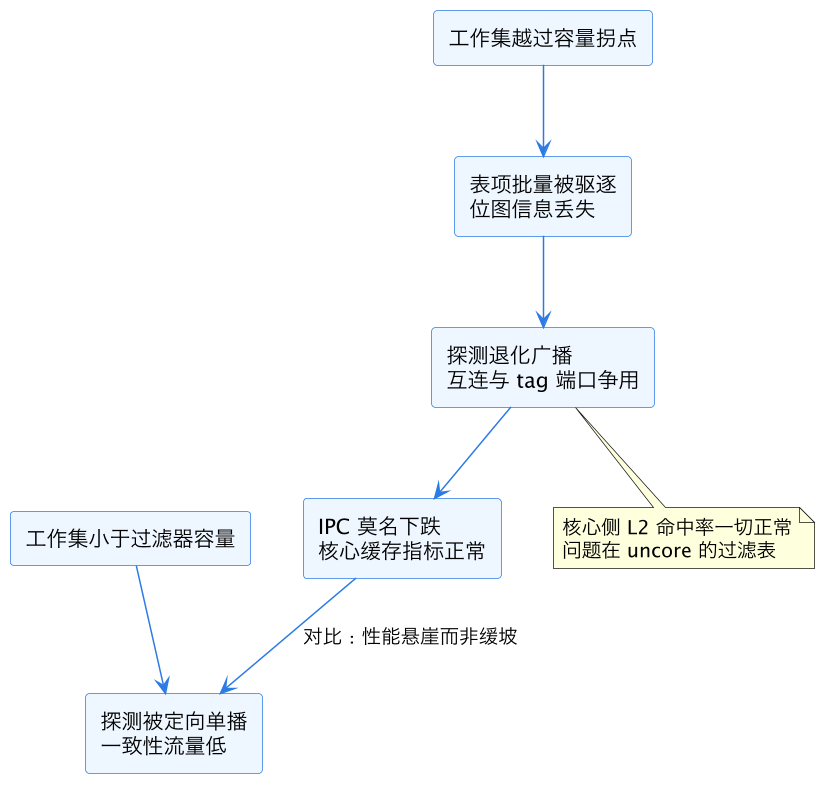
上图刻意画成一条「悬崖」:左边和右边之间没有渐变区。这是 snoop filter 问题区别于普通缓存容量问题的诊断特征——缓存容量不足是渐进恶化,过滤器失效是开关式跳变,监控曲线上表现为一夜之间的一致性事务数翻倍。
五、与全目录的分界:核数决定路线
snoop filter 的本质是「用一张小表逼近全目录的效果」。它和全目录方案的分界线在核数,路线总览见 目录式与侦听式一致性。
过滤器的逻辑前提是:广播只是偶发的保底手段,绝大多数探测被表挡下。核数从 8 涨到 64 再涨到几百时,两个趋势同时挤压这个前提。其一,过滤器的容量要随「所有核私有缓存总和」线性增长,而私有缓存总和随核数线性增长,过滤器本身会变成一块可观的 SRAM。其二,即使过滤器完美工作,共享度稍高的负载下「定向发给 k 个核」的 k 也在涨,一致性事务的绝对份数依然膨胀。
于是大规模系统走另一条路:干脆给每行数据在 LLC(或主存代理)里维护完整目录项,记录精确共享者列表,这就是目录式。AMD EPYC 的每个 CCD 内用 probe filter(本质还是 snoop filter),跨 CCD 和跨插槽则由 Infinity Fabric 上的主存目录接管;多 die 封装下的这种分层做法见 chiplet 多 die 一致性。Intel 至强可扩展系列从 Skylake-SP 起也是「核间 snoop filter 加 LLC 目录位」的混合体,LLC 切片寻址的分散方式见 LLC slice 哈希寻址。
| 规模 | 主流结构 | 理由 |
|---|---|---|
| 4 到 16 核单 die | snoop filter(或 LLC 核有效位) | 广播保底代价可接受,过滤器便宜 |
| 16 到 64 核 mesh | snoop filter 加目录位混合 | 过滤器挡大部分,目录管共享热点 |
| 多 die 多插槽 | 全目录为主 | 跨 die 延迟太高,广播保底已不可承受 |
一句话给选型划线:只要「广播一次」的代价还低于「维护全目录」的常年开销,snoop filter 就赢;核数和共享度把这条不等式翻转过来时,就该目录上场了。
这一篇在知识体系里的位置
本篇是微架构模块「缓存一致性线」的中间篇。上游基础是 缓存一致性协议 MESI 与 MOESI(状态机本身)与 目录式与侦听式一致性(两条路线之争),本篇讲的是侦听路线上最重要的工程补丁。与它互为表里的是 L2 L3 缓存包含关系——inclusive LLC 与 snoop filter 的共生是全文的主轴之一。同线相邻的 缓存一致性写失效与写更新 讨论协议动作本身,chiplet 多 die 一致性 讲过滤器和目录在多 die 下的分层。观测侧靠 PMU 性能计数器编程,互连底座的 ring 与 mesh 互连 和 uncore 频率调节 决定了一致性流量的吞吐上限。全景地图见 CPU 微架构总览。
总结
侦听过滤器(snoop filter)是坐在 LLC 旁边的一张「谁可能持有哪些缓存行」的存在性摘要表,它把一致性探测从「广播给所有核查 tag」压缩成「定向发给可能持有的核」,挡掉了占总量八九成的无效探测;inclusive LLC 时代它几乎免费——LLC tag 加几个核有效位就是过滤器,LLC 改成 non-inclusive 后则必须外挂一张容量看齐所有核私有缓存总和的独立表,而这张表一旦被工作集挤爆,探测会开关式地退回广播模式,造成核心缓存指标完全正常、IPC 却断崖下跌的隐蔽性能事故;当核数涨到几十上百、跨 die 广播保底的代价超过常年维护目录的开销时,snoop filter 就让位给全目录方案,这正是现代服务器 CPU「核内过滤器加全局目录」混合架构的由来。