cache bank 冲突:L1 数据缓存多 bank 组织与同周期多访问撞 bank 的停顿机制与规避
更新时间:2026-10-03。LSU 载入存储单元 那篇讲了现代核每周期能同时发两三个 load 加一个 store 的「标称带宽」,但那只是发射侧的能力——数据缓存本身能不能一个周期真的服务这么多访问,取决于另一个不太起眼的结构:L1 数据缓存内部被切成了若干个 bank,每个 bank 一周期只能响应一次访问。两条访存指令如果地址落在同一个 bank 的不同 cache line 上,即使数据全命中,也只能一前一后串行服务,后到的那个被推迟一拍,这就是 cache bank 冲突。它是 IPC 瓶颈 里最隐蔽的一类:perf 里看不到 cache miss,看不到端口饱和,只有 LSU 的 cycle 数悄悄变大。这一篇把 bank 的切法、冲突判定、停顿机制和软件规避手法一次讲清,背景衔接 CPU 微架构总览。
本文要回答的问题
- L1 数据缓存为什么不做成一个真正的多端口存储体,而要切成多个 bank?
- 地址的哪几位决定一次访问落到哪个 bank?为什么是这几位而不是高位?
- 同周期两个访问撞同一个 bank 时,硬件怎么判冲突、怎么推迟、推迟多久?
- bank 冲突和 cache miss、执行端口竞争在性能计数器上怎么区分?
- 软件层面(数据布局、循环结构、访存顺序)有哪些可操作的规避手段?
一、为什么切 bank:多端口 SRAM 的面积灾难
先建立物理直觉。L1 数据缓存本质上是一块 SRAM。一块「单端口」SRAM 一周期只能做一次读或一次写;而现代高性能核的 LSU 标称能力是每周期 2 个 load 加 1 个 store,也就是 L1D 每周期至少要支撑 2 到 3 次访问。
最直接的解法是做一个真正的多端口 SRAM:每个存储单元(bit cell)里给每个读端口、写端口各拉一套字线和位线。问题在于代价——SRAM 单元面积随端口数近似平方增长,一个 6T 单端口单元做成 2 读 1 写三端口,单元要涨到十几二十个晶体管,位线电容和译码功耗同步暴涨,还会直接拖慢访问延迟。L1 的延迟预算是 4 到 5 个周期,多端口方案会把延迟和功耗一起顶破预算。
工程上的折中就是切 bank:把数据缓存按地址切成 B 块独立的单端口小 SRAM(B 常见取值 4、8、16),每块自带一套译码和读写电路。只要同一周期的几次访问落在不同的 bank,它们就能真并行;落在同一 bank 的就只能排队。这把「全局多端口」问题变成了「大概率并行、小概率冲突」的问题——用很少的硬件换到接近多端口的效果,代价就是引入了 bank 冲突这种新的停顿源。
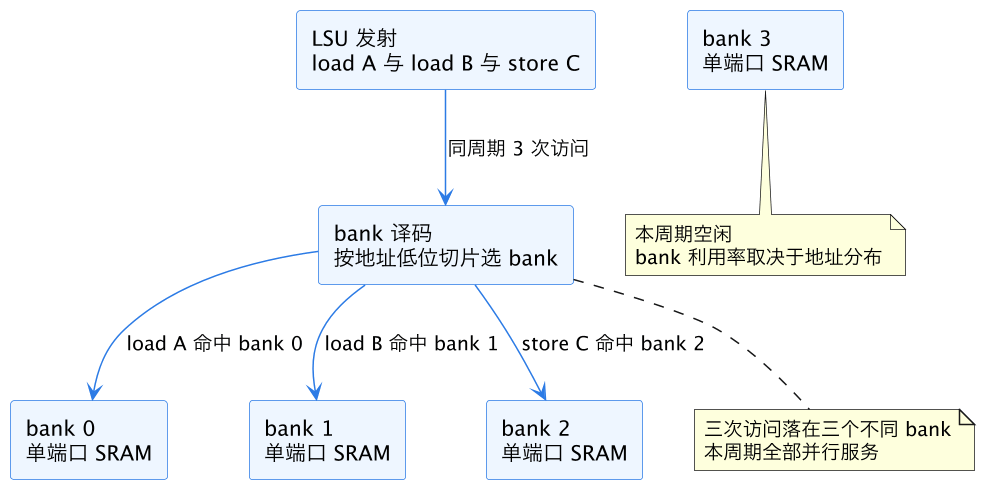
上图是顺利情形:三次访问散在三个 bank,一周期全部完成。理想很丰满,但地址分布由程序决定,不总是那么给面子——下一节看地址是怎么映射到 bank 号的。
二、bank 号从哪来:地址低位切片
要预测冲突,先得知道 bank 号的计算公式。主流做法是从地址低位连续取若干位做 bank 索引。以 64 字节 cache line、8 个 bank 的 L1D 为例:地址 bit 0-2 是字节偏移(8 字节一个字),bit 3-5 常用来选 bank,bit 6 往上是 set 索引(决定查哪一路标签)。
为什么用 bit 3-5 这种「line 内偏移的低位」而不是 set 索引高位?答案藏在程序的访存模式里。程序最常见的访存是顺序扫数组:地址一格一格往上走。如果用 set 索引位选 bank,顺序访问会连续命中同一个 bank 的相邻 line,冲突拉满;用 line 内低位选 bank,顺序访问的字会轮转到不同 bank 上(8 字节步长时,连续 8 个字正好轮遍 8 个 bank),天然把连续流量摊平。这和 DRAM 用低位地址做 bank interleaving 是同一个思想,DRAM bank 并行与 rank 那篇讲的是内存条层面的同款把戏。
真实芯片的映射比「连续三位」更花一点:有些设计把 bank 索引和 set 索引的几位做 XOR,打散「固定步长」造成的规律性聚集;Intel 某些代的 L1D 还允许多个访问命中同一 bank 的同一条 cache line 时合并服务(后面细讲)。但核心规律不变:bank 号由地址低位决定,冲突由「访问地址之间低位的关系」决定,而不是由「是不是同一块数据」决定。
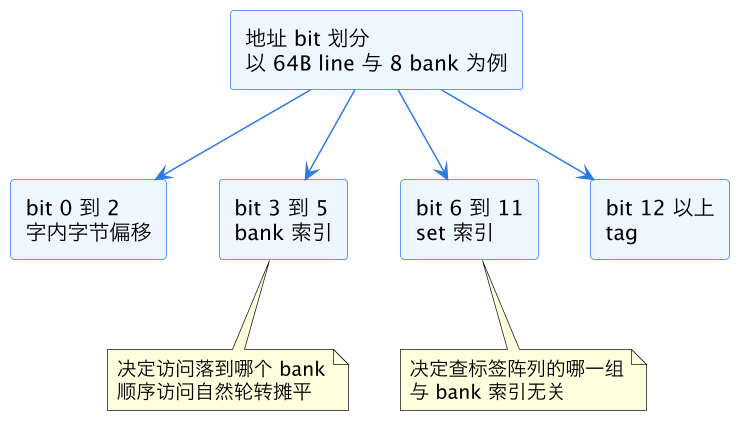
上图把地址切片画了出来。注意 bank 索引和 set 索引是两组不同的位:两次访问可以是完全不同的数据(不同 set、不同 tag、不同 line),只要 bit 3-5 相同,就撞同一个 bank。这是理解冲突的关键——bank 冲突与 cache 命中与否毫无关系,全命中的访问流照样可以撞得头破血流。
三、撞 bank 的瞬间:冲突判定与一拍推迟
现在看冲突发生的精确过程。LSU 在每个周期的访存发射级,把本周期要执行的所有 load/store 的地址算出来,送进 bank 译码逻辑,做一轮两两比较:任意两次访问的 bank 号相同、且不满足合并条件(见下),就判定冲突。裁决逻辑保留其中一个访问本周期进入 bank,其余的被「回放」(replay)——打回 load/store queue 里重新排队,下一拍或之后再试。
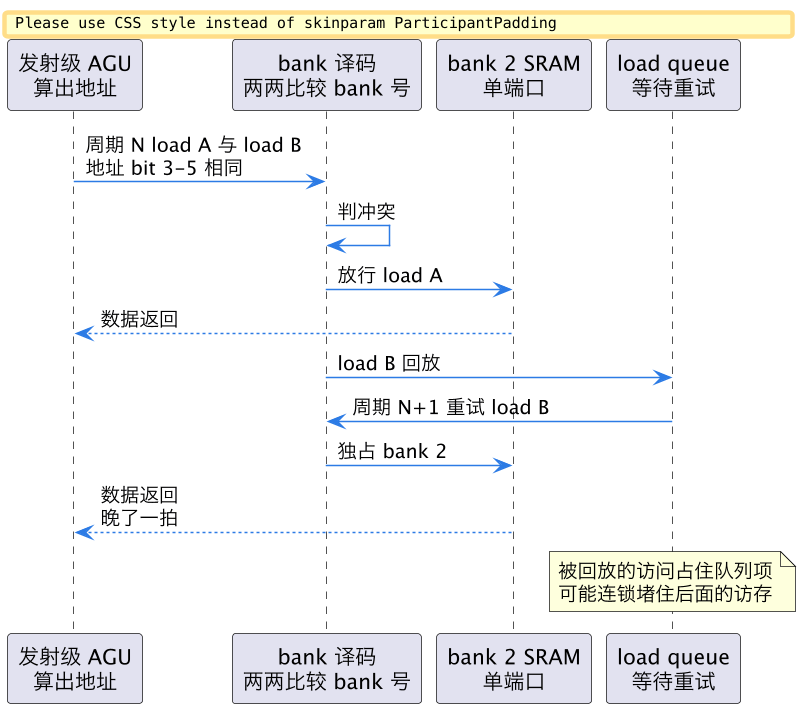
上面这张时序图是一次典型冲突的完整生命周期。三处细节值得盯住。第一,推迟的单位是「一拍起步」——被回放的访问至少要等下一个周期重试,如果下一拍又撞上别人,继续推。第二,回放的访问占着 load queue 的项不放,队列项是稀缺资源,连续冲突可能把队列堵住,进而卡住整个 LSU 的接收能力,小冲突放大成长停顿,机制与 MSHR 未命中状态寄存器 耗尽时的堵塞是同构的。第三,被推迟的 load 的下游消费指令(等这个数据做运算的那批)跟着晚一拍被唤醒,如果发射队列已经按「正常 L1 延迟」做了投机调度,还要再付一次重放代价,连锁反应见 发射队列的唤醒选择。
还有一种放大效应容易被忽略:冲突不是孤立的单拍事件。一个被回放的 load 重试时,恰好又和下一拍新发射的 store 撞同一 bank,就会再被推迟一拍。在访存压力本来就高的内核里,bank 译码级每拍都在做这种裁决,冲突概率随每拍访存次数非线性上升——每拍 1 次访存时几乎没有冲突,每拍 2 次时偶发,每拍 3 次且地址低位扎堆时,平均每条访问都要多等零点几拍,累积起来就是百分之十几的内核减速。
硬件上有一个重要缓和阀:同一 bank、同一 cache line 的多次访问常常可以合并。比如两个 load 都读 bank 2 的第 0x80 号 line 的不同字节,bank 一次读出整条 line 的数据就能同时喂给两者——Intel 近几代核(Sunny Cove 之后)在 L1D 里实现了这种「同 line 不同地址不冲突」的合并,使同 line 访问零冲突代价。真正吃冲突的是「同 bank 不同 line」的组合。
把冲突的组合条件列成表,排查时直接对照:
| 两次访问的关系 | 是否冲突 | 说明 |
|---|---|---|
| 不同 bank | 不冲突 | 真并行 |
| 同 bank 同 line(支持合并的核) | 不冲突 | 一次读 line 服务多个访问 |
| 同 bank 同 line(老核或不支持) | 冲突 | 也要排队 |
| 同 bank 不同 line | 冲突 | 最典型、最值得规避的场景 |
四、性能计数器上怎么认出它
bank 冲突的麻烦在于「沉默」:它既不是 cache miss,也不是 TLB miss,常规 perf stat 看到的命中率漂亮得很。要自己造实验才能隔离出来——写一个循环,让两个 load 的地址低位固定相差 8 字节(同 bank 不同 line),对比相差 64 字节(不同 bank)的版本,数据全在 L1 里,前者的每迭代周期数会明显高出一截。
Intel 平台有直接的证据链:PMU 事件 L1D.REPLACEMENT 无关,要看的是 CYCLE_ACTIVITY 家族里与 L1D 绑定的那几个(如 CYCLE_ACTIVITY.STALLS_L1D_MISS 之外的 L1D pending 类事件,不同代名字略有差异),以及 LD_BLOCKS 家族——它细分了 load 被阻塞的各种原因。AMD 和 ARM 也有对应的 LSU 重放计数。区分思路是一个三分表:
| 症状 | 命中率 | 端口利用率 | 指向 |
|---|---|---|---|
| L1 miss 高 | 低 | 不一定 | 数据冒险与 L1 miss |
| 命中正常、特定端口饱和 | 高 | 接近 100% | 执行端口竞争 |
| 命中正常、端口未饱和、LD_BLOCKS 类计数涨 | 高 | 中等 | cache bank 冲突 |
第三个症状组合就是 bank 冲突的指纹:数据明明都在 L1 里,load 也没把端口塞满,但 LSU 相关的阻塞计数在涨、每迭代周期数莫名偏高。很多「代码看着没问题就是慢」的向量化内核,最后是栽在这上面——SIMD 把每周期访存次数顶到了 2 到 3 次的上限,地址布局稍有不巧,冲突概率就平方级上升。这类「标称带宽与实际带宽的落差」也正是 内存级并行 MLP 讨论的现实约束之一。
五、软件规避:布局、步长与访存顺序
知道了冲突由地址低位关系决定,规避手法就有章可循,按见效程度排四条。
第一条,错开并发访问的 bank 号。一个函数里同一拍会被一起发出的几组访问(比如卷积里同时读两个输入数组加一个权重数组),让它们的基地址低位相互错开 8 到 16 字节的奇数倍,使每拍的三次访问落在三个不同 bank。手工调基地址 padding 是最直接的做法。
第二条,警惕「固定大步长」扫多个数组。两个数组基址对齐到 4KB 页面边界、用相同步长并行扫,两个访问的地址低位永远相同,每拍必撞同 bank。给其中一个数组的起始地址加 64 字节偏移(一条 cache line),低位关系立刻错开。注意对齐到 4KB 的数组在 cache VIPT 与 synonym 讨论的 aliasing 场景里也有类似的对齐敏感性,两件事可以一起看。
第三条,重排访问顺序,摊到时间上。如果一个周期内确实要发很多访存,调整指令顺序让同 bank 的访问之间隔几拍——编译器的调度器在已知机器模型时会自动做一部分,但编译器通常不建模 bank 结构,手工交换循环体内 load 的顺序经常还能再榨出几个百分点。
这套受控实验的思路值得单独说透,因为它是唯一可靠的归因手段:固定循环体只读 L1 常驻的小 buffer,一次只改两个 load 的地址间距这一个变量,扫一遍 8、16、32、64、128 字节的间距,画出「间距对每迭代周期数」的曲线。曲线上间距为 8 字节倍数但不是 64 字节倍数的那些点如果明显抬高,就是同 bank 不同 line 冲突的直接证据;间距 64 字节倍数也抬高,那更可能是别的效应(比如 4K aliasing,即 load 和之前 store 的页内偏移相同触发的假相关,见 load store queue 与存储消歧),两组点要分开解读。实验做在固定频率、关闭 Turbo 的环境下,否则频率抖动会淹没一拍级别的差异。
第四条,数据结构层面的 bank 感知填充。结构体数组里热点字段如果总被成对访问(比如 AoS 布局下 x 和 y 相邻、一个迭代同时读两者),它们在同 line 内反而安全(同 line 可合并);真正危险的是 SoA 下多个对齐数组的并行流。反过来,多线程各自写自己数据时,让各线程的工作区低位错开,避免多核的 L1 在各核内部撞同款 bank 模式。
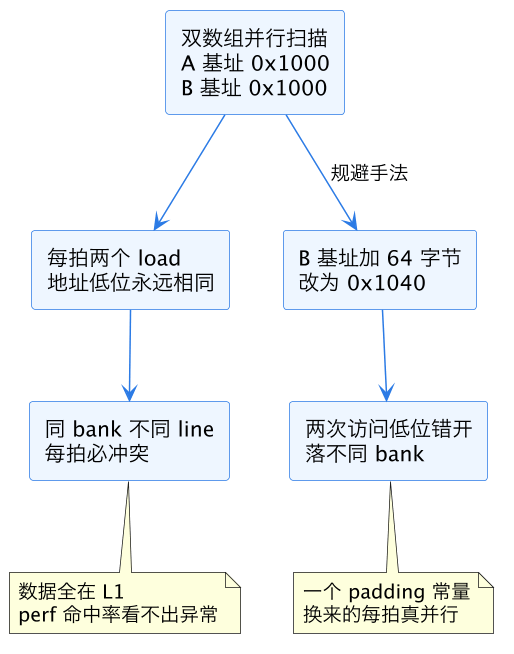
上图把最典型的冲突场景与最小修复画在一起。这类 bug 的荒诞之处在于:修复成本是改一个对齐常量,发现成本却是整个 PMU 排查流程——所以写访存密集型内核时,把「并发访问流的低位错开」当成和「避免 false sharing」同级的默认纪律,比事后排查划算得多。
最后给一个量级速查表收束全篇:
| 项目 | 典型值 | 备注 |
|---|---|---|
| L1D bank 数 | 8 到 16 个 | 随代际增加 |
| bank 粒度 | 8 字节左右 | bank 索引位从 bit 3 起 |
| 冲突推迟 | 1 拍起步 | 连续冲突会叠加 |
| 同 line 合并 | 新核普遍支持 | 同 bank 同 line 不算冲突 |
| 软件修复成本 | 一个 padding 常量 | 典型 64 字节错位 |
总结
cache bank 冲突的根源是 L1 数据缓存用多个单端口 bank 冒充多端口存储体:bank 号由地址低位(典型 bit 3-5)决定,同周期两个访问落到同 bank 不同 line 时,后到的被回放、至少推迟一拍,还会占住 load queue 项放大停顿;它命中率正常、端口不饱和,只能靠 LSU 阻塞类 PMU 计数和受控实验识别;软件上靠错开并发访问流的地址低位、避免同基址同步长并行扫多数组、重排访存顺序来规避——写高带宽内核时把低位错开当成默认纪律,能省掉一整轮隐蔽的性能排查。