缓存替换策略:LRU、随机与伪 LRU —— 缓存满了踢谁,答案决定命中率
组相联缓存的每一组只有有限几路,新数据来了而组已满,就必须踢掉一路。踢谁——这就是缓存替换策略要回答的问题。它不像 数据冒险 那样决定单条指令的对错,却决定整个工作集的 miss 率走向:选错受害者,热数据被反复踢出,IPC 直接腰斩。本篇从三种主流策略的行为对照讲起,重点解剖 LRU 的 thrash 死穴和现代 CPU 的插入策略补丁。缓存层次的整体背景见 CPU 微架构总览。
本文要回答的问题
- 缓存替换策略到底在什么时候被触发,它影响的是哪一级性能指标?
- LRU、随机替换、伪 LRU 三种策略的行为差异和硬件代价各是什么?
- 为什么严格的 LRU 会在顺序扫描下集体失效(thrash)?
- 现代 CPU 用什么插入策略给 LRU 打补丁,效果有多大?
一、替换策略在缓存里的位置:组相联的最后一道选择题
先回忆组相联缓存的寻址过程:地址被拆成 tag / index / offset 三段,index 选中一"组"(set),组内 N 路(way)并行比较 tag。命中皆大欢喜;miss 时就要从组里选一个牺牲者(victim)腾位置——N 路里挑一路踢掉。这个"挑谁"的决策,就是替换策略。
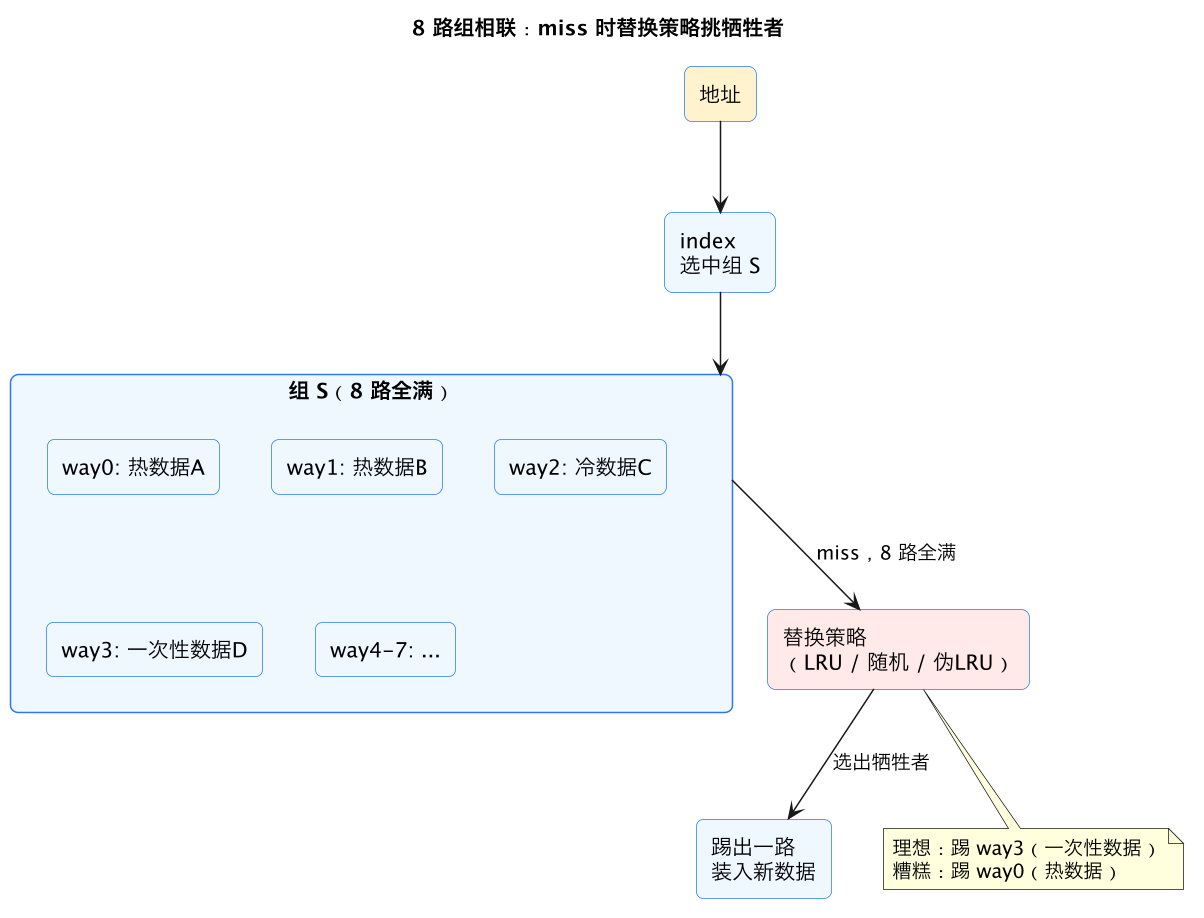
图里的关键点是:组内 8 路的内容"价值"并不相等——有的是循环热数据,有的是只读一次的流式数据。替换策略的终极目标只有一个:尽量踢掉"未来最久不会再被用"的那一路。但硬件无法预知未来,只能用过去的行为做启发式猜测。不同策略 = 不同的猜测方法,代价和准确度各不相同。
一个容易被忽视的事实:替换策略只影响 miss 率,不影响命中时的延迟。命中路径上 tag 比较是并行的,策略元数据根本不参与。所以它的全部价值都体现在"少 miss 几个百分点"上——而 L1 每多 1% 的 miss,落到 L2 就是 10 拍级、落到内存就是 200 拍级的惩罚。
二、三种主流策略的行为对照
2.1 LRU:踢最久没用的,理论上最优
LRU(Least Recently Used,最近最少使用)的思路很直觉:过去最久没被访问的那一路,未来也最可能不再被用。每次命中都把该路标记为"最新",miss 时踢掉"最旧"的那路。
问题在于硬件代价。N 路组相联要维护精确的 LRU 顺序,需要记录完整的访问历史排序——N 路的全排列有 N! 种,需要 log₂(N!) 位状态。8 路就需要约 16 位/组,而且每次访问都要更新多个计数器或矩阵位,时序压力大。4 路以内尚可接受,8 路以上精确 LRU 基本不做了。
2.2 随机替换:零状态,出奇的能打
随机替换(Random)最粗暴:不记任何历史,miss 时硬件随机数发生器指一路踢掉。零状态位、零更新逻辑。
听起来很蠢,但大量实测表明:在很多真实负载上,随机替换的 miss 率只比精确 LRU 高一点点,有时甚至更好。原因在于 LRU 的"过去最久不用 = 未来也不用"这个假设在扫描型负载下恰恰是最差的猜测(见第三节),而随机踢人反而不会系统性踩坑。ARM 不少核心的 L1/L2 就用随机或近似随机策略。
2.3 伪 LRU(树形 PLRU):用 log₂N 位逼近 LRU
伪 LRU(Pseudo-LRU,常见实现是树形 tree-PLRU)是工程上的甜点:组内 N 路组织成一棵二叉树,每个内部节点只存 1 个指向"较旧半边"的位,N 路只需 N-1 位状态。访问一路时,把路径上的位全部指向反方向(表示"这边刚用过");替换时顺着位指针走到叶子,就是近似最旧的路。
三策略对照如下:
| 维度 | 精确 LRU | 随机替换 | 树形伪 LRU |
|---|---|---|---|
| 状态位(8 路/组) | ~16 位 | 0 位 | 7 位 |
| 每次访问更新逻辑 | 复杂(排序变化) | 无 | 简单(翻转路径位) |
| 近似 LRU 程度 | 完全准确 | 完全不近似 | 较好近似 |
| 扫描 thrash 抗性 | 最差 | 好 | 较差 |
| 典型使用位置 | 4 路以内的小结构 | ARM 系 L1/L2 | x86 L2/L3 常见 |
可以看到伪 LRU 用约一半的状态位拿到了 LRU 的大部分收益,这是它在高相联度缓存里胜出的根本原因。但它继承了一个 LRU 家族的共同软肋——下一节的 thrash。
把上表的结论再压成一张三栏卡,记住每家的「状态位代价」和「thrash 抗性」这两行就够应付大部分选型讨论:
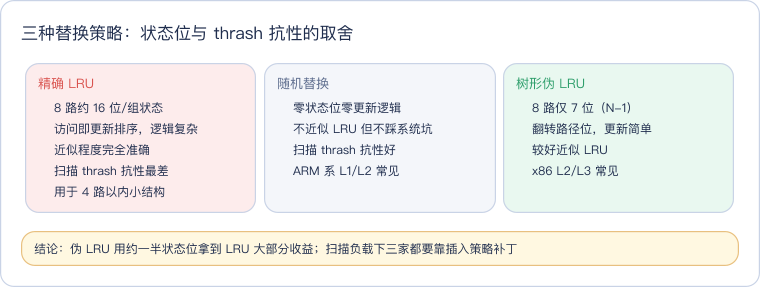
这张卡与上面的明细表是同一份事实的两种读法:表给可检索的逐项字段,卡给一句话取舍——没有「免费的最优」,只有「状态位、近似度、thrash 抗性」三者之间的让渡。
三、LRU 的死穴:顺序扫描 thrash
考虑一个经典场景:循环遍历一个 2MB 数组,而 LLC 某组的有效容量只够装 1MB 的对应部分。访问序列是 A B C D ... Z A B C D ...(循环扫)。LRU 的行为是:
- 第一轮:A~Z 依次装入,全部 miss,把组撑满
- 第二轮访问 A:A 已经在第一轮里被挤成"最旧",早被踢了 → miss;装入 A 又踢掉当前最旧的 B
- 访问 B:B 刚被 A 踢掉 → miss;装入 B 又踢掉 C……
- 每一次访问都 miss,命中率 0%
这就是缓存 thrash(颠簸):工作集略大于缓存时,LRU 的"踢最旧"恰好每轮都把马上要用的数据踢出去,表现比随机替换还差——随机好歹能留下一部分,期望命中率约等于"缓存容量/工作集大小"。
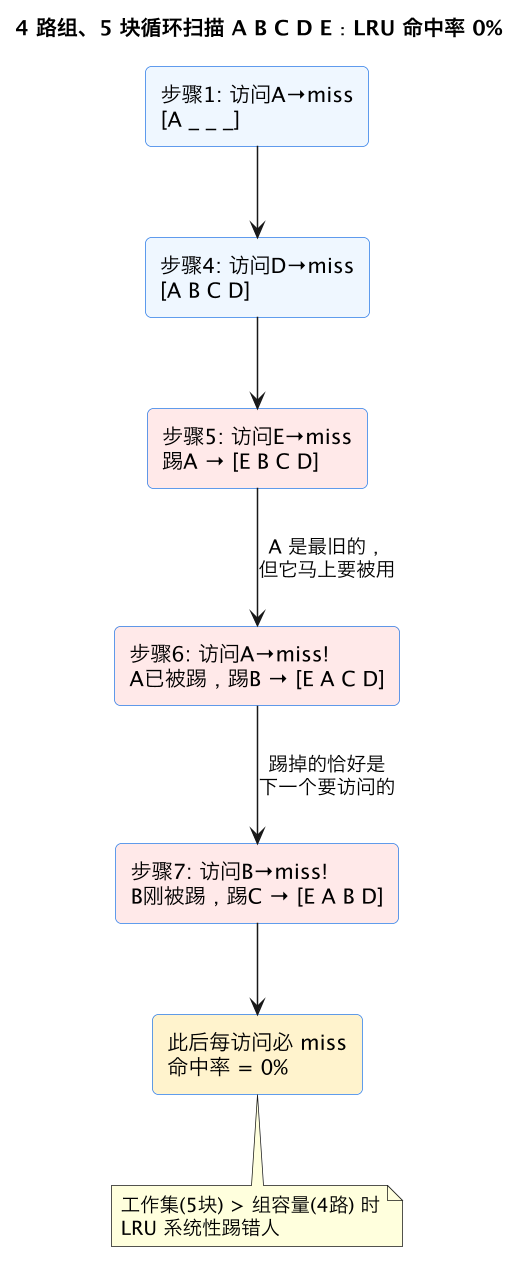
图里这个 5 块对 4 路的最小例子,把 thrash 的机制暴露得很清楚:LRU 踢掉的永远是"循环序列里下一个就要用的"。工作集只比组容量大 25%,命中率却从理想 80% 掉到 0%。这不是边角案例——数据库全表扫描、视频编码的帧遍历、大数组 memcpy,全是这种模式。
四、现代 CPU 的补丁:插入策略与 thrash 抗性
既然 LRU 的问题是"新来的数据一律当最热处理",补丁思路自然是:让新装入的块别急着排到最前面。这就是插入策略(insertion policy)的玩法,Intel 从 Nehalem 起的 LLC 就用了类似机制:
- LIP(LRU Insertion Policy):新块装入时直接插到"最旧"位置,而不是"最新"位置。扫描流数据进来就排到队尾,马上会被踢走,不会把热数据挤下去。循环扫描场景下,原来的热数据全程留在缓存里。
- BIP(Bimodal Insertion Policy):大部分时候用 LIP,小概率(比如 1/32)用正常的 MRU 插入——避免纯 LIP 下新数据完全得不到机会,给真正会变热的新块留了活路。
- DIP(动态选择):运行时同时跟踪两组计数器,动态判断当前负载更像"复用型"还是"扫描型",在 LRU 和 BIP 之间切换。Intel 的 LLC 策略常被认为是这一类自适应方案的变种。
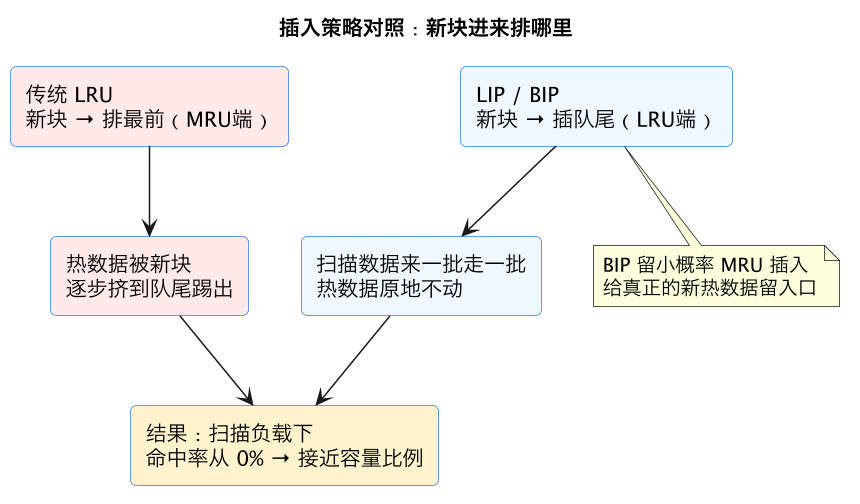
效果上,DIP 类策略能把 thrash 负载的 LLC 命中率从接近 0% 拉回"容量/工作集"的理论上限附近,对混合负载(热数据 + 扫描流并存,比如数据库一边跑热点查询一边做备份扫描)改善尤其明显。
对性能分析实践的意义有两条。第一,当你用 perf 看到 cache-misses 在某段大数组循环上爆表,先想想是不是工作集略超缓存的 thrash 模式,而不是简单归因为"缓存太小"。第二,代码层面可以主动配合:大顺序流用非临时加载指令(x86 的 movntdqa / SSE 的 streaming load),明确告诉硬件"这数据只用一次,别污染缓存",等于软件手动实现了 LIP。
这一篇在知识体系里的位置
本篇属于 concepts/microarch 目录下的缓存主题,与流水线/乱序主题互补:替换策略决定缓存层次能兜住多少访问,而 CPU 微架构总览 给出这些部件在整机里的位置。缓存 miss 发生后对流水线的连锁冲击,见 L1 miss 连锁反应篇;乱序引擎如何用 MLP 掩盖 miss 延迟,见 乱序执行。用 perf 量化 miss 率的实操见 perf 用法。
总结
缓存替换策略回答的是"组满了踢谁":精确 LRU 理论最优但硬件贵且有 thrash 死穴,随机替换零代价且意外地稳,树形伪 LRU 用 N-1 位状态拿到 LRU 大部分收益成为高相联度主流;面对顺序扫描,LRU 会系统性地踢掉下一个要用的块导致命中率归零,现代 CPU 用 LIP/BIP 插入策略让新块从队尾进队,保住了热数据。 分析 cache-miss 热点时,先分清是"容量不够"还是"thrash 模式",后者靠调整遍历方式或用 streaming 指令就能救。