iTLB 4K 别名惩罚:指令获取路径上的同义冲突、页遍历与误伤
承 itlb-miss-frontend-stall 对指令 TLB 未命中导致前端停顿的分析,以及 cache-vipt-synonym-aliasing 对 VIPT 缓存同义问题的通用讨论。「4K 别名」这个词在数据侧(load/store 的 4K aliasing)名气更大,但指令获取路径同样被「低 12 位相同」这件事折磨——而且疼法不止一种。本篇把 iTLB 4K 别名惩罚拆成三张账:L1i 同义冲突、iTLB 未命中页遍历、SMC 检测误伤。
本文要回答的问题
- 为什么指令路径对「低 12 位相同」特别敏感?4K 这个数字从哪来?
- L1i 的 VIPT 同义冲突怎么影响取指?
- iTLB 未命中走页遍历的代价多大?4K 页与大页差多少?
- 自修改代码(SMC)检测为什么会被 4K 别名误触发?JIT 为什么容易中招?
- 工程上怎么测、怎么躲?
一、4K 这个数字的来历
x86 基本页大小 4KB,页内偏移正好占虚拟地址低 12 位。于是一切「只看低 12 位做快速猜测」的微架构结构,都会把「两个不同页、低 12 位相同」的地址搅在一起——这就是 4K 别名。指令路径上至少有三处用到低 12 位做快速决策:L1i 的 VIPT 索引(见 cache-vipt-synonym-aliasing)、iTLB 的组索引、以及 store→fetch 的 SMC(self-modifying code,自修改代码)检测的粗筛。每一处都有自己的惩罚形式,下面逐个算。
二、L1i 同义:VIPT 的容量幻觉
L1i 典型 32KB、8 路、64 字节行——组数 = 32K/(8×64) = 64 组,组索引恰好落在低 12 位以内,这是设计上的甜蜜点(索引不依赖 TLB 结果,取指不用等翻译)。代价是:两个虚拟地址低 12 位相同、落在不同 4K 页时,它们映射到同一组,只能靠标签(物理地址)区分。8 路听起来宽裕,但共享库被大量进程映射到不同虚拟地址、同一份物理页——此时标签相同不冲突;真正的麻烦是同一进程里两个低 12 位相同的虚拟页存放不同代码(比如 mmap 出来的 JIT 代码段恰好与某个热点函数低 12 位对齐),它们在 L1i 里抢同一组,8 路被快速填满后就是反复换出换进。
更隐蔽的一档是别名引发的命中误判修正:前端按低 12 位取了组、预读了数据,等 iTLB 返回物理标签一对——不匹配,这次取指作废重来,白花 5-9 个前端周期,效果类似一次小型分支误预测。
这一节的数字也值得记住:L1i 同义冲突的代价不是「容量小了一点」那么简单,它让有效相联度从 8 路退化到「被别名对半分」——两个互撞的热点各占 4 路,等价于 L1i 在它们身上只剩 16KB。对代码 footprint 本来就贴着 L1i 上限的服务(大模板代码、扁平化后的解释器主循环),这种退化足以把 L1i miss 率翻倍,然后问题顺着「L1i miss → L2 → 前端气泡」一路放大。
三、iTLB 未命中:4K 页时代的页遍历账单
iTLB(一级指令 TLB)典型只有 64-128 项,全 4K 页时覆盖 256KB-512KB 代码——一个中等规模服务的.text 段轻松超过它。未命中后走 STLB(二级 TLB,见 tlb-two-level-stlb-design),STLB 也 miss 就触发硬件页遍历(page walk):最多 4 次内存级访问(4 级页表),命中缓存也要 20-80 周期,部分走内存则 300+ 周期——而这期间前端完全断粮,流水线前端气泡直接传导成 IPC 下跌。iTLB miss 对前端的影响机制详见 itlb-miss-frontend-stall。
「4K 别名」在这里的角色是放大器:页遍历缓存(paging-structure cache,见 tlb-pagewalk-cache)按虚拟地址部分位索引,低 12 位相同的高层页表项会互相挤占,让本应缓存命中的遍历退化成全遍历。换 2M 大页后,一个 iTLB 项覆盖 2MB,同义概率和 miss 率一起塌掉——这就是 hugepage-tlb-pressure 主张给代码段上大页的核心理由。
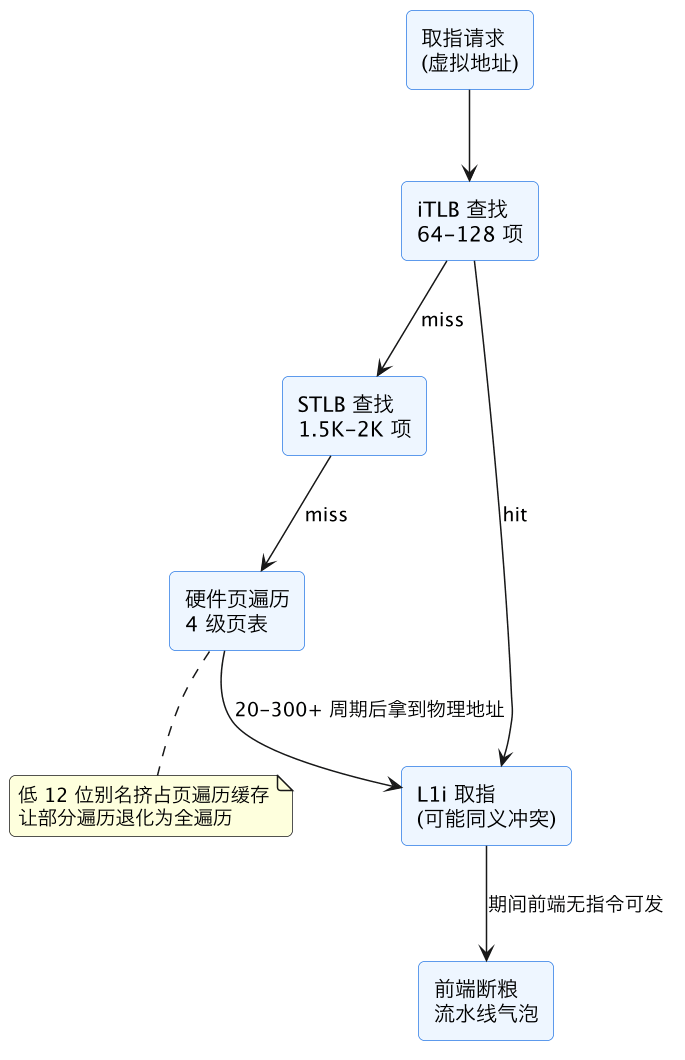
图上要害:iTLB→STLB→页遍历是一条延迟逐级暴涨的链,而 4K 别名在链条两端(iTLB 组冲突、页遍历缓存挤占)同时使坏。
四、SMC 误伤:JIT 的隐形税
x86 要求 CPU 检测「程序写了自己将要执行的代码」并自动作废已取指/已解码的内容(维护指令一致性)。检测要兼顾性能,做法是粗筛:store 的物理页与正在取指的地址低 12 位匹配(或同页)时,按最坏情况处理——触发 machine clear,清空整条流水线重来,一次约 150-450 周期。
JIT 运行时(Java HotSpot、V8、各类 AOT+patch 系统)是重灾区:代码页和数据页经常紧邻分配,元数据写(改个计数、更新个类型反馈)的数据地址与热点代码低 12 位撞车,就会被误判为「在改代码」,一轮流水线清空伺候。Intel 有对应 PMU 事件 MACHINE_CLEARS.SMC,JIT 负载下这个计数不该是零但不该涨得快——涨得快就该考虑把 JIT 元数据区与代码区按 4K 对齐错开分配。
五、一个可复现的对照实验:大页前后
想直观看到 iTLB 4K 别名/未命中的分量,最干净的对照是「同一份代码,4K 页 vs 2M 大页」。
实验设置:挑一个 .text 段在 8-32MB 之间的真实服务(或用一个跳来跳去执行的大函数集合压测程序模拟),先用默认 4K 页跑标准压测,记录 IPC 与 ITLB_MISSES.WALK_DURATION;然后给代码段挂上 2M 大页(新版内核可直接对 text 启用 THP,老方案是用 hugetlbfs 重映射 text,或借助 libhugetlbfs 的 HUGETLB_MORECORE/--text-huge-pages 链接选项),同压力再跑一次。
典型结果:iTLB 页遍历周期数掉一到两个数量级,前端 bound 比例(Topdown 的 Frontend_Bound,见 topdown-analysis-methodology)明显下降,整体 IPC 提升 3%-10%——纯靠「少做翻译」赚来的,业务代码一行没改。代码越大、调用图越跳(解释器、微内核式分发、海量模板实例化),收益越靠上限。
反向实验也值得一做:刻意让两个热点函数低 12 位对齐(链接脚本里把第二个函数排到 first + N×4K + 固定偏移),4K 页下能看到 L1i 冲突 miss 明显上升;切 2M 大页后两者页内偏移相同但同处一大页内,同义消失。这一正一反两个开关,基本能把「别名问题是不是我当前的瓶颈」定性清楚。
六、测量与规避清单
测量侧三个事件:前端 iTLB 停顿看 ICACHE_16B.IFDATA_STALL / ITLB_MISSES.STLB_HIT 族(名字因代而异),SMC 误伤看 MACHINE_CLEARS.SMC,页遍历成本看 ITLB_MISSES.WALK_DURATION。规避侧四条:
- 代码段上 2M 大页(Linux:
/sys/kernel/mm/transparent_hugepage对 text 的支持,或显式 hugetlbfs 映射)——iTLB 覆盖直接放大 512 倍; - JIT 的代码缓存与元数据分区域、按页对齐分配,消灭 SMC 别名撞车;
- 动态库布局避免让热点函数低 12 位互撞(极端场景下用链接脚本/加载地址微调);
- 别在热路径写代码页附近的只读数据——把「写」和「取指」的物理邻接拆开,SMC 检测就无可误伤。
最后提醒一个认知陷阱:iTLB 类问题很少单独把程序拖死,它更像一种「百分比税」——平时交 2%-5%,没人察觉;等业务膨胀到某个规模(代码量翻倍、JIT 代码缓存撑爆、上了新的动态库),税率突然跳到 10%+,表现为「什么都没改,就是全面变慢了一点」。把 ITLB_MISSES 族和 MACHINE_CLEARS.SMC 编进常规性能巡检,比在事故现场现学要快得多。
这一篇在知识体系里的位置
前端停顿机制见 itlb-miss-frontend-stall,VIPT 同义通用原理见 cache-vipt-synonym-aliasing,两级 TLB 与页遍历缓存见 tlb-two-level-stlb-design 与 tlb-pagewalk-cache,大页方案见 hugepage-tlb-pressure,流水线清空家族见 load-replay-pipeline-recovery。
总结
iTLB 4K 别名惩罚是「低 12 位相同」在指令路径上收的三笔税:L1i 同义挤组、页遍历缓存挤占拉长 iTLB miss、SMC 粗筛误伤清空流水线;代码段上大页加 JIT 布局对齐,是性价比最高的两味解药。