BTB 分支目标缓冲:取指级怎么在译码之前就知道"下一条地址是谁"
承 branch-prediction——那一篇重点讲了方向预测器怎么猜"跳还是不跳",但只解决了一半问题。取指级每个周期都要回答一个更紧迫的问题:下一拍从哪个地址取指? 分支指令此刻还没译码,"它是不是分支、跳去哪"理论上还不知道。让前端不停摆的正是 BTB 分支目标缓冲(Branch Target Buffer)——一张用 PC 索引、记录"这条分支上次跳去了哪"的高速缓存。它与方向预测器一文一武:方向预测器管"走不走",BTB 管"去哪"。间接分支目标(ITTAGE、RSB)见 indirect-branch-prediction,本篇聚焦 BTB 本身。
本文要回答的问题
- 为什么方向预测器再准,没有 BTB 前端照样每拍停摆?
- BTB 命中和缺失时,取指流程分别长什么样,气泡各有多少拍?
- BTB 和方向预测器怎么分工、谁先查谁后查?
- BTB 的容量、组相联路数、tag 截断为什么会引入"别名冲突",两个不相干的分支怎么互相挤掉?
- BTB miss 在真实代码里有多贵,perf / Topdown 里怎么看到它?
一、BTB 解决什么问题:取指级的"下一拍地址"难题
把镜头拉到前端最左端。取指级每拍做的事极其朴素:拿一个 PC,去指令缓存取一行,然后立刻需要下一个 PC。流水线不留思考时间——这一拍不定下地址,下一拍取指就空转。
麻烦在于:当前这行指令里可能藏着一条分支。它是不是分支、是条件还是无条件、目标是多少,这些答案要等译码级才能确认,真正算出来甚至要到执行级。如果取指级老老实实等译码结果,每遇到一次分支前端就要空转好几拍;按分支占动态指令 15%~25% 的常见比例,IPC 直接被打骨折。
有人可能会问:既然目标地址对直接分支来说就编码在指令里,让取指级"偷看"一下指令内容不就行了?偷看的前提是已经取到了指令并且认出它是变长 x86 指令的边界——x86 一条指令 1 到 15 字节,定位分支指令本身就要先做一遍预译码。等预译码跑完再决定下一拍地址,和等译码级没本质区别,气泡照旧。BTB 的思路是绕开"先读懂指令"这条路径:不读指令,直接拿 PC 这个现成钥匙去查一张小表,把"这附近有没有分支、它上次去哪"变成一次纯粹的 SRAM 查找。
方向预测器(TAGE、两位饱和计数器那一族,详见 branch-prediction)只回答"跳不跳"这一个比特。就算它 100% 准,取指级仍然不知道"跳去哪"——尤其 jmp *%rax 这类间接分支,目标存在寄存器里,连指令编码都没有。BTB 补的就是这一半:用当前 PC 直接查表,当拍或下一拍给出"疑似分支 + 预测目标地址",译码还没动手,取指已经转向。
这张图的核心信息是:BTB 和方向预测器与取指并行工作,都不等译码。PC 一到,两路查询同时发出;BTB 给出"这一带有个分支,它上次跳去了 X",方向预测器给出"这次跳不跳"。取指决策逻辑把两者合起来:BTB 说这里有分支且方向预测说跳,下一拍 PC 就改成 BTB 给的目标;方向预测说不跳,就顺序往下取。译码级发现新分支后再回填 BTB——BTB 的内容完全由"历史执行痕迹"累积而成,冷启动时是空的。
二、BTB 命中与缺失时的取指流程
命中与缺失的差别,直接决定前端是"零气泡转向"还是"空转若干拍"。用一张时序对比图展开:
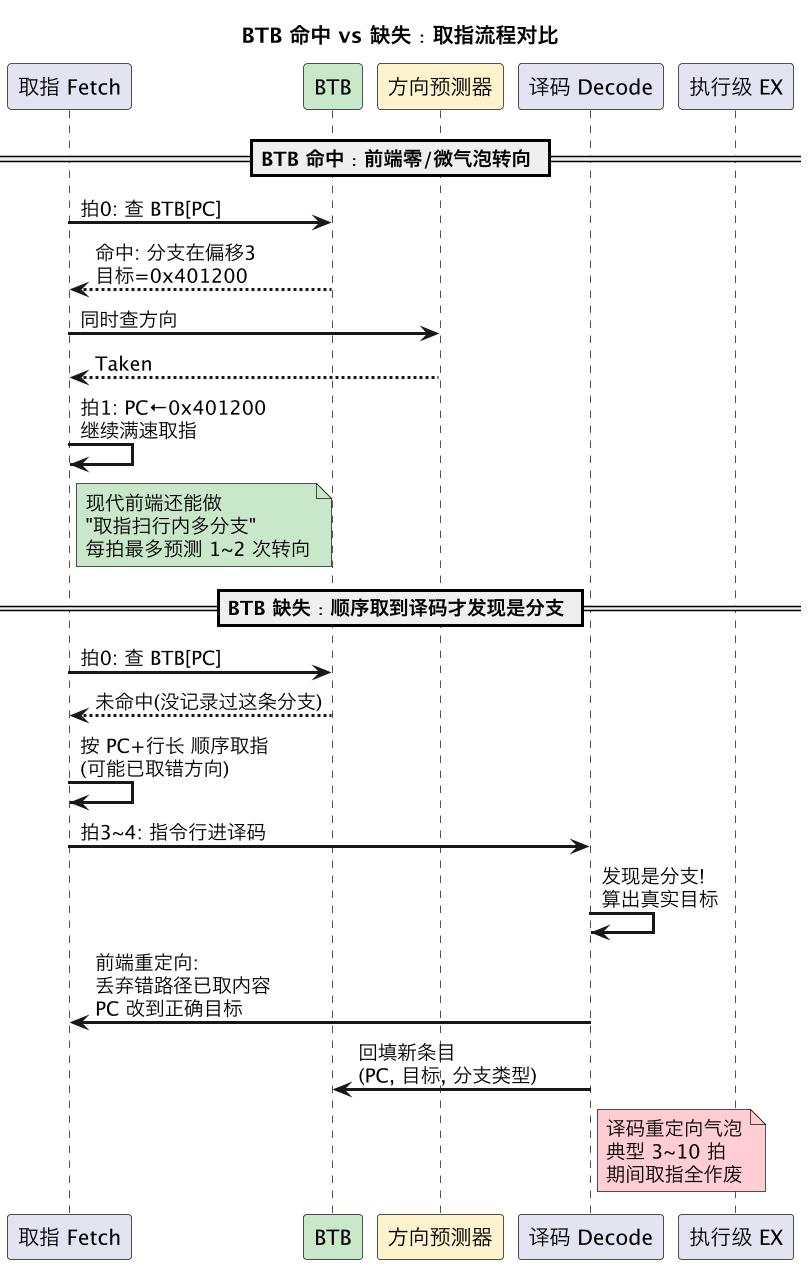
解读这张图的两个要点。其一,命中路径上 BTB 必须在译码之前出结果——这是它和"译码后从指令编码直接算目标"的本质区别。直接条件分支的目标明明编码在指令里,为什么还要 BTB?因为译码在取指之后三四拍,等译码给目标,前端照样要空转;BTB 用 SRAM 查表把这个答案提前到了译码之前,代价是要花面积存一份"PC → 目标"的冗余拷贝。其二,缺失路径的气泡分两段:方向未知段(不知道这里有分支,按顺序取,可能整条路都取错)加重定向段(译码发现后丢弃、改 PC)。现代 Intel 前端还有一层 fast redirect 机制,译码后不久就能纠偏,把气泡从十几拍压到个位数,但再快也是纯损失——这几拍里后端明明饿,前端却供不上 µop。
三、BTB 与方向预测器的分工
两者经常被笼统叫成"分支预测器",但查的东西、错的代价、更新的时机完全不同:
| 维度 | BTB 分支目标缓冲 | 方向预测器(TAGE 等) |
|---|---|---|
| 回答的问题 | 这个 PC 附近有分支吗?目标是谁? | 这条条件分支这次跳不跳? |
| 存的内容 | PC tag + 目标地址 + 分支类型 | 历史模式(计数器/表项),不含地址 |
| 查询时机 | 取指级,用 PC 索引,当拍/下拍出结果 | 与 BTB 并行,或依 BTB 命中的分支信息 |
| 管哪些分支 | 所有控制流:直接、间接、调用、返回 | 只管条件直接分支的方向 |
| 误判的代价 | 目标错:整条投机路径作废 | 方向错:同样 flush,但目标本身不用猜 |
| 更新时机 | 译码发现新分支回填;执行级修正目标 | 分支退休/执行后更新历史 |
| 典型规模 | 数千到上万条目的组相联 SRAM | 数十万到上百万个计数器 |
一句话概括分工:方向预测器是"评论员",只表态走不走;BTB 是"导航仪",直接给下一拍地址。无条件跳转、调用、返回这些方向板上钉钉的分支,方向预测器根本不参与,全靠 BTB 给目标——这也解释了为什么 BTB 必须记录分支类型字段:call 要把返回地址压进返回栈缓冲 RSB(见 indirect-branch-prediction),ret 要从 RSB 弹目标,jmp * 要转交间接目标预测器,各自有后续的专管硬件。
四、容量、路数与别名:BTB 为什么不是越大越灵
BTB 物理上就是一张组相联缓存,和 I-Cache 的组织方式神似:PC 的低位做组索引,高位做 tag,每条目存"目标地址 + 分支类型 + 有效位"。
这张图里的 0x...A1B4 和 0x...E1B4 两条分支互不相干,但 PC 低位一样,被映射到同一组。4 路组相联意味着同组最多容纳 4 条这样的分支,第 5 条进来就要踢人。被踢的分支下次执行时 BTB miss,前端又要吃一次译码重定向气泡。更要命的一种场景是 tag 截断:为了省面积,有些设计只存 PC 高位的一部分做 tag,于是低位相同、高位不同的两条分支可能共用同一个条目、给出对方的目标地址——方向预测器说跳,BTB 给的目标却是别人家的,取指沿着错误目标跑出去十几拍才在执行级被发现。Spectre v2 的 BTB poisoning(BTB 投毒)利用的正是这个机制:攻击者用精心构造的 PC 在受害者 BTB 条目里塞进恶意目标,诱使受害者投机执行到泄密代码。BTB 别名因此不仅是性能问题,还是安全问题。
容量和路数的演进反映了分支密度的爆炸:
| 世代 | BTB 规模(量级) | 备注 |
|---|---|---|
| Intel Nehalem(2008) | 数千条,2 级 BTB | 首次引入两级:小 L0 快、大 L1 全 |
| AMD Zen 2(2019) | L1 512 条 + L2 7K 条 | 两级结构成主流 |
| Intel Golden Cove(2021) | 约 12K 条,每拍预测 2 个分支 | 取指扫行内多分支转向 |
| AMD Zen 4(2022) | L1 1.5K + L2 7K,L1 零气泡 | 命中 L1 时转向不损失拍数 |
| Apple M 系列 | 未公开,实测数万条量级 | 大 BTB 支撑超高前端带宽 |
趋势很清楚:代码体积越来越大(浏览器、JIT 运行时动辄几十 MB 热代码),单级小 BTB 覆盖不住,于是都做成了"小而快的 L0/L1 + 大而全的 L2"层次结构,和 I-Cache 的 L1/L2 分层如出一辙。L2 BTB 命中虽然要多花一两拍,但仍远好于完全 miss 走到译码。
还有一个容易被忽略的结构性细节:BTB 的条目粒度不一定是"一条分支一个条目"。现代前端按"取指块"(fetch block,一次取出的 16~64 字节窗口)组织预测,一个条目可以描述"这个窗口里最多两条分支及其各自目标"。这样做的收益是每拍可以预测多次转向——一个窗口里先有一条 jcc 再有一条 ret,一拍内连环转向两次。代价是条目格式更复杂,且窗口内分支数超过条目能描述的上限时,多出来的分支照样等译码。这解释了为什么密度极高的跳转表(连续十几条 jmp)即使每条都"很热",前端带宽还是会塌:不是 BTB 没记住它们,而是每拍能预测的转向次数本身有硬上限。
五、BTB miss 的前端气泡:有多贵、怎么观测
BTB miss 的代价可以拆成三种典型情形:
- 新分支首次执行(冷 miss):必然 miss,译码重定向气泡约 3~10 拍。程序刚启动、新代码路径第一次走时密集发生,稳态后消失。
- 容量/冲突 miss:热代码的分支总数超过 BTB 有效容量,条目互相踢出,稳态下持续 miss。跳转表密集的解释器分发循环、巨型 switch、高度多态的虚函数调用点是重灾区。
- 间接分支目标多变:BTB 只存单一目标,目标经常变的间接分支等于 BTB 层面近乎失效,要靠 ITTAGE 这类专门预测器(见 indirect-branch-prediction),miss 时代价和误预测同级——一次 flush 15~20 拍起步,误预测后的流水线清空机制见 precise-exception-pipeline-flush。
对比一下量级:一次 L1 BTB 零气泡转向成本为 0,译码重定向约 5 拍,方向/目标误预测 15~20 拍,一次 L3 未命中的访存约 40 纳秒(上百拍)。BTB miss 是"小伤",但分支密度高时小伤乘以巨大频次,前端供给能力就被啃掉一大块——这在 Intel Topdown 方法里体现为 Frontend Bound 升高。观测手段:
# Topdown 第一层:前端供给不足占比
perf stat -M TopdownL1 ./app
# 关注 frontend_bound 百分比

# Intel 更细的前端事件(Sandy Bridge 以后)
perf stat -e icache_16b.ifdata_stall,\
frontend_retired.latency_ge_4,\
br_misp_retired.all_branches ./app
# frontend_retired.latency_ge_4 —— 前端超过 4 拍供不上 µop 的槽位
# 结合 BTB miss 密集场景(大量间接跳转)判断是不是 BTB 在拖经验法则:frontend_bound 高但 icache miss 低、br_misp 也不离谱时,就要怀疑 BTB 覆盖不住——典型画像是代码足迹大、分支密集、跳转目标分散(虚函数-heavy 的 C++、解释器、JIT 代码)。
代码侧的应对围绕"帮 BTB 减负"展开:
- 收紧热路径布局:用
__builtin_expect提示分支倾向,配合 PGO(Profile-Guided Optimization,按真实运行画像重新排布代码)让热代码挤在一起、冷代码挪走,热区分支数直接降一个量级,BTB 有效覆盖率随之上升。 - 适度内联:把高频小函数内联掉,一对
call/ret从 BTB 里省出两个条目,还顺带免了 RSB 的占用。 - 改写分支密集的分发循环:解释器的
switch (opcode)分发、查表式状态机,能合并的计算跳转就合并,能用无分支查表替代的就用数据换分支——每消掉一条热分支,BTB 就少一份压力。 - 小心超大跳转表:单函数里上百个 case 的 switch 编译成跳转表后,是容量 miss 和间接目标 miss 的双重灾区,必要时应拆层级或改哈希分派。
µop cache 命中时整个译码级被旁路(见 uop-cache-decode-frontend),但 BTB 查询依然要做——译码可以省,"下一拍去哪取"永远省不掉。BTB 是前端里少数连 µop cache 也替代不了的部件。
这一篇在知识体系里的位置
本篇是微架构"⑤分支预测+投机"环节里 BTB 分支目标缓冲的专题,与三篇姊妹文互补不重复:
- branch-prediction:分支预测总纲,方向预测器(两位计数器、TAGE)的主场;本篇把其中"BTB 管目标"那一句话展开成全篇。
- indirect-branch-prediction:间接分支目标预测(ITTAGE)与返回栈 RSB;本篇只交代 BTB 如何把它们串起来,不深入。
- quadirect-branch-prediction:另一视角的分支预测纵深讨论。
- 上游框架:cpu-microarch-overview 的演进链导读,cpu-out-of-order 的投机执行背景,pipelining-basics 的控制冒险。
- 下游影响:前端气泡的完整流水线视角见 uop-pipeline-walkthrough,前端瓶颈在 IPC 分析中的定位见 ipc-bottlenecks,误预测 flush 的机制细节见 precise-exception-pipeline-flush。
总结
BTB 分支目标缓冲是前端的"下一拍地址发生器":方向预测器只表决"跳不跳",BTB 用 PC 当拍查出"跳去哪",让取指在译码之前就能转向;它是一张组相联 SRAM,容量路数有限、PC 低位相同的分支互为别名互相挤占,miss 时前端要吃 3~10 拍译码重定向气泡,间接分支目标多变时更惨——分支密集、代码足迹大的程序里,BTB 覆盖率就是 Frontend Bound 的隐形天花板。