锦标赛预测器:局部与全局预测器并用、meta-predictor 仲裁机制全解
更新时间:2026-10-02。分支预测 那篇讲过预测器的代际演进:两位饱和计数器只看分支自己,gshare 引入固定长度的全局历史。代际表上还留着一格——「锦标赛预测器(tournament predictor)」,标注是「局部 + 全局两个预测器并跑,选择器仲裁」。这一篇就把这一格展开:为什么要同时养两个预测器、meta-predictor(元预测器)这个「裁判」怎么训练和裁决、开山之作 Alpha 21264 的具体参数长什么样,以及这套「多个专家 + 一个裁判」的思想如何在 TAGE 分支预测器 里以另一种形态延续至今。
本文要回答的问题
- 局部历史预测器和全局历史预测器各自擅长什么,为什么任何一个单独用都不够?
- 锦标赛预测器的三路结构(局部、全局、选择器)各自存什么、怎么索引?
- meta-predictor 的选择计数器是怎么训练的,「谁对听谁」的规则有没有例外?
- Alpha 21264 作为第一个商用锦标赛预测器,参数是怎么配的,为什么是它先想到?
- 锦标赛思想在今天的 TAGE、感知机预测器里留下了什么?
一、为什么一个预测器不够用:局部与全局的互补性
先把两位主角的本事说清楚。
局部历史预测器(local history predictor)记录的是「这条分支自己最近几次是跳还是不跳」。它对自身有周期模式的分支特别灵:一个跑 3 次就退出的内层循环,方向序列是 taken、taken、taken、not-taken 无限重复,只要记住这条分支自己的最近几次结果,模式表一索引,完美预测。经典结构是两级的:第一级是每条分支一个的历史寄存器(PHT,Pattern History Table 之前还有一级 BHT,Branch History Table),第二级用这段历史去索引两位计数器表。
全局历史预测器(global history predictor)记录的是「最近 N 条分支(不管是谁)的结果」,存在一条全局历史寄存器(GHR)里。它擅长的是分支间相关性:if (a > 0) ...; if (b > 0) ... 这类代码里,前一条分支的方向强烈暗示后一条的方向,因为两个条件在程序语义上相关。这种相关性看单条分支自己的历史是看不见的——每条分支自己都可能是无规律的,但它们的组合有规律。
麻烦在于,同一个程序里两类分支同时存在,而且比例随程序而变、随程序的执行阶段而变:
- 循环密集的数值计算代码(SPECfp 一类),局部模式多,局部预测器碾压全局;
- 分支链密集的控制流代码(gcc、解析器一类),分支间相关性多,全局预测器碾压局部;
- 更糟的是冲突:两类分支共享一张表时互相 hash 踩踏,谁都训不好。
面对这种「两种模式各有胜负」的局面,朴素的做法是押注其中一个,赌负载特性。1992 年 McFarling 在 DEC WRL 的技术报告里给出了更漂亮的回答:都养,再养一个裁判。这就是锦标赛预测器(tournament predictor)这个名字的由来——两个预测器像两名选手,每条分支来了都各自出招,由一个选择器(choice predictor,也就是本篇的主角 meta-predictor)裁决谁的预测算数,事后根据实际结果训练裁判「这类分支以后听谁的」。
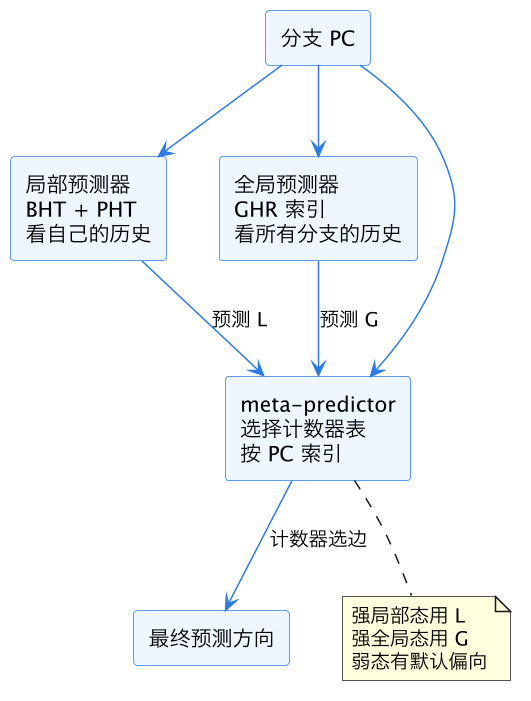
上图是锦标赛预测器的总骨架。三个部件并行工作:局部预测器、全局预测器各自给出方向,meta-predictor 根据这条分支的「历史战绩」决定采用谁。注意 meta-predictor 自己不预测方向,它预测的是「哪个预测器更可能说对」——这是它和普通预测器的本质区别,也是「meta」这个前缀的含义。
二、meta-predictor 的仲裁机制:一个两位计数器的选边游戏
meta-predictor 的结构出人意料地简单:就是一张用 PC 索引的两位饱和计数器表,和最早的方向预测器同款。区别只在语义——这里的计数器不表示「跳还是不跳」,而表示「该听局部的还是听全局的」。
两位计数器四个状态,通常这样解释:
| 状态 | 值 | 语义 | 采用谁的预测 |
|---|---|---|---|
| 强局部 | 00 | 这条分支历来局部准 | 局部预测器 |
| 弱局部 | 01 | 略倾向局部 | 局部预测器 |
| 弱全局 | 10 | 略倾向全局 | 全局预测器 |
| 强全局 | 11 | 这条分支历来全局准 | 全局预测器 |
训练规则是整套机制里最讲究的一笔,先记住一句话:只在两个预测器意见不一致时更新选择计数器。具体逻辑是:分支结果揭晓后,若局部对、全局错,计数器向「局部」方向饱和递增;若全局对、局部错,向「全局」方向饱和递减;若两个都对或两个都错,计数器原地不动。
为什么「都对」和「都错」不更新?这是容易被略过但非常深的设计考量:
- 都对的时候,听谁的都一样,这次结果不包含任何「谁更靠谱」的信息,更新只会引入噪声;
- 都错的时候,惩罚谁?错可能是这条分支本身难(随机性),不是哪个预测器的系统性劣势。把不可预测的噪声当成选边信号,会让选择计数器来回抖动,典型的过拟合。
换句话说,meta-predictor 学的不是「这次谁对」,而是「在两人有分歧的场合,谁的分歧意见更值得信赖」。这是统计上很干净的因果采样:只有分歧样本才携带区分两个模型的信息。这个思想后来被 TAGE 原样继承——TAGE 分支预测器 里 provider 和 alternate 的仲裁、useful 位只在「provider 与 alt 意见不同且 provider 对」时置位,都是同一个「只在分歧处计分」的原则。
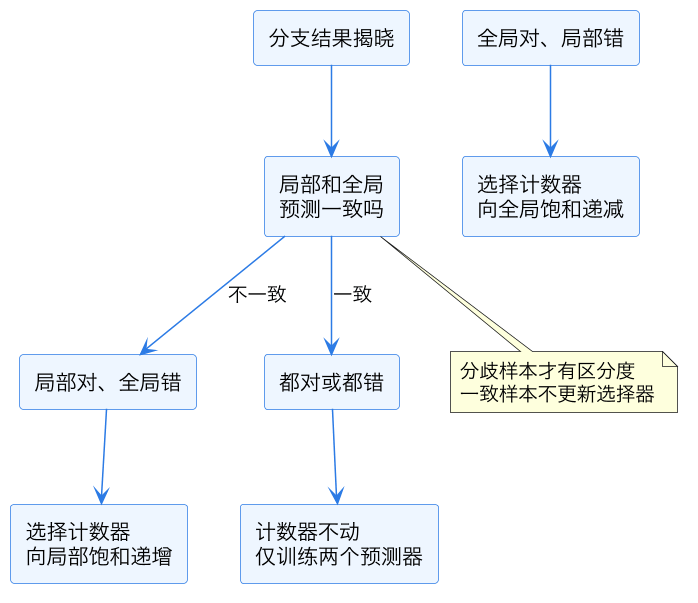
上图是选择计数器的训练数据流。注意最后一行「仅训练两个预测器」——无论选择器动不动,局部和全局两个方向预测器自己的两位/三位计数器每次都照常训练。选手要持续练功,裁判只在有争议时记分,两条更新线互不干扰。
三、Alpha 21264:锦标赛预测器的开山商用实现
纸面思想 1992 年就有了,但第一个把它做进量产芯片的是 1998 年的 DEC Alpha 21264(EV6)。这颗芯片在微架构史上地位极高——乱序、四发射、800MHz 目标,前端取指每周期要吞 4 条指令,分支预测错一次的代价是 7 级流水线清空。这么高的误预测成本,逼出了当时最激进的方向预测器。它的具体配置(Kessler 的公开论文里写得很全)值得逐个数:
| 部件 | 结构 | 容量 | 索引方式 |
|---|---|---|---|
| 局部历史表 BHT | 1024 项 × 10 位历史 | 10 Kb | PC 低位索引 |
| 局部模式表 PHT | 1024 项 × 3 位计数器 | 3 Kb | 局部历史索引 |
| 全局历史寄存器 GHR | 12 位 | 12 b | 所有分支共享 |
| 全局预测表 | 4096 项 × 2 位计数器 | 8 Kb | GHR 索引 |
| 选择器(meta) | 4096 项 × 2 位计数器 | 8 Kb | GHR 索引 |
总预算约 29 Kb,换算下来不到 4KB——今天看来小得可怜,但在 1998 年的 0.35μm 工艺上,这已经是取指通路里能挤出的极限。
几个参数细节很有嚼头。局部预测器用 10 位历史 + 3 位计数器:10 位足以覆盖迭代次数到 1024 的循环模式,3 位计数器(而非 2 位)让局部预测更「黏」,偶然的一次异常迭代不会立刻翻转预测。全局分量用 12 位 GHR,而选择器用 GHR 索引而不是 PC 索引——这是 21264 的一个微妙选择:「该听谁的」这件事本身也和全局上下文相关,同一条分支在不同的全局历史下可能适合不同的预测器。McFarling 原始论文里选择器按 PC 索引,21264 改成了按 GHR 索引,锦标赛模拟里证明后者在它的负载上更准。
效果数字也留下来了:21264 的方向预测在 SPEC95 上平均每千条分支误预测约 11-12 个,比单纯全局预测器低约 15-20%,比单纯局部预测器低约 30-40%。在 IPC 还没被缓存墙压垮的年代,这个差距直接换算成几个百分点的整机性能。
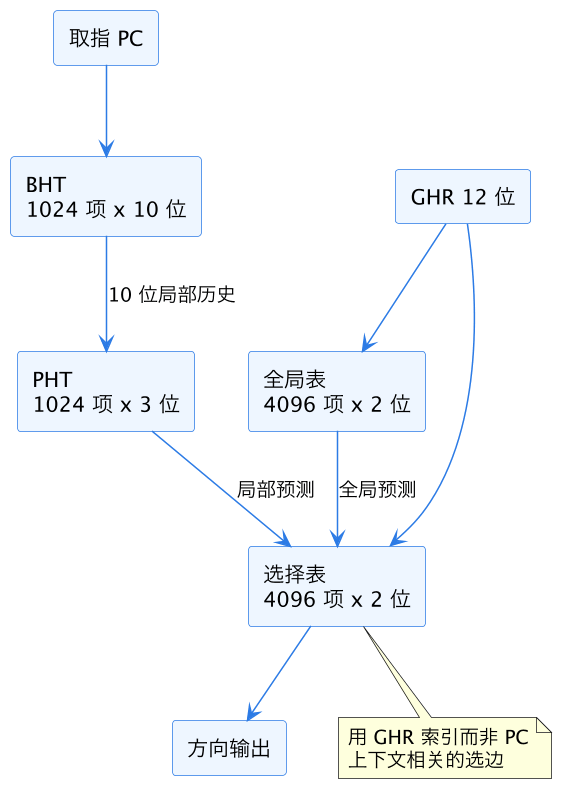
上图是 21264 的三路数据流,可以清楚看到两级局部结构(BHT 出历史、PHT 出预测)和全局、选择两表共享 GHR 索引的布局。这套图也是读现代处理器逆向分析文章的「识字卡片」——今天 AMD、Intel 的前端结构虽然复杂得多,但「多分量 + 仲裁」的骨架一眼就能认出来。
四、锦标赛的软肋与变体:裁判也会犯错
锦标赛预测器不是银弹,它的短板和它的优点一样清晰,而且每一条短板都直接催生了下一代技术。
软肋一:单长度的全局分量。 21264 的全局历史只有 12 位。和 分支预测 里讲过的死结一样:短了看不见长程相关,长了表项爆炸加历史污染。锦标赛机制能缓解(局部分量兜底),但不能根治——根治方案是把「一个全局分量」换成「一组几何级长度的全局分量」,这正是 TAGE 干的事。
软肋二:选择器本身的训练成本。 一条新分支进来,选择计数器从弱态开始,要经历好几次「分歧样本」才能收敛到正确的一边。训练期内选错边的误预测是锦标赛独有的开销——单一预测器没有这笔税。分支密度高的代码里,这笔税能吃掉锦标赛收益的一个角。
软肋三:两个选手可能都弱。 选择器只能在 L 和 G 之间挑一个,如果这条分支的模式两边都抓不到(比如既无自身周期、也无强全局相关的准随机分支),裁判再怎么选都是错。这类分支需要的是第三种结构——后来的感知机预测器(perceptron)用一组权重对历史的每一位投票,抓住了线性可分的模式;多层次分支预测 则用多个不同视角的分量叠加覆盖。
针对软肋二和三,学术界出过一批变体,值得一提的有两个:
- 偏向启动(biased choice):选择计数器的初始值不设为中性的弱态,而是按分支静态特征(方向、操作码)设一个先验偏向,缩短训练期。本质是给裁判一个「出身论」的初始印象。
- 三层锦标赛:在选择器之上再叠一个选择器,仲裁「听局部-全局胜者还是听第三个预测器」。锦标赛思想可以递归套用,代价是每多一层多一份面积和训练延迟。
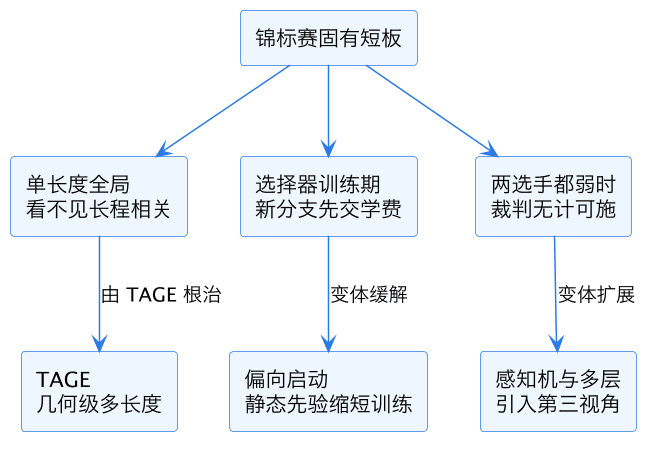
上图把三条短板和对应的演进路线放在了一起。可以说,1998 年之后分支预测器的主线剧情,就是围着这三条短板打补丁——看懂这张图,再看任何一篇现代预测器论文的 motivation 一节,都会觉得似曾相识。
五、从锦标赛到 TAGE:裁判思想的三种转世
锦标赛预测器作为具体结构,在 2000 年代中期之后就淡出了高性能核的正面战场(TAGE 家族的精度优势太明显),但「meta-predictor 仲裁」这个思想以至少三种形态活到了今天。
转世一:TAGE 的 provider/alt 与 USE_ALT_ON_NA。 TAGE 分支预测器 里,命中多张带 tag 表时,最长历史表当 provider、次长当 alternate,provider 计数器处于弱态时由一个全局统计器决定要不要改听 alt。这就是缩小版的选择器:裁判不再预测「L 还是 G」,而是预测「老师傅还是实习生」,训练原则同样是「只在分歧处计分」。
转世二:覆盖式多层预测的 L1/L2 仲裁。 现代高性能核普遍是「单周期小预测器 + 多周期大预测器」的覆盖结构:小预测器先出方向让取指不停,大预测器几个周期后出结果,若不一致就覆盖并付出前端气泡。这里没有一个显式的选择计数器表,但「大预测器是否有权推翻小预测器」的判断逻辑,扮演的正是 meta-predictor 的角色——只不过仲裁的依据从「历史战绩」变成了「结构信任度」。
转世三:统计校正器。 TAGE-SC-L 末尾那个感知机式的校正器,把主预测器的输出当成一个特征、再叠加其他弱特征投票,置信度不够就不动主预测——这是把「裁判」从二选一升级成了「全体特征合议」,meta-predictor 思想的终极形态。
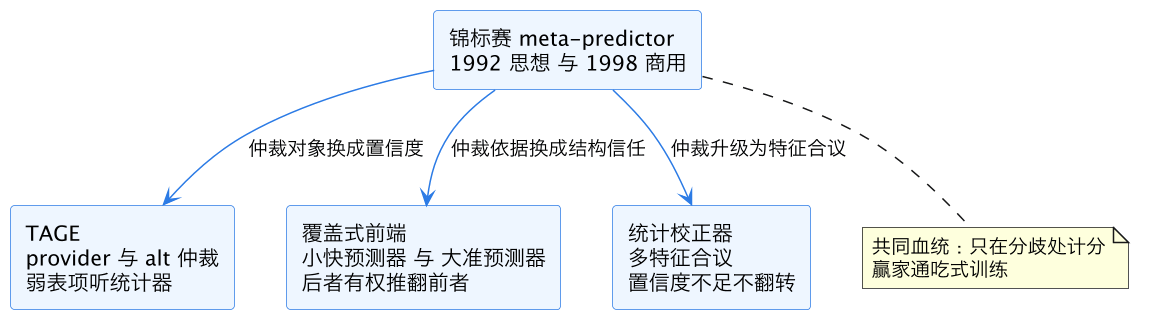
为什么这个思想如此长寿?因为它回答的是一个比分支预测更普遍的问题:当你有多个各有所长的模型时,如何花最小的代价组合它们。机器学习里这叫 ensemble,硬件里叫 tournament,思想同构。不同之处在于硬件的仲裁必须在 1-2 个周期内完成、状态必须投机更新——选择计数器在预测时读出的值要存进快照,误预测时和 GHR 一起从检查点恢复,这套机制和 重命名检查点与分支恢复、ROB 重排序缓冲 的提交回滚语义是同一套框架。另外别忘了硬币的另一面:任何「按历史选边」的逻辑都是可被训练的状态,Spectre 与 Meltdown 瞬态执行 类攻击恰恰会污染选择器,诱导受害者分支走上攻击者想要的投机路径——meta-predictor 也是攻击面。
这一篇在知识体系里的位置
本篇是微架构模块方向预测线里承上启下的一篇:上接 分支预测 的代际框架(两位计数器、局部、全局各自的来龙去脉),下接 TAGE 分支预测器 的几何级多长度世界。同线并行的还有目标地址侧三篇——BTB 分支目标缓冲、间接分支预测、返回地址栈 RAS,以及多层预测的极致形态 多层次分支预测。投机状态的快照与恢复见 重命名检查点与分支恢复 与 ROB 重排序缓冲;整条演进链的地图见 CPU 微架构总览。
总结
锦标赛预测器让局部历史预测器和全局历史预测器并行出招,再用一张按上下文索引的两位饱和计数器表当 meta-predictor 动态选边,裁判只在两个选手意见分歧时按谁对谁错更新——这套「多专家并行 + 分歧处计分 + 赢家通吃训练」的仲裁机制由 Alpha 21264 首次商用落地,虽有单长度全局、训练期学费、双弱无解三条短板,但其 meta-predictor 思想在 TAGE 的 provider/alt 仲裁、覆盖式前端和统计校正器里转世至今,是理解一切现代分支预测器的必修前传。