TLB shootdown:改一次页表为什么要广播失效,以及它的性能代价与优化
承 tlb-two-level-stlb-design 与 tlb-pagewalk-cache——那两篇讲的是 TLB 命中路径怎么快、页表遍历怎么省,但刻意回避了一个相反方向的问题:当内核要作废一条映射时,散落在几十个核的 TLB 里的旧条目怎么办? 答案就是 TLB shootdown(TLB 击落):发起核向所有可能缓存了旧映射的核广播失效请求,逐个核等它们清完 TLB 再继续。这是虚拟内存系统里最昂贵的跨核操作之一,也是
munmap频繁抖动的服务在多核机器上性能莫名崩塌的常见元凶。
本文要回答的问题
- 改一次页表,为什么本核
INVLPG一条指令不够,非得惊动其他核? - 一次 shootdown 从触发到完成,硬件和软件各走了哪几步?
- 性能代价具体有多大,什么负载形态会被它拖垮?
- 内核做了哪些延迟批处理优化,它们各自牺牲了什么换什么?
一、问题的起点:TLB 是分布式副本,页表才是唯一真源
先钉死一个基本事实:页表在内存里只有一份(真源),但每个核的 TLB 各自缓存了其中若干条目的拷贝(副本)。这和缓存一致性问题的结构一模一样,只是对象从缓存行换成了地址映射。当内核执行 munmap、页面回收、写保护升级(比如 fork 后的写时复制 arm)等操作时,页表项被改掉了,可其他核的 TLB 里可能还躺着旧翻译——那些核此刻正在用旧映射欢快地访问物理页。
危险在哪?举个最具体的例子:进程 A 把一段地址 munmap 掉,内核把那几页物理内存回收、转手分配给了进程 B。如果某个核的 TLB 里还残留进程 A 旧映射,它写这段地址的数据就会直接写进 B 的物理页——这不是性能问题,是跨进程的数据损坏。所以正确性要求是硬性的:页表修改完成、物理页可被复用之前,必须保证全系统没有任何 TLB 再持有这条旧映射。
为什么不在硬件层做一致性,像 MESI 那样自动同步?成本。TLB 命中是关键路径上每一拍都要做的事,给它挂一套监听或目录机制(见 coherence-directory-vs-snoop 的协议讨论)面积和功耗都吃不消,而且页表修改的频率远比数据访问低。于是 x86 的选择是:硬件只提供单核失效原语,跨核一致性完全甩给软件——这就是 shootdown 存在的理由。
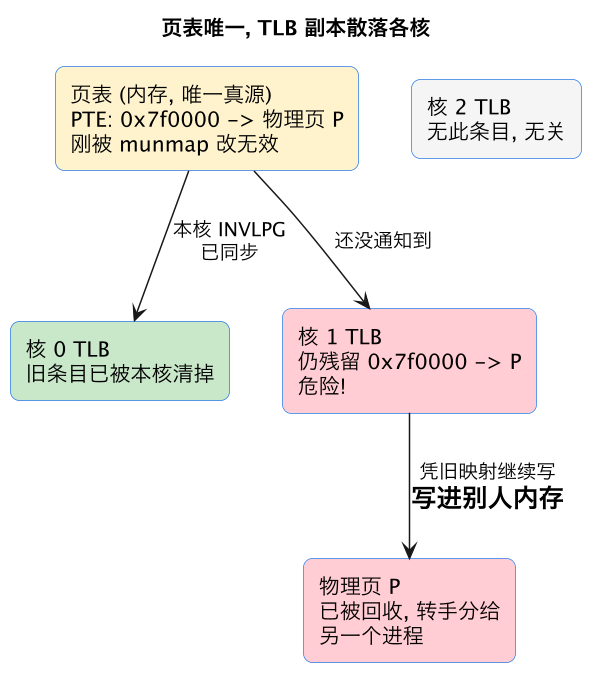
这张图里唯一的麻烦制造者是核 1:它的 TLB 是私有的,没有任何硬件机制能替它注意到页表变了。shootdown 的全部工作,就是找到所有"核 1",逼它们在物理页 P 被复用之前把旧条目吐出来。
二、触发时机与硬件原语:INVLPG 只管本核
哪些内核操作会触发 shootdown?梳理一下主要来源:
| 触发操作 | 典型系统调用 | 失效范围 | 频率特征 |
|---|---|---|---|
| 解除映射 | munmap / mremap | 一段地址区间 | 抖动负载下每秒成千上万次 |
| 写保护降级 | mprotect(PROT_READ)、fork 的 COW arm | 单页或区间 | fork 风暴时密集 |
| 页面换出 | 内存回收路径 | 单页 | 内存压力下持续 |
| 大页拆分 | THP split(见 THP 专题) | 一个 2MB 大页 | 取决于混合负载 |
| 页迁移 | NUMA balancing 自动迁移 | 单页 | 周期性 |
硬件侧,x86 提供的失效原语严格限定在本核范围内:
INVLPG addr:作废本核 TLB(以及 paging structure cache,见 tlb-pagewalk-cache)中翻译该虚拟地址的所有条目。注意它跨 ASID/PCID 生效——粒度虽细,火力不小。- 写
CR3(切地址空间):默认冲刷本核全部 TLB;启用 PCID 后可以保留,靠 PCID 标签隔离。 - 写
CR4/CR0相关位:全核 TLB 全冲,最重的一档。
也就是说,发起核修改页表后,自己能 INVLPG 干净利落,但对远端核的 TLB 一条指令都够不着。要让核 1 清条目,唯一的办法是让核 1 自己执行 INVLPG——而让一个正在跑用户代码的核停下来执行内核的指令,只有一个通道:中断它。
三、完整流程:IPI 串起来的五拍
Linux 的 shootdown 主路径(native_flush_tlb_others 一族)是一次典型的"发起者-响应者"协议,共五拍:
- 发起核本地修改:改页表项,本核
INVLPG,把物理页挂到"待释放"队列——注意此刻还不能真释放。 - 算出目标掩码:查
mm_struct->cpu_vm_mask,这个掩码记录"哪些核的 TLB 可能缓存过本地址空间的映射"(即该进程最近在哪些核上运行过)。掩码有多大,广播面就有多大。 - 发 IPI:通过 APIC 向掩码里每个核发一个核间中断(Inter-Processor Interrupt),带上失效函数指针和地址区间。
- 目标核响应:每个目标核在 IPI 处理函数里执行
INVLPG(或按区间大小选择全冲),然后递减共享计数器。 - 发起核等齐并收尾:发起核自旋等待计数器归零——这一步是同步等待,不等完不能走——然后才真正释放物理页。
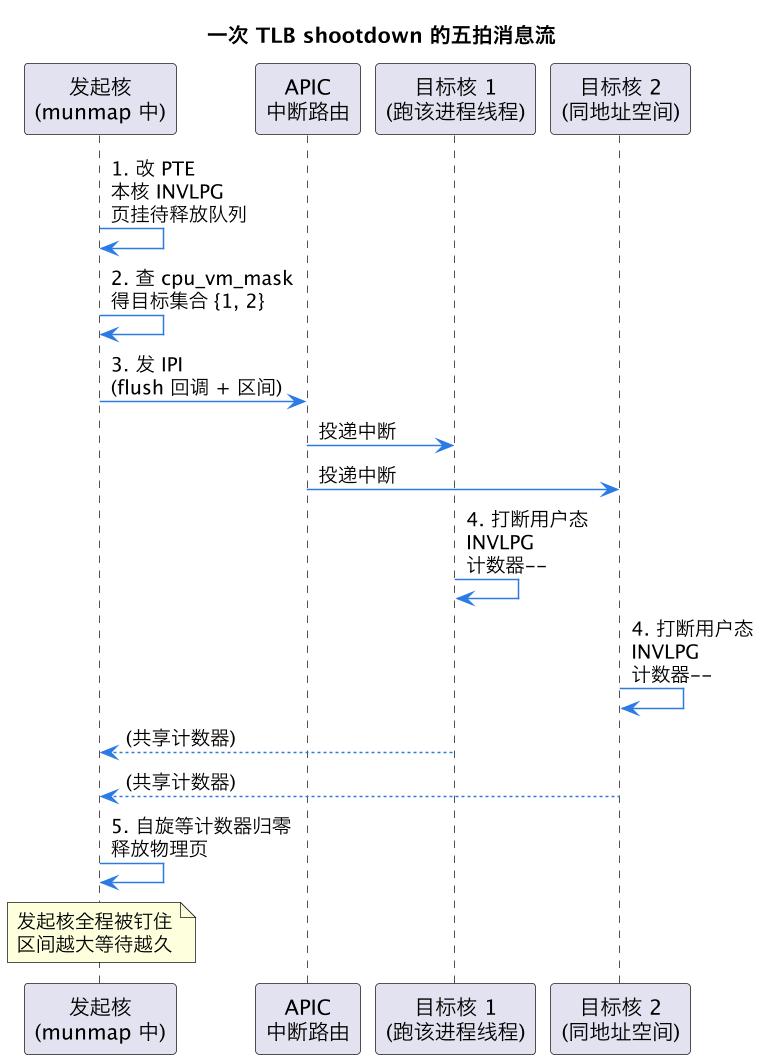
这张时序图里最刺眼的是第 5 拍:发起核在自旋等待里白白烧时间,等待时长由最慢的那个目标核决定。如果目标核正在关中断的临界区里、或者干脆在另一个虚机上被 hypervisor 抢走了 vCPU,发起核就得干等——一次 shootdown 从正常的几微秒恶化到上百微秒并不罕见。而被中断的目标核也没占到便宜:它被打断、清 TLB、恢复现场之后,接下来一段时间内所有 TLB miss 都会变多,因为刚清掉的条目要重新 walk 回来。
四、性能代价:谁在为 shootdown 付账
把账算细,一次 shootdown 的成本由四块构成:
| 成本项 | 谁付 | 量级 | 随什么增长 |
|---|---|---|---|
| IPI 发送与处理 | 发起核 + 每个目标核 | 单次几微秒 | 目标核数线性 |
| 发起核自旋等待 | 发起核 | 等于最慢目标核的响应时间 | 核间干扰、虚拟化 |
| 目标核被中断 | 目标核 | 现场保存 + IPI 处理几微秒 | 与业务争抢 |
| 失效后 TLB 重填 | 所有被清的核 | 每次 miss 一次 page walk | 区间大小、工作集 |
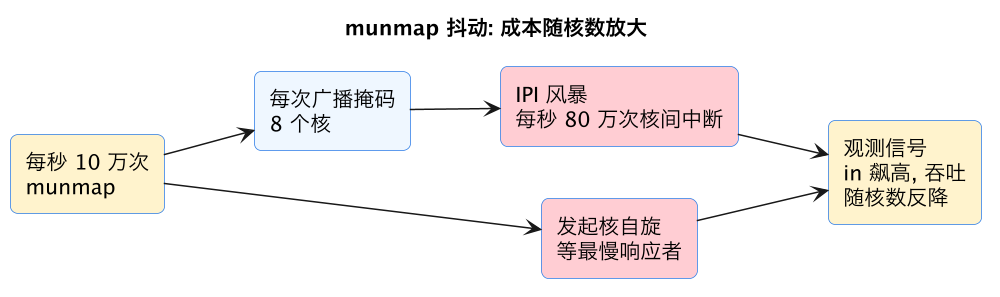
单次几微秒听起来微不足道,但负载形态会把它放大成灾难。经典的重灾区是短生命周期映射的高频抖动:JVM 堆栈页、某些数据库的临时映射、用户态内存分配器(如 jemalloc 的 huge page 归还)疯狂 mmap/munmap 的服务。一个 64 核机器上每秒 10 万次 munmap、每次广播 8 个核的场景,意味着每秒 80 万次 IPI 和发起核累计上百毫秒的自旋——perf top 里会看到 native_flush_tlb_others、smp_call_function_many 这类符号吃掉可观的 CPU,vmstat 的 in(每秒中断数)异常飙高。这就是有名的"munmap 抖动"病症:吞吐随核数不升反降,因为核越多,每次 shootdown 的广播面越大、等齐越慢。
还有一个隐蔽的放大器:透明大页(THP)的拆分。一个 2MB 大页被拆成 512 个 4KB 页时,失效范围是整个大页,一次 shootdown 废掉 512 页翻译;反过来如果用 INVLPG 逐页失效 512 次,又是 512 次广播。内核对这种区间的策略是"超过阈值直接全 TLB 冲刷"——单核全冲一次代价约等于几十次逐页失效,区间大时反而划算。这个"逐页失效还是全冲"的临界点选择,本身就是 shootdown 路径里的一处微优化。
五、软件优化:晚一点、凑一批、躲几核
既然正确性红线是"物理页复用之前失效必须完成",而大部分场景并没有立刻复用物理页,优化空间就全在这个时间差里。Linux 一路演化出的手段可以归为三类:
第一类:批处理,把 N 次广播压成 1 次。 munmap 一个大区间时,不是每改一个 PTE 就 shootdown 一次,而是先把整段 PTE 全部改完,攒到最后发一次覆盖整个区间的广播——目标核收到后按区间冲刷,一次 IPI 解决全部。这就是 tlb_gather_mmu / tlb_finish_mmu 这一对 API 存在的意义:前者开始攒批,后者统一结算。页面回收路径同理,mmu_gather 攒一批待释放的页,统一失效后统一释放。
第二类:延迟,把"立刻失效"改成"需要时再失效"。 代表性的有两招。一是物理页先进 per-cpu 页框缓存(PCP list)或惰性释放队列,真正回收复用前的最后一刻才确认 shootdown 完成;二是 ARM 生态推动的 tlbi 延迟语义 和 x86 侧的懒失效讨论——核心思想相同:只要没人急着用这块物理内存,旧 TLB 条目就让它躺着,反正它只会在访问时才造成危害,而访问旧映射的前提是该地址空间还活跃。
第三类:收窄广播面,能不惊动的核一个都不惊动。 这是最工程化的一类:
- 精细掩码:
cpu_vm_mask只在进程切换进某核时置位,配合惰性失效(lazy TLB mode),内核线程借道运行时可以不参与失效; - 隔离核避让:被
isolcpus隔离、跑实时任务的核若不在掩码里,shootdown 与它们零交集——这是实时部署的标准动作; - PCID 保条目:失效只针对特定地址空间时,不清其他 PCID 的条目,目标核切回原进程后 TLB 热度还在;
- 投机跳过:发起时发现掩码里没有"正在运行"的核(该地址空间此刻没在任何核上执行),可以直接跳过 IPI,只做惰性标记。
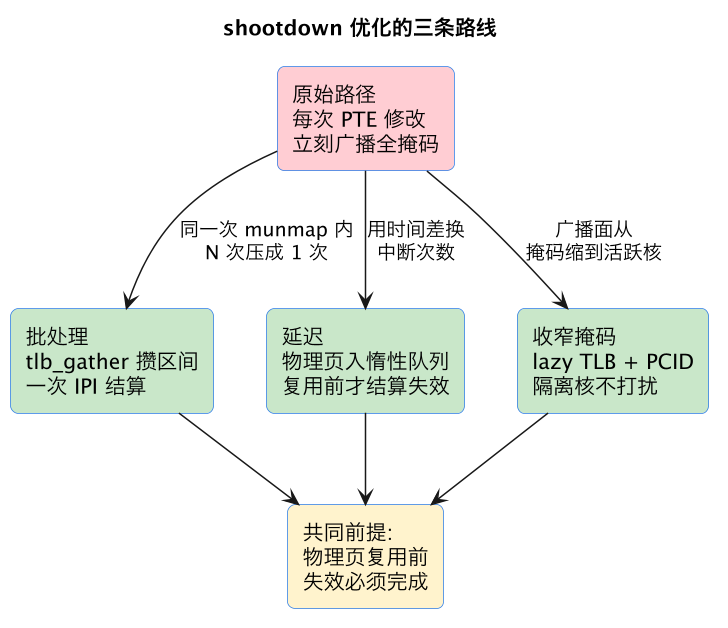
三条路线共享同一个安全底线,就是图底部那条:无论怎么拖、怎么省,物理页被写上别人的数据之前,旧 TLB 条目必须死透。所有优化都是在这条线的上方腾挪。
六、观测与自查:怀疑 shootdown 捣乱时看什么
工程上定位 shootdown 问题,按这个顺序查:
- 中断计数:
vmstat 1看in列,纯计算负载下每秒数万以上就值得怀疑;/proc/interrupts里的 IPI/RES(reschedule)和 TLB flush 相关行(不同内核版本名字不同,常见TLB或CAL)逐秒增量最直接。 - 内核符号:
perf top或perf record里native_flush_tlb_others、flush_tlb_mm_range、smp_call_function_many合计超过 2% CPU,基本坐实。 - tracepoint:
tlb:tlb_flush事件能直接看到每次失效的地址区间、页数和原因,是区分"逐页失效过多"还是"全冲过多"的利器。 - 应用侧对照:
strace -c统计munmap/mprotect调用频率,与上面的内核证据互相印证——高频mprotect同样会走 shootdown,别只盯着munmap。
还有一类容易误判的场景值得点名:虚拟化环境。宿主机调度走 vCPU 的时间窗里,这个核对 IPI 毫无感知,发起核的自旋等待会被拉长到毫秒级——perf kvm 或宿主机侧的 vCPU steal 指标能证实这一点。此时 shootdown 问题的根因不在客户机内部,而在宿主机的过订阅,调低单机 vCPU 密度比改客户机内核参数有效得多。
确认病灶后的缓解手段也分两层:应用层减少映射抖动(分配器开 MADV_FREE 策略、jemalloc 调 dirty decay、避免高频 mprotect),系统层把实时线程绑到 isolcpus 隔离核上躲开广播面。这两层的配合思路与 cpu-microarch-overview 里"把干扰源从关键核上移走"的总原则一脉相承。
这一篇在知识体系里的位置
本篇属于微架构层"TLB 专题"里讲一致性维护的一篇,与讲命中快路径的两篇互补:
- tlb-two-level-stlb-design:TLB 的两级结构怎么设计来追命中率;本篇回答"这些条目什么时候必须被杀死"。
- tlb-pagewalk-cache:页表遍历缓存的加速机制;
INVLPG会连带冲刷它,两篇合起来才是完整的失效语义。 - coherence-directory-vs-snoop:缓存一致性用硬件协议自动维护;TLB 不走这条路、靠软件 shootdown,正是该篇"为什么 TLB 不做硬件一致性"的注脚。
- cpu-microarch-overview:微架构全景导读,本篇是其中"地址翻译"分支的一环。
总结
TLB shootdown 是页表修改后内核向所有持有旧映射副本的核广播 TLB 失效的跨核协议:硬件只给本核
INVLPG,跨核全靠 IPI 中断逼目标核自己动手,发起核还要自旋等齐才能释放物理页——单次几微秒的开销在 munmap 抖动、THP 拆分这类负载下会放大成 IPI 风暴和随核数反降的吞吐;内核的对策是批处理(攒区间一次结算)、延迟(物理页复用前才失效)和收窄广播面(精细掩码、PCID、隔离核避让),三条路线共享同一条底线:物理页被复用之前,旧 TLB 条目必须死透。