NoC credit 流控:片上网络靠什么保证路由器缓存永不溢出
承 NoC 片上网络与路由器——那一篇讲了路由器的五级流水(路由计算、虚通道分配、开关分配、交叉开关、链路传输)怎么把一个 flit 从进口搬到出口,但刻意跳过了一个前提:下游凭什么敢收这个 flit? 片上网络不允许丢包——丢一个 flit 就意味着缓存一致性消息或内存响应消失,系统直接死锁或数据损坏。所以相邻路由器之间必须有一套「下游没位置、上游就不发」的机制,这就是流控。片上网络里最主流的答案是 NoC credit 流控(credit-based flow control,基于信用额的流量控制):下游预先告诉上游自己还有几个空槽位,上游每发一个 flit 扣一张票,票用完了就停发。虚通道怎么在这套机制上复用见 NoC 虚通道与 QoS,本篇聚焦 credit 机制本身:它怎么工作、buffer 要开多深才够用、吞吐在哪个点塌掉、以及和更省面积的 on/off 流控怎么选。
本文要回答的问题
- credit 流控的一次完整「发 flit、还 credit」循环长什么样,为什么它天然不会溢出?
- credit 环路 turnaround 时间由哪几段组成,为什么它决定了 buffer 的最小深度?
- 负载升高时吞吐在哪个利用率拐点塌下来,和 buffer 深度是什么定量关系?
- on/off(XON/XOFF)流控省掉了一半状态线,代价是什么、什么场景值得换?
- 虚通道引入之后,credit 要按 VC 分开记账,这对实现和死锁有什么影响?
一、为什么片上网络不能靠「重传」过日子
互联网的老经验是「发出去再说,丢了重传」——TCP 就是靠超时重传和滑动窗口在不可靠链路上跑出可靠传输。这套思路搬到片上网络立刻撞墙,原因有三个。
第一,延迟预算完全不同。一次片内 cache miss 全程也就几十纳秒,其中 NoC 传输通常只分到 5~20 纳秒;一个 flit 走 3~5 跳,每跳只能容忍 1~3 拍。丢包重传意味着检测到丢失(超时)加上重发,动辄几十拍,直接把整条内存访问路径的延迟翻倍——这在微架构上是不可接受的。
第二,消息语义不允许重排和复制。片上跑的是缓存一致性协议(见 目录与监听一致性),Invalidate、Ack、Data 之间有严格的因果关系;一个 flit 悄悄丢了,协议状态机可能就永远等不到那条 Ack,表现形式是系统挂死而不是性能下降。片上网络的正确性要求是「恰好一次、按序到达」,这比以太网的「尽力而为」苛刻得多。
第三,片上没有「大缓存」这回事。路由器输入端口的 buffer 是宝贵的 SRAM/触发器资源,一个典型深度只有 4~16 个 flit,每条虚通道独立一份。缓冲这么浅,意味着「下游满了」不是小概率事件,而是中负载下的日常;流控机制必须在拍级粒度上反应,任何迟缓都直接变成溢出。
结论:片上网络流控必须是无损的、预防式的——在上游 flit 出发之前,就必须确定下游有位置接它。能满足这个要求的机制主要有两家:credit 流控和 on/off 流控,本篇的主角是前者。
二、credit 流控的工作循环:一张票一个 flit
credit 流控的思想朴素得像停车场:管理员(下游路由器)手里有一把车位牌,数量等于自己的空槽位数;每个进场的车(flit)要拿一张牌才能进,出场(flit 被下游消费、槽位腾空)后牌还给管理员。牌永远不多不少,所以车位永远不会被超额占用。
映射到硬件上,记账方在上游:下游路由器 R1 的输入 buffer 深度假设为 8,上游路由器 R0 维护一个计数器 credit_count,初始值就是 8。每拍的工作规则只有两条:
- R0 有 flit 要发,且
credit_count > 0:flit 上链路,credit_count减一; - R1 消费掉一个 flit(它被交换到输出端口、输入槽位腾空):通过一条反向的 credit 信号线通知 R0,
credit_count加一。
反向 credit 信号是这套机制的全部额外连线开销——每个方向一条一位宽的「归还脉冲」,或者用专门的 credit flit 捎带。整个系统的美妙之处在于不变式:任意时刻,链路上在途 flit 数 + R1 buffer 已占槽位 + R0 手里的 credit 数 = 8(buffer 总深度)。既然三者加起来恒等于 8,buffer 占用就永远到不了 9,溢出在数学上被排除了。
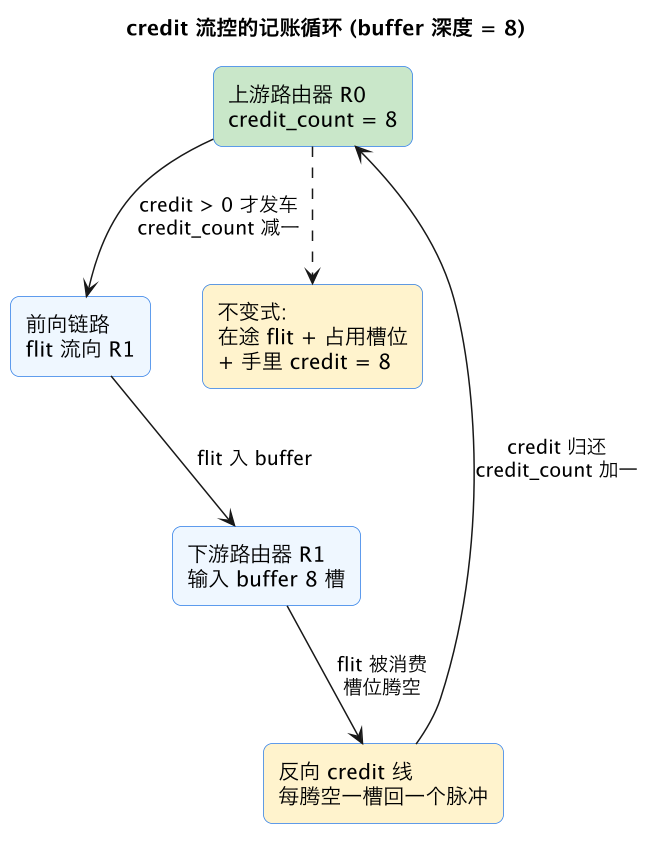
这张图里最容易被忽视的是那个「不变式」卡片——它不是装饰,而是 credit 机制安全性的全部证明。任何一拍把三个量加起来都得到 buffer 深度,就意味着拥塞只会表现为「上游 credit 归零、停发等待」,而永远不会表现为「下游接不下」。拥塞被优雅地反压(backpressure)回源头,这正是片上网络想要的性质。
对比握手机制可以更清楚 credit 的定位:valid/ready 握手(见 valid-ready 握手协议)是「每拍现问现答」——ready 拉高这拍才能传,它对「ready 信号本身的传播延迟」极其敏感,一拍线延迟就意味着一拍气泡;credit 则是「预支额度」,下游一次性把 8 个槽位的许可批发给上游,上游在额度内可以连续发车不看任何人脸色,只有额度耗尽才停。这是用一点状态(计数器)换取对链路延迟的容忍,这个取舍正是下一节定量分析的主题。
三、turnaround 时间:buffer 深度的下限从哪来
credit 机制有一个隐藏的前提:上游手里的 credit 必须反映下游「此刻」的空槽情况,但信号传播需要时间。从「R1 腾空一个槽位」到「R0 的 credit_count 真正加一」之间隔着一个 credit 环路延迟,也叫 turnaround 时间(往返周转时间)。它由四段组成:
| 段落 | 内容 | 典型量级 |
|---|---|---|
| 前向链路传播 | flit 从 R0 输出寄存器走到 R1 输入寄存器 | 1~2 拍(含线上流水线寄存器) |
| 下游处理与腾空 | flit 过路由流水、被交换出去、槽位释放逻辑 | 1~3 拍 |
| 反向 credit 传播 | 归还脉冲从 R1 走回 R0 | 1~2 拍 |
| 上游记账与恢复发车 | credit 更新、调度器重新放行 | 1 拍 |
四段加起来,典型 mesh NoC 相邻路由器之间的 turnaround 约 4~8 拍。这个数字直接给出 buffer 深度的下限公式:
buffer 深度 ≥ turnaround 拍数 × 每拍想发的 flit 数
推导很直白:假设 buffer 只有 4 深而 turnaround 是 8 拍。上游连发 4 个 flit 后 credit 归零、停发;这 4 个 flit 到达下游被消费后,归还的 credit 要再过若干拍才能回到上游。也就是说,即使链路物理上每拍能传一个 flit,上游每 8 拍里也只有 4 拍能发车——链路利用率被锁死在 50%。buffer 深度不够时,瓶颈不再是链路带宽而是「票回得太慢」,这是一种隐蔽的、由流控机制自己制造出来的带宽损耗。
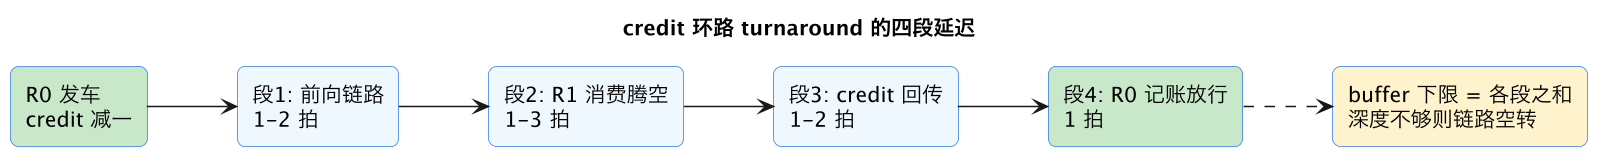
工程含义是:buffer 不是越深越好也不是越省越好,先算 turnaround,再留裕量。这也是为什么长距离链路上要插流水线寄存器(中继站)时,设计师必须同步加深两端 buffer 或在中继点之间也建 credit 环——链路每多一拍延迟,turnaround 就多两拍(去一回各一拍),buffer 下限随之上涨。FIFO 深度设计的一般方法(含突发与速率差的折算)见 FIFO 深度设计,NoC 场景是它的一个特例:这里的「读写速率差」是由环路延迟人为造出来的。
四、吞吐拐点:拥塞是怎么发生的
有了 credit 和足够深的 buffer,单条链路看起来万事大吉。但 NoC 是一张网,不是一根线——当全网注入率升高,buffer 开始被多个流竞争占用,吞吐曲线会经历一个经典的非线性拐点。
典型的均匀随机流量下,mesh 网络的吞吐-注入率曲线分三段:低载区吞吐随注入率线性上升(网络空闲,flit 随到随走);接近饱和区时延迟开始飞涨,吞吐增速放缓;越过饱和点后吞吐不再增长甚至下跌——热点方向的 buffer 全部被占满,credit 长期归零,拥塞沿反压链路向上游扩散,像堵车一样从路口蔓延到整条街。均匀随机流量下 2D mesh 的饱和点大约在网络容量的 50%~70%;换成热点流量(所有核都访问同一个内存控制器)可能 30% 就塌。
buffer 深度对这个拐点的定量影响值得单独说:更深的 buffer 把拐点向右推,但推不动天花板。深度从 4 加到 16,饱和吞吐可能从 55% 提到 65%,因为深 buffer 能吸收瞬时突发、让上游不至于频繁断票;但网络的根本瓶颈是拓扑的对分带宽(bisection bandwidth)——mesh 中间那条假想切口能过多少 flit 是物理上限,buffer 再深也存不下持续超过对分带宽的流量,只是把排队从「立刻堵」变成「慢慢堵满再堵」。这也是为什么提升饱和吞吐的正解是加虚通道(缓解队头阻塞,见 NoC 虚通道与 QoS)、改拓扑或提链路频率,而不是无脑堆 buffer。
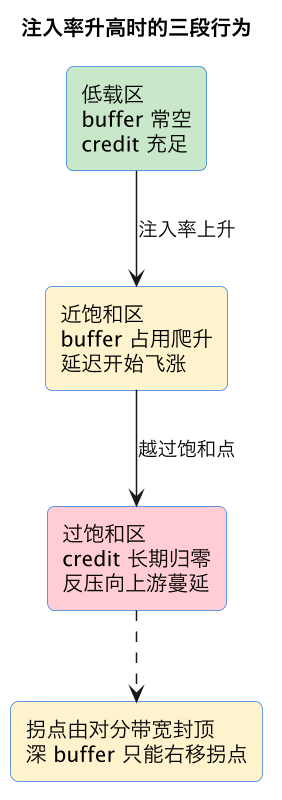
对做性能分析的人,这张状态图有个直接可观测的投影:NoC 拥塞时,受害的不仅是拥塞流本身——共享 buffer 和交叉开关的无辜流延迟一起恶化。在现代服务器上这表现为 LLC miss 延迟方差变大、NUMA 远端访问长尾拉长,uncore 计数器里能看到 mesh 端口阻塞周期数上升。Ring 与 mesh 拓扑在这方面的行为差异见 uncore ring 与 mesh 互连。
五、与 on/off 流控的对比:省线的代价
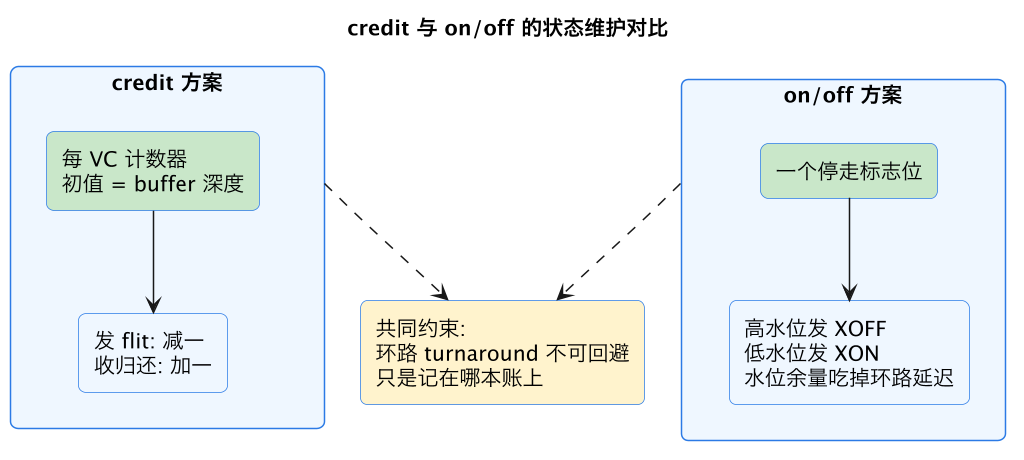
credit 流控不是唯一答案,它最常见的竞争对手是 on/off 流控(也叫 XON/XOFF 流控):下游不做精细记账,只在 buffer 占用超过高水位时向上游喊一声「停」(XOFF),回落到低水位再喊「走」(XON)。对比维度如下:
| 维度 | credit 流控 | on/off 流控 |
|---|---|---|
| 反向信号 | 每腾空一槽一个脉冲(或周期捎带) | 只有越水位两条消息,量极少 |
| 上游状态 | 每 VC 一个计数器 | 一个停/走触发器 |
| 带宽利用率 | 额度内连续发车,可达满带宽 | 停走之间存在环路空窗,需要更深 buffer 掩盖 |
| buffer 需求 | ≥ turnaround | ≥ turnaround + 水位迟滞余量,通常更深 |
| 突发平滑 | 额度天然限速,逐 flit 公平 | 停走切换引起批量突发,延迟抖动更大 |
| 实现复杂度 | 记账逻辑多,验证点多 | 逻辑极简 |
| 适用场景 | 主数据面,带宽敏感 | 低频控制通道、面积极端受限的边角路径 |
on/off 最大的坑是水位设计本身就是一道 turnaround 计算题:XOFF 从下游出发到上游真正停发,中间隔着一个环路延迟,这段时间里上游还在按每拍一个 flit 继续灌——高水位必须预留「环路延迟 × 每拍 flit 数」的吸收空间,否则照样溢出。换句话说,on/off 并没有消灭 turnaround 约束,只是把它从「buffer 下限」挪进了「水位余量」里,而且还要额外付迟滞余量防止在高水位附近抖动(XON/XOFF 频繁振荡)。总账算下来 buffer 往往比 credit 方案还要深,省下的只是反向信号线和一点记账逻辑。
业界还有一个远亲:UART 的 RTS/CTS 硬件流控(见 UART 硬件流控 RTS/CTS)本质上就是 on/off 流控在板级串口上的化身——RTS 拉低就是 XOFF。它在每秒百万比特的串口上工作得很好,因为对方发送端反应慢、线延迟占比小;搬进拍级粒度、每拍一个 flit 的 NoC 里就水土不服了。这个对比也说明一件事:流控机制的选型不是「哪种先进」,而是「环路延迟占服务间隔的比例」——比例越小,粗粒度的 on/off 越划算;比例逼近或超过 1(片上网络正是如此),只有 credit 这种逐 flit 预支额度的机制能跑满带宽。
六、虚通道时代的 credit:按 VC 分账与死锁防线
前面为了叙述干净,一直假设一个端口一个 buffer。真实 NoC 里每个输入端口挂着多条虚通道(virtual channel,VC),每条 VC 有自己独立的 buffer 队列,共享同一根物理链路——目的有两个:缓解队头阻塞(一条流被堵不拖垮其他流),以及给协议不同消息类(请求/响应/监听)各走各的道,掐断协议级死锁的环路依赖。
VC 一引入,credit 记账必须跟着分家:每条 VC 一套独立的 credit 计数器,上游为下游的 VC0、VC1 各记一本账。反向 credit 信号也要带上 VC 编号(归还的是哪条 VC 的槽位),这就是为什么真实设计里 credit 回传常用「脉冲 + VC id」的编码,或者干脆攒成专门的 credit flit 批量捎带。实现代价随之上涨:N 条 VC 就需要 N 个计数器和 N 份账目一致性验证,crossbar 调度器也要在「有 flit」与「对应 VC 有 credit」两个条件同时满足时才放行——VC 分配和 credit 检查是开关分配级流水里的两个串联关卡,任何一个不满足,flit 这拍就走不了。
分账还有一个不那么显然的好处:它把反压粒度从「端口」细化到「VC」。端口级流控下,一条 VC 堵了会连累同端口所有 VC(它们的 flit 排在同一个物理队列里,链路停发人人挨饿);VC 级 credit 下,堵住的只是那一条 VC 的账目,其他 VC 的 credit 照常流通、照常发车——这正是 QoS 隔离(高优流不被批量流拖死)能在流控层落地的机制基础。
最后必须提一句死锁。credit 保证「不溢出」,但不保证「永远能动」:如果全网形成一个 flit 互相等待的环(A 等 B 的 buffer、B 等 C、C 等 A),每个节点 credit 都合法、每个 buffer 都没溢出,但没有任何 flit 能前进一步——这是路由层面的循环等待死锁,和流控机制正交。工程上的标准解法是转向限制路由(如维序路由,禁止某些转弯,从拓扑上掐掉环)或逃生 VC(专设一条走无环路由的 VC,死锁时流量倒进逃生道)。这两条防线和 credit 机制叠加,才构成一个「不丢、不堵死」的完整 NoC。
这一篇在知识体系里的位置
本篇属于 NoC 专题的「流控层」,向上承接路由器微架构,向下支撑 VC 与 QoS 的隔离语义:
- NoC 片上网络与路由器:路由器五级流水与交叉开关,本篇的 credit 检查就嵌在开关分配级里。
- NoC 虚通道与 QoS:VC 复用物理链路与服务等级仲裁,本篇解释了它底层的按 VC 分账机制。
- valid-ready 握手协议:拍级现问现答的流控,与本篇的预支额度模式互为对照。
- FIFO 深度设计:buffer 深度折算的一般方法,本篇的 turnaround 公式是其在 NoC 场景的特例。
- UART 硬件流控 RTS/CTS:on/off 流控在板级链路的化身。
- uncore ring 与 mesh 互连 与 目录与监听一致性:NoC 之上的拓扑选择与协议流量,流控拥塞的可观测表现在这两篇的应用层视角里出现。
总结
NoC credit 流控用「下游预发车位牌、上游凭票发车」的记账不变式(在途 flit 加占用槽位加剩余 credit 恒等于 buffer 深度)从数学上杜绝了路由器缓存溢出;它的全部设计题围绕一条 turnaround 环路展开——buffer 深度下限等于环路拍数乘以每拍发车数,深度不够则链路空转、吞吐拐点提前,深度足够也只把饱和点右移而无法突破对分带宽的天花板;与 on/off 流控相比,credit 用每 VC 一个计数器的代价换来满带宽和细粒度反压,是拍级粒度片上网络的主数据面正解,而 on/off 省线省逻辑但水位余量反而更吃 buffer,只适合环路延迟占比小的低频通道;虚通道时代 credit 按 VC 分账,再叠加转向限制路由或逃生 VC 防死锁,才凑齐片上网络「不丢、不堵、不锁」的完整拼图。