MPK 内存保护键:PKU 页表保护键的权限切换成本、WRPKRU 序列化与用户态隔离用例
更新时间:2026-10-04。改一段内存的访问权限,传统路线是
mprotect:一次系统调用进内核、校验区间、改页表项、刷 TLB,开销动辄几千个周期,多线程场景还要触发 TLB shootdown(跨核失效广播,见 TLB 失效广播与 shootdown),代价上万周期。MPK 内存保护键(Memory Protection Keys,Intel 叫 PKU,Protection Keys for Userspace)给了另一条路:页表项里塞进 4 位键编号,每个线程带一个 32 位的 PKRU 寄存器记录对 16 个键的读写开关,用户态一条WRPKRU指令就能翻转自己视角下整组页面的权限——不进内核、不动页表、不刷 TLB。代价是这条指令有序列化语义,会把流水线排空。本篇属于微架构模块「内存保护线」,上游铺垫见 CPU 微架构总览 与 页表遍历缓存,切换类开销的同类分析见 KPTI 与 PCID 的微架构成本。
本文要回答的问题
- MPK 内存保护键在硬件上由哪两部分组成?页表项和 PKRU 寄存器各自存什么?
- 一次访存的权限判定在哪一步叠加 PKRU 检查?TLB 命中后还要不要再查?
WRPKRU为什么有序列化语义?一次权限切换真实成本多少周期?- 与
mprotect相比,MPK 在哪些维度赢、哪些维度输? - OpenSSL、JIT 引擎、glibc 怎么用 MPK 做用户态隔离?它有哪些已知的绕过手法?
一、硬件机制:页表项里的 4 位键与每线程的 PKRU
MPK 内存保护键的设计拆成两个部件,缺一不可。
第一个部件在页表里。四级页表最末一级 PTE(Page Table Entry,页表项)的第 59 到 62 位被划出 4 位作为保护键编号(PKEY),取值 0 到 15,也就是一页最多归属 16 个「键域」之一。键 0 是默认域,所有没显式设置键的页面都属于它。设置键号由内核完成——Linux 提供 pkey_alloc 申请一个键、pkey_mprotect 把一段虚拟地址区间打上这个键,之后这段区间的每一页 PTE 里都带上了同一个 4 位编号。地址翻译本身完全不受影响:虚拟地址到物理地址的映射照旧,TLB 缓存的也照旧,键号只是搭车存在 PTE 和 TLB 项里的附属标签。
第二个部件在寄存器里。每个逻辑核有一份 PKRU(Protection Key Rights Register for Userspace),32 位,恰好是 16 个键乘 2 位:每个键占一对比特,低位是 WD(Write Disable,禁止写),高位是 AD(Access Disable,禁止一切访问)。PKRU 是每线程状态,随上下文切换由操作系统保存恢复(走 XSAVE 系列指令,属于扩展处理器状态的一部分),所以两个线程即使跑在同一个核上、看着同一组页面,权限视角可以完全不同。
| 部件 | 位置 | 位宽 | 谁写 | 写什么 |
|---|---|---|---|---|
| PKEY 键号 | 末级 PTE 第 59-62 位 | 4 位 | 内核(pkey_mprotect) | 页归属的键域编号 0-15 |
| PKRU 寄存器 | 每逻辑核一份,每线程保存 | 32 位(16 键乘 2 位) | 用户态(WRPKRU) | 每个键的 AD 与 WD 开关 |
| WD 位 | PKRU 中每键的低位 | 1 位 | 用户态 | 置 1 则该键域不可写 |
| AD 位 | PKRU 中每键的高位 | 1 位 | 用户态 | 置 1 则该键域不可读写 |
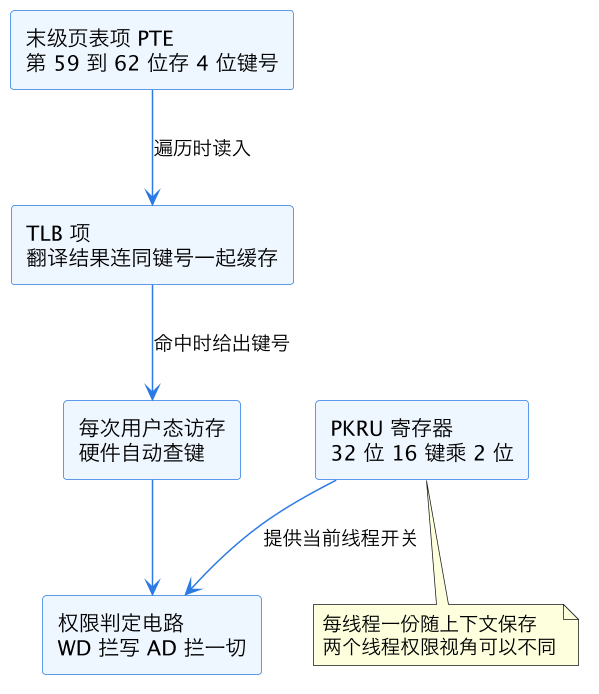
上图是两个部件的汇合关系。要点在 TLB 那条边:键号跟着翻译结果一起进了 TLB,所以 TLB 命中后权限检查用的是缓存下来的键号,不需要再走页表——这正是 MPK「零页表改动切换权限」的硬件基础。PTE 是静态标签,PKRU 是动态开关,开关翻转只改寄存器,标签一个比特都不用动。
二、权限判定流程:R/W 位先过,PKRU 再加一道闸
一次用户态数据访问的权限判定分两层。第一层是传统的页表权限:PTE 的 R/W 位、U/S 位(用户态还是内核态可访问),这层不过直接触发页错误(page fault),和有没有 MPK 无关。第二层才是 PKRU 检查:硬件取出该页键号 i,查 PKRU 的第 2i 位(WD)和第 2i+1 位(AD)——AD 为 1 则读写执行数据访问全拒;AD 为 0 且 WD 为 1 则只拦写。两层是「与」的关系:PTE 说可写、PKRU 的 WD 置了 1,写照样被拦,触发段错误(SIGSEGV),错误码里带 SEGV_PKUERR 标志,用户态可以据此区分是经典权限错误还是保护键违例。
有两个细节值得记住。其一,PKRU 只作用于用户态数据访问:内核态访问不受 PKRU 约束(内核有自己的 PKS,Protection Keys for Supervisor,对应 MSR 里的 PKRS,机制同构),取指执行也不查 PKRU——执行权限仍只看 PTE 的 NX 位。其二,检查点在所有常规权限判定之后,所以 PKRU 只能「收紧」权限,永远不能「放宽」——没法用 PKRU 让一个 PTE 本来就不可写的页变得可写。
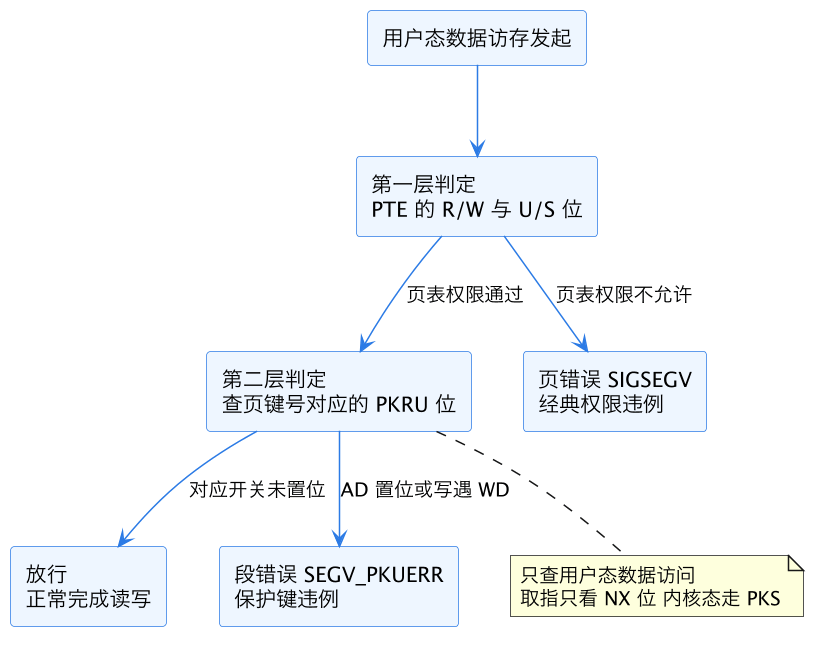
上图的两层串行结构解释了 MPK 的定位:它不是要替代页表权限,而是在页表权限之上加一道「每线程可随时翻转」的附加闸。页表权限管「这片内存谁能碰」,PKRU 管「此刻这个线程允不允许碰」,两者的变化频率差了若干个数量级。
三、切换成本解剖:WRPKRU 的几十到上百个周期花在哪
MPK 的核心卖点是切换便宜,但「便宜」要拆开了看。用户态改 PKRU 的指令是 WRPKRU:输入约定是 EAX 放新的 32 位 PKRU 值,ECX 和 EDX 必须为零(否则 GP 异常),读出用 RDPKRU。单看指令本身,它的微操作数很少,名义吞吐不差;真正的成本来自它的序列化语义:WRPKRU 必须等前面所有内存访问按旧权限完成、后面的访问全部按新权限检查,中间的乱序执行窗口被强制排空,效果近似一条轻量的管道冲刷。实测口径下,一次 WRPKRU 的端到端代价大约在 20 到 260 个周期之间浮动——流水线浅、前后访存少时接近下限;前后堆积大量未完成的 load 和 store 时被拖到上限,store buffer 排空逻辑见 store buffer 与写合并,乱序窗口排空机制见 乱序执行的边界。
另一个隐性成本在上下文切换。PKRU 属于扩展处理器状态,线程切换时操作系统要用 XRSTOR 恢复新线程的 PKRU,这把每个线程的 XSAVE 区域撑大了 64 字节,切换路径上多了几十周期的保存恢复——单次不起眼,高并发短任务场景下乘上每秒几十万次切换就值得注意了。
把 MPK 和 mprotect 摆到同一张账本上,差距是数量级的:
| 维度 | mprotect 路线 | MPK 加 WRPKRU 路线 |
|---|---|---|
| 是否进内核 | 是,一次系统调用 | 否,纯用户态指令 |
| 页表项是否改写 | 是,逐页改权限位 | 否,键号不动只翻 PKRU |
| TLB 是否刷新 | 是,本核加跨核 shootdown | 否,TLB 项原样有效 |
| 权限视角粒度 | 整个地址空间(全线程一致) | 每线程独立 |
| 单次切换典型成本 | 数千到上万周期 | 20 到 260 周期 |
| 可管理的权限域数量 | 页表允许即无上限 | 仅 16 个键 |
| 防谁 | 可防任何非特权代码 | 只防「不执行 WRPKRU」的代码 |
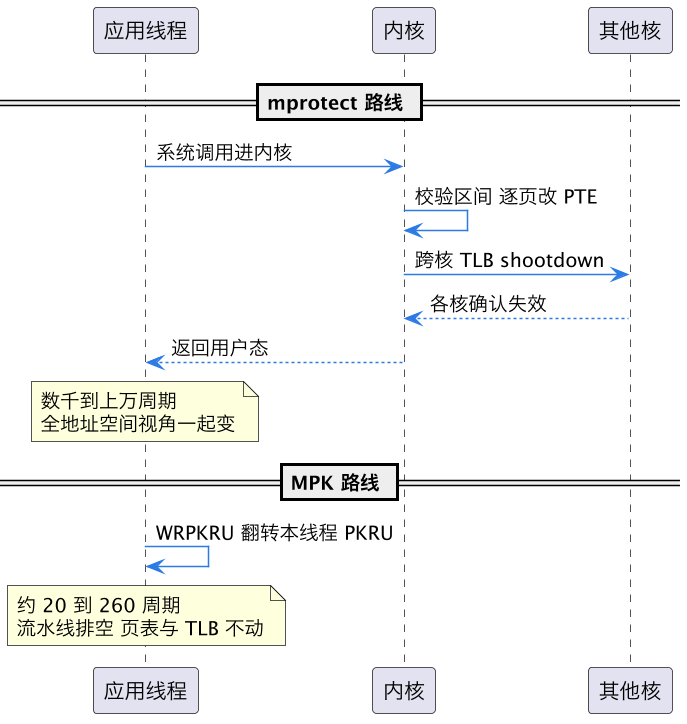
上图把两条路线的动作序列并排画了出来,mprotect 那条线上的「跨核 shootdown」是整个账单里最贵的一项——它不光耗本线程的时间,还让所有核一起停下手里相关的 TLB 项。MPK 路线则把动作收敛到「本线程、本核、一个寄存器」,这就是它在高频切换场景里不可替代的原因。
四、用户态隔离的真实用例
MPK 的生产价值集中在「同一个进程里要圈出一块不信任区域」的场景,几个已经被验证的用法。
密钥域保护。OpenSSL 等密码库把私钥材料放进一个专属键域,平时 PKRU 对该域置 AD,只有进入加解密函数的几百条指令期间才临时开门、出门立即关。这样即使进程其他部分(比如某个解析器)被攻破,攻击者读到的密钥内存也只会触发 SEGV_PKUERR。glibc 也曾用保护键把 struct pthread 里存放的栈金丝雀(stack canary)与信号栈元数据隔离起来,防止栈溢出时顺手把金丝雀值读走。
JIT 引擎的 W 异或 X。V8、WebKit 这类即时编译引擎要在运行时生成机器码,传统做法是代码页可写可执行(被 ROP 攻击者当成弹药库),或者每次生成代码都 mprotect 翻转(慢)。用 MPK 的方案:生成代码的页打上专属键并始终保持可执行,PKRU 平时置 WD 禁写,只有编译线程往里写新代码的窗口才放行——攻击者即便劫持了主线程,只要骗不到它执行那段开门的 WRPKRU 序列,就没法篡改已生成的代码。
进程内沙箱与组件隔离。浏览器把图像解码器、字体解析器这类高危解析代码关进低权限键域,数据库把用户自定义函数(UDF)与核心数据结构分开,都是同一个套路。还有一类用法是调试与正确性工具:给关键数据结构配一个默认禁写的键,任何越界写都会在第一现场被抓到,比事后对着 core dump 倒推写者高效得多,思路与 精确异常与流水线冲刷 里「异常在退休点精确报出」的价值同源。
| 用例 | 键域里放什么 | PKRU 常态 | 开门窗口 |
|---|---|---|---|
| 密钥保护 | 私钥、会话密钥 | AD 全禁 | 加解密函数执行期间 |
| JIT W 异或 X | 生成的机器码页 | WD 禁写 | 编译线程写代码时 |
| 解析器沙箱 | 解码器工作内存 | 主线程全禁 | 解析函数运行期间 |
| 越界写检测 | 关键数据结构 | WD 禁写 | 合法的更新函数内 |
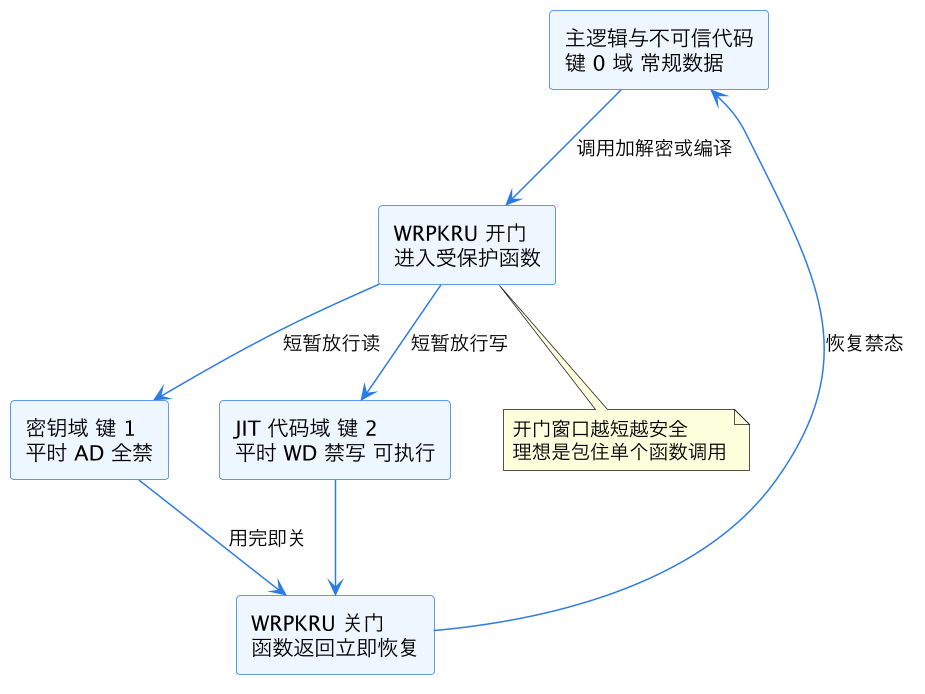
上图是这类用法的统一骨架:所有域默认关,开门和关门成对出现,包住尽量短的代码窗口。安全收益的大小不取决于 MPK 本身,而取决于「窗口里有多少行代码、窗口外攻击者能不能控制执行流跳到 WRPKRU」——这就引出下一节的问题。
五、局限与绕过:MPK 是隔离工具不是安全边界
MPK 内存保护键最大的结构性弱点是:WRPKRU 是非特权指令。任何用户态代码都可以执行它,包括被劫持的代码。也就是说,MPK 防的是「不主动去开门」的代码,防不了「会去找开门指令」的攻击者。已知绕过手法大致三类:一是「写小工具」(write gadget)——二进制里只要存在一段「EAX 可控后接 WRPKRU」的指令序列,ROP 链拼过去就能开门,所以启用 MPK 的程序常要扫描代码段、避免引入含 WRPKRU 的库,或用二进制改写消除意外的小工具;二是猜 EAX——PKRU 只有 32 位且常用值集中,攻击者可暴力尝试开门值,不过猜错会当场段错误,噪声大;三是盯上下文切换路径上的保存恢复,不过那需要先突破别的防线。因此社区的共识口径是:MPK 把攻击者的门槛从「一次内存读」抬到「要找小工具或猜值」,是有价值的纵深防御层,但绝不能当成进程边界那种硬隔离。
数量是第二个硬约束:只有 16 个键。一个进程想给每种隔离需求各配一个域,很快就会分配完,Linux 的 pkey_alloc 用光后返回失败。第三个坑在继承语义:PKRU 不随 fork 按内存语义复制给子进程的预期常被误解——线程新建时 PKRU 由线程属性决定,写代码时必须显式初始化,否则新线程可能带着一份意外的宽松开关。最后还有观测问题:保护键违例和普通段错误都走 SIGSEGV,靠 si_code 区分,性能侧则没有专门的 PMU 事件统计「WRPKRU 冲刷周期数」,只能借 MACHINE_CLEARS 类事件近似归因,计数器编程方法见 PMU 性能计数器编程。
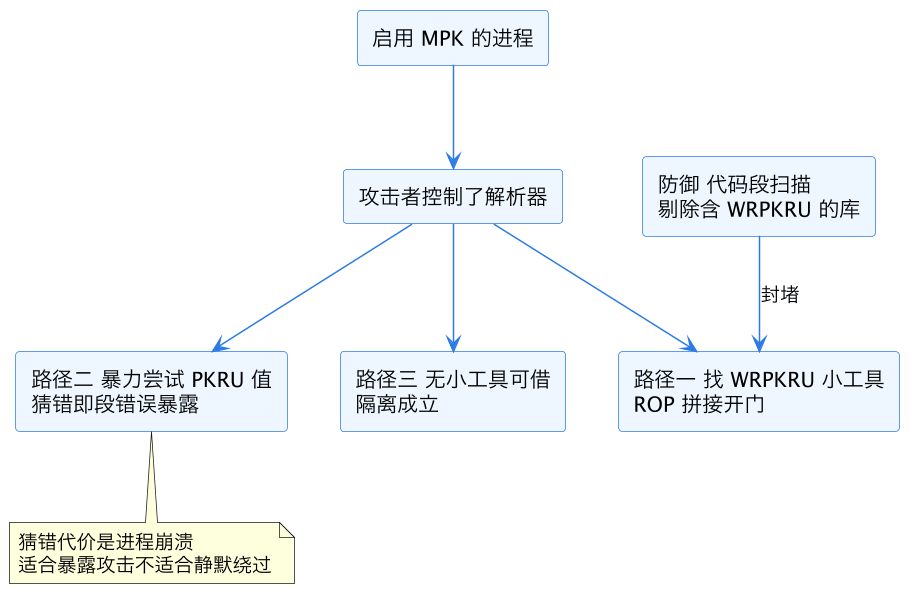
上图的三条攻击路径里,真正能防死的是路径一(扫描加改写让小工具消失),路径二靠「猜错就崩」的噪声特性天然受限,路径三才是 MPK 设计射程内的场景。工程结论:MPK 值得用在「窗口短、键数少、代码可审计」的场景,密钥域和 JIT 写禁是最佳匹配;指望它替代进程隔离去跑完全不可信的代码,是拿错了工具。
这一篇在知识体系里的位置
本篇是微架构模块「内存保护线」的用户态保护键专题。同线相邻的隔离成本分析见 KPTI 与 PCID 的微架构成本(内核页表隔离用切 CR3 换安全,与 MPK 用翻寄存器换权限是同一家族的两极),虚拟化侧的地址翻译开销见 EPT NPT 二级地址翻译,TLB 刷新的跨核广播细节见 TLB 失效广播与 shootdown。WRPKRU 序列化涉及的乱序排空背景见 乱序执行的边界 与 store buffer 与写合并,违例报告的精确性见 精确异常与流水线冲刷。全景地图见 CPU 微架构总览。
总结
MPK 内存保护键(Intel PKU)用「末级页表项第 59 到 62 位的 4 位键号」加「每线程 32 位 PKRU 寄存器的 AD/WD 开关」两个部件,让用户态代码能用一条 WRPKRU 指令在约 20 到 260 个周期内翻转自己视角下某个键域的读写权限——不进内核、不改页表、不刷 TLB,比 mprotect 的数千到上万周期便宜两个数量级,代价是指令的序列化语义会排空流水线、每进程只有 16 个键、且 WRPKRU 作为非特权指令可被 ROP 小工具借用;它是 OpenSSL 密钥域、JIT 写执行隔离、进程内解析器沙箱这类「窗口短、键数少、代码可审计」场景的理想纵深防御层,但不能替代进程级硬隔离。