SVE 谓词寄存器:谓词化执行的常见模式与编译器生成质量
承 向量长度无关编程模型 对 SVE(Scalable Vector Extension,可伸缩向量扩展)整体模型的介绍,以及 向量 SIMD 执行单元 对数据通路的拆解。SVE 与 NEON 最大的差别不是向量更宽,而是每条车道头上都顶着一个开关——这个开关就是 SVE 谓词寄存器。看懂谓词化执行的套路和编译器的生成质量,才能真正判断一段代码在 SVE 机器上跑得到底好不好。
本文要回答的问题
- SVE 谓词寄存器是什么?它与传统 SIMD 的掩码有什么本质差别?
- 谓词化执行有哪几种常见模式?循环尾部、条件赋值、稀疏访问各怎么写?
whilelt、cmp这类谓词生成指令的工作机制是什么?- GCC 和 Clang 自动生成谓词化代码的质量如何?什么场景会翻车?
- 什么时候必须手写 SVE intrinsics 兜底?
一、谓词寄存器:每条车道一个开关
SVE 有 16 个谓词寄存器 p0–p15,每个谓词寄存器的长度与向量寄存器 z0–z31 同步伸缩——128 位向量时每个谓词位管一个 8 位车道,2048 位向量时同样一个谓词位管一个 8 位车道。谓词为真的车道正常执行,谓词为假的车道「按兵不动」:不写结果、不触发内存访问、不产生异常。
这与 x86 AVX-512 的掩码寄存器 k1–k7 思路接近,但有两个关键差别。第一,SVE 谓词是车道粒度与数据宽度解耦的:同一个谓词寄存器既能管 64 位车道也能管 8 位车道,由指令里的 .d/.b 后缀决定,写代码时不用按元素宽度换掩码寄存器。第二,SVE 的谓词深度参与循环控制本身——whilelt 这类指令直接用「当前索引 vs 循环上界」生成谓词,把「这一迭代处理几个元素」变成硬件回答的问题。这正是向量长度无关模型能成立的根基,细节见 向量长度无关编程模型。
16 个谓词寄存器里,p0–p7 是「全员可用」的通用谓词,p8–p15 只能被部分指令使用(主要给谓词逻辑运算当中间结果),编译器做寄存器分配时这点差异会直接影响生成质量。
二、四种常见的谓词化模式
实战中谓词化执行翻来覆去就四种模式,看反汇编时认出它们,就能判断编译器有没有「想明白」。
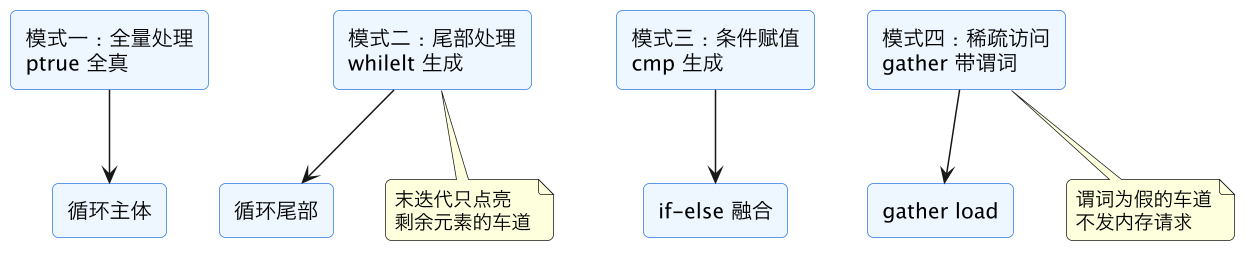
这张图按「谓词从哪来」分类:模式一的谓词是常量(ptrue),模式二来自边界比较(whilelt),模式三来自数据比较(cmplt 等),模式四则是模式二三的组合再喂给访存指令。四种模式覆盖了 90% 以上的 SVE 代码,下面逐个拆。
模式一:ptrue 全量。循环主体里所有车道都干活,ptrue p0.d 一条指令把谓词拉满,之后的 load/算术/store 全用它。开销就是一条指令,几乎免费。
模式二:whilelt 尾部。这是 SVE 的招牌动作。whilelt p0.s, x8, x9 比较「索引寄存器 x8」与「总数 x9」,为 x8、x8+1… 直到小于 x9 的车道点亮谓词。末次迭代 x8 离 x9 只剩 3 个元素时,谓词自然只有 3 个真位——不需要任何标量尾巴循环。对比 NEON 时代「向量主体 + 标量尾巴」两段式写法,代码体积和分支都少了。
模式三:cmp 条件赋值。cmplt p1.s, p0/z, z0.s, z1.s 在 p0 为真的车道上比较 z0 和 z1,结果写进 p1;随后的 sel z2.s, p1, z3.s, z4.s 按 p1 选值。一条 cmp 加一条 sel 就替换了 if-else 分支,没有分支预测失败的风险——对数据分布不可预测的条件(比如哈希表查找命中判断)收益巨大。
模式四:谓词化 gather。ld1w z0.s, p0/z, [x0, z1.s, sxtw #2] 只对 p0 为真的车道发内存请求,为假的车道连地址都不翻译。这不仅省带宽,还承担了安全语义:稀疏循环里越界的下标只要把谓词灭掉,就不会触发段错误。
三、一个具体例子:条件求和
看一个最小例子,把四种模式串起来:
// 对 arr[0..n) 中大于 threshold 的元素求和
uint64_t sum = 0;
uint64_t i = 0;
svbool_t pg = svwhilelt_b64(i, n);          // 模式二
do {
    svuint64_t v = svld1(pg, &arr[i]);       // 模式一主体内
    svbool_t gt = svcmpgt(pg, v, threshold); // 模式三
    sum += svaddv(gt, v);                    // 归约, 只对 gt 车道
    i += svcntd();
    pg = svwhilelt_b64(i, n);                // 尾部自然收窄
} while (svptest_any(svptrue_b64(), pg));
这个循环没有标量尾巴、没有内层分支,n 是 7、是 1000、是 99999 都走同一份机器码——这就是 SVE 谓词寄存器换来的自由度。svaddv 这类归约指令同样吃谓词,只有点亮车道的值进加法树。
四、编译器生成质量:能到什么水平,在哪翻车
GCC(12+)和 Clang(15+)对简单循环的 SVE 自动向量化已经相当可用,但质量分层明显:
| 场景 | 自动生成质量 | 说明 |
|---|---|---|
| 无依赖的 map/reduce 循环 | 好 | whilelt + 谓词化 load/store 一步到位 |
| 简单条件赋值(cmov 可表达) | 好 | cmp + sel 模式能认出 |
| 带 break/continue 的搜索循环 | 差 | 退化为标量,或生成 lasta/brka 的笨重组 |
| 跨迭代依赖(前缀和等) | 差 | 多数直接放弃向量化 |
| gather/scatter 稀疏循环 | 中 | 需要 -msve-vector-bits 或运行时 CPUID 才放手生成 |
| 浮点归约(加/乘) | 差 | 不重排就不向量化,需 -ffast-math |
看生成质量最直接的办法是 objdump -d 数谓词指令:好的 SVE 代码里 whilelt 应该只在循环头和循环尾各出现一次,循环体内谓词由 cmp/ptrue 派生;如果你在主体内看到反复 whilelt 或者大量 mov 在 z 寄存器和 w 寄存器之间倒腾,说明编译器没摸到正路。
另一个可量化的判据是动态谓词密度:用 ARM SME 流式矩阵扩展 同源的性能计数思路,在支持 SVE PMU 事件的机器上(如 Neoverse V1/N2)统计谓词为真车道的占比。尾部处理写得好的循环,全量迭代谓词密度应接近 100%;如果平均密度只有 60%,多半是 trip count 与向量宽度配合不好,值得手工拆循环。
五、什么时候手写 intrinsics
三条经验法则。第一,热点循环被编译器放弃向量化时——-fopt-info-vec-missed 会告诉你是「unknown dependence」还是「control flow too complex」,前者加 restrict 常常救得回来,后者基本只能手写。第二,需要精确谓词语义时,比如 gather 下标可能越界、必须保证灭灯车道不访存,编译器不会替你证明安全性,手写 svld1_gather 加显式谓词是唯一可靠路径。第三,多谓词协同时(一个 p 管访存、一个 p 管计算、一个 p 管归约),自动向量化的谓词分配经常溢出到 p8–p15 受限区,生成额外搬运,手写可以把谓词钉在 p0–p7。
还有一个容易被忽略的坑:whilelt 的粒度由元素宽度后缀决定,whilelt p0.b 与 whilelt p0.d 点亮的位数相差 8 倍。同一循环里 load 用 .s、算术用 .d 时谓词必须各自生成,混用会直接算错——这类 bug 不崩、不报警,只是结果悄悄偏小, Code Review 时值得专门盯。
手写时记住一个性能细节:谓词生成指令(whilelt/cmp)走的是与向量 ALU 不同的端口,在 Neoverse V 系列上谓词操作吞吐是每周期 1-2 条,比向量加法低;把 cmp 结果复用到多条后续指令(多个 sel 共享一个谓词)比反复比较划算。
这一篇在知识体系里的位置
本篇是 SVE 系列的执行机制篇:编程模型总览见 向量长度无关编程模型,数据通路背景见 向量 SIMD 执行单元,矩阵扩展里的谓词用法见 ARM SME 流式矩阵扩展。
总结
SVE 谓词寄存器是车道级开关:ptrue 管全量、whilelt 管尾部、cmp 管条件、谓词化 gather 管稀疏,四种模式覆盖绝大多数场景;编译器对简单循环已能生成干净的谓词代码,但带复杂控制流、跨迭代依赖和安全敏感 gather 的热点,仍需手写 intrinsics 把谓词钉在 p0–p7 并复用比较结果。