存取违序与重放:load 抢跑到未决 store 前面的代价
更新时间:2026-10-06。本篇是访存乱序系列的零件文。站内相关阅读:load-store queue 与访存消歧 讲消歧的总框架,内存依赖预测 讲预测器怎么猜「该不该等」,store-to-load 转发 讲正确的捷径长什么样,load 重放与流水线恢复 讲重放机制本身。本篇把镜头对准消歧失败的账单一角:memory order violation。
本文要回答的问题
- 乱序核为什么允许 load 越过旧 store,又靠什么发现「越错了」?
- 存取违序被检出后,机器清刷(machine clear)和重放(replay)各是什么代价?
- 内存依赖预测器怎么在「猜错的代价」和「等错的代价」之间权衡?
- 哪些代码模式是违序高发区,perf 里看哪些计数器?
- 依赖预测器的「前科」机制为什么会让修好的代码继续背锅一阵?
- 写代码时怎么从源头减少这类违序?
一、违序怎么发生:抢跑的 load 与迟到的地址
乱序核的访存单元面临一个结构性矛盾:load 想吃掉一切可以提前的机会(乱序的全部意义就在于此),但 x86-TSO 的内存模型要求 load 不能越过同址的旧 store——否则读到的就是过期的数据。矛盾在于「同址」这个条件:store 的地址要执行到地址生成(AGU)阶段才知道,而一条乱序调度的 load 完全可能在旧 store 的地址还没算出来之前就先发射了。
硬件的处理是「先斩后奏」:load 发射时扫描 store buffer,把所有地址已知的旧 store 比对一遍,撞址的等、不撞的放行;对地址未知的旧 store,默认放行——赌它不同址。赌对了,皆大欢喜;赌错了,等那条 store 的地址算出来、与已在飞或已完成的 load 做反向比对时发现同址,就构成一次 memory order violation(存取违序):load 读到的可能是旧数据,而它之后的指令已经用这份旧数据算了半天。这就是 load-store queue 与访存消歧 里「乐观消歧」策略的代价面。
为什么硬件敢这么赌?因为赢面实在太大。动态执行的 load-store 对里,真正同址(且无法转发)的比例通常不到百分之一;如果每遇到地址未决的 store 就让后续 load 无条件等待,乱序窗口里访存并行度(见 内存级并行 MLP)会被砍去一大块,平均损失远超偶尔一次的违序冲刷。乐观消歧和分支预测是同一个哲学:默认猜「没关系」,猜错付费——只要猜对的收益乘以概率大于猜错的代价,投机就是净赚。违序机制的全部工程,就是把这笔账的两侧都尽量做小。
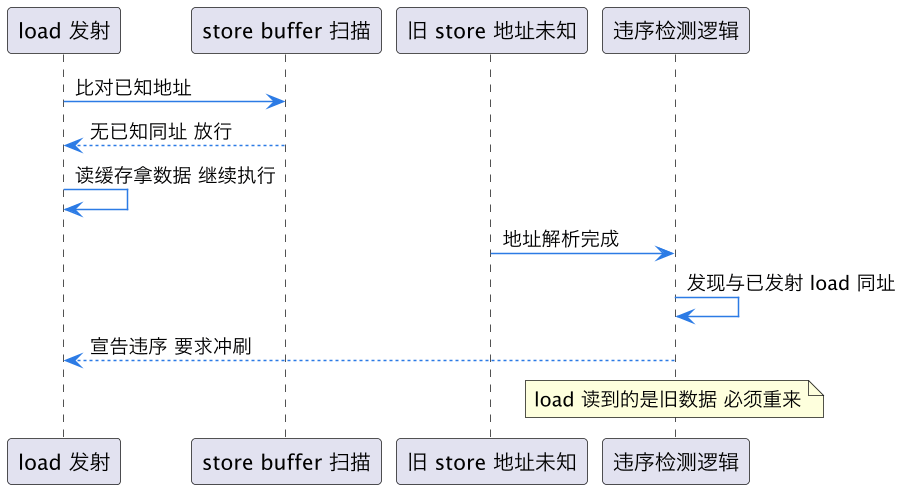
上图是一次违序的完整时间线。注意检测的非对称性:load 发射时做一次正向扫描(找 store),store 地址解析时做一次反向扫描(找 load),两次扫描的窗口差就是违序的生存空间——load 在这两段之间读到了缓存里的旧值,错误已经播种,只能靠冲刷拔除。
还有一个和违序「长得像但本质不同」的现象要分开:假冲突。早期实现(以及所有实现的部分路径)在地址未完全解析时只能比较地址的低位(页内偏移),如果 load 与 store 的页内偏移相同但物理页不同(4K 别名,原理同 缓存 VIPT 与别名),会触发一次「假违序」——按违序流程重放或等待,但数据其实没错。假违序不污染正确性,只白付性能,是 LD_BLOCKS 族计数器里独立可分的项。真违序靠「修代码」治,假违序靠「错开页内偏移」治,分辨两者是排查的第一步。
二、两档账单:重放与机器清刷
违序的处理分两档,代价差一个量级:
| 档位 | 触发条件 | 动作 | 典型代价 |
|---|---|---|---|
| 重放(replay/nuke) | 违序发现早,load 尚未退休且依赖链短 | 只作废 load 及其直接依赖,从发射队列重发 | 约 10 拍量级 |
| 机器清刷(machine clear) | 违序发现晚或实现选择保守 | 从 load 之后清空整条流水线,按正确顺序重取 | 30-60 拍量级 |
重放是「局部手术」:load 的 uop 被标记重放,喂给它的下游 uop 跟着失效,调度器在 store 数据可用后重新发射它们——机制细节见 load 重放与流水线恢复。机器清刷(Intel 文档里的 MACHINE_CLEARS.MEMORY_ORDERING 事件对应的正是这档)是「推倒重来」:整条 ROB 从违序 load 起全部作废,前端重定向到正确地址重新取指,等于一次不打误预测标签的完整流水线冲刷——代价模型和 精确异常与流水线冲刷 是同一族。
两档的选择由实现和时机决定:发现得早(load 还年轻、下游污染少)可以重放,发现得晚(load 已接近退休、下游已铺满后端)只能清刷。这也解释了违序代价的长尾特性:大多数违序几十拍,但叠在已经紧张的 ROB 窗口上时,一次清刷可能把整个乱序窗口(几百条指令的在飞并行度,见 ROB 大小与乱序窗口)清零,实际损失远超冲刷本身的拍数。
把违序清刷放进 MACHINE_CLEARS 的家族里看更有坐标感:这个事件族还包括 SMC(自修改代码冲刷)、FP_ASSIST(浮点辅助)、COUNT(计数器溢出相关)等兄弟项,全都是「流水线已经投机的状态被发现错了,推倒重来」的不同诱因。违序清刷在其中通常是占比最高的项之一——分支误预测有自己的专属事件(BR_MISP_RETIRED),而违序没有「重放档」的统一公开计数器,只有清刷档进了 MACHINE_CLEARS.MEMORY_ORDERING。这意味着观测到的违序只是冰山露出水面的部分:重放档的损耗散在 CPI 里,不单独显形,评估违序总成本时要把清刷计数当下限而非全部。

三、依赖预测器:用历史换太平
既然「默认放行、错了再罚」代价不小,硬件自然进化出了折中:内存依赖预测器(memory dependence predictor)。它记录「过去哪些 load 与哪些地址未决的旧 store 发生过违序」,下次同一条 load(按 PC 索引)再遇到地址未决的 store 时,直接让它等待——宁可误等几拍,也不赌又一次违序冲刷。内存依赖预测 对这套结构有完整拆解,这里只强调它与违序成本的耦合关系。
预测器把违序问题变成了经典的「误伤 vs 漏放」权衡:预测太激进(稍有嫌疑就让 load 等),会把大量本可并行的 load-store 对串行化,损失的是乱序的初衷——真正的 store-to-load 转发(store-to-load 转发 讲的捷径)也会被误等拖累;预测太保守,违序率上升,machine clear 的账单堆起来。Intel 的演进史里能看到这个权衡的摇摆:某些代际被逆向发现「对地址未决 store 的默认态度从乐观转悲观」,背后正是产品实测中 machine clear 成本超标的反馈。
预测表的实现形态也值得一提:它不是「记 pair(load PC, store PC)」的全精度账本——那对存储太奢侈。常见做法是以 load 的 PC 索引一个小表,表里只记「这条 load 有没有前科、前科多严重」(几位饱和计数),触发等待时让 load 等所有地址未决的旧 store,而不是等特定某条。粒度粗换来面积小,代价是误伤面大:一条有前科的 load 会让它在整个窗口内对所有未决 store 保持敬畏。这也是为什么违序高发的代码一旦被预测器「记住」,性能劣化会持续存在——即使后来的执行流里根本没有真冲突,只要前科计数没衰减完,load 就一直在白白等待。
上图里预测器的角色类似分支预测器:用 PC 索引的小表记录「前科」,用几拍的确定性小损失对冲几十拍的随机性大损失。区别是分支预测的「正确答案」恒定(跳或不跳),依赖预测的「正确答案」随地址流变化——同一条 load 在不同时刻撞上不同 store,前科的指示力天然弱于分支历史,所以依赖预测器的置信度衰减和老化机制做得更保守。
四、高发代码模式与 perf 观测
违序不是均匀分布的,它集中在这几类模式上:
- 混用宽窄访问:同一块内存一会儿按 8 字节写、一会儿按 4 字节读(联合体、类型双关、序列化代码),地址比对容易出「部分重叠」的复杂情形,违序和 4K 别名 式的假冲突都高发。
- 指针追逐穿插写:链表/树遍历中
p = p->next的 load 与偶尔的结构写交错,load 大量抢跑,偶尔撞址就是一次清刷。 - 溢出填充(spill/fill)密集的函数:寄存器不够时编译器在栈上频繁 store 再 load,窗口内 store 地址未决的比例高,违序概率水涨船高。
- 伪共享的多核热点:多核争同一缓存行的写(原子操作的缓存行实现 的场景)会拖慢 store 地址与数据的就位,窗口拉长,违序机会变多。
观测上,Intel 平台认两组计数器:MACHINE_CLEARS.MEMORY_ORDERING(机器清刷档的违序次数)和各代际的 LD_BLOCKS* 族(load 被阻塞的细分原因)。一条经验判读:CPI 偏高、branch-misses 不高、但 MACHINE_CLEARS 总量里 MEMORY_ORDERING 占比突出,就是违序在收税。AMD 平台对应事件名不同(LS_MAAL 之类),语义相同。采样定位可以用 perf record -e machine_clears.memory_ordering(事件名以 perf list 为准)直接归因到代码行——违序的「案发地」通常是 load 一侧,但「肇事者」往往是窗口内那条迟到的 store,修复时两边都要看。
给一个排查的实战侧写。某 JSON 解析服务,CPI 比预期高 0.4,perf stat 的分支误预测率只有 0.8%(正常),但 MACHINE_CLEARS.MEMORY_ORDERING 折算每千条指令 1.2 次——一次清刷按 40 拍粗算,正好解释 CPI 缺口的大头。采样归因到解析器的状态机主循环:循环里按 1 字节写状态缓冲、紧接着按 8 字节读同一缓冲做查表索引,宽窄混用加上窗口极短,违序高发。把状态缓冲的读写宽度统一成 8 字节(写入侧做移位合并)后,违序事件下降 90%,CPI 回落。这个案例几乎集齐了本文所有要点:宽窄混用的模式、清刷计数与 CPI 的换算、修法在数据流而非屏障。
五、源码层的规避
软件侧能做的归结为三句话。减少宽窄混用:同一块数据用统一的访问宽度,类型双关优先走 memcpy(编译器能优化成单次对齐访问)而不是指针强转。缩短 load 与前序 store 的窗口:把「写完很快就读」的模式重排成「写完隔一段再读」,给 store 地址解析留出时间——这在手写汇编级的热循环里是真功夫,C 层面靠调整语句顺序和减少内联膨胀实现。警惕溢出热点:perf 显示违序集中在某函数且该函数寄存器压力爆表时,拆函数、减局部变量、或把热数据改成寄存器友好布局,比任何微优化都直接。
一个反面提醒:不要试图用编译器屏障或 fence 去「治」违序——这是核内的消歧问题,与核间的内存模型无关,fence 只会让窗口更长、违序更多(内存屏障的真实开销 的教训在这里同样适用)。治法是数据流整形,不是加锁。
最后给一个改动后的验证套路:每次按上述思路重构后,固定输入跑三轮 perf stat -e cycles,instructions,machine_clears.memory_ordering,看违序计数的变化方向而非绝对值——绝对值随负载波动,方向才是代码改动的净效果。如果违序计数降了但 CPI 没动,说明违序原本就不是主要瓶颈(或修掉的只是假冲突),及时收手,别在错误的战场上继续投入。
这一篇在知识体系里的位置
本篇是访存乱序系列里「失败的投机」一角:总框架 load-store queue 与访存消歧,预测侧 内存依赖预测,正确捷径 store-to-load 转发,恢复机制 load 重放与流水线恢复,写侧缓冲 store buffer 与写合并,冲刷族谱 精确异常与流水线冲刷。整个 LSU 的总览、访存数据冒险 与 uop 流水线之 LSU 缓冲 可作为延伸阅读。
总结
存取违序是乱序核「load 抢跑、store 地址后到」的结构性风险:正向扫描放行、反向扫描抓错,抓到就按发现早晚付出重放(约 10 拍)或机器清刷(30-60 拍外加乱序窗口清零)的账单;依赖预测器用 PC 前科把大损失换成小等待,前科未衰减时修好的代码也会继续背锅。排查认 MACHINE_CLEARS.MEMORY_ORDERING,根治靠统一访问宽度、拉开写读间距、缓解寄存器溢出——它是核内消歧问题,加 fence 只会帮倒忙。