大页与 TLB 共存:2M/1G 页在 split TLB 与 STLB 里的占位经济学
更新时间:2026-10-06。本篇是 TLB 系列的零件文。站内相关阅读:大页缓解 TLB 压力 讲大页为什么能救 TLB,两级 TLB 与 STLB 设计 讲层级结构,TLB 页遍历缓存 讲 miss 之后的遍历加速,TLB 合并翻译 讲相邻项的合体技巧。本篇回答一个更细的工程问题:4K、2M、1G 三种页同时存在时,TLB 的每一项到底被谁占了,代价怎么算。
本文要回答的问题
- 现代核的 TLB 层级里,2M/1G 大页住在哪一层、各占多少项?
- 4K 与 2M 页混用时的「碎片化」指什么,覆盖能力损失怎么量化?
- 透明大页(THP)的合并与拆分在微架构层面要付哪些钱?
- 一个 2.5GB 热工作集的 KV 服务,开大页前后 STLB 覆盖差多少?
- 怎么观测大页配置的真实收益,perf 里看哪些事件?
- 静态预留大页与透明大页各自适合什么样的负载?
一、TLB 的分页格局:不同层住不同尺寸的页
现代 x86 核(Intel Golden Cove、AMD Zen 4 这一档)的 TLB 不是一张统一的大表,而是「按页尺寸分格」的多层结构。典型的分工是:L1 dTLB 给 4K 页准备几十项、给 2M 页单独留一小格(比如 16-32 项),1G 页往往只有几项甚至没有专格;L2 级的 STLB(Shared TLB,共享二级 TLB)容量大得多(1536-2048 项量级),多数设计让它混住 4K 和 2M 项——同一个物理项,标签解释的粒度不同而已。
两家的具体分格略有差异。Intel 近年客户端/服务器核的 L1 dTLB 大约是「4K 页 96 项 + 2M/4M 页 32 项 + 1G 页 4 项」的三格布局;AMD Zen 系的 L1 dTLB 项数较少但全相连程度更高,2M 页与 4K 页共用一组项的混合格设计更常见。差异对调优的直接影响是:同一台服务换平台后,「多少热内存能留在 L1 级」的阈值会变,过去刚好卡在 L1 容量内的应用可能突然滑到 STLB,延迟分布整体抬一档——跨平台性能对比时这是常见的隐形变量。
这种分格的直接后果是:大页的 TLB 收益不是线性的。一个 2M 页顶替 512 个 4K 页,理论上把 TLB 覆盖能力放大 512 倍;但如果 L1 dTLB 的 2M 格只有 32 项,数据工作集超过 64MB 后 L1 级照样 miss,只是 miss 落到了 STLB——那里项多、便宜(十几到二十拍 vs 页遍历的几十到上百拍),惩罚小得多。所以大页的真实收益曲线是两段的:STLB 容量之内,收益接近满分;超出 STLB 覆盖(2M 页 × 1536 项 ≈ 3GB),收益开始打折,这时才轮到 1G 页登场。
| 层级 | 4K 页典型项数 | 2M 页典型项数 | 1G 页典型项数 | miss 代价量级 |
|---|---|---|---|---|
| L1 iTLB | 64-128 | 分格 8-32 | 0-8 | STLB 命中约 10-20 拍 |
| L1 dTLB | 64-96 | 分格 16-32 | 0-16 | 同上 |
| STLB | 混住 1536-2048 | 与 4K 共享 | 少量 | 页遍历 40-100+ 拍 |
| 页遍历缓存 | 保存中间级 | 与大页无关 | 与大页无关 | 砍掉遍历前几级 |
这张表的用法是反查:知道应用的「热数据足迹」和「热指令足迹」,对照各层项数,就能预判 TLB miss 主要发生在哪一级、大页能把哪一级救回来。指令侧的问题见 iTLB miss 与前端停顿,本文聚焦数据侧。
上图是 miss 逐级下沉的路径。注意大页对页遍历的加成是双重的:2M 页的页表只有三级(PTE 层消失),1G 页只有两级,遍历本身就更短——TLB 页遍历缓存 缓存的中间级恰好也是大页翻译的必经站,两者收益叠加。所以「开没开大页」在最坏路径(STLB miss)上差异比在统计平均值上更刺眼。
1G 页的处境单独说一句。它的覆盖效率最极致(1 项管 1GB),但限制也最硬:必须在启动期通过内核参数预留,运行时几乎不可动态分配;L1 级的 1G 分格项数极少(几项量级),热数据超过几 GB 后 L1 级照样 miss 落到 STLB。因此 1G 页适合「一块硕大且长寿的连续区域」——数据库 buffer pool、DPDK 的大页内存池是典型用户;指望它覆盖零散增长的堆是不现实的。2M 与 1G 的选择本质上是「灵活性与覆盖效率」的互换:2M 可拆分、可 THP 自动管理,1G 一次到位但几乎不可逆。
还有一个横向对照:ARM64 的 64K 基页配置(部分服务器发行版启用)把「基页与大页」的落差从 512 倍缩到 32 倍(64K 基页 + 2M/512M 大页),TLB 压力的形态随之改变——基页本身就宽,THP 的边际收益变小,但页表级数可能增加一级,遍历变长。评估 ARM 服务器上的大页配置,不能直接搬 x86 的经验值,要按实际的基页粒度重算覆盖账。
二、混用与碎片化:TLB 覆盖能力怎么算账
真实系统里三种页必然混用:内核代码段、小对象堆栈是 4K,开了 THP 的匿名内存是 2M 为主,数据库 buffer pool 可能配了 1G 静态大页。混用时的核心概念是 TLB 覆盖能力(reach):所有 TLB 项覆盖的地址总量。一笔账:1536 项 STLB 全装 4K 页覆盖 6MB,全装 2M 页覆盖 3GB——同一块硅,覆盖能力差 500 倍。这意味着混用的比例直接决定 STLB 的有效容量:一半项被 4K 页占着,2M 页的覆盖就从 3GB 掉到 1.5GB。
「碎片化」这个词在 TLB 语境里有两层含义,要分清。第一层是地址空间碎片:THP 只能对「恰好 2M 对齐且连续的物理内存」成立,系统跑久了物理页散乱,能拼出 2M 连续块的机会下降,结果是大页占比缓慢衰减——这是内核内存管理的碎片问题。第二层是 TLB 项占位碎片:一个 2M 区域内只要有一小部分被拆成 4K 页(比如被 mprotect、madvise、写时复制动了其中几页),这个区域在 TLB 里就从「1 项」变回「几十上百项」,覆盖能力瞬间蒸发。后者是微架构层面的真损失,而且常常由一次不起眼的系统调用触发。

上图是占位碎片的核心账:覆盖能力不变,占位成本暴涨数十倍。更麻烦的是这种拆分往往不可逆——THP 的合并(khugepaged 后台扫描)是慢速且挑剔的,拆开的区域很长时间内都保持 4K 形态,TLB 压力持续偏高。对延迟敏感的服务,这是「今天 p99 突然变差」的可疑根因之一。
还有一个混用时的隐蔽效应值得点名:iTLB 与 dTLB 的分格预算是各自独立的。数据库类应用常见「数据侧大页化做得很彻底、指令侧却是几 MB 的热点代码铺在 4K 页上」的组合——数据侧的 TLB 问题解决得干干净净,前端却因 iTLB miss 与前端停顿 持续失血。部分发行版支持把可执行文件 remap 到大页(如 hugetlbfs 挂代码段、或借助 libhugetlbfs 的 --text-huge),对代码足迹大的服务能再省一档遍历开销,只是操作门槛高、收益要实测确认。
三、一个覆盖能力的估算实例
把抽象账目落到一个具体场景。某 KV 存储进程,热数据工作集约 2.5GB,代码段约 200MB,零散的堆栈与元数据约 100MB。全部用 4K 页时:2.5GB 数据对应 64 万个翻译,STLB 的 1536 项只覆盖 6MB——连工作集的 0.3% 都盖不住,几乎每次缺一行数据的访问都要页遍历,PAGE_WALKS.CYCLES 轻松吃掉 15-25% 的核周期。切到 2M 大页后:2.5GB 数据只需 1280 项,恰好住进 STLB;代码段若保持 4K 则再占约 5 万项中活跃的一部分——好在代码访问局部性强,实际热项不过几百。此时 STLB 级别的 miss 基本消失,只剩冷启动和边界访问,遍历周期占比掉到 1-3%。
这个例子里还藏着一个决策点:工作集 2.5GB 对「1536 项 × 2M ≈ 3GB」的 STLB 覆盖来说是贴着天花板的,任何混进来抢项的 4K 翻译(共享库、内核映射回映、其他线程的栈)都在蚕食余量。这就是为什么大内存服务建议把数据页做成静态大页(hugepagesz 预留)而不是依赖 THP——静态大页不进普通伙伴系统,不会被零散分配拆散,STLB 里给数据留的座位是买断了产权的。
四、THP 合并与拆分:微架构层面的五笔开销
透明大页对应用「免费」,但对硬件不免费。把它拆成微架构能看见的五笔开销:
- 分配时的规整:要凑出 2M 连续物理块,可能触发直接回收(direct reclaim)和内存规整(compaction),分配路径从纳秒级掉到微秒甚至毫秒级——这是 THP 最臭名昭著的「分配卡顿」,大页缓解 TLB 压力 里讲的
madvise模式正是为了把这笔钱关进白名单。 - 拆分时的大量 TLB 失效:一个 2M 页被拆成 512 个 4K 页,意味着新建立 512 个翻译,任何核 TLB 里的旧大页项都得作废。跨核作废走 TLB shootdown 失效 讲的 IPI 广播路径,一次 shootdown 在众核机器上是微秒级事件。
- 页遍历缓存的连带失效:PMD 级页表项变了,缓存它的页遍历缓存项同样要清,否则旧遍历结果会给出错误翻译。
- khugepaged 的后台扫描成本:内核线程周期性扫描候选区域、尝试合并,合并动作本身要先拆分再重建,期间持有的锁与 IPI 都会干扰前台业务。
- 虚假收益的测量陷阱:THP 合并成功的那一刻,TLB miss 率骤降;但如果随后频繁拆分-合并震荡,总成本可能反超「从头到尾用 4K」——评估大页要看长期稳态,不能只看合并后那几分钟的漂亮曲线。
五笔账里,前四笔是「事件型」开销(发生时有明确的时间点和计数),第五笔是「统计型」陷阱(要用足够长的观察窗识破)。运维上的对应动作也不同:事件型开销靠配置规避(白名单、静态预留、关闭透明规整),统计型陷阱靠监控识破(把 thp_split 速率纳入告警面板)。
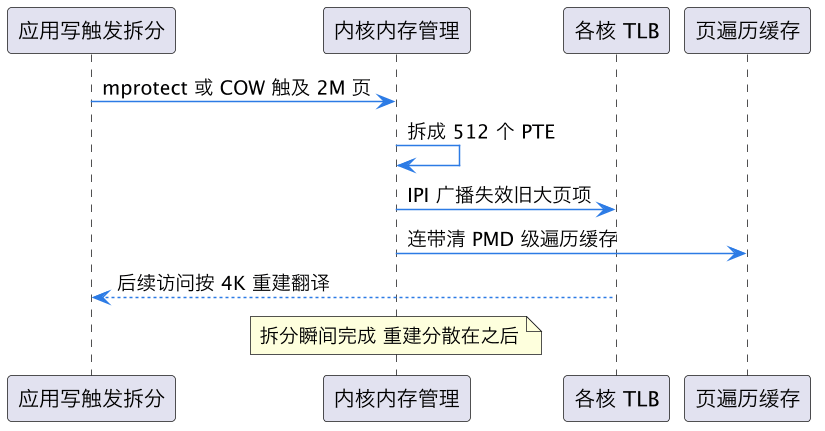
上图是拆分事件的时序:失效是同步的、瞬间的(所有核的 TLB 立刻作废),代价是重建被摊到之后每次访问里慢慢还。这个「立刻收账、分期还款」的模式解释了为什么拆分后的性能劣化是渐进而非跳变——监控上看到的是 TLB miss 率缓慢爬坡,很容易误判成别的问题。
五、观测与配置:perf 事件与决策表
大页收益的观测靠两组事件。第一组是 TLB miss 计数:Intel 的 DTLB_LOAD_MISSES.MISS_CAUSES_A_WALK 和 DTLB_STORE_MISSES.MISS_CAUSES_A_WALK 数的是落到页遍历的真 miss,PAGE_WALKS.CYCLES 直接给出遍历占用的周期占比——这是最硬的指标,遍历周期占比从 15% 掉到 2%,就是大页的功劳簿。第二组是内核侧计数:/proc/vmstat 里的 thp_fault_alloc、thp_collapse_alloc、thp_split 记录了分配、合并、拆分的累计次数,拆分计数持续上涨说明工作在震荡区。
配置决策可以收敛成一张表:
| 负载特征 | 推荐配置 | 理由 |
|---|---|---|
| 大 buffer pool 长驻(DB、KV) | 静态 1G/2M 大页 | 免拆分震荡,覆盖能力拉满 |
| 堆内存增长型服务(Java 等) | THP=madvise + JVM 显式启用 | 把分配卡顿关进白名单 |
| 内存敏感的小服务混部 | THP=never 或 defer | 避免规整抖动互相传染 |
| 虚拟化二层翻译 | 大页收益翻倍 | 见下段与 EPT 二级翻译 |
虚拟化场景值得单独一句:EPT/NPT 二级翻译让一次 TLB miss 的页遍历从 4 级膨胀到最多 24 次内存访问(客户机页表的每一级都可能再嵌套宿主机页表的查询),大页把两级页表各砍一层,遍历缩短的收益是平方级的——虚拟化里大页不是优化,是生存需求。云厂商的机型文档普遍默认开启并预留大页,原因正在于此;反过来,在虚拟化环境里测到莫名的遍历开销,先查宿主机有没有把内存 backing 切成 4K 小页。
一条可直接上手的观测命令是 perf stat -e dtlb_load_misses.miss_causes_a_walk,dtlb_store_misses.miss_causes_a_walk,page_walks.cycles,cycles -p <pid>(事件名随代际略有差异,perf list | grep -i walk 确认)。对比开/关大页两轮,重点看 page_walks.cycles / cycles 这个比值的变化,而不是 miss 绝对次数——miss 次数受访问总量影响,周期占比才是干净的归一化指标。
最后给一个常被忽视的验证动作:改了 THP 配置后,别只看 perf stat 的 CPI 变化,顺手确认 thp_split 没有同步上涨。合并收益和拆分成本经常同时存在,净值才作数。
这一篇在知识体系里的位置
本篇在 TLB 系列中位于「层级结构」与「压力治理」之间:上游 两级 TLB 与 STLB 设计 给出骨架,本篇填大页占位的细节;同层 TLB 页遍历缓存、TLB 合并翻译 是 miss 路径上的另外两种省法;下游 大页缓解 TLB 压力 与 TLB shootdown 失效 分别是收益面与代价面的全景。虚拟化交叉点见 EPT 二级翻译,地址空间布局的宏观视角见 缓存层次延迟带宽全景。
总结
大页与 TLB 共存的本质是占位经济学:2M 页用 1 个 TLB 项顶替 512 个 4K 项,把 STLB 覆盖能力放大数百倍,但 L1 分格有限、混用挤占、一次 mprotect 就能触发拆分让占位暴涨;THP 的合并与拆分各有一本微架构账(分配卡顿、shootdown、遍历缓存连带失效),评估收益要看稳态净值,观测上认 PAGE_WALKS.CYCLES 和 thp_split 这两组计数最靠谱。